课后补充--RFdiffusion + ProteinMPNN从头抗体设计
原创
课后补充--RFdiffusion + ProteinMPNN从头抗体设计
原创
追风少年i
发布于 2026-09-26 17:25:40
发布于 2026-09-26 17:25:40
作者,Evil Genius
今天我们来梳理一下从头抗体设计的思路。
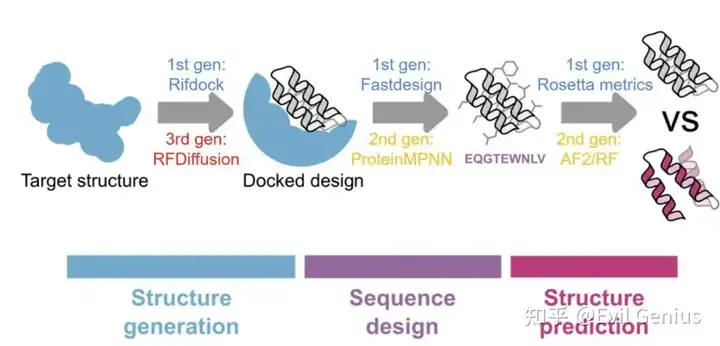
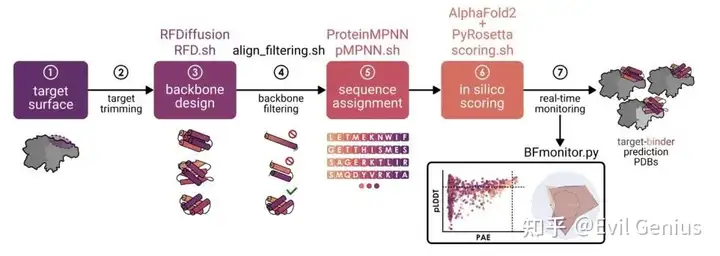
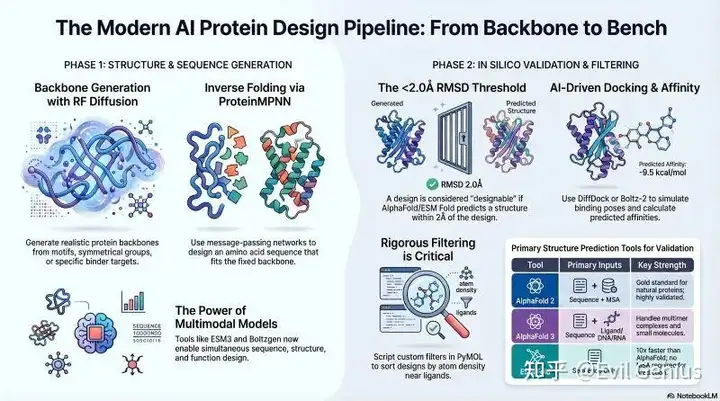
一、RFdiffusion从头设计抗体:完整路线
已知靶蛋白结构
                       │
                       ↓
              ① 靶蛋白结构准备
                       │
                       ↓
              ② 确定目标表位
                 Epitope
                       │
                       ↓
              ③ 定义设计区域
              hotspot / interface
                       │
                       ↓
              ④ RFdiffusion
          生成抗体结合骨架
                       │
                       ↓
             大规模生成候选
                       │
                       ↓
              ⑤ 结构过滤
        interface / RMSD / clash
                       │
                       ↓
              ⑥ ProteinMPNN
             设计氨基酸序列
                       │
                       ↓
              ⑦ 结构预测
        AlphaFold / ESMFold等
                       │
                       ↓
             ⑧ 复合物验证
          Target + designed binder
                       │
                       ↓
          ⑨ 界面/亲和力筛选
                       │
                       ↓
              ⑩ Rosetta优化
                       │
                       ↓
                 ⑪ MD验证
                       │
                       ↓
              ⑫ 实验表达筛选
                       │
                       ↓
                最终抗体
二、第一步:准备靶蛋白结构
假设已经有:
target.pdb首先进行结构检查:
target.pdb
   ↓
去除不需要的配体
   ↓
检查缺失残基
   ↓
检查链
   ↓
添加必要氢原子
   ↓
检查结构质量
   ↓
target_clean.pdb
例如:
Target protein
     │
     ├── Chain A
     ├── Chain B
     └── ligand
需要先明确:
究竟是哪条链、哪个结构域、哪个表面区域是你希望抗体结合的位置。
三、第二步:确定 Epitope
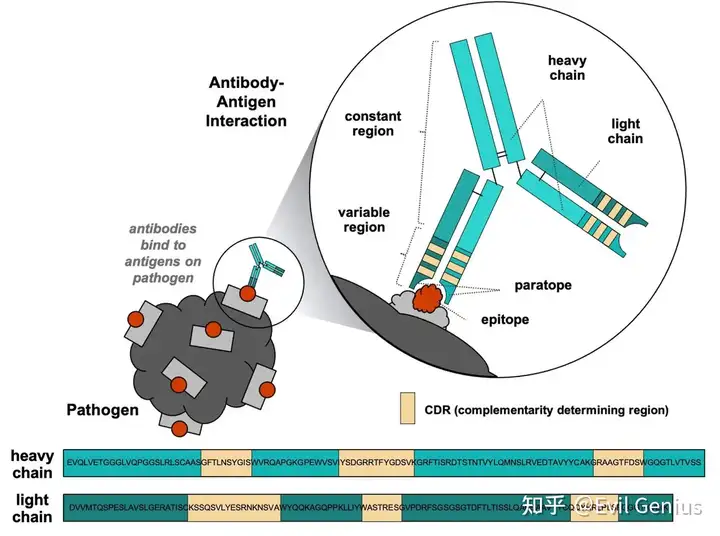
这是整个过程非常关键的一步。
RFdiffusion并不是:
“让AI自己随便找靶蛋白表面。”
更常见、更可控的思路是:
你先告诉它希望 binder 接近靶蛋白的哪个区域。
例如:
Target protein

       ┌───────────────┐
      /                 \
     |                   |
     |      ★★★★★       |
     |      Epitope     |
     |                   |
      \                 /
       └───────────────┘
                ↑
          desired binder
如果你的目标是:
特异性结合某个突变位点
例如:
WT:
         ─── A ───

Mutant:
         ─── X ───
              ★
那么可以把突变附近表面作为设计区域。
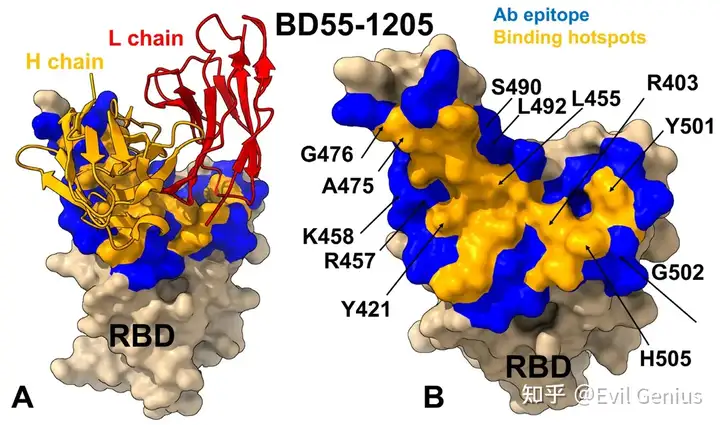
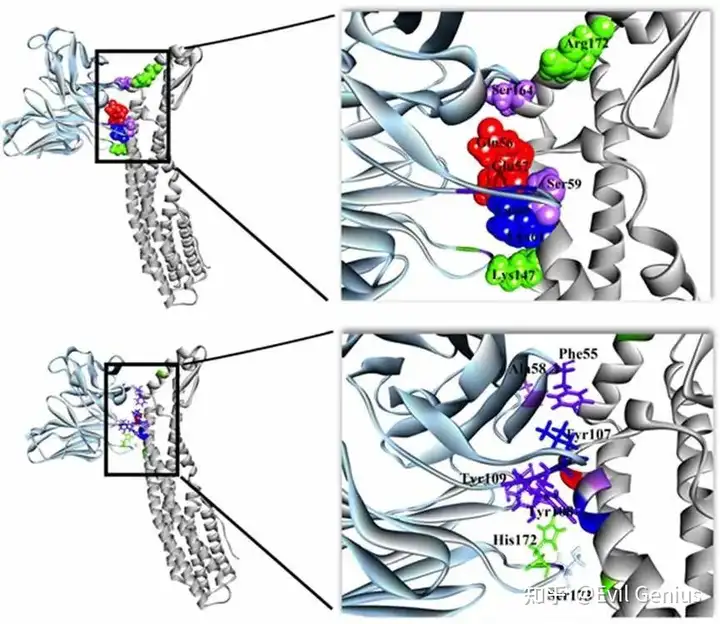
四、第三步:确定 hotspot residues
这里是 RFdiffusion binder design 中非常重要的概念。
可以指定:
哪些靶蛋白残基必须参与结合。
例如:
Target

     100     105
      ↓       ↓
───── K ───── Y ─────
        \     /
         \   /
        hotspot
可以理解为:
Target protein
     ↓
hotspot residues
     ↓
RFdiffusion生成binder
     ↓
让binder interface靠近这些残基
也就是说:
hotspot是设计约束,而不是最终抗体序列。
五、第四步:RFdiffusion到底生成什么?
RFdiffusion首先生成的是:
3D protein backbone
而不是直接生成:
完整抗体氨基酸序列。
也就是说:
RFdiffusion
                     ↓
              3D backbone
                     ↓
             ┌─────────────┐
             │             │
             │    Binder   │
             │             │
             └─────────────┘
例如你给它:
Target
+
hotspot residues
+
binder length
它可以产生:
Target + new protein backbone这属于:
de novo protein binder design
六、但是“从头设计抗体”和“设计蛋白binder”要区分
RFdiffusion最自然的任务是:
设计一个能够结合目标蛋白的新的蛋白骨架。
它并不天然等价于:
生成一个符合天然抗体 VH/VL 架构、具有完整免疫球蛋白折叠和标准 CDR 的抗体。
因此实际项目中需要区分两条路线:
路线 A:De novo protein binder
Target
 ↓
RFdiffusion
 ↓
New binder backbone
 ↓
ProteinMPNN
 ↓
Sequence
路线 B:Antibody-specific design
Target
 ↓
Epitope
 ↓
Antibody scaffold
 ↓
CDR design / constrained diffusion
 ↓
Antibody sequence如果目标是真正的 IgG / Fab / scFv 抗体,就要特别关注抗体 scaffold 和 CDR 架构,而不能简单把任意 RFdiffusion binder 称为“抗体”。
七、第五步:生成大量候选结构
假设一次生成:
1000 structures得到:
candidate_001.pdb
candidate_002.pdb
candidate_003.pdb
...
candidate_1000.pdb
这时候:
绝大多数候选都不能直接拿去做实验。
需要进行结构过滤。
八、第六步:第一轮结构过滤
主要看:
① 是否真正接触目标表位
Target
████████████████
██████★█████████
      ↑
   binder
而不是:
Target

████████████████

             binder
② 是否存在严重 clash
Bad:

Target
████████
   ████████
      ↑
    clash
③ 接触面积
一般希望形成合理的蛋白-蛋白界面。
关注:
- interface area
- buried surface area
- contact residues
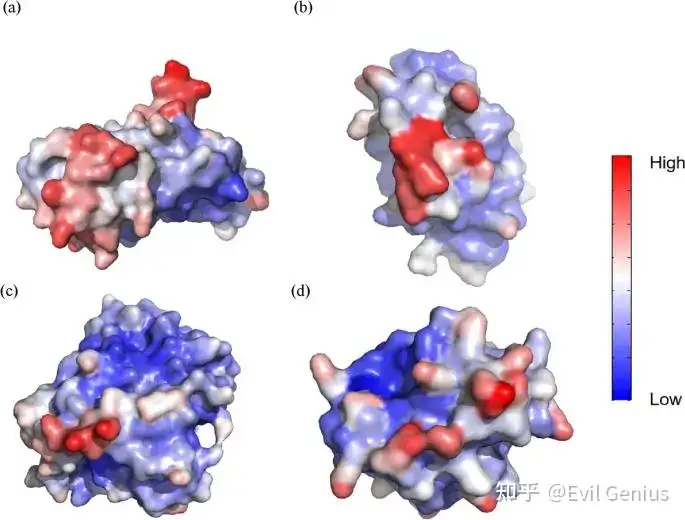
④ Shape complementarity
Target surface
     ∩
Binder surface
希望:
形状互补。
九、第七步:ProteinMPNN进行序列设计
RFdiffusion给的是:
Backbone接下来需要:
ProteinMPNN 根据 backbone 设计氨基酸序列。
流程:
RFdiffusion backbone
        ↓
    ProteinMPNN
        ↓
Sequence 1
Sequence 2
Sequence 3
...
例如:
Binder backbone

       ↓

MPNN

       ↓

MKT...XXX...
所以可以简单记:
RFdiffusion负责“长什么样”;ProteinMPNN负责“由什么氨基酸组成”。
十、如果设计真正的抗体,序列设计还需要考虑什么?
需要关注:
VH
│
├── Framework
├── CDR-H1
├── CDR-H2
└── CDR-H3

VL
│
├── Framework
├── CDR-L1
├── CDR-L2
└── CDR-L3
尤其是:
CDR-H3
因为它往往是抗原识别的重要组成部分。
所以真正的 antibody design 不应该只看:
ProteinMPNN loss
还需要检查:
- CDR构象
- framework合理性
- VH/VL interface
- CDR长度
- sequence developability
- aggregation risk
- liability motifs
十一、第八步:重新预测设计序列的结构
得到序列以后:
Designed sequence
        ↓
Structure prediction
        ↓
Predicted structure
可以采用 AlphaFold 系列等方法进行结构预测。
这里有两个问题:
问题1
这个序列能不能折叠成我们设计的 backbone?
问题2
它折叠以后还能不能结合靶蛋白?
所以不能只预测单体。
更重要的是:
Target
   +
Designed binder
   ↓
complex prediction
十二、第九步:检查“设计结构”和“预测结构”是否一致
这是一个非常重要的过滤步骤。
假设:
RFdiffusion设计:

        Target
          │
        Binder
          ↓
       interface
预测之后:
Predicted:

        Target
          │
          │
       Binder
          ↘
如果结构发生很大变化:
这个设计可能不可靠。
因此需要比较:
design vs prediction
例如:
- backbone RMSD
- interface RMSD
- secondary structure consistency
- confidence
- interface contacts
十三、第十步:检查抗原-抗体界面
需要分析:
Target
   │
   ├── Epitope residues
   │
   ├── H-bonds
   │
   ├── Salt bridges
   │
   ├── Hydrophobic contacts
   │
   ├── π interactions
   │
   └── van der Waals
          ↑
        Binder
特别需要问:
设计出来的 binder 到底是不是通过预期的 Epitope 结合?
十四、第十一步:特异性设计
如果你只追求:
“结合目标蛋白”
还不够。
真正的抗体开发还需要:
Target binding + Off-target avoidance
例如:
Designed antibody
       │
       ├──────── Target
       │             ↓
       │          strong
       │
       ├──────── WT
       │             ↓
       │          weak
       │
       ├──────── Homolog 1
       │             ↓
       │          weak
       │
       └──────── Homolog 2
                     ↓
                   weak
所以可以进行:
Positive design
增强:
Target interaction
Negative design
削弱:
Off-target interaction
这对:
突变体特异性抗体
尤其重要。
十五、第十二步:Rosetta / PyRosetta优化
假设:
CDR-H3
      ↓
Residue 1
Residue 2
Residue 3
Residue 4
进行计算突变:
A → F
A → Y
A → W
A → L
...
然后计算:
- interface energy
- ΔΔG
- hydrogen bonds
- packing
- buried surface
- steric clash
筛选:
Candidate 1
Candidate 2
Candidate 3
...
十六、第十三步:MD验证
然后进入分子动力学:
Target + designed antibody
          ↓
        MD
          ↓
     trajectory
          ↓
 ┌────────┼────────┐
 ↓        ↓        ↓
RMSD      Rg     H-bonds
 ↓        ↓        ↓
Interface stability
重点看:
RMSD
复合物是否稳定。
Interface contacts
接触是否持续存在。
Hydrogen bonds
关键氢键是否保持。
SASA/BSA
界面是否稳定。
MM/GBSA 或 MM/PBSA
可以作为相对比较指标,但不要把它当成实验亲和力的直接替代。
十七、第十四步:最后得到候选抗体
经过多轮筛选:
10000 generated
      ↓
3000 structural filters
      ↓
500 sequence designs
      ↓
100 predicted structures
      ↓
20 interface candidates
      ↓
5–20 experimental candidates
最终进入实验:
DNA synthesis
      ↓
Expression
      ↓
Purification
      ↓
Binding assay
      ↓
BLI / SPR
      ↓
Specificity
      ↓
Cell assay
十八、整个 RFdiffusion + ProteinMPNN + AF + Rosetta + MD 的位置
可以把几个软件的角色记成:
工具 | 主要负责什么 |
|---|---|
RFdiffusion | 生成新的蛋白骨架 |
ProteinMPNN | 根据骨架设计氨基酸序列 |
AlphaFold/其他结构预测 | 检查序列能否形成预期结构/复合物 |
Rosetta/PyRosetta | 结构优化、界面设计、能量评估 |
Docking | 探索/验证抗原-设计蛋白结合模式 |
MD | 检查复合物动态稳定性 |
BLI/SPR | 实验测结合动力学/亲和力 |
ELISA | 实验检测结合 |
细胞实验 | 验证实际生物学功能 |
十九、如果真正想做“从头抗体”,建议三种路线
路线 ① De novo binder
最适合理解 RFdiffusion:
Target
 ↓
Epitope
 ↓
RFdiffusion
 ↓
Binder backbone
 ↓
ProteinMPNN
 ↓
Binder sequence
它得到的是:
全新的蛋白结合分子
不一定是传统 IgG 抗体。
路线 ② Antibody scaffold + CDR设计
Target
 ↓
Epitope
 ↓
选择 VH/VL scaffold
 ↓
设计 CDR
 ↓
Antibody structure
 ↓
Docking
 ↓
Optimization
更接近:
传统抗体工程
路线 ③ AI + 抗体库/VDJ
这个与你前面问的 VDJ 可以连接起来:
天然BCR/VDJ repertoire
           ↓
       VH / VL
           ↓
      CDR sequence
           ↓
   Structure prediction
           ↓
Antigen-antibody docking
           ↓
   AI/计算优化
           ↓
Experimental screening
这种路线不是完全 de novo,而是:
从天然免疫受体序列出发进行抗体发现和优化。
二十、总结成一张总图
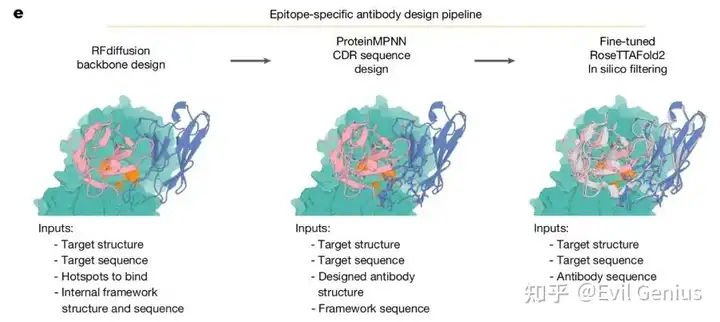
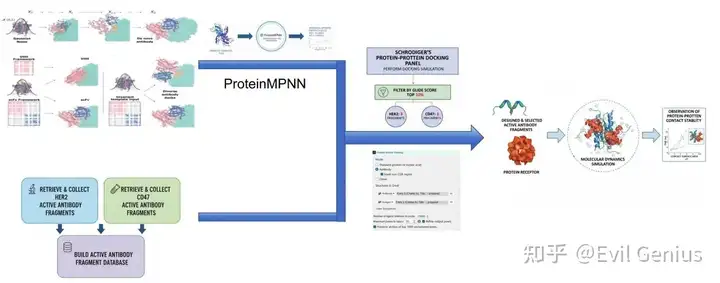
TARGET PROTEIN
                         │
                         ↓
                  Structure analysis
                         │
                         ↓
                     EPITOPE
                         │
                         ↓
                 Hotspot residues
                         │
                         ↓
                  ┌──────────────┐
                  │ RFdiffusion  │
                  └──────┬───────┘
                         ↓
                 Binder backbones
                         │
                         ↓
               Structure filtering
                         │
                         ↓
                  ┌──────────────┐
                  │ ProteinMPNN   │
                  └──────┬───────┘
                         ↓
                  Binder sequences
                         │
                         ↓
              Structure prediction
                         │
                         ↓
               Target + Binder
                         │
                         ↓
               Interface analysis
                         │
             ┌───────────┴───────────┐
             ↓                       ↓
        Target binding          Off-target
             ↓                       ↓
          Positive               Negative
           design                design
             └───────────┬───────────┘
                         ↓
                 Rosetta / PyRosetta
                         ↓
                       MD
                         ↓
                 Candidate ranking
                         ↓
                Experimental test
                         ↓
                     Lead binder
最关键的理解
RFdiffusion ≠ “输入靶蛋白,输出抗体”。
靶蛋白结构 + 目标表位/热点约束 → RFdiffusion生成结合骨架 → ProteinMPNN设计序列 → 结构预测验证 → 界面筛选 → Rosetta/MD优化 → 实验验证。
生活很好,有你更好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号