课后补充--基于配体的虚拟筛选(LBVS)
原创
课后补充--基于配体的虚拟筛选(LBVS)
原创
追风少年i
发布于 2026-09-22 08:46:19
发布于 2026-09-22 08:46:19
作者,Evil Genius
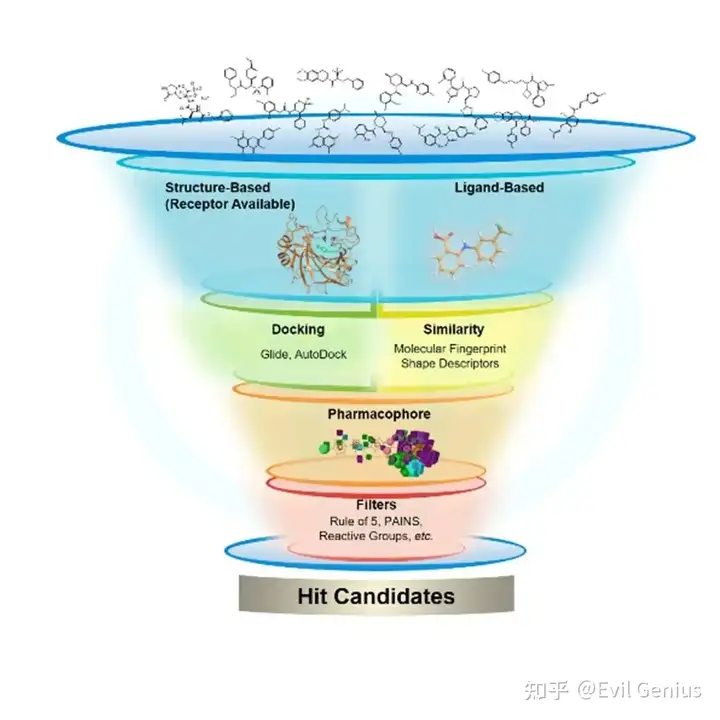
关于虚拟筛选从来不是盲目的把各种配体分子放进去分析,而是要在配体库中基于结构、官能团、ADME进行初步筛选,这其中要求我们有较好的基础研究,虚拟筛选主要分为两种
- 基于结构的虚拟筛选:Structure-Based Virtual Screening (SBVS)
- 基于配体的虚拟筛选:Ligand-Based Virtual Screening (LBVS)
这一篇我们来详细分析一下基于配体的虚拟筛选(LBVS)。
基于配体的虚拟筛选(LBVS)详细分析流程
Ligand-Based Virtual Screening(LBVS) 的核心思想
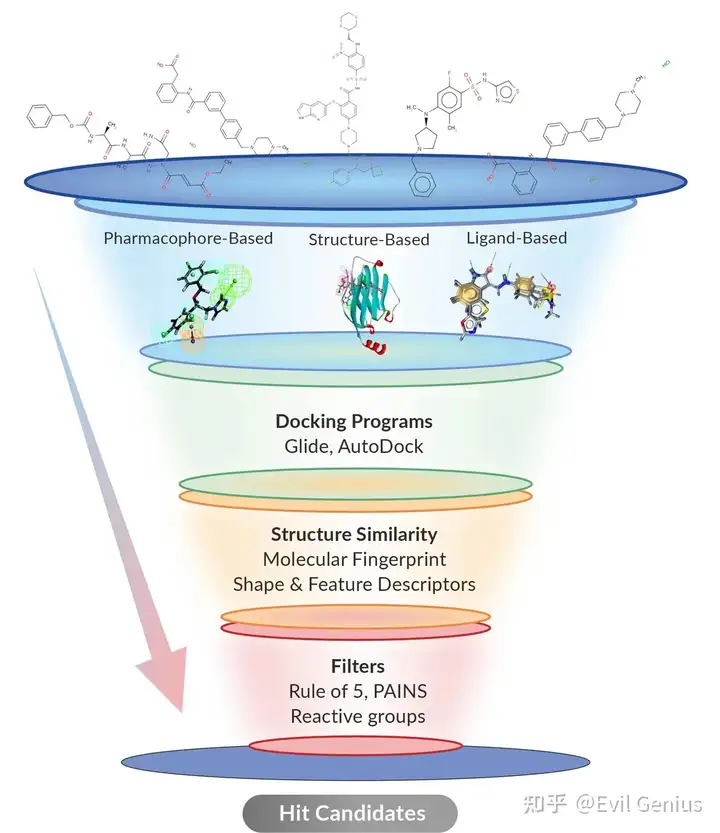
当我们已经知道一些具有生物活性的配体,但没有可靠的靶蛋白三维结构时,可以利用这些已知活性分子的结构、理化性质、共同药效团和构效关系(SAR),从大型化合物库中寻找可能具有相似活性的分子。
LBVS 的主要方法包括 2D 分子相似性、分子指纹、3D 形状相似性、药效团、QSAR/机器学习 等。
一、LBVS 与 SBVS 最核心的区别
项目 | SBVS | LBVS |
|---|---|---|
核心信息 | 蛋白三维结构 | 已知活性配体 |
是否需要蛋白结构 | 通常需要 | 不一定需要 |
是否需要已知活性配体 | 不一定 | 需要 |
主要方法 | Docking、rescoring | Similarity、Fingerprint、Pharmacophore、QSAR |
核心问题 | “分子能不能进入这个口袋?” | “这个分子是否具有类似活性分子的特征?” |
典型输入 | Protein + compound library | Active ligands + compound library |
输出 | Docking poses/scores | Similarity/fit/QSAR prediction |
常用工具 | AutoDock Vina、Glide、GOLD | RDKit、Pharmit、LigandScout、ROCS、QSAR/ML |
LBVS 特别适合靶点结构未知或结构质量不足,但已经存在一定数量已知活性化合物的情况。
二、LBVS 的整体流程
可以把 LBVS 理解成一个“已知活性分子 → 提取规律 → 搜索化学数据库 → 找相似分子”的过程。
已知活性化合物
                       │
                       ↓
              ┌─────────────────┐
              │ 1. 数据收集     │
              │ Active/InActive │
              └─────────────────┘
                       │
                       ↓
              ┌─────────────────┐
              │ 2. 数据清洗     │
              │ 去重/标准化     │
              └─────────────────┘
                       │
                       ↓
          ┌──────────────────────────┐
          │ 3. LBVS模型/特征构建     │
          ├──────────────────────────┤
          │ 2D Similarity            │
          │ Molecular Fingerprint    │
          │ Pharmacophore            │
          │ 3D Shape                 │
          │ QSAR / Machine Learning  │
          └──────────────────────────┘
                       │
                       ↓
                 化合物数据库
                       │
                       ↓
                  Virtual Screening
                       │
                       ↓
                  Hit Ranking
                       │
                       ↓
             去除重复/不合格化合物
                       │
                       ↓
              ADMET / Toxicity
                       │
                       ↓
               Top Candidate
                       │
                       ↓
                Docking / MD
                       │
                       ↓
                  实验验证
LBVS 的主要路线包括 2D similarity、3D similarity、pharmacophore 和 QSAR 等。
三、第一步:收集已知活性化合物
这是 LBVS 最重要的基础。
例如研究:
某蛋白 Kinase-X 的抑制剂
目前已经有 20 个已知抑制剂:
Inhibitor-01
Inhibitor-02
Inhibitor-03
...
Inhibitor-20
每一个分子最好具有:
SMILES
SDF
MOL
MOL2
以及对应的实验活性:
IC50
EC50
Ki
Kd
pIC50
例如:
Compound | IC50 |
|---|---|
C001 | 12 nM |
C002 | 25 nM |
C003 | 48 nM |
C004 | 95 nM |
C005 | 180 nM |
这样就不仅知道:
哪些分子有效
还知道:
哪些分子更有效。
四、第二步:数据清洗
这一部分非常重要,尤其是做 QSAR。
例如原始数据库:
10,000 compounds可能存在:
重复结构
盐形式
不同质子化形式
错误SMILES
缺失活性
单位不一致
实验条件不同
需要进行:
原始数据
   ↓
结构标准化
   ↓
去盐
   ↓
去重
   ↓
统一单位
   ↓
检查异常值
   ↓
Activity classification
例如:
IC50 = 10 nM可以转换为:
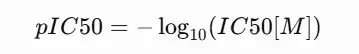
10 nM:
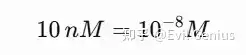
因此:
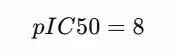
五、第三步:选择 LBVS 方法
LBVS 并不是一种单独的方法。
通常可以分成五大类:
LBVS
│
├── 1. 2D Similarity
│
├── 2. Molecular Fingerprint
│
├── 3. 3D Shape Similarity
│
├── 4. Pharmacophore
│
└── 5. QSAR / Machine Learning
这几种方法实际上是在从不同角度回答:
“两个分子为什么可能具有相似的生物活性?”
六、方法①:2D Molecular Similarity
这是最直观的 LBVS 方法。
例如:
Known Active
     │
     ↓
   Query
     │
     ↓
Database
     │
     ├── Compound A
     ├── Compound B
     ├── Compound C
     └── Compound D
比较它们的:
- scaffold
- functional groups
- atom connectivity
- substructure
例如:
已知活性分子

      O
      ║
Ar ─ N ─ CH3
     │
     R
数据库中:
Compound A

      O
      ║
Ar ─ N ─ CH3
     │
     R1
虽然 R1 不完全相同,但是核心结构高度相似。
因此 A 可能被筛选出来。
七、方法②:Molecular Fingerprint
这是实际 LBVS 中非常常见的方法。
核心思想:
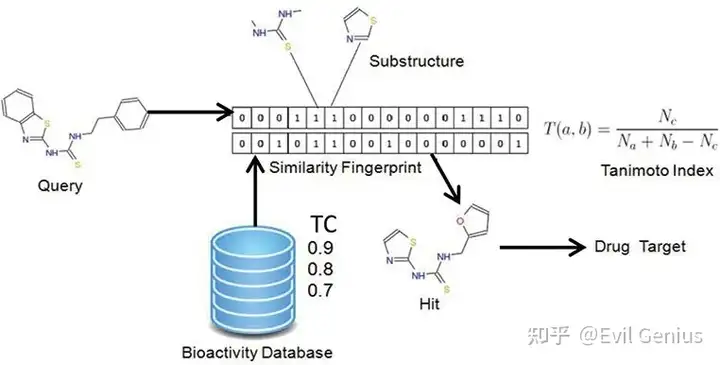
把一个化学结构转换成一串数字/bit,然后比较两个分子的 bit 是否相似。
例如:
Molecule
   ↓
Fingerprint
   ↓

101001001010100101001...
另外一个分子:
100001001010100101101...然后计算 similarity。
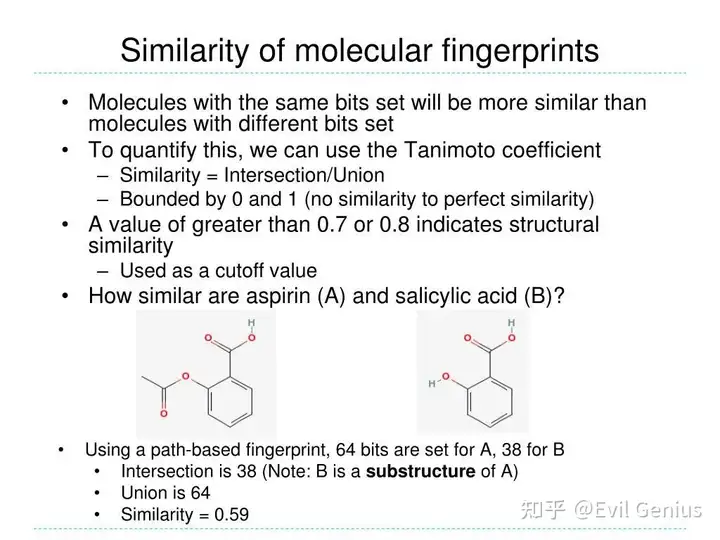
最常见的是 Tanimoto similarity:
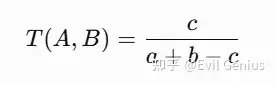
其中:
- a:A 中 bit 数量
- b:B 中 bit 数量
- c:A、B 共同 bit 数量
因此:
Tanimoto = 1表示指纹完全相同;
Tanimoto ≈ 0表示非常不相似。
一个简单例子
假设:
Query molecule
Fingerprint:

101101001110
数据库:
Compound A
101101001010

Compound B
101001000010

Compound C
000010110001
计算之后:
Molecule | Tanimoto |
|---|---|
A | 0.83 |
B | 0.61 |
C | 0.18 |
于是可以按照相似性进行初筛:
Database
100,000
   ↓
Fingerprint similarity
   ↓
Top 5,000
2D fingerprint similarity 是 LBVS 中非常经典的一类方法,因为速度快、容易扩展到大型数据库。
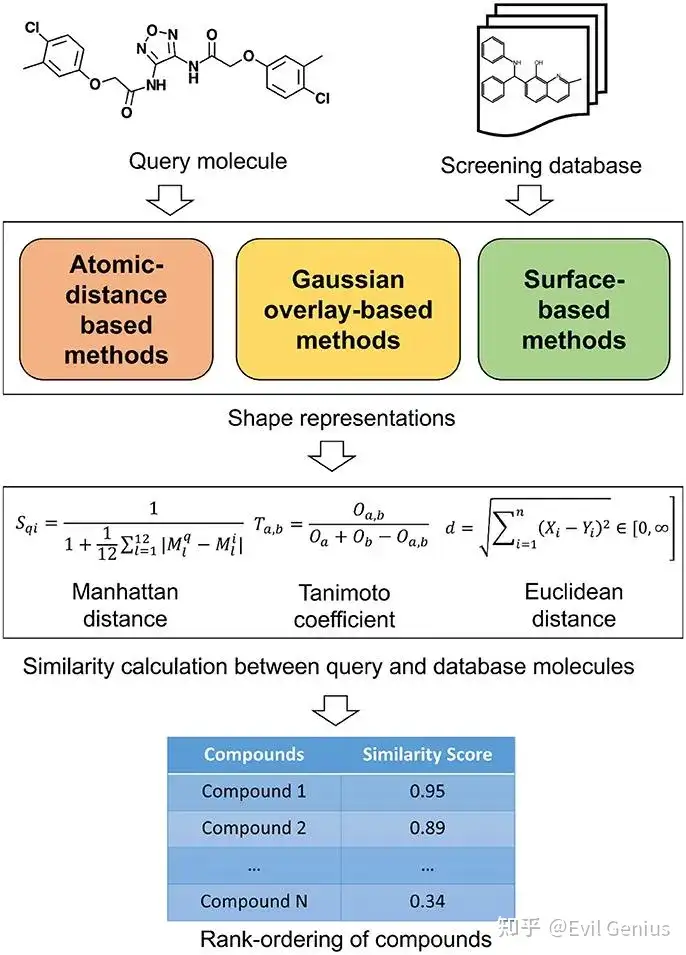
八、方法③:3D Shape Similarity
有些情况下:
两个分子的二维结构并不相似,但是三维形状和关键化学特征非常相似。
例如:
Molecule A

       ███
     ███████
       ███
        │
       ╱
Molecule B:
███
     █████
       ███
        │
       ╲
2D:
可能不太相似3D:
形状非常接近因此 LBVS 可以使用:
- molecular shape
- volume
- surface
- electrostatic potential
- hydrophobicity
- pharmacophoric features
进行 3D similarity search。
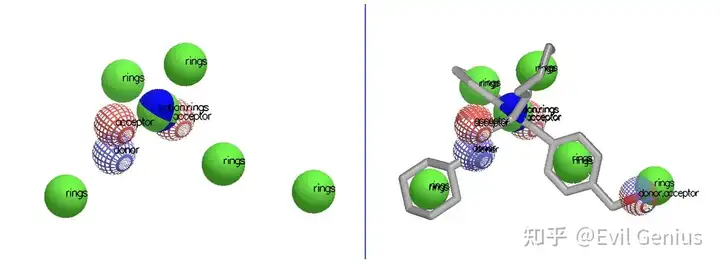
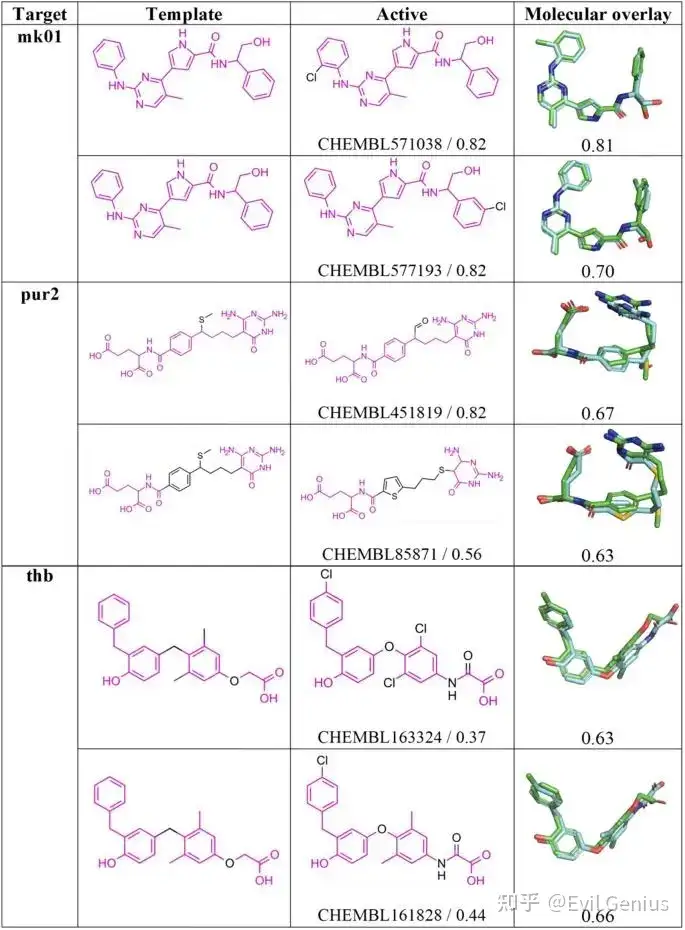
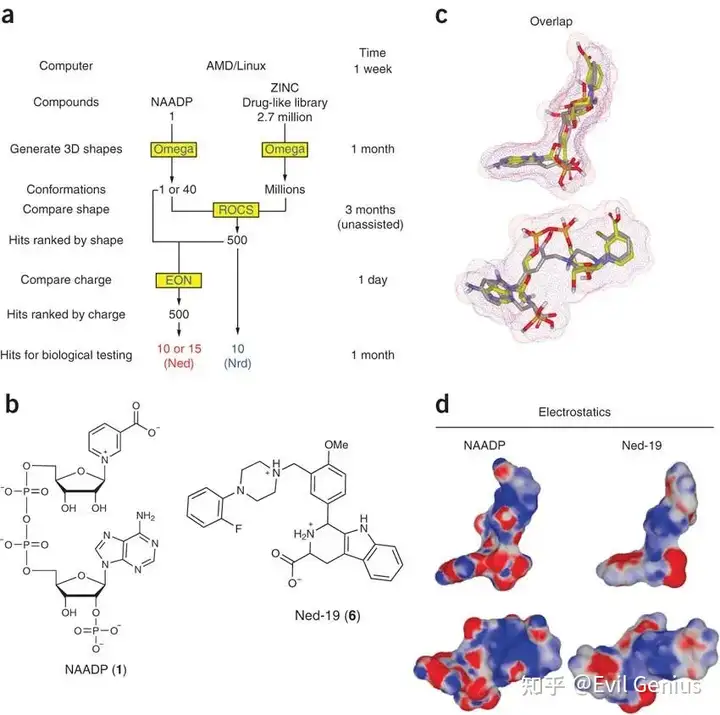
3D similarity 方法通常需要先生成分子的多个构象,再进行 alignment 和 similarity calculation;例如 VSFlow 的流程就是 conformer generation → 3D alignment → shape similarity → 3D pharmacophore similarity。
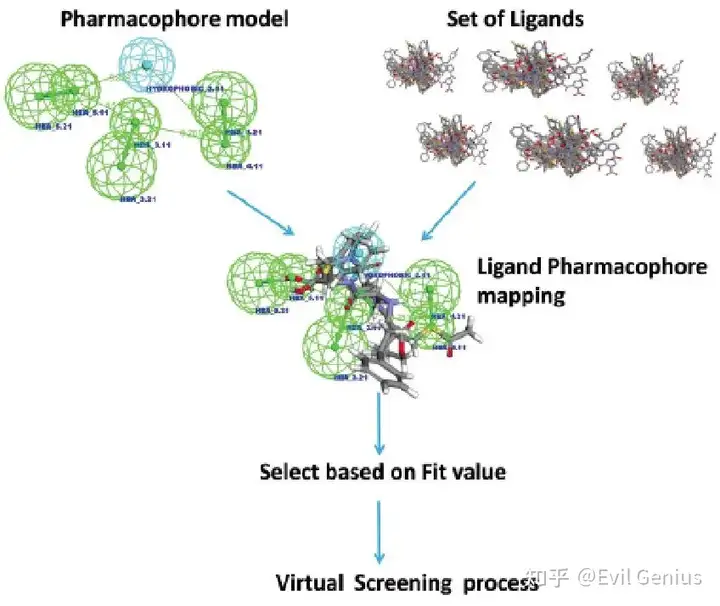
九、方法④:Ligand-Based Pharmacophore
这是 LBVS 中非常重要的一种方法。
这里不再简单问:
两个分子的结构是否相似?
而是问:
它们是否具有相似的关键药效团特征?
例如从多个活性分子发现:
HBA
       ●
       │
       │ 5.2 Å
       │
       ● HBD

       │
       │ 4.8 Å
       │
       ● Hydrophobic
于是构建一个药效团模型:
HBA
       ●
       │
       │
       ● HBD

       │
       │
       ● HYD
这三个特征的空间关系可能是活性的重要组成部分。
常见药效团特征
Feature | 含义 |
|---|---|
HBA | Hydrogen Bond Acceptor |
HBD | Hydrogen Bond Donor |
HY | Hydrophobic |
AR | Aromatic Ring |
POS | Positive ionizable |
NEG | Negative ionizable |
PI | π interaction |
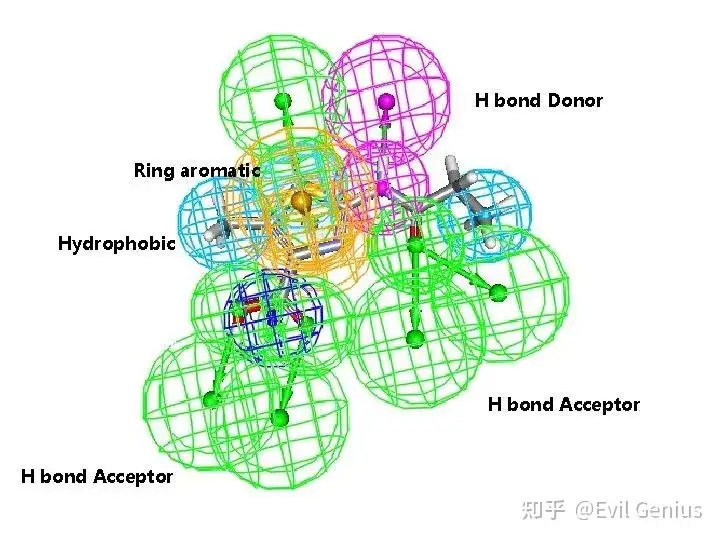
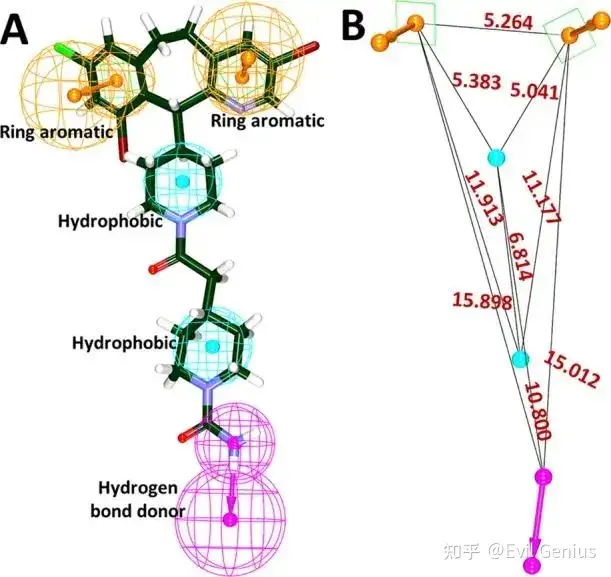
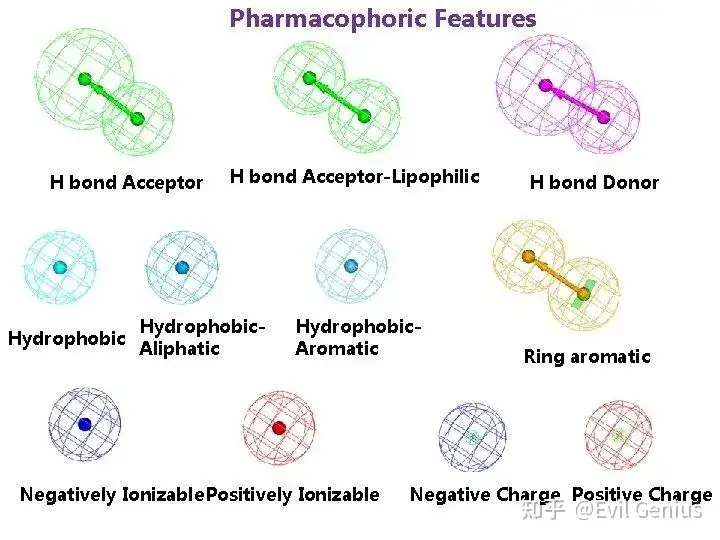
药效团模型通常是从多个已知活性配体中寻找共同的关键特征,并通过 pharmacophore mapping 对数据库分子进行筛选。
十、一个非常直观的药效团案例
假设有 5 个已知抑制剂:
Ligand 1
Ligand 2
Ligand 3
Ligand 4
Ligand 5
虽然它们的结构不同:
A        B        C        D        E
│        │        │        │        │
不同     不同     不同     不同     不同
但是经过 3D alignment 后发现:
HBA
         ●

         │
         │  5 Å
         │

         ● HBD

     ╲         ╱
      ╲       ╱
       ●─────●
      Hyd   Aromatic
说明它们可能共享:
HBA
+
HBD
+
Hydrophobic
+
Aromatic
那么就建立这个 LB pharmacophore。
然后:
100,000 compounds
        ↓
Pharmacophore screening
        ↓
3,000
        ↓
Fit score
        ↓
300
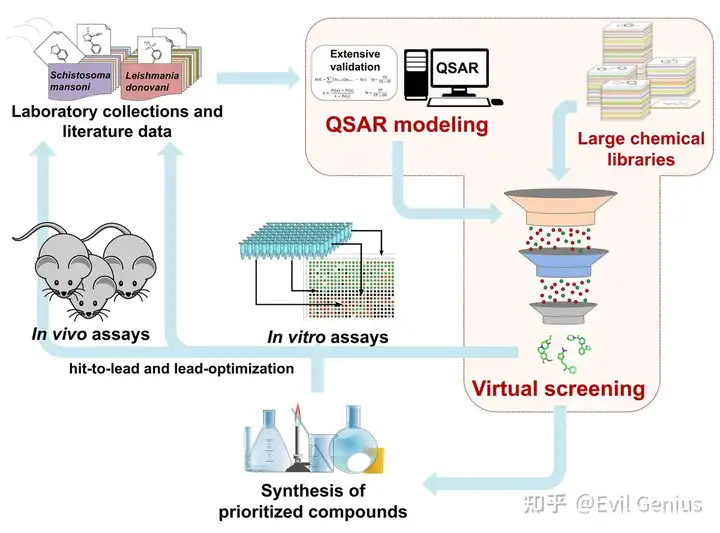
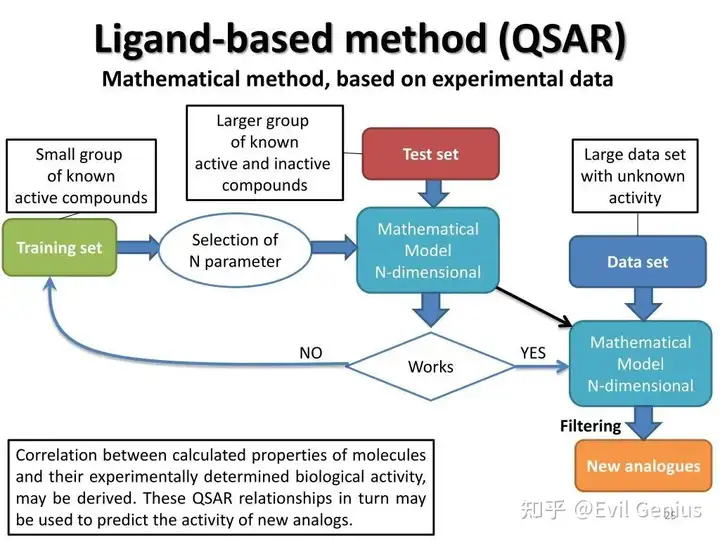
十一、方法⑤:QSAR
QSAR 是另一条非常重要的 LBVS 路线。
它不是简单比较:
“这个分子像不像已知分子?”
而是建立:
分子结构 → 生物活性
之间的数学关系。
例如:
Molecular structure
       ↓
Descriptors
       ↓
Machine Learning
       ↓
Predicted activity
输入
例如:
MW
LogP
TPSA
HBD
HBA
Rotatable bonds
Aromatic rings
Morgan fingerprint
ECFP
Molecular descriptors
以及实验:
IC50于是:
Compound
   ↓
Descriptors
   ↓
QSAR model
   ↓
Predicted pIC50
QSAR 可以处理连续变量,例如 pIC50、pEC50、Ki,也可以进行 active/inactive 分类。
十二、QSAR 建模的完整流程
例如我们有:
1,000 known compounds首先:
1000
 ↓
Data cleaning
 ↓
Descriptor calculation
 ↓
Feature selection
然后划分:
1000 compounds
                    │
          ┌─────────┴─────────┐
          ↓                   ↓
       Training             Test
        800                  200
训练:
Training set
     ↓
Random Forest
XGBoost
SVM
Neural Network
     ↓
QSAR model
然后:
Test set
   ↓
Prediction
   ↓
R²
RMSE
MAE
ROC-AUC
如果模型具有合理的外部预测性能,再用于:
100,000 unknown compounds
        ↓
QSAR prediction
        ↓
Predicted active
        ↓
Candidate compounds
QSAR 的一个关键要求是数据质量和外部验证;仅仅训练集拟合得很好,并不代表模型对新化合物具有可靠预测能力。
十三、LBVS 最典型的“漏斗式筛选”
例如有:
100,000 个化合物
第一层:Fingerprint
100,000
    ↓
Tanimoto > 0.5
    ↓
20,000
第二层:Pharmacophore
20,000
    ↓
Pharmacophore fit
    ↓
3,000
第三层:3D Shape
3,000
    ↓
Shape similarity
    ↓
500
第四层:QSAR
500
 ↓
Predicted activity
 ↓
100
第五层:ADMET
100
 ↓
ADMET
 ↓
30
第六层:SBVS
这时候就可以把 LBVS 得到的 30 个分子交给:
AutoDock Vina
30 compounds
      ↓
Protein docking
      ↓
Pose
      ↓
Binding interactions
这样就形成:
LBVS → SBVS → MD
的组合流程。
十四、一个完整的 LBVS 示例
假设我们研究:
某蛋白 Kinase-X 抑制剂
目前:
- 没有可靠的蛋白晶体结构
- 已经发现 30 个已知抑制剂
- 有它们的 IC50
那么非常适合先做 LBVS。
Step 1:收集 30 个活性分子
C001
C002
...
C030
例如:
Compound | IC50 |
|---|---|
C001 | 8 nM |
C002 | 15 nM |
C003 | 20 nM |
C004 | 45 nM |
C005 | 80 nM |
Step 2:选择高活性分子
例如定义:
IC50 < 100 nM作为 active set。
然后:
30 compounds
      ↓
Active compounds
      ↓
20 compounds
Step 3:计算 Fingerprint
例如使用:
Morgan fingerprint
radius = 2
nBits = 2048
得到:
C001
↓
2048-bit fingerprint
然后与数据库比较。
Step 4:Similarity Search
数据库:
1,000,000 compounds计算:
Tanimoto(C001, database)得到:
Compound | Similarity |
|---|---|
DB_001 | 0.91 |
DB_002 | 0.87 |
DB_003 | 0.84 |
DB_004 | 0.81 |
DB_005 | 0.79 |
得到:
Top 10,000十五、接下来建立 Pharmacophore
把 20 个 active molecules 做共同特征分析:
Active 1
Active 2
Active 3
...
Active 20
得到:
HBA
HBD
Hydrophobic
Aromatic
建立:
HBA
         ●

         │

         ● HBD

      ●
    Aromatic

         ●
      Hydrophobic
筛选:
10,000
 ↓
Pharmacophore
 ↓
1,000
十六、再做 QSAR
使用已有:
30 active/inactive compounds或者更大的可靠活性数据集建立模型:
Molecule
 ↓
Fingerprint
 ↓
Descriptor
 ↓
Random Forest / XGBoost
 ↓
Predicted pIC50
筛:
1,000
 ↓
Predicted active
 ↓
100
十七、ADMET 筛选
100 个分子继续检查:
100
         ↓
 ┌───────────────┐
 │ Solubility    │
 │ Permeability  │
 │ CYP           │
 │ hERG          │
 │ Toxicity      │
 └───────────────┘
         ↓
       30
最终:
30 candidate molecules十八、如果后来获得蛋白结构
这时候就可以进行:
LBVS
               ↓
          100,000
               ↓
            1,000
               ↓
             100
               ↓
               30
               │
               ↓
        Protein structure
               │
               ↓
       AutoDock Vina
               ↓
       Docking analysis
               ↓
               10
               ↓
              MD
               ↓
        Experimental assay
这就是非常典型的:
LBVS + SBVS Hybrid Virtual Screening
将 ligand-based 和 structure-based 方法结合使用,可以分别利用已知配体的 SAR 信息和靶点结构信息;组合方式可以是 sequential、parallel 或 hybrid。
十九、LBVS 的五种方法放在一起
方法 | 核心思想 | 典型输入 | 输出 |
|---|---|---|---|
2D Similarity | 结构是否相似 | SMILES/2D | Similarity |
Fingerprint | 子结构模式是否相似 | Molecular fingerprint | Tanimoto |
3D Shape | 三维形状是否相似 | 3D conformers | Shape score |
Pharmacophore | 关键功能特征是否相似 | Active ligands | Fit score |
QSAR/ML | 结构与活性之间的关系 | Structure + activity | Predicted activity |
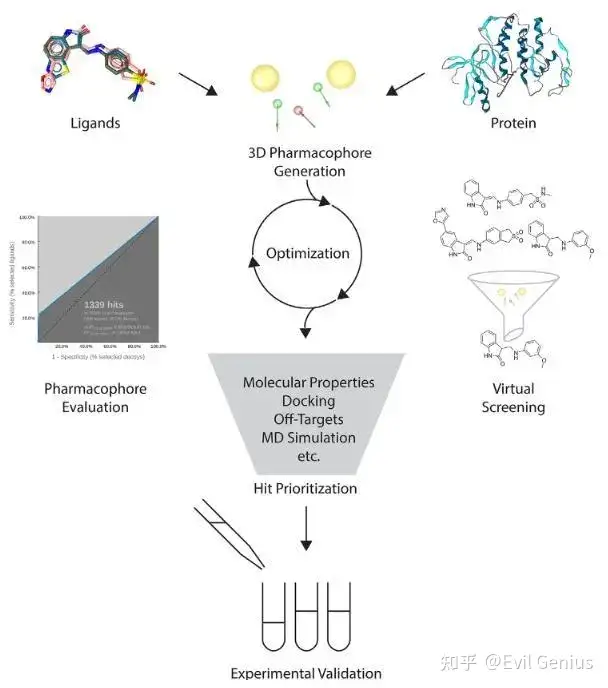
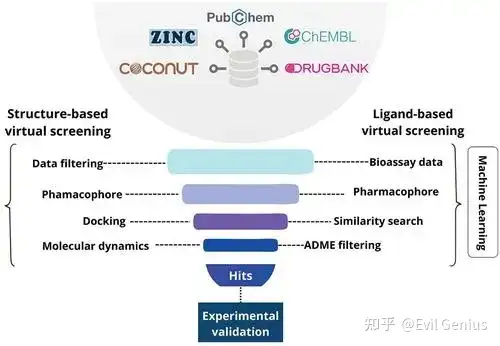
这些方法并不是互相排斥的。实际工作中经常采用多级筛选,例如先用快速 2D similarity/fingerprint 缩小数据库,再使用 3D shape/pharmacophore 和 QSAR 进一步筛选。
二十、LBVS 与 SBVS 的关系
可以把两种方法非常直观地理解成:
SBVS
知道“锁”的结构
        ↓
研究锁的形状
        ↓
寻找能够进入锁的钥匙
即:
Protein structure
       ↓
Binding pocket
       ↓
Docking
       ↓
Candidate
LBVS
已经知道几把“有效钥匙”
        ↓
总结这些钥匙的共同特征
        ↓
寻找结构/性质相似的新钥匙
即:
Known active ligands
       ↓
Similarity / Pharmacophore / QSAR
       ↓
Database
       ↓
New candidates
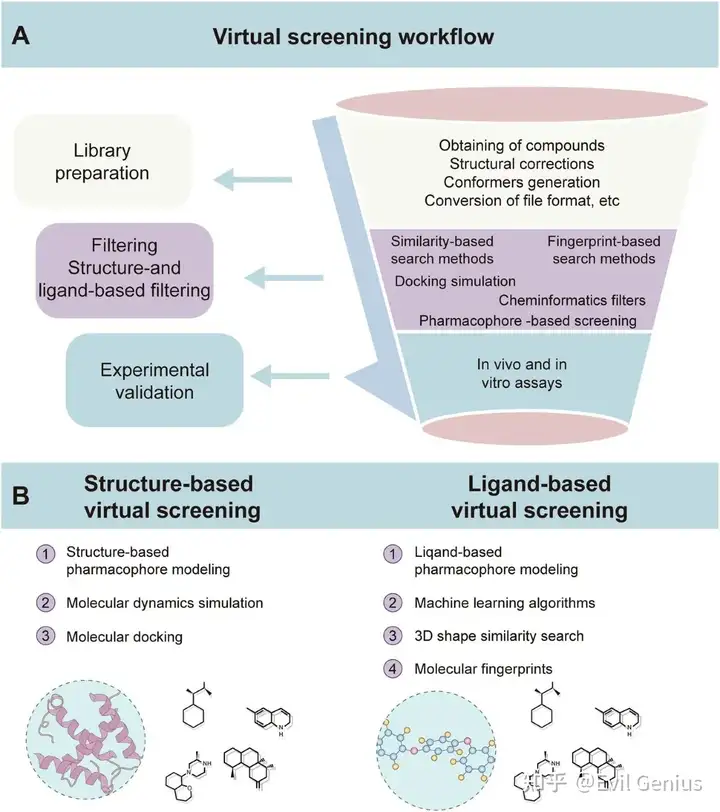
二十一、LBVS 最值得注意的局限
① 最大问题:相似 ≠ 活性一定相同
两个分子:
Tanimoto = 0.85并不能保证它们一定具有相同的生物活性。
分子相似性方法的效果高度依赖于目标体系的结构–活性关系(SAR),而不同相似性方法也可能找到不同的候选集合。
② 容易产生“相似性偏倚”
如果数据库里面已有:
A scaffold
A scaffold
A scaffold
A scaffold
A scaffold
LBVS 很可能继续找到:
A scaffold derivatives因此虽然命中率可能不错,但:
化学空间探索可能比较窄。
这也是为什么实际虚拟筛选经常加入scaffold diversity / chemical diversity控制。
③ QSAR 对数据质量非常敏感
如果:
实验数据不一致
        ↓
错误 IC50
        ↓
错误训练集
        ↓
错误 QSAR
        ↓
错误预测
所以 QSAR 中:
数据整理和外部验证的重要性甚至不低于模型本身。
最后总结
可以把 LBVS 最终总结成:
已知活性配体
                  │
                  ↓
        ┌──────────────────┐
        │   数据整理        │
        │ Active / Inactive│
        └──────────────────┘
                  │
        ┌─────────┼─────────┐
        ↓         ↓         ↓
    2D相似性   Fingerprint  Pharmacophore
        │         │         │
        └─────────┼─────────┘
                  ↓
             3D Shape
                  │
                  ↓
             QSAR / ML
                  │
                  ↓
           化合物数据库
                  │
                  ↓
            Virtual Screening
                  │
                  ↓
             Hit Ranking
                  │
                  ↓
          Chemical Diversity
                  │
                  ↓
              ADMET
                  │
                  ↓
            Candidate Hits
                  │
                  ↓
          ┌───────┴────────┐
          ↓                ↓
      Docking              MD
          ↓                ↓
          └───────┬────────┘
                  ↓
              实验验证
一句话概括 LBVS:
SBVS 是“从蛋白口袋出发找配体”,LBVS 是“从已知活性配体出发找新配体”。
生活很好,有你更好。课后补充--基于配体的虚拟筛选(LBVS)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号