课后补充--基于结构的虚拟筛选(SBVS)
原创
课后补充--基于结构的虚拟筛选(SBVS)
原创
追风少年i
发布于 2026-09-21 09:13:00
发布于 2026-09-21 09:13:00
作者,Evil Genius
大家其实不用太焦虑,大家的处境绝对比我好,我被迫当无业游民很久了,什么都没有,当然也看开了,活着就行。
很多人失业了,其实也不是什么可怕的事情,休息休息,短暂的停留再出发,哪有什么一帆风顺的事情。
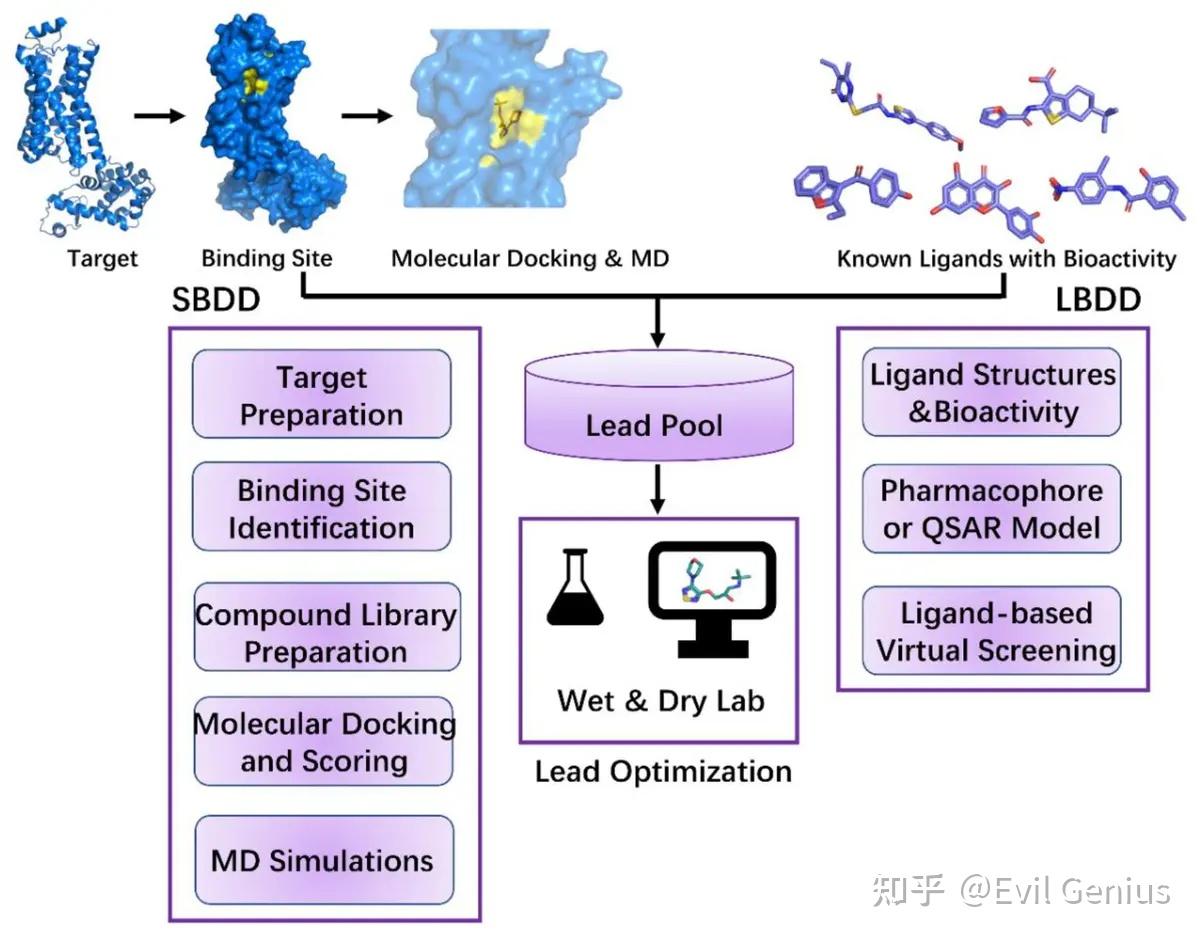
关于虚拟筛选从来不是盲目的把各种配体分子放进去分析,而是要在配体库中基于结构、官能团、ADME进行初步筛选,这其中要求我们有较好的基础研究,虚拟筛选主要分为两种
- 基于结构的虚拟筛选:Structure-Based Virtual Screening (SBVS)
- 基于配体的虚拟筛选:Ligand-Based Virtual Screening (LBVS)
学习呢,其实是一个成本最低的事情,就是需要时间来研究,最怕半途而废,如果无法坚持,不如不学,好好玩玩放松心情,如果决定学习,就一定要学会,半学不学的结果就是技能没学会,时间浪费了,两头都不沾。
这一篇我们来详细分析一下基于结构的虚拟筛选(SBVS)。
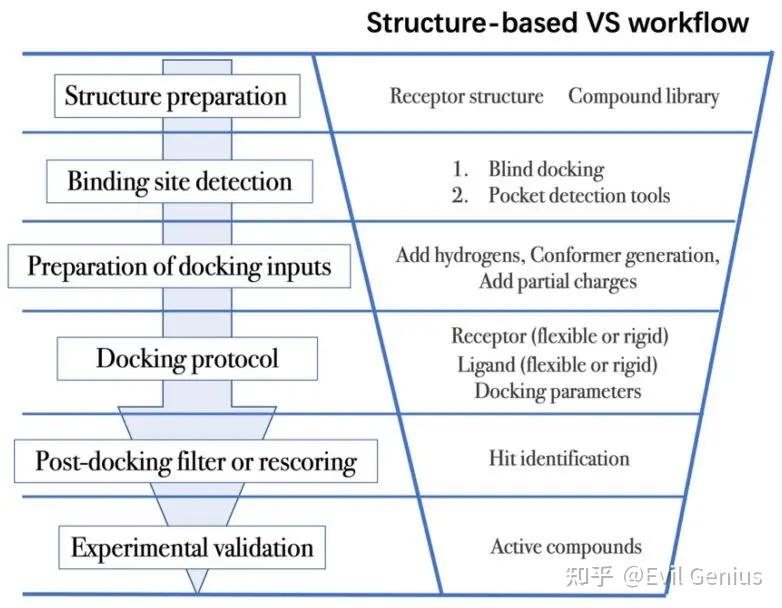
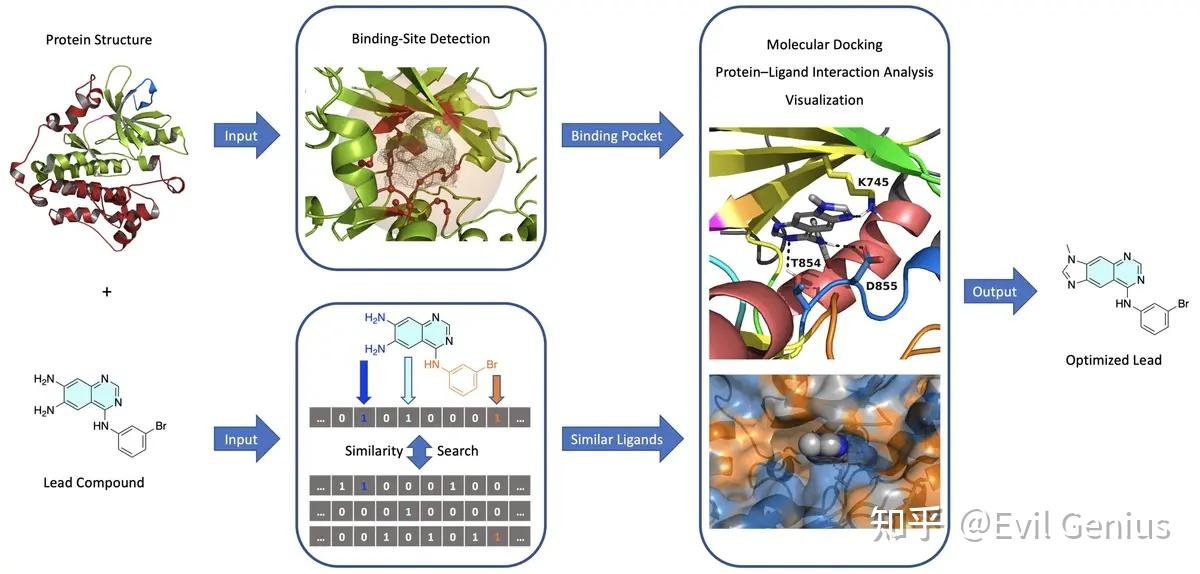
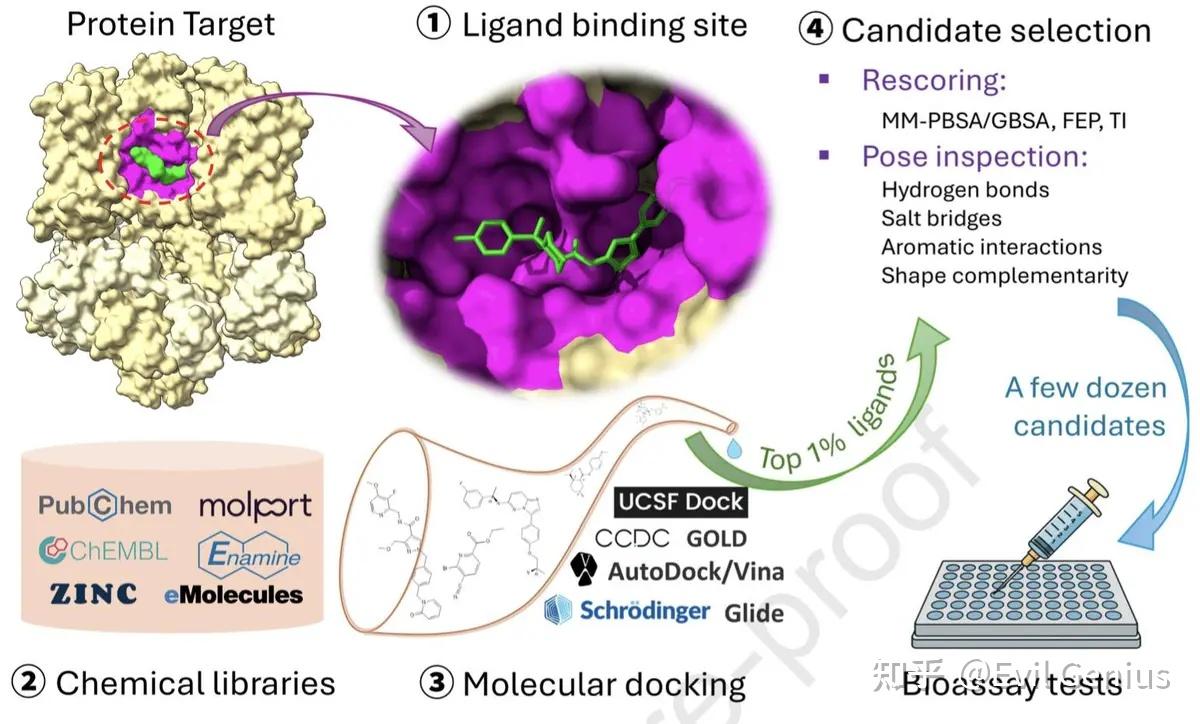
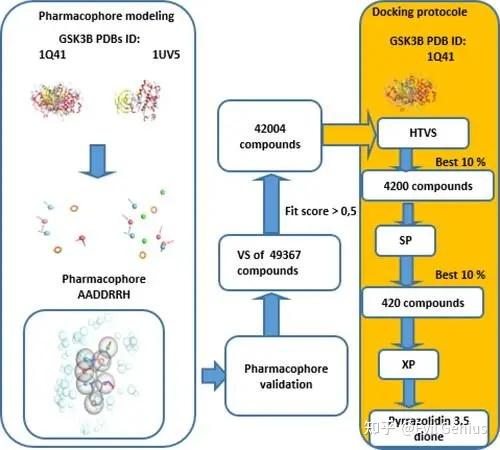
Structure-Based Virtual Screening(SBVS) 的核心思想是:已知靶蛋白三维结构 → 找到/定义结合口袋 → 准备大规模化合物库 → 分子对接 → 按打分和相互作用逐级筛选 → 进一步重打分/MD → 实验验证。
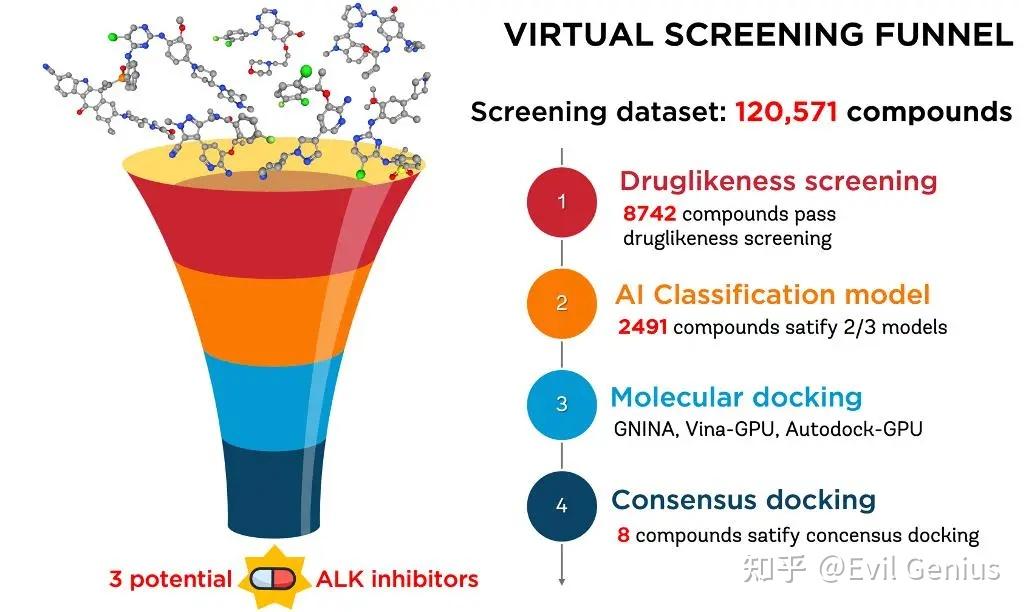
与单纯“把几万个分子全部做一次 Vina”相比,一个比较规范的 SBVS 通常是多级漏斗式筛选。分子对接是 SBVS 的核心环节,但不是整个 SBVS。
一、SBVS 的整体逻辑
可以把整个过程理解成:
靶蛋白三维结构
                         │
                         ↓
              ┌────────────────────┐
              │ 1. 靶蛋白结构准备  │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ 2. 结合口袋确定    │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ 3. 化合物数据库准备 │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ 4. 化合物预筛选     │
              │ ADMET / Drug-like  │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ 5. 高通量分子对接   │
              │ AutoDock Vina等     │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ 6. Docking Score排序│
              └────────────────────┘
                         │
                    Top 1–10%
                         ↓
              ┌────────────────────┐
              │ 7. 相互作用分析     │
              │ H-bond/π/疏水/盐桥 │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ 8. 重打分/二次对接  │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ 9. MD / MM-PBSA    │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ 10. 实验验证        │
              └────────────────────┘
文献中的典型 SBVS 流程也包括靶点结构准备、binding-site detection、docking、ranking/rescoring 和实验验证等阶段。
二、第一步:获得靶蛋白三维结构
SBVS 与 LBVS 最大的区别之一就是:
SBVS 必须利用靶蛋白的三维结构信息。
结构来源主要有:
来源 | 说明 |
|---|---|
X-ray | 药物设计中非常常见 |
Cryo-EM | 大型蛋白/复合物越来越常见 |
NMR | 部分蛋白 |
AlphaFold | 没有实验结构时可以作为模型 |
Homology modeling | 有同源结构时可建模 |
Protein–ligand complex | 最适合确定已知结合口袋 |
例如:
PDB
 │
 ↓
8xxx.pdb
 │
 ├── Protein
 ├── Ligand
 ├── Water
 ├── Ion
 └── Cofactor
如果 PDB 本身存在共晶配体,那么这个配体的位置通常可以帮助确定 docking box。
三、第二步:蛋白结构准备
主要处理:
PDB
 │
 ├── 删除无关水分子
 ├── 删除无关配体
 ├── 检查缺失残基
 ├── 检查残基名称
 ├── 添加氢原子
 ├── 确定质子化状态
 ├── 添加电荷
 ├── 检查金属离子
 └── 生成 docking 输入文件
reduce protein.pdb > protein_H.pdb
然后使用 MGLTools:
prepare_receptor4.py \
    -r protein_H.pdb \
    -o protein.pdbqt \
    -A hydrogens
最终:
protein.pdb
      ↓
protein_H.pdb
      ↓
protein.pdbqt
对于 AutoDock Vina,受体和配体通常使用 PDBQT 格式;Vina 本身不需要传统 AutoGrid 的 GPF 和 grid map 文件。
四、第三步:确定 Binding Site
这是 SBVS 中非常关键的一步。
因为实际上需要回答:
小分子究竟应该被放进蛋白的哪个位置?
常见方法:
方法① 共晶配体
最可靠、最直观。
Protein
   ↓
[ Binding Pocket ]
       ↑
    Crystal ligand
例如:
Protein
     ┌───────────────┐
     │               │
     │      ███      │
     │     █████     │ ← 共晶配体
     │      ███      │
     │               │
     └───────────────┘
             ↓
       定义 docking box
方法② 已知关键残基
例如已经知道:
HIS41
CYS145
GLY143
SER144
参与活性位点。
那么可以围绕这些残基设置 docking box。
方法③ Binding pocket prediction
没有共晶配体时,可以使用:
- P2Rank
- fpocket
- DoGSite
- CASTp
- SiteMap
- Cavity detection
方法④ Blind docking
完全不知道结合位置时:
整个蛋白表面
        ↓
   Blind docking
        ↓
多个潜在结合区域
        ↓
寻找 cluster
        ↓
确定候选 pocket
但 blind docking 计算量通常更大,而且假阳性问题更明显。
五、第四步:建立化合物数据库
按照我们课程的方式准备:
compound_001
compound_002
compound_003
...
compound_100000
来源可以是:
- ZINC
- ChEMBL
- PubChem
- Enamine
- 自建化合物库
- 天然产物数据库
- 药物数据库
SBVS 的优势就是可以从非常大的化学空间中进行筛选。传统 docking-based VS 的基本形式就是对化合物库逐个进行 docking,再得到排序后的候选列表。
六、第五步:Ligand Preparation
假设原始数据库:
library.sdf需要转换成适合 docking 的形式。
例如:
SDF
 ↓
去重
 ↓
标准化
 ↓
检查结构
 ↓
添加H
 ↓
生成3D
 ↓
确定质子化状态
 ↓
确定互变异构体
 ↓
计算电荷
 ↓
生成多个构象
 ↓
PDBQT
例如:
obabel library.sdf \
    -O library.pdb \
    --gen3d
再进行 ligand preparation。
七、第六步:化合物预筛选
这里非常重要。
不建议把所有分子直接扔进 docking。
可以先进行:
100000 compounds
        ↓
结构质量过滤
        ↓
90,000
        ↓
PAINS / reactive group
        ↓
80,000
        ↓
Drug-like filter
        ↓
60,000
        ↓
ADMET filter
        ↓
30,000
        ↓
Docking
可以考虑:
Lipinski Rule of Five
例如:
参数 | 常见参考 |
|---|---|
MW | ≤500 Da |
logP | ≤5 |
HBD | ≤5 |
HBA | ≤10 |
但要注意:
这些不是绝对的“能成药/不能成药”标准。
八、第七步:高通量 Docking
例如:
vina \
--receptor protein.pdbqt \
--ligand ligand.pdbqt \
--config config.txt \
--out result.pdbqt \
--log result.log
config:
receptor = protein.pdbqt

center_x = -15
center_y = 15
center_z = 129

size_x = 20
size_y = 20
size_z = 20

exhaustiveness = 8
num_modes = 10
energy_range = 3
如果有 10,000 个分子:
ligand001.pdbqt → Vina
ligand002.pdbqt → Vina
ligand003.pdbqt → Vina
...
ligand10000.pdbqt → Vina
最后得到:
Ligand       Best Affinity
ligand001      -7.2
ligand002      -8.5
ligand003      -6.9
...
Vina 官方文档也提供了直接使用 Bash 对多个 ligand 进行 virtual screening 的方法。
九、一个实际的虚拟筛选结果
假设筛选:
10,000 个化合物
得到:
Rank | Ligand | Vina Affinity |
|---|---|---|
1 | Ligand_08321 | -10.2 |
2 | Ligand_02145 | -9.8 |
3 | Ligand_06432 | -9.6 |
4 | Ligand_00987 | -9.4 |
5 | Ligand_07654 | -9.3 |
6 | Ligand_04231 | -9.2 |
7 | Ligand_00321 | -9.1 |
8 | Ligand_08765 | -9.0 |
9 | Ligand_01234 | -8.9 |
10 | Ligand_05543 | -8.8 |
但是:
不能简单认为 -10.2 kcal/mol 就一定比 -9.8 kcal/mol 的化合物真实结合能力强。
Docking score 更适合作为排序和优先级筛选指标,而不是实验结合自由能的直接替代品。传统 docking 方法本质上是在搜索配体构象并利用 scoring function 评价候选 pose。
十、第八步:不要只看 Docking Score
这是 SBVS 分析中非常重要的一点。
例如:
Compound A
Affinity = -10.5 kcal/mol

Compound B
Affinity = -9.6 kcal/mol
但是:
Compound A
蛋白
 ↓

ARG
     ❌
    ligand

大量疏水原子暴露
没有关键氢键
构象异常
Compound B
ASP ─── H-bond ─── ligand
TYR ─── π-π ───── ligand
PHE ─── hydrophobic ─ ligand
那么 B 可能反而更值得进一步研究。
所以虚拟筛选不能变成:
Score排序
      ↓
直接买Top 10
而应该:
Docking score
       +
Pose
       +
Interaction
       +
Chemical quality
       +
ADMET
       +
Structural novelty
       ↓
Candidate selection
十一、第九步:分析 Protein–Ligand Interaction
重点分析:
① Hydrogen bond
例如:
Protein ASP
      O
      |
      |  H-bond
      |
      H
      |
Ligand N
常见分析:
- donor
- acceptor
- distance
- angle
② Hydrophobic interaction
例如:
PHE
TYR
LEU
ILE
VAL
MET
与 ligand 的疏水区域形成相互作用。
③ π–π interaction
常见:
PHE
TYR
TRP
HIS
与芳香环形成 π–π stacking。
④ Salt bridge
例如:
ARG+  --------  COO-
LYS+  --------  COO-
⑤ π-cation
例如:
PHE
     ╱────╲
     ╲────╱
        ↑
       NH3+
⑥ Metal coordination
如果你的体系包含:
Zn²⁺
Mg²⁺
Fe²⁺
Mn²⁺
Ca²⁺
就必须额外考虑:
Protein
    │
    O
    │
  Zn²⁺
   / \
  N   O
   \ /
 Ligand
这种体系不能简单按照普通有机小分子 docking 来解释,需要特别检查配位几何、金属参数和距离。
十二、第十步:从 10,000 → 1,000 → 100 → 20
真正比较合理的 SBVS 是一个漏斗。
例如:
100,000 compounds
                    │
                    ↓
             ┌──────────────┐
             │ Drug-like    │
             │ ADMET filter │
             └──────────────┘
                    │
                    ↓
              50,000
                    │
                    ↓
            High-throughput
                docking
                    │
                    ↓
               5,000
                    │
                    ↓
             score filter
                    │
                    ↓
                500
                    │
                    ↓
          interaction analysis
                    │
                    ↓
                100
                    │
                    ↓
            second docking
                    │
                    ↓
                 30
                    │
                    ↓
             MD / rescoring
                    │
                    ↓
                 10
                    │
                    ↓
             实验验证
                    │
                    ↓
Hit compounds这也是为什么SBVS 不应该简单等同于 molecular docking。
十三、第十一步:Consensus Docking
如果条件允许,可以使用多个 docking 程序。
例如:
Compound Library
                    │
        ┌───────────┼───────────┐
        ↓           ↓           ↓
      Vina         GOLD       Glide
        ↓           ↓           ↓
      Score        Score       Score
        └───────────┼───────────┘
                    ↓
             Consensus ranking
或者同一个程序进行不同参数/不同 receptor conformations docking。
这样可以减少:
某一个 scoring function 本身造成的偏差。
Consensus docking 和 rescoring 已经被广泛用于高通量虚拟筛选流程。
十四、第十二步:Rescoring
Top 100 或 Top 50 可以进一步做:
MM-GBSA
或者:
MM-PBSA
流程:
Top docking hits
       ↓
Molecular Dynamics
       ↓
trajectory
       ↓
MM-PBSA / MM-GBSA
       ↓
ΔGbind
例如:
Ligand | Docking | MM-GBSA |
|---|---|---|
L1 | -9.8 | -42.1 |
L2 | -10.1 | -31.2 |
L3 | -9.4 | -45.7 |
L4 | -9.7 | -28.4 |
这样可以进一步从不同角度评价候选物。
不过 MM-PBSA/MM-GBSA 同样具有模型假设和参数依赖性,不应把结果直接当作实验自由能。
十五、第十三步:MD验证
对于最终的:
Top 5–20 compounds可以进入 GROMACS:
Protein + Ligand
       ↓
Topology
       ↓
Energy minimization
       ↓
NVT
       ↓
NPT
       ↓
Production MD
       ↓
100 ns / 200 ns / 500 ns
然后分析:
RMSD
Protein RMSD
Ligand RMSD
RMSF
哪些残基波动明显?Radius of gyration
蛋白整体稳定性Hydrogen bonds
Ligand-protein H-bondDistance
例如:
Ligand
   |
   | 3.1 Å
   |
ASP
MM-PBSA
最后综合评价。
十六、一个完整案例
假设:
目标蛋白:某激酶 Kinase-X
已经有:
PDB = 8XXX并且共晶配体位于 ATP binding pocket。
Step 1:蛋白
8XXX.pdb
   ↓
删除无关分子
   ↓
加氢
   ↓
确定质子化
   ↓
protein.pdbqt
Step 2:确定口袋
发现:
VAIK
HRD
DFG
以及共晶配体周围残基。
设置:
center_x = 12.5
center_y = -3.2
center_z = 18.7

size_x = 22
size_y = 22
size_z = 22
Step 3:准备化合物
例如:
100,000 compounds经过:
duplicate removal
        ↓
structure filtering
        ↓
Lipinski
        ↓
PAINS
        ↓
ADMET
剩:
40,000 compoundsStep 4:Vina
40,000
   ↓
Docking
   ↓
40,000 docking scores
Step 5:初筛
选择:
Top 1%得到:
400 compoundsStep 6:Interaction analysis
进一步检查:
hinge region
     +
H-bond
     +
hydrophobic pocket
     +
DFG region
     +
gatekeeper residue
最终:
400
 ↓
100
Step 7:第二轮 docking
使用:
higher exhaustiveness或者:
different docking software进一步:
100
 ↓
30
Step 8:ADMET
30
 ↓
toxicity
 ↓
solubility
 ↓
permeability
 ↓
CYP
 ↓
hERG
最后:
30
 ↓
15
Step 9:MD
15 compounds
 ↓
MD
 ↓
RMSD
RMSF
H-bond
MM-PBSA
 ↓
5 compounds
Step 10:实验
5 compounds
 ↓
Protein binding assay
 ↓
IC50 / Kd
 ↓
Biological validation
最终得到真正值得进一步研究的 hit。
十七、SBVS 最终可以整理成这张“科研流程图”
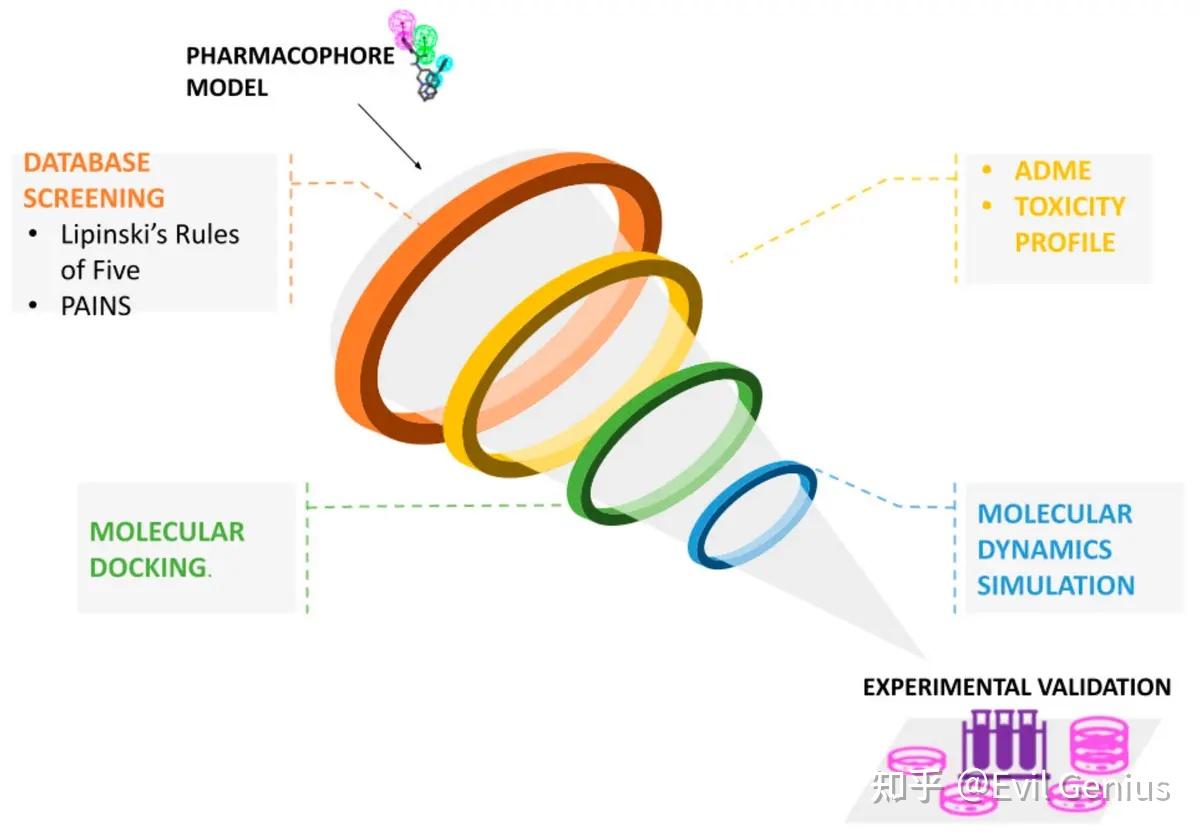
STRUCTURE-BASED VIRTUAL SCREENING
                         │
                         ↓
              ┌────────────────────┐
              │ Target structure   │
              │ PDB / AlphaFold    │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ Protein preparation│
              │ H / charge / water │
              └────────────────────┘
                         │
                         ↓
              ┌────────────────────┐
              │ Binding-site       │
              │ identification     │
              └────────────────────┘
                         │
                         ↓
       ┌─────────────────────────────────────┐
       │         Compound library             │
       │  ZINC / ChEMBL / PubChem / in-house │
       └─────────────────────────────────────┘
                         │
                         ↓
                 Ligand preparation
                         │
                         ↓
                  Drug-like filter
                         │
                         ↓
               High-throughput docking
                         │
                         ↓
                  Score ranking
                         │
                         ↓
               Pose / interaction
                    inspection
                         │
                         ↓
                Consensus docking
                         │
                         ↓
                  Rescoring
                         │
                         ↓
                   MD simulation
                         │
                         ↓
                  MM-PBSA/GBSA
                         │
                         ↓
                 ADMET / toxicity
                         │
                         ↓
                  Final candidates
                         │
                         ↓
                 Experimental assay
十八、如果用 AutoDock Vina 做 SBVS
实际操作流程:
阶段 | 输入 | 输出 |
|---|---|---|
1. Protein | protein.pdb | protein_H.pdb |
2. Receptor preparation | PDB | protein.pdbqt |
3. Binding site | PDB/共晶配体 | config.txt |
4. Compound library | SDF/SMILES | ligand structures |
5. 3D generation | 2D molecules | 3D molecules |
6. Ligand preparation | ligand | *.pdbqt |
7. Virtual screening | protein + thousands ligands | docking results |
8. Ranking | docking scores | Top compounds |
9. Pose analysis | PDBQT | interaction diagrams |
10. Rescoring | Top compounds | refined ranking |
11. MD | protein-ligand complexes | trajectories |
12. MM-PBSA | trajectories | ΔGbind |
13. ADMET | final hits | drug-like profile |
14. Experiment | selected compounds | IC50/Kd/etc. |
最核心的一点是:
SBVS = 蛋白结构 + binding pocket + 化合物库 + docking + 多层筛选,而不是单纯的 Vina 打分排序。
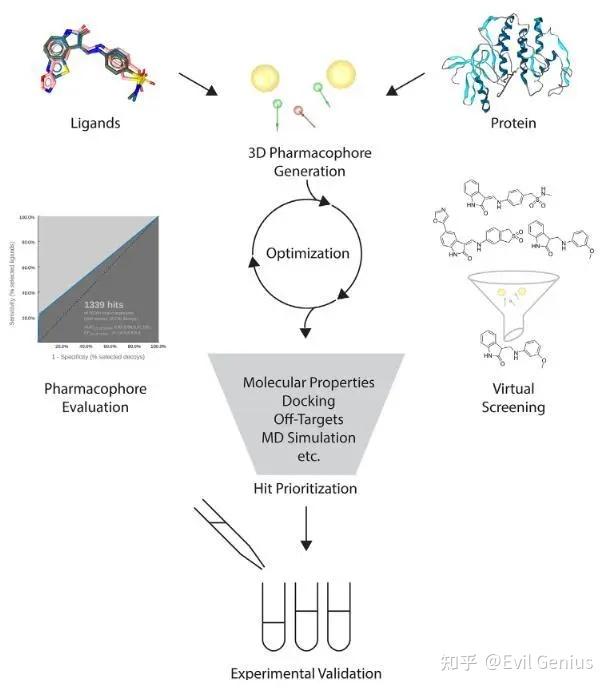
另外,现代 SBVS 中也可以加入受体构象集合、药效团、机器学习/深度学习 docking、混合溶剂 MD 等步骤;例如 receptor-based pharmacophore 可以从蛋白结合位点和片段 docking pose 中生成,再用于后续筛选。
流程可以直接分成 ①靶蛋白准备 → ②口袋搜索 → ③化合物库准备 → ④Vina批量筛选 → ⑤结果排序 → ⑥相互作用分析 → ⑦ADMET → ⑧MD验证 。
生活很好,有你更好
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号