DeepSeek 开源的这11个 skill 让你的 Agent 超神

DeepSeek 开源的这11个 skill 让你的 Agent 超神
Onegun
发布于 2026-09-20 12:31:45
发布于 2026-09-20 12:31:45
这两天翻 DeepSeek Harness 的开源仓库,我发现了一个挺骚的东西。
DeepSeek 不只把 Harness 的代码放了出来,连仓库里给 Agent 用的工作规范,也一起摊在了 GitHub 上。
一共 11 个 Skill。
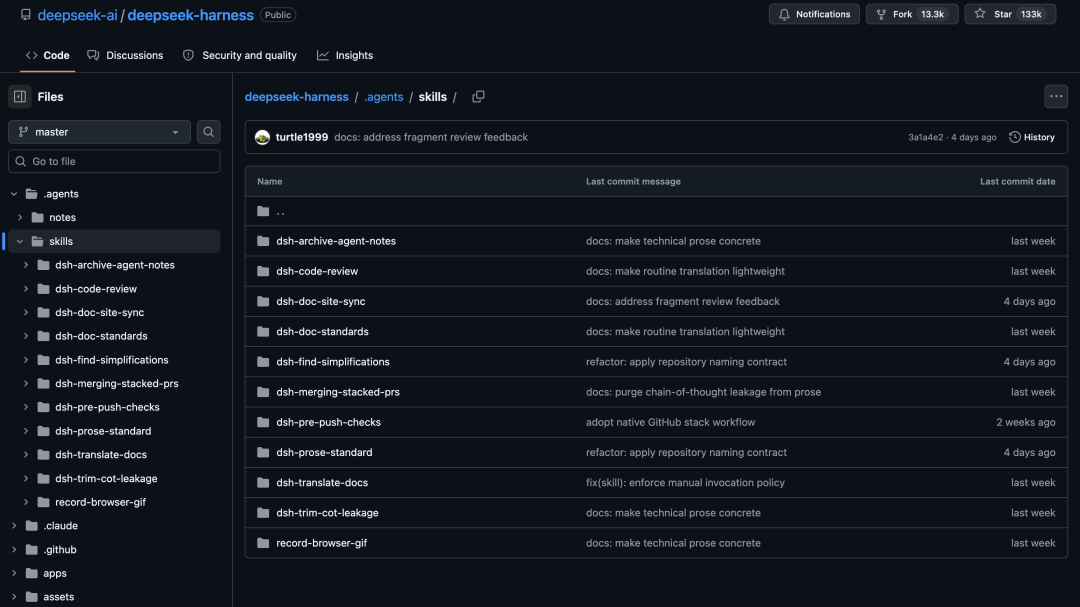
我原本以为,无非又是一些「写好代码」、「记得测试」之类正确但没啥用的废话。
点进去以后,我发现不是,它写得非常具体。
具体到在审查 PR 时,要顺着接口两端检查资源释放和异步竞态...在推送前也不是傻乎乎跑完整个仓库,而是根据改动选择必要的测试,甚至连哪些讨论痕迹该删、哪些架构决策该归档,都写了。
这尼玛已经不是提示词了。
更像是把资深工程师脑子里的判断,拆成 Agent 可以执行的工作规程。
11 个 Skill 如下:
覆盖维度 | Skill 名称 | 使用场景 |
|---|---|---|
代码与 Git 流程 | dsh-code-review | 代码审查指南,告诉 Agent 审查 PR 时不能只看代码能否运行,还要检查接口契约、异步并发、资源释放、安全边界、测试强度、文档是否同步等。 |
dsh-pre-push-checks | 代码推送前检查,根据当次修改涉及的范围,选择最必要的测试、类型检查和文档检查,避免每次都把整个仓库的测试全部跑一遍。 | |
dsh-merging-stacked-prs | 合并有依赖关系的一组 PR,比如 B 依赖 A、C 又依赖 B,它会指导 Agent 按正确顺序检查、同步和合并,避免分支关系混乱,不用再手动改 base 改到崩溃。 | |
技术文档与文案 | dsh-doc-standards | 项目文档管理规范,决定每一段内容应该写在哪、教程和参考文档如何区分、文档是否过长,以及代码注释、JSDoc 和 Markdown 各自承担什么职责。 |
dsh-prose-standard | 文字质量规范,用于检查文档、注释、提示词、报错信息和界面文字,要求保留真正重要的规则和约束,删除重复解释、空话和装饰性表达。 | |
dsh-doc-site-sync | 把仓库文档同步到官网,管理哪些 Markdown 会发布到文档网站、中文和英文页面如何映射、链接如何转换,以及网站构建与检查流程。 | |
dsh-translate-docs | 中英文文档同步翻译,保持英文 foo.md、中文 foo.zh.md 和配套记录一致,同时强调术语统一和自然表达;需要用户明确指定后才运行。 | |
dsh-trim-cot-leakage | 清理"思考过程残留",删除文档或注释中类似"我们之前考虑过……""在第几个 PR 中被否决……"这类只对当时讨论者有意义的过程描述,改写成脱离讨论背景也能理解的正式结论。这里不只是模型隐私意义上的思维链,更接近"开发讨论痕迹"。 | |
项目协作治理 | dsh-find-simplifications | 寻找可以删减和简化的代码,专门发现重复实现、过度设计、没有实际用途的抽象、已经失效的兼容逻辑,以及"明明有现成依赖却又手写一套"的代码。 |
dsh-archive-agent-notes | 整理和归档架构决策记录,Agent Notes 可以理解为给 AI 和开发者看的"项目决策档案",该 skill 判断哪些仍有指导价值、哪些已经完成可以归档、哪些过时记录可以删除。 | |
Demo 演示 | record-browser-gif | 录制网页操作 GIF,控制浏览器完成真实操作,按界面状态抓取画面并生成优化后的 GIF,用于展示 PR 带来的界面变化。 |
代码与 Git 流程
代码和 Git 这块,有 3 个。
dsh-code-review不满足于「代码能跑」,还要看接口契约、生命周期、并发、安全和测试。dsh-pre-push-checks根据改动范围挑质量门禁。dsh-merging-stacked-prs专门处理相互依赖的 PR,知道该按什么顺序同步和合并。
我自己写代码时最怕的,恰恰不是 Agent 不会写,而是它太会写了。
你让它加一个功能,它顺手加三个抽象、两层兼容,仓库也成功胖了 20 斤。。。
技术文档与文案
文档这块更细,一口气放了 5 个。
dsh-doc-standards决定内容该放 README、教程还是代码注释。dsh-prose-standard负责砍空话。dsh-doc-site-sync管文档到官网的同步。dsh-translate-docs管中英文文件和术语,而且必须由用户明确触发。最有意思的是dsh-trim-cot-leakage,它清理「我们之前考虑过」这类脱离讨论就看不懂的残留,把它改成后来者也能理解的正式结论。
项目协作治理
我最喜欢的是dsh-find-simplifications。
它专门找重复实现、过度设计、失效兼容和没人使用的接口,还强调别拿猜测凑数,宁愿只找几个证据扎实、真的值得删的地方。
“克制”这两个字,可能才是 AI Coding 里最稀缺的能力。
还有dsh-archive-agent-notes,负责整理架构决策档案,该保留的保留,该归档的归档。
Demo演示
record-browser-gif甚至会控制浏览器跑真实操作,生成展示 PR 变化的 GIF。
从写代码,到审代码,到写文档,再到把结果演示出来。
闭环了。
很多朋友可能会问,我又不开发 DeepSeek Harness,这些东西跟我有啥关系?
坦率的讲,你不能把 11 个文件原封不动塞进任何项目,然后期待 Agent 瞬间附体 DeepSeek 工程师,里面不少规则只属于这个仓库,硬抄会水土不服。
但你完全可以把它们当成一套公开的范本。
今天就能做的动作很简单,先挑一个最痛的环节。代码臃肿,就借dsh-find-simplifications。PR 漏测,就参考dsh-pre-push-checks。文档像会议纪要,就看dsh-trim-cot-leakage。
不要一次全装,使用方法也非常简单。
我直接以 Workbuddy 中安装使用为例。
先把 DeepSeek Harness 的开源仓库地址(github.com/deepseek-ai/deepseek-harness/tree/master/.agents/skills)发给它,告诉它你需要安装哪个。
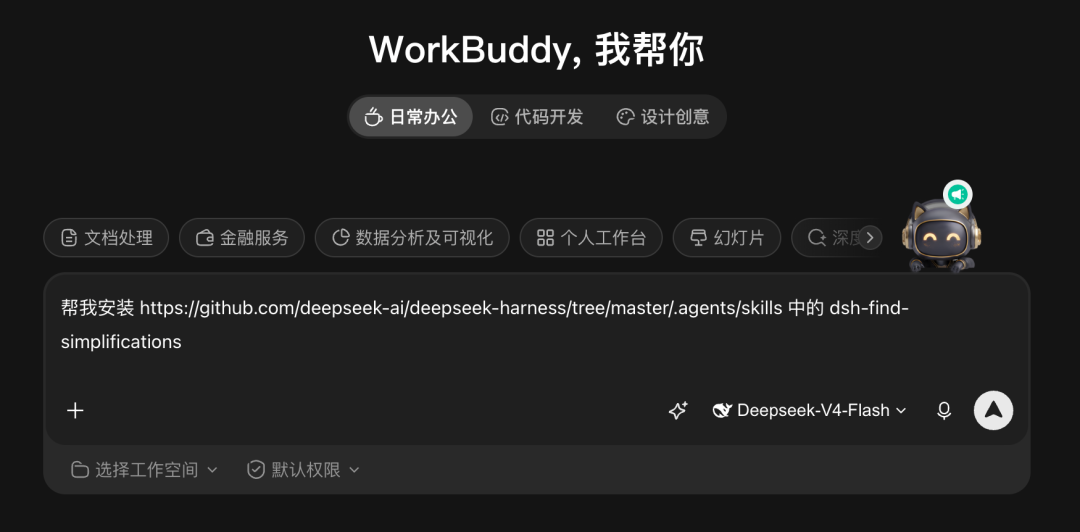
基本就是秒速安装。
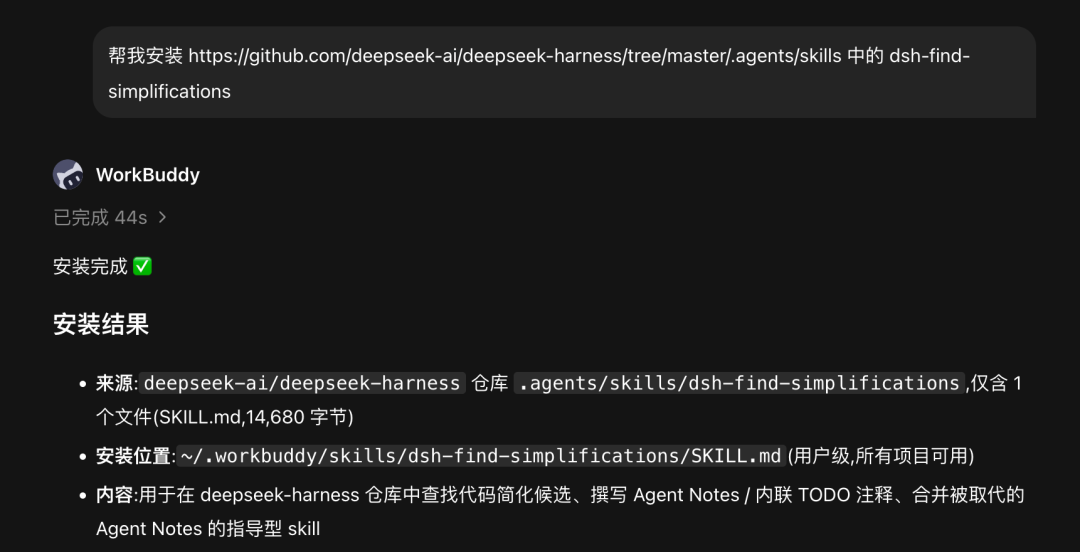
我拿真实任务跑一遍,再换成自己的目录、命令和质量门禁,规则被反复修正后,它会慢慢变成团队可复用的工程判断。
6700 行的一个项目找出来 450+行的可优化代码,确实是有两把刷子。
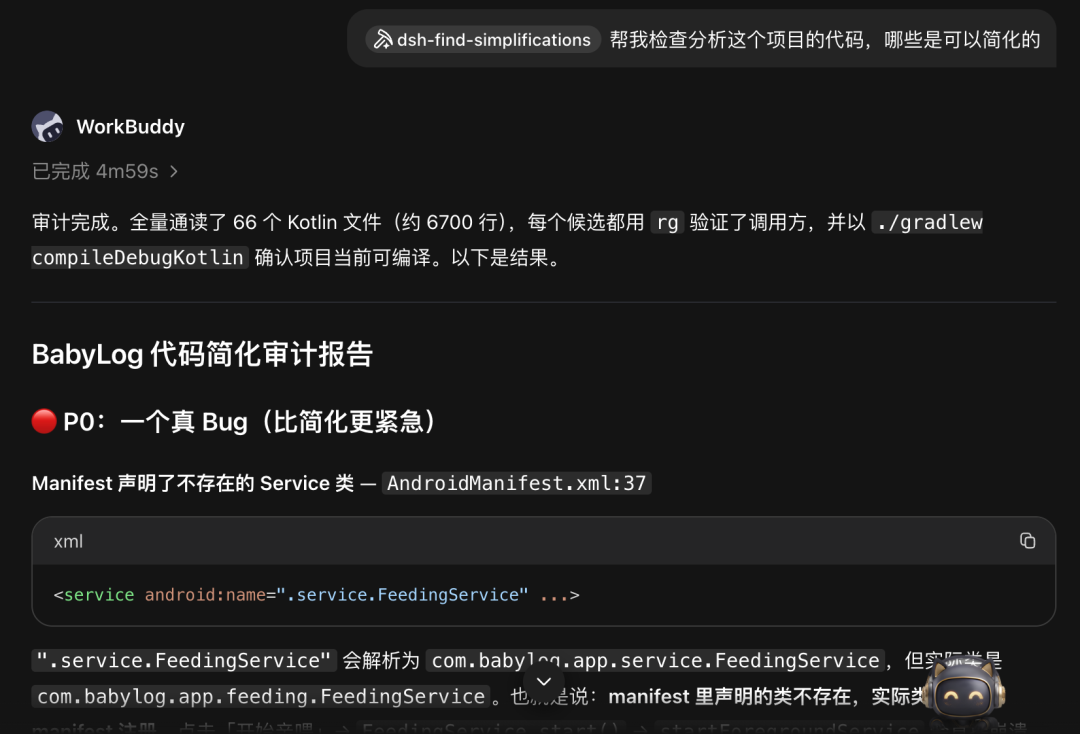
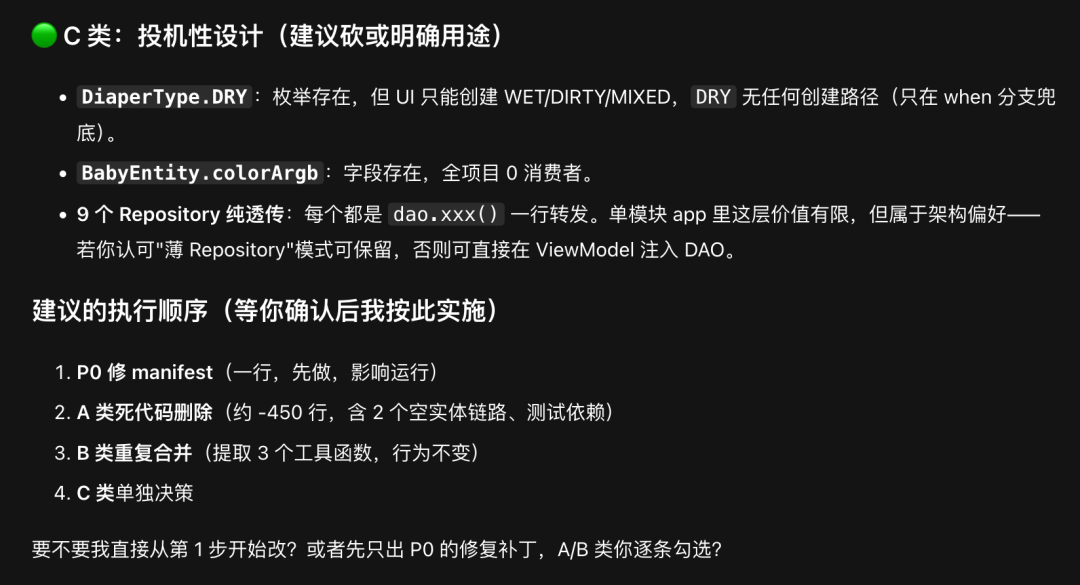
过去我们把经验写进师徒关系,写进 Code Review,也写进只有老员工才知道的潜规则里。
现在,Skill 给了这些经验一个新的容器。
DeepSeek这一套开源工的作规范,是把「怎么得到这个结果」也交了出来。
这也是 DeepSeek 这 11 个 Skill 真正让我兴奋的地方。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-17,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号