爽爆了!WorkBuddy + IMA 知识库 200 段历史对话知识库查询,从此随搜随有,资产随时沉淀

爽爆了!WorkBuddy + IMA 知识库 200 段历史对话知识库查询,从此随搜随有,资产随时沉淀

瑭宋元
发布于 2026-09-17 18:46:28
发布于 2026-09-17 18:46:28
上个月 AI 帮你做过的那个竞品分析结论,到底藏在哪个对话里? 我翻了 40 分钟没找到。直到把 WorkBuddy 接上 IMA,历史对话不只能"搜得到",更能自动总结成高价值资产、还能在对话里越用越聪明——这才叫把经验真正用起来。
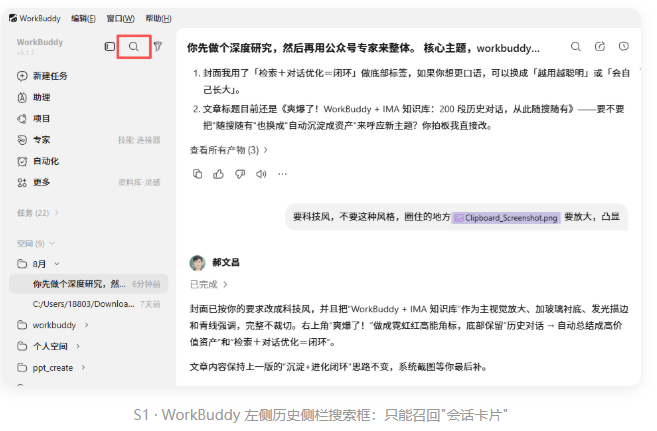
一、先说扎心真相:WorkBuddy 的搜索,有两个"坑"
我有快 200 个对话,每个里面要么多个任务、要么一个任务调了十几轮。某天想捞一段关键信息,才发现——WorkBuddy 给的两个搜索入口,都查不到跨对话的正文。
入口 1左侧历史侧栏搜索框:它做的是"语义匹配会话卡片"。你输入关键词,它帮你找出"相关的对话",但匹配的是标题 + 摘要,不是对话正文里逐字出现的地方。官方也明说:不支持通配符和布尔运算,按语义而非关键词。它看着像 grep,其实只是把相关会话卡片递给你。
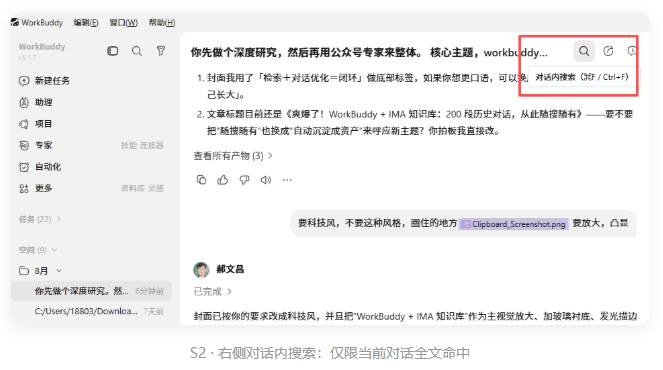
入口 2右侧对话内搜索(Ctrl+F / Cmd+F,4.22.4+):只能在当前这一个对话里搜,能高亮、能翻页,挺好用——但仅限于眼前这一条。另外 199 个对话,它一个都够不着。
缺口就在这:跨所有对话、按任意关键词"逐字全文命中",WorkBuddy 目前没有任何一个入口能做到。经验资产在内部"沉没了"。
二、那个"看着像 grep"的误会
很多人(包括我)一开始都以为左边那个框能搜全文。结果呢——它给你一列"相关对话卡片",点进去还得自己再找。真正的"正文级命中 + 高亮 + 可统计",它给不了。这不是 WorkBuddy 不行,是它把"语义找对话"和"全文找句子"这两件事分开了,而我们要的是后者。
三、转机:我发现了一个出口——IMA 知识库
腾讯的 ima 知识库(ima.qq.com)本来是个人/团队的 AI 资料库。关键它接受的文件类型极广:MARKDOWNTXTNOTESESSION(会话)PDF/WORD/EXCEL/PPT……换句话说,WorkBuddy 导出的记忆、甚至整段对话,它都能吃进去并建立索引。
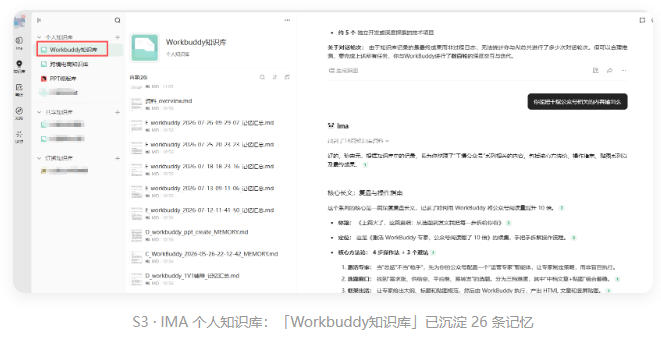
更妙的是,WorkBuddy 和 IMA 是双向打通的:WorkBuddy 侧有 ima 连接器,可以把记忆直接写进 IMA;反过来,新对话里 @一下知识库,AI 就能基于你的历史经验作答。
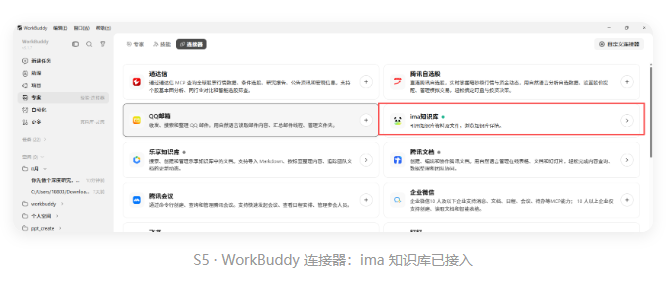
四、核心打法:让 WorkBuddy 把记忆"提炼"成资产,同步到 IMA
思路一句话:把 WorkBuddy 全量的任务记忆,定期"总结提炼"成结构化高价值资产,同步进 IMA 知识库——不只是备份,更是沉淀。三条路径,从轻到重:
- 路径 A(推荐·自动化):在 WorkBuddy 配一个全局自动化(如每周日 23:00,Cron 触发)。让它读取各工作区的 memory 目录,先让 AI 把每个任务总结成"结论 / 方法 / 可复用片段 / 踩坑"的结构化笔记,再合并写入「Workbuddy知识库」。落进 IMA 的不是原始流水,而是提炼过的高价值资产。一次配置,持续生效。
- 路径 B(手动·轻量):把有价值的对话结论导出成 MD/TXT,拖进 IMA 知识库(原生支持)。适合"顺手沉淀"的单次动作。
- 路径 C(最关键·反向调用):同步完成后,回到 WorkBuddy 对话框,输入 @Workbuddy知识库 + 你的问题,AI 直接基于全部历史记忆作答——你不用离开 WorkBuddy,历史经验随叫随到。第二大脑从"存得住"升级到"用得上"。
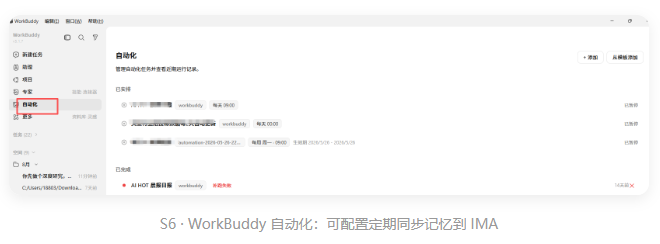
五、实测:一句"搜 WorkBuddy 搜索",正文片段直接高亮
我自己的「Workbuddy知识库」里已经沉淀了 26 条记忆。我在 IMA 里搜 "WorkBuddy 搜索",返回的不是"哪个文件叫这名字",而是正文中出现过这两个词的所有片段,并直接高亮——哪天写的、哪段话、前后文全在。
这就是区别:WorkBuddy 左框给你"相关对话卡片",IMA 给你"正文里的那句话"。一个找对话,一个找答案。
五·续 最爽的一点:同步完,在 WorkBuddy 里 @一下就调出来
很多人以为这套打法只是"去 IMA 里搜"。其实最方便的在 WorkBuddy 这一侧——知识库同步到 IMA 之后,你回到 WorkBuddy 对话框,直接 @ima / Workbuddy知识库 再抛个问题,AI 会基于那 26 条(以后只多不少)历史记忆作答。换句话说:你既不用离开 WorkBuddy,也不用记得东西放哪,历史经验随叫随到。
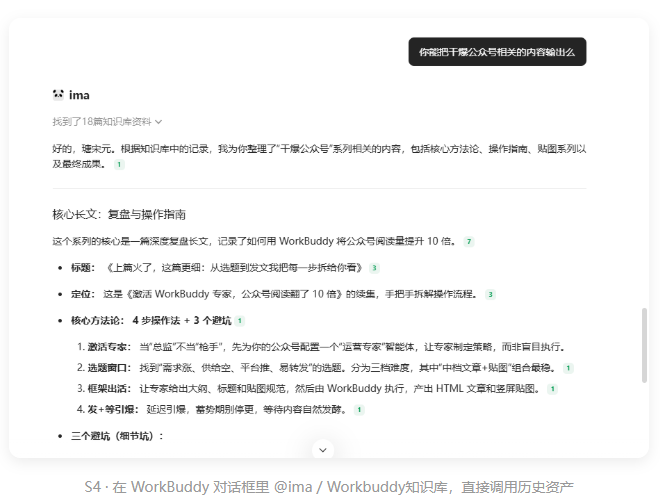
一个闭环,两种爽法: · IMA 侧:跨对话逐字全文检索 + 统计,专治"想不起放哪"; · WorkBuddy 侧:对话框里 @一下知识库,让 AI 直接复用历史,专治"想用但懒得翻"。 两头都不用折腾,记忆真正"活着"。
六、不止检索:这是一个会进化的资产闭环
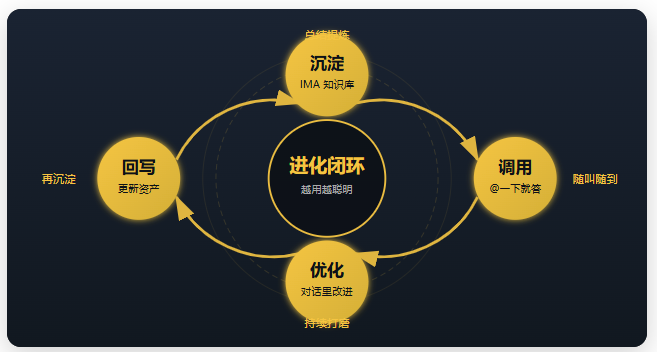
很多人以为这套打法就是"检索方便"。其实真正厉害的是——WorkBuddy + IMA 把历史的人机协作,从一堆沉没的聊天记录,变成了一套会自己长大的高价值资产。
· 总结提炼:同步时让 AI 把每个任务蒸馏成"结论 / 方法 / 可复用片段 / 踩坑",落进 IMA 的是精炼资产,不是流水账; · 沉淀增值:所有历史任务资产集中在一个知识库,越攒越厚,可检索、可统计、可复用; · 对话优化:你 @一下知识库调用历史,在对话里把方案改得更好,再把新版写回——资产被"用"过一轮就更聪明; · 闭环飞轮:沉淀 → 调用 → 优化 → 回写 → 再沉淀。每一次使用都在让资产更值钱,这是单纯"搜索工具"永远给不了的东西。
七、三步上手(照着做就行)
- 第一步 · 连上:WorkBuddy 资料库里绑定 ima 知识库(OAuth 一键授权),或在 IMA 客户端建一个「Workbuddy知识库」。
- 第二步 · 同步:用路径 A 配个每周自动化,把各工作区记忆汇总推过去;或先用路径 B 手动拖几份进去尝鲜。
- 第三步 · 开搜:在 IMA 里用关键词/标签/类型随意检索、统计。需要让 AI 复用历史时,回 WorkBuddy @一下知识库即可。
八、为什么这件事"爽爆了"
因为 WorkBuddy 终于从一个"用完就翻不动"的工具,变成了会自己沉淀、自己进化的第二大脑:
· 跨对话任意关键词命中,不再翻 200 个对话; · 自动总结提炼,历史聊天蒸馏成可复用的方法论与资产,而不是一堆流水; · 对话框里 @一下就调用,回 WorkBuddy 就能让 AI 复用全部历史,懒人福音; · 对话持续优化 + 回写,资产越用越聪明,闭环飞轮越转越快。
· 自主沉淀skill,我的workbuddy已经沉淀了漫画风故事skill、竖屏贴图skill、大模型生动课程skill、爬取数据skill等几十种符合我偏好的skill,这些skill都是我的个人资产,能够大幅度提升协作效率。
本文由 WorkBuddy 深度调研 + 公众号运营视角产出 · 实测基于已连接的 ima 知识库 配图 S1–S6 为真实系统截图,闭环图为 SVG 矢量图。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-30,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号