AlignRAG:浙江大学提出的可泛化推理对齐框架,助力 RAG 系统解决推理失配问题

AlignRAG:浙江大学提出的可泛化推理对齐框架,助力 RAG 系统解决推理失配问题
AgenticAI
发布于 2025-04-23 12:14:46
发布于 2025-04-23 12:14:46
近年来,检索增强生成(Retrieval-Augmented Generation, RAG)成为知识驱动文本生成的核心范式。然而,现有的 RAG 系统在推理过程中常常出现“推理失配”问题,即模型的推理路径与检索到的证据不一致,导致生成内容与事实不符,甚至产生幻觉信息。这种失配在需要精确知识支撑的任务中尤为严重,影响了大模型的可靠性和实用性。
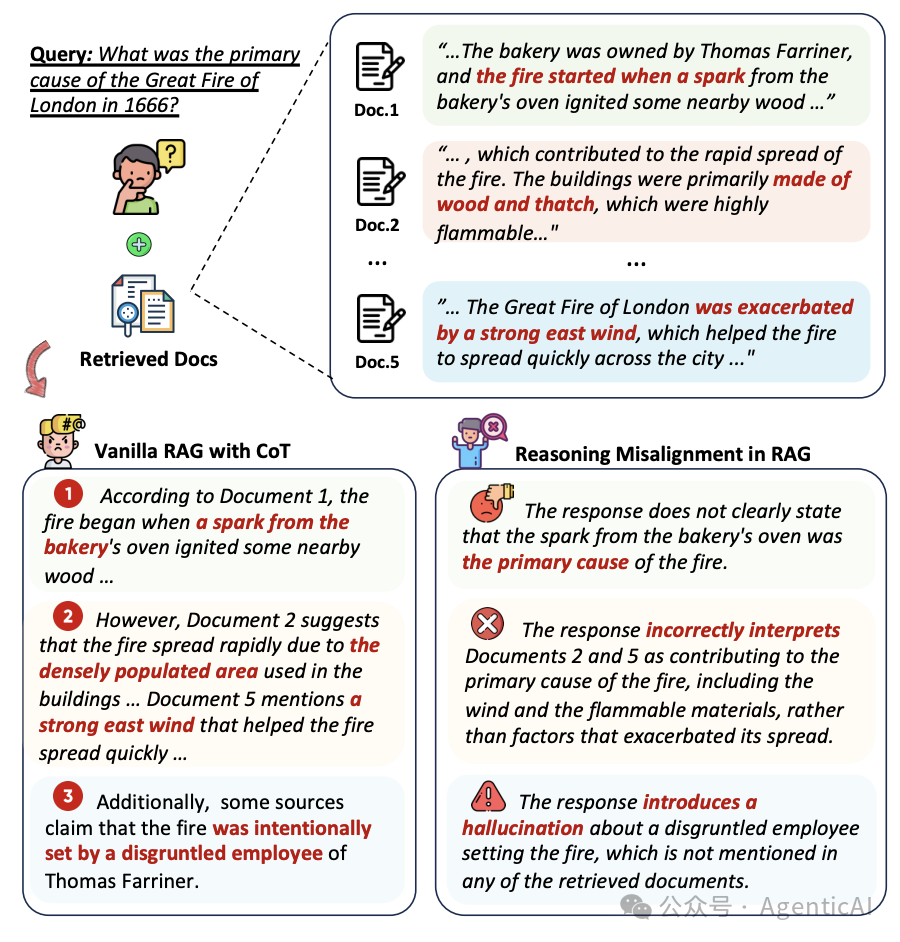
当前方法主要依赖于静态训练或后处理选择,难以在推理过程中动态调整推理路径,无法有效解决推理失配问题。因此,迫切需要一种在推理阶段能够实时纠正推理路径的方法,以提升 RAG 系统的准确性和可信度。
1. 核心贡献与方法
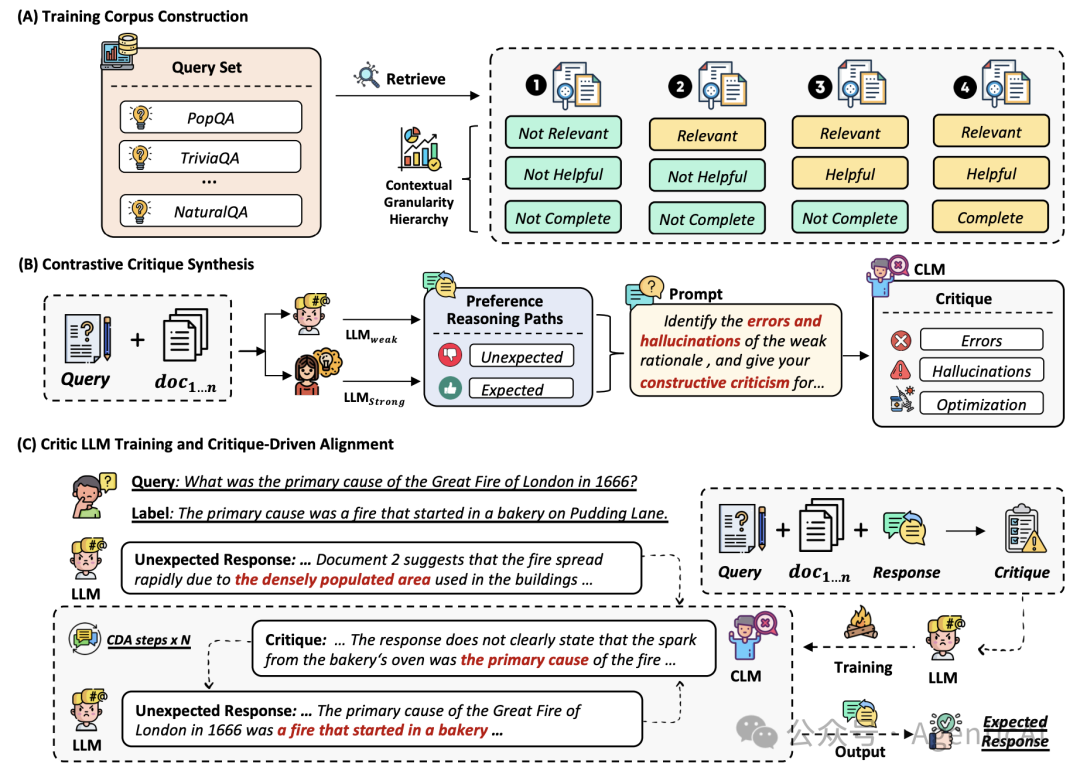
本文提出了 AlignRAG,一种可适配的框架,用于在推理阶段动态纠正 RAG 系统中的推理失配问题。AlignRAG 引入了“批判驱动对齐”(Critique-Driven Alignment, CDA)机制,通过训练一个专门的批判语言模型(Critic Language Model, CLM),在推理过程中识别并纠正推理路径中的错误。
AlignRAG 的工作流程包括:
- 构建包含多样推理路径的训练语料;
- 生成对比性批判,指出推理路径中的问题;
- 训练 CLM 模型,识别推理失配;
- 在推理阶段,应用 CDA 机制,迭代优化推理路径。
与现有方法相比,AlignRAG 能够在推理过程中动态调整推理路径,无需重新训练主模型,具有良好的可扩展性和实用性。
2. 实验设计与结果
作者在多个问答数据集上对 AlignRAG 进行了评估,包括 PopQA、TriviaQA 和 NaturalQA。实验采用了标准的准确率和一致性指标,比较了 AlignRAG 与现有 RAG 系统的性能。
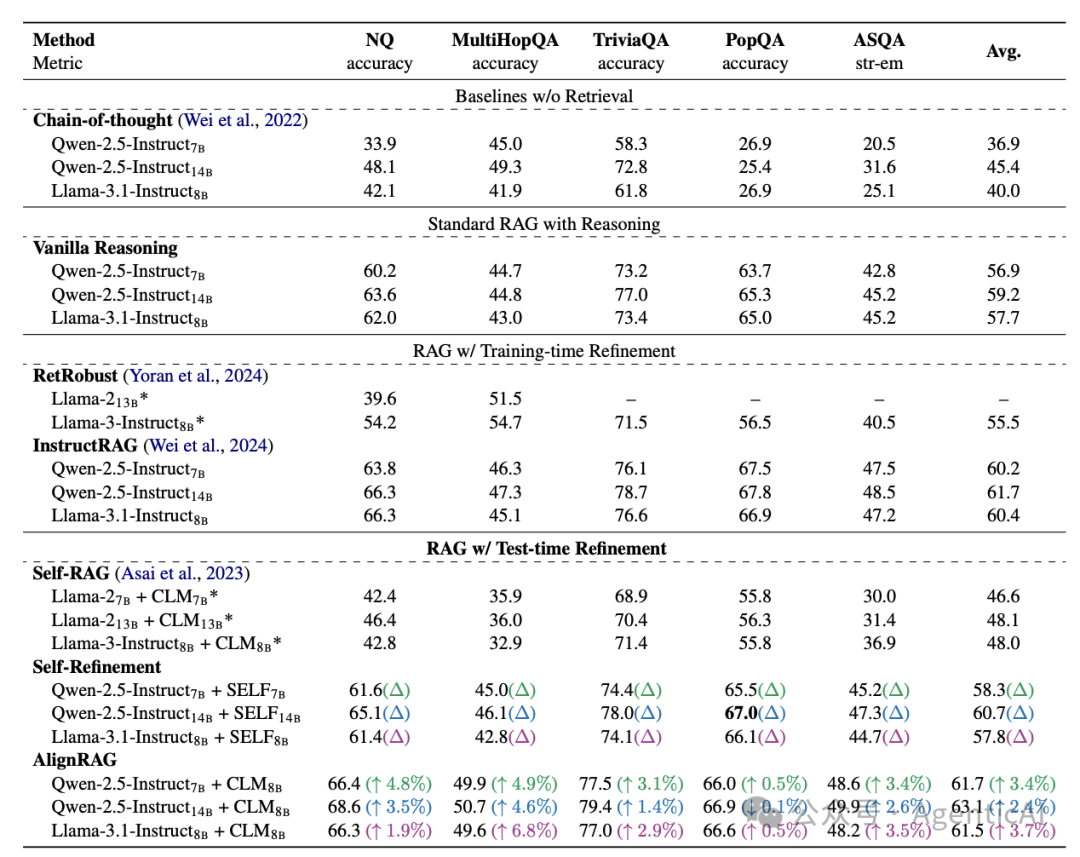
结果显示,AlignRAG 在所有数据集上均优于基线方法,特别是在处理复杂查询和多跳推理任务中表现突出。通过引入 CDA 机制,AlignRAG 显著减少了推理失配,提高了生成内容的准确性和一致性。
此外,作者将 AlignRAG 整合进 InstructRAG[1] 框架,并在三种不同语言模型上进行了测试。下表展示了 InstructRAG 在 AlignRAG 加持下,在域内(ID)和域外(OOD)评估下的性能表现。
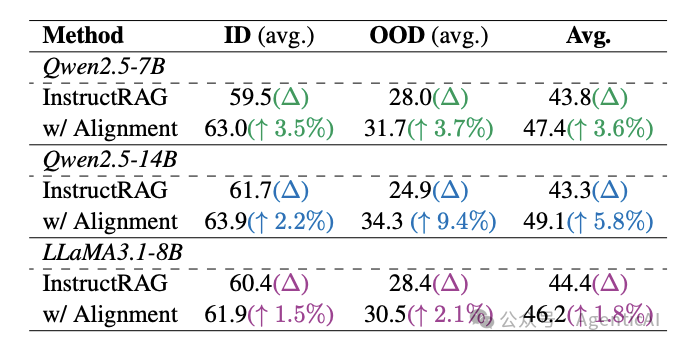
可以得出结论,在熟悉和未见过的数据分布中,模型都有一致的性能提升。增强了对齐机制的变体显著优于原始的 InstructRAG,这表明我们的方法可以在无需修改原始模型的情况下、以测试时的方式无缝集成到现有的 RAG 流程中,凸显了其强大的兼容性和实用价值。
3. 总结
AlignRAG 提供了一种创新的解决方案,通过在推理阶段动态纠正推理路径,显著提升了 RAG 系统的准确性和可靠性。其引入的 CDA 机制和 CLM 模型,为处理推理失配问题提供了新的思路,具有较高的实用价值和科学意义。
亮点:
- 在推理阶段动态纠正推理路径,无需重新训练主模型;
- 引入批判语言模型,增强了系统的自我纠错能力;
- 在多个数据集上表现优异,验证了方法的有效性。
改进建议:
- 进一步优化 CDA 机制的效率,降低计算成本;
- 扩展到更多类型的任务,验证方法的通用性。
开源情况:
代码已在 GitHub 上开源,目前还只有 eval 部分,期待作者的后续的更新~
GitHub 地址:https://github.com/QQW-ing/AlignRAG
参考资料
[1]
InstructRAG: https://arxiv.org/abs/2406.13629
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-04-22,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号