【机器学习 | 数据挖掘】时间序列算法

【机器学习 | 数据挖掘】时间序列算法
Francek Chen
发布于 2025-01-22 21:54:44
发布于 2025-01-22 21:54:44
【作者主页】Francek Chen 【专栏介绍】
智能大数据分析是指利用先进的技术和算法对大规模数据进行深入分析和挖掘,以提取有价值的信息和洞察。它结合了大数据技术、人工智能(AI)、机器学习(ML)和数据挖掘等多种方法,旨在通过自动化的方式分析复杂数据集,发现潜在的价值和关联性,实现数据的自动化处理和分析,从而支持决策和优化业务流程。与传统的人工分析相比,智能大数据分析具有自动化、深度挖掘、实时性和可视化等特点。智能大数据分析广泛应用于各个领域,包括金融服务、医疗健康、零售、市场营销等,帮助企业做出更为精准的决策,提升竞争力。 【GitCode】专栏资源保存在我的GitCode仓库:https://gitcode.com/Morse_Chen/Intelligent_bigdata_analysis。
一、常用的时间序列算法
时间序列是按照时间排序的一组随机变量,它通常是在相等间隔的时间段内依照给定的采样率对某种潜在过程进行观测的结果,是一种动态数据处理的统计方法,主要研究随机数据序列所遵从的统计规律。
常用的时间序列模型:
模型名称 | 描述 |
|---|---|
平滑法 | 平滑法常用于趋势分析和预测,利用修匀技术,削弱短期随机波动对序列的影响,使序列平滑化。根据所用平滑技术的不同,可具体分为移动平均法和指数平滑法。 |
趋势拟合法 | 趋势拟合法将时间作为自变量,相应的序列观察值作为因变量,建立回归模型。根据序列的特征,可具体分为线性拟合和曲线拟合。 |
组合模型 | 时间序列的变化主要受到长期趋势( T T T)、季节变动( S S S)、周期变动( C C C)和不规则变动( ε \varepsilon ε)这4个因素的影响。根据序列的特点,可以构建加法模型和乘法模型,加法模型: x t = T t + S t + C t + ε t x_t=T_t+S_t+C_t+\varepsilon_t xt=Tt+St+Ct+εt;乘法模型: x t = T t ⋅ S t ⋅ C t ⋅ ε t x_t=T_t\cdot S_t \cdot C_t \cdot \varepsilon_t xt=Tt⋅St⋅Ct⋅εt |
AR模型 | x t = ϕ 0 + ϕ 1 x t − 1 + ϕ 2 x t − 2 + ⋯ + ϕ p x t − p + ε t x_t = \phi_0 + \phi_1 x_{t-1} + \phi_2 x_{t-2} + \cdots + \phi_p x_{t-p} + \varepsilon_t xt=ϕ0+ϕ1xt−1+ϕ2xt−2+⋯+ϕpxt−p+εt 以前 q q q期的序列值 x t − 1 , x t − 2 , … , x t − p x_{t-1}, x_{t-2}, \ldots, x_{t-p} xt−1,xt−2,…,xt−p为自变量,随机变量 x t x_t xt的取值为因变量建立线性回归模型。 |
MA模型 | x t = μ + ε t − θ 1 ε t − 1 − θ 2 ε t − 2 − ⋯ − θ q ε t − q x_t = \mu + \varepsilon_t - \theta_1 \varepsilon_{t-1} - \theta_2 \varepsilon_{t-2} - \cdots - \theta_q \varepsilon_{t-q} xt=μ+εt−θ1εt−1−θ2εt−2−⋯−θqεt−q 随机变量 x t x_t xt的取值取决于以前各期的序列值无关,建立 x t x_t xt与前 q q q期的随机扰动 ε t , ε t − 1 , ε t − 2 , … , ε t − q \varepsilon_t, \varepsilon_{t-1}, \varepsilon_{t-2}, \ldots, \varepsilon_{t-q} εt,εt−1,εt−2,…,εt−q 的线性回归模型。 |
ARMA模型 | x t = ϕ 0 + ϕ 1 x t − 1 + ϕ 2 x t − 2 + ⋯ + ϕ p x t − p + ε t − θ 1 ε t − 1 − θ 2 ε t − 2 − ⋯ − θ q ε t − q x_t = \phi_0 + \phi_1 x_{t-1} + \phi_2 x_{t-2} + \cdots + \phi_p x_{t-p} + \varepsilon_t - \theta_1 \varepsilon_{t-1} - \theta_2 \varepsilon_{t-2} - \cdots - \theta_q \varepsilon_{t-q} xt=ϕ0+ϕ1xt−1+ϕ2xt−2+⋯+ϕpxt−p+εt−θ1εt−1−θ2εt−2−⋯−θqεt−q 随机变量 x t x_t xt的取值不仅与以前 p p p期的序列值有关,还与前 q q q期的随机扰动有关。 |
ARIMA模型 | 许多非平稳序列分后会显示出平稳序列的性质,称这个非平稳序列为差分平稳序列。对差分平稳序列可以使用ARIMA模型进行拟合。 |
ARCH模型 | ARCH模型能准确地模拟时间序列变量的波动性的变化,适用于序列具有异方差性并且异方差函数短期自相关。 |
GARCH模型及其衍生模型 | GARCH模型称为广义ARCH模型,是ARCH模型的拓展。相比于ARCH模型,GARCH模型及其衍生模型更能反映实际序列中的长期记忆性、信息的非对称性等特性。 |
)、季节变动(
)、周期变动(
)和不规则变动(
)这4个因素的影响。根据序列的特点,可以构建加法模型和乘法模型,加法模型:
;乘法模型:
AR模型
以前
期的序列值
为自变量,随机变量
的取值为因变量建立线性回归模型。MA模型
随机变量
的取值取决于以前各期的序列值无关,建立
与前
期的随机扰动
的线性回归模型。ARMA模型
随机变量
的取值不仅与以前
期的序列值有关,还与前
期的随机扰动有关。ARIMA模型许多非平稳序列分后会显示出平稳序列的性质,称这个非平稳序列为差分平稳序列。对差分平稳序列可以使用ARIMA模型进行拟合。ARCH模型ARCH模型能准确地模拟时间序列变量的波动性的变化,适用于序列具有异方差性并且异方差函数短期自相关。GARCH模型及其衍生模型GARCH模型称为广义ARCH模型,是ARCH模型的拓展。相比于ARCH模型,GARCH模型及其衍生模型更能反映实际序列中的长期记忆性、信息的非对称性等特性。
二、时间序列的预处理
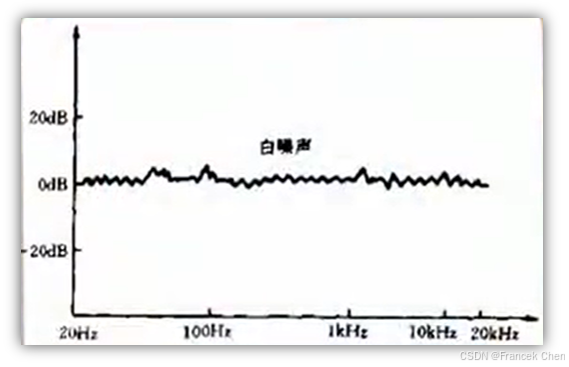
针对一个观察值序列后,首先要对它的白噪声和平稳性进行检验,这两个重要的检验称为序列的预处理。根据检验结果可以将序列分为不同的类型:
类型 | 说明 |
|---|---|
白噪声序列 | 序列的各项之间没有任何相关关系,序列在进行完全无序的随机波动。 |
平稳非白噪声序列 | 均值和方差是常数,通常是建立一个线性模型来拟合该序列的发展,借此提取该序列的有用信息。 |
非平稳序列 | 均值和方差不稳定,处理方法一般是将其转变为平稳序列,再应用有关平稳时间序列的分析方法。 |
(一)平稳性检验
平稳时间序列的定义:如果时间序列
在某一常数附近波动且波动范围有限,即有常数均值和常数方差,并且延迟
期的序列变量的自协方差和自相关系数是相等的或者说延迟
期的序列变量之间的影响程度是一样的,则称此序列为平稳序列。

平稳性检验:
- 时序图检验:根据平稳时间序列的均值和方差都为常数的性质,平稳序列的时序图显示该序列值始终在一个常数附近随机波动,而且波动的范围有界;如果有明显的趋势性或者周期性那它通常不是平稳序列。
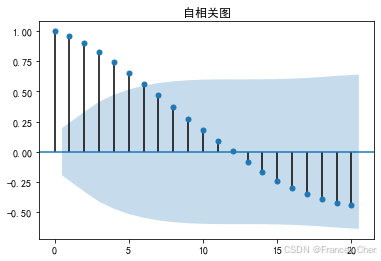
- 自相关图检验:随着延迟期数
的增加,平稳序列的自相关系数 (延迟
期)会比较快地衰减趋向于零,并在零附近随机波动,而非平稳序列的自相关系数衰减的速度比较慢。
- 单位根检验:单位根检验是指检验序列中是否存在单位根,存在单位根就是非平稳时间序列。
(二)白噪声检验
白噪声检验也称纯随机性检验,一般是构造检验统计量来检验序列的白噪声;常用的检验统计量有Q统计量和LB统计量,计算出统计量后再计算出对应的
值,如果
值显著大于显著性水平
,则表示该序列不能拒绝纯随机的原假设,可以停止对该序列的分析。
三、平稳时间序列分析
(一)基本性质
1. 自相关系数(ACF)
平稳AR(
)模型的自相关系数
呈指数的速度衰减,始终有非零取值,不会在
大于某个常数之后就恒等于零。这个性质就是平稳AR(
)模型的自相关系数
具有拖尾性。
2. 偏自相关系数(PACF)
对于一个平稳AR(
)模型,求出延迟
期自相关系数
时,实际上得到的并不是
与
之间单纯的相关关系。因为
同时还会受到中间
个随机变量
的影响,所以自相关系数
里实际上掺杂了其他变量
与
的相关影响。为了单纯地测度
对
的影响,引进偏自相关系数的概念。
3. 拖尾与截尾
- 截尾是指时间序列的ACF或PACF在某阶后均为0的性质;
- 拖尾是指ACF或PACF并不在某阶后均为0的性质。
(二)AR模型
具有
结构的模型称为阶自回归模型,简称为AR(
)。即在时刻的随机变量
的取值是前
期
的多元线性回归,认为
主要是受过去
期的序列值的影响。误差项是当期的随机干扰
,为零均值白噪声序列。
平稳AR(
)模型的性质如下所示:
统计量 | 性质 | 统计量 | 性质 |
|---|---|---|---|
均值 | 常数均值 | 自相关系数(ACF) | 拖尾 |
方差 | 常数方差 | 偏自相关系数(PACF) | p p p阶截尾 |
阶截尾
(三)MA模型
具有
结构的模型称为
阶移动平均模型,简记为MA(
)。即在时刻
的随机变量
的取值,
是前
期的随机扰动
的多元线性函数,误差项是当期的随机干扰
,为零均值白噪声序列,
是序列
的均值。认为
主要是受过去
期的误差项的影响。
平稳MA(
)模型的性质如下所示:
统计量 | 性质 | 统计量 | 性质 |
|---|---|---|---|
均值 | 常数均值 | 自相关系数 (ACF) | q q q阶截尾 |
方差 | 常数方差 | 偏自相关系数 (PACF) | 拖尾 |
阶截尾方差常数方差偏自相关系数 (PACF)拖尾
(四)ARMA模型
具有
结构的模型称为自回归移动平均模型,简记为ARMA(
)。即在
时刻的随机变量
的取值
是前
期
和前
期
的多元线性函数,误差项
是当期的随机干扰,为零均值白噪声序列。认为
主要是受过去
期的序列值和过去
期的误差项的共同影响。特别的,当
时,是AR(
)模型;当
时,是MA(
)模型。
平稳ARMA(
)的性质如下表所示:
统计量 | 性质 | 统计量 | 性质 |
|---|---|---|---|
均值 | 常数均值 | 自相关系数(ACF) | 拖尾 |
方差 | 常数方差 | 偏自相关系数(PACF) | 拖尾 |
(五)平稳时间序列建模
平稳时间序列建模步骤:
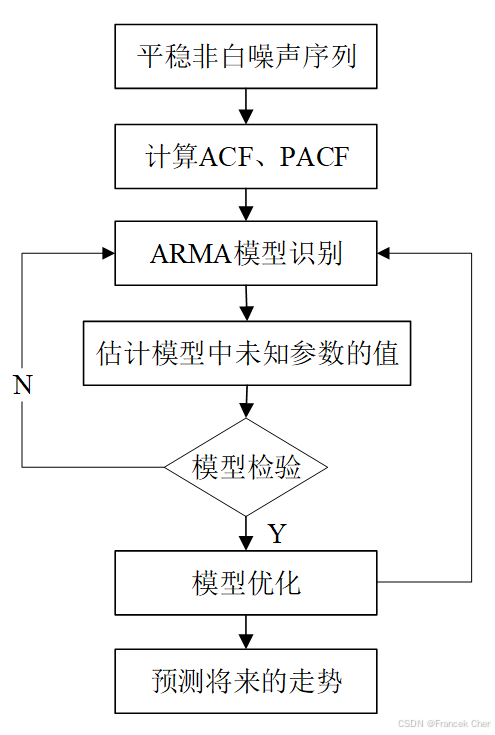
模型 | 自相关系数(ACF) | 偏自相关系数(PACF) |
|---|---|---|
AR( p p p) | 拖尾 | p p p阶截尾 |
MA( q q q) | q q q阶截尾 | 拖尾 |
ARMA( p , q p,q p,q) | p p p阶拖尾 | q q q阶拖尾 |
)拖尾
阶截尾MA(
)
阶截尾拖尾ARMA(
)
阶拖尾
阶拖尾
四、非平稳时间序列分析
对非平稳时间序列的分析方法可以分为确定性因素分解的时序分析和随机时序分析两大类。
确定性因素分解的方法将所有序列的变化都归结为4个因素(长期趋势、季节变动、循环变动和随机波动)的综合影响,其中长期趋势和季节变动的规律性信息通常比较容易提取,而由随机因素导致的波动则非常难以确定和分析,对随机信息浪费严重,会导致模型拟合精度不够理想。
随机时序分析法的发展就是为了弥补确定性因素分解方法的不足。根据时间序列的不同特点,随机时序分析可以建立的模型有ARIMA模型、残差自回归模型、季节模型、异方差模型等。本小节重点介绍ARIMA模型对非平稳时间序列进行建模。
import pandas as pd
usage = pd.read_csv('../data/WWWusage.csv')
usage = usage['x']

# 时序图
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['SimHei']  # 用于正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False  # 用于正常显示负号
usage.plot()
plt.show()

# 自相关图
from statsmodels.graphics.tsaplots import plot_acf
plot_acf(usage)
plt.title('自相关图')
plt.show()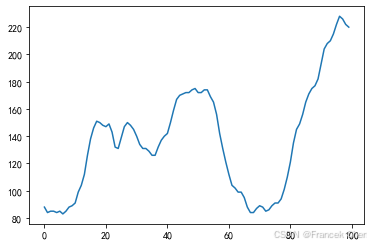
(一)差分运算
差分运算具有强大的确定性信息提取能力,许多非平稳序列差分后会显示出平稳序列的性质,这时称这个非平稳序列为差分平稳序列。常用的差分计算分为
阶差分和
步差分两种。
阶差分:做
次差分。
步差分:相距
个数据的两个序列值之间的减法运算称为
步差分运算。
(二)ARIMA模型
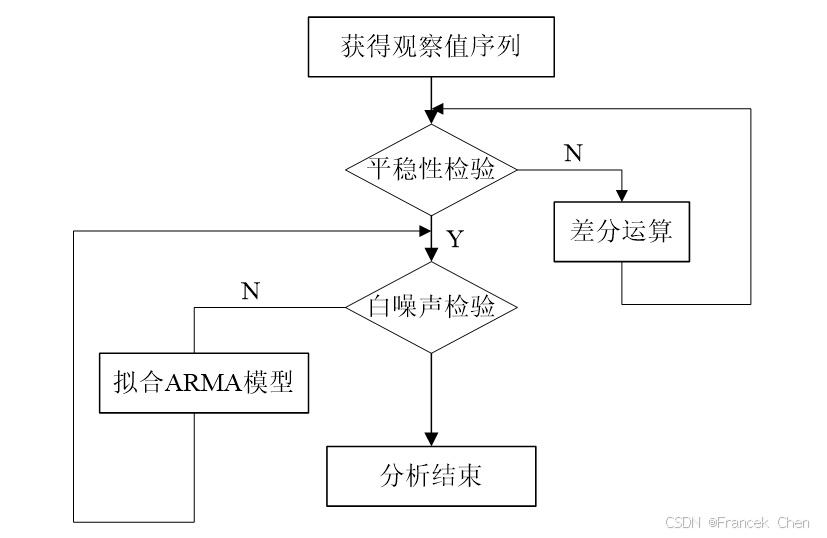
对差分平稳序列可以使用ARMA模型进行拟合。ARIMA模型的实质就是差分运算与ARMA模型的组合。
1. 平稳性和白噪声检验
使用statsmodels库中的stats模块的acorr_ljungbox函数可以检测是否为白噪声序列,基本使用格式和常用参数说明如下:
statsmodels.stats.diagnostic.acorr_ljungbox(x, lags = None, boxpierce = False, model_df = 0, period = None, return_df = None)
参数名称 | 参数说明 |
|---|---|
x | 接收array_like,接收时间序列数据,无默认值 |
lags | 接收int,表示滞后数目,默认为None |
boxpierce | 接收bool,表示是否返回Box-Pierce测试结果,默认为False |
model_df | 接收int,表示模型消耗的自由度数,默认为0 |
period | 接收int,表示季节性时间序列的周期,默认为None |
2. 查看时间序列平稳性
通过时间序列的时序图和自相关图可以查看时间序列平稳性。使用statsmodel库中的tsa模块的plot_acf函数可以绘制自相关系数图,基本使用格式和常用参数说明如下:
statsmodels.tsa.stattools.plot_acf(x, lags = None, alpha = 0.05, missing = 'none', title = 'Autocorrelation', zero = True)
参数名称 | 参数说明 |
|---|---|
x | 接收array_like,表示时间序列数据,无默认值 |
lags | 接收int、array_like,表示滞后值,默认为None |
alpha | 接受float,表示给定级别的置信区间,默认为0.05 |
missing | 接收str,表示如何处理NaN,默认为None |
title | 接收str,表示标题,默认为Autocorrelation |
zero | 接收bool,表示是否包括0滞后自相关,默认为True |
3. 单位根检验
单位根检验是指检验序列中是否存在单位根,因为存在单位根就是非平稳时间序列了。单位根检验可以检验时间序列的平稳性。使用statsmodels库中的tsa模块的adfuller函数可以对原始序列进行单位根检验,查看数据的平稳性,基本使用格式和常用参数说明如下:
statsmodels.tsa.stattools.adfuller(x, maxlag = None, regression = 'c', autolag = 'AIC', store = False, regresults = False)
参数名称 | 参数说明 |
|---|---|
x | 接收array_like,表示要检验的数据集,无默认值 |
maxlag | 接收int,表示最大滞后数目,默认为None |
regresults | 接收bool,表示是否将完整的回归结果将返回,默认为False |
4. 对原始序列进行一阶差分
使用pandas库中的DataFrame模块的diff()方法可以实现对观测值序列进行差分计算,基本使用格式和常用参数说明如下:
pandas.DataFrame.diff(periods=1, axis=0)
参数名称 | 参数说明 |
|---|---|
periods | 接收int,表示差分周期,默认为1 |
axis | 接收int、str,表示对行还是列差分,默认为0 |
# 平稳性检测
from statsmodels.tsa.stattools import adfuller as ADF
print('原始序列的ADF检验结果为:', ADF(usage))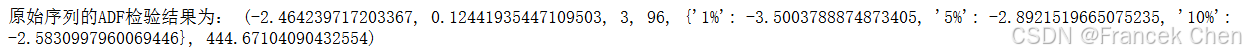
# 差分后的结果
D_usage = usage.diff().dropna()
D_usage.plot()
plt.show()  # 时序图
plot_acf(D_usage)
plt.title('自相关图')  # 自相关图
plt.show()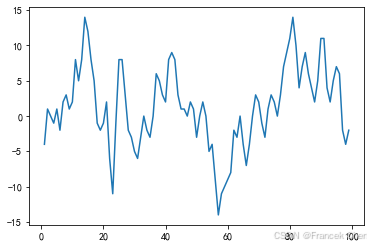
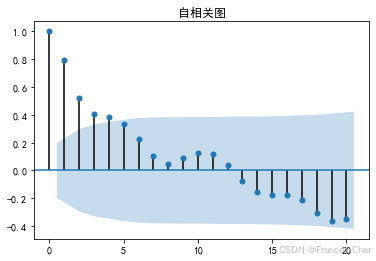
# 单位根检验
print('差分序列的ADF检验结果为:', ADF(D_usage)) 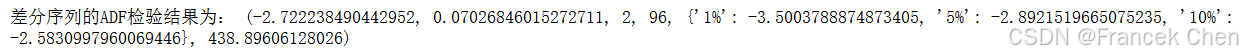
# 白噪声检验
from statsmodels.stats.diagnostic import acorr_ljungbox
print('差分序列的白噪声检验结果为:', acorr_ljungbox(D_usage, lags=1))  # 返回统计量和p值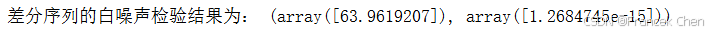
5. ARIMA模型构建
使用statsmodels库中的tsa模块的ARIMA类可以用于设置时序模式的建模参数,创建ARIMA时序模型,基本使用格式和常用参数说明如下:
class statsmodels.tsa.arima_model.ARIMA(endog, order, exog = None, dates = None, freq = None, missing = 'none')
参数名称 | 参数说明 |
|---|---|
order | 接收str,表示模型的(p,d,q)顺序 |
dates | 接收array_like,表示日期,默认为None |
freq | 接收str,时间序列的频率,默认为None |
from statsmodels.tsa.arima_model import ARIMA
# 定阶
usage = usage.astype(float)
pmax = 3
qmax = 3
bic_matrix = []  # BIC矩阵
for p in range(pmax+1):
    tmp = []
    for q in range(qmax+1):
        try:  # 存在部分报错,所以用try来跳过报错
            tmp.append(ARIMA(usage, (p,1,q)).fit().bic)
        except:
            tmp.append(None)
    bic_matrix.append(tmp)
bic_matrix = pd.DataFrame(bic_matrix)  # 从中可以找出最小值
print(bic_matrix)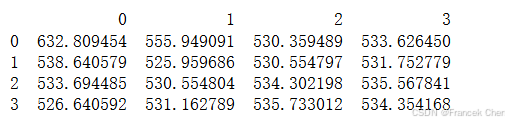
# ARIMA模型预测
p,q = bic_matrix.stack().idxmin()  # 先用stack展平,然后用idxmin找出最小值位置
print('BIC最小的p值和q值为:%s、%s' %(p,q))
model = ARIMA(usage, (p,1,q)).fit()  # 建立ARIMA(1, 1, 1)模型
print('模型报告为:\n', model.summary2())
print('预测未来10分钟,其预测结果、标准误差、置信区间如下。\n', model.forecast(10))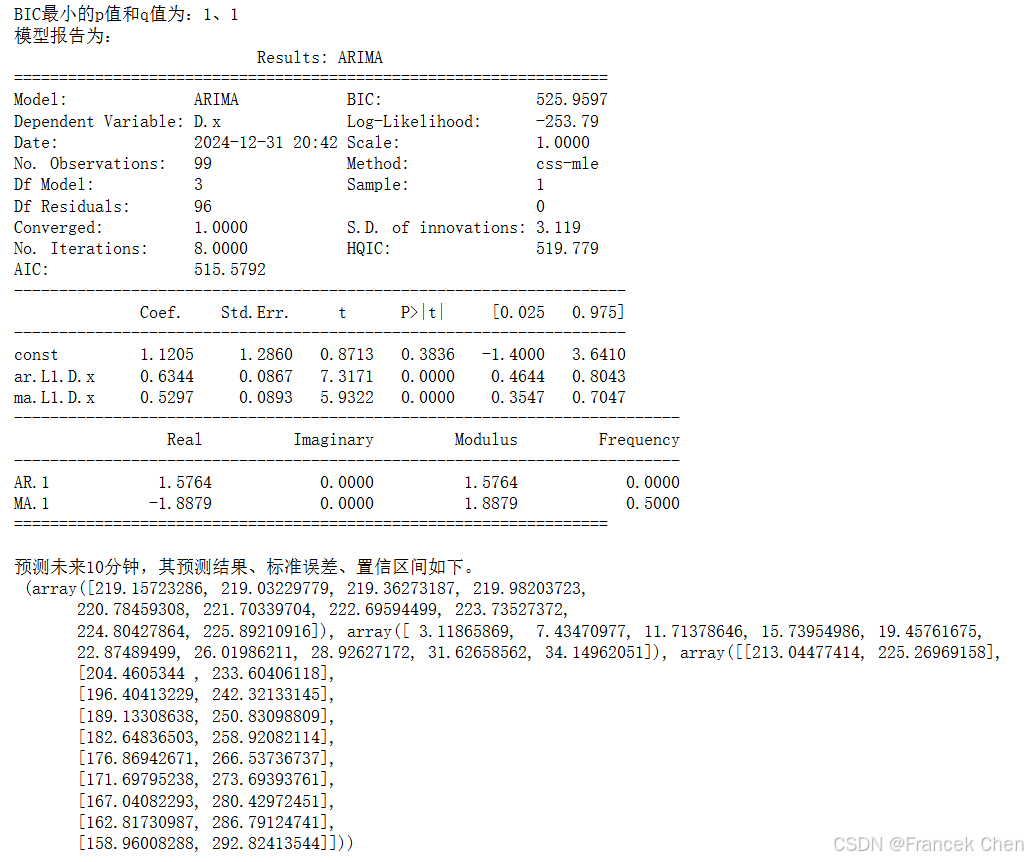
附:以上文中的数据文件及相关资源下载地址: 链接:https://pan.quark.cn/s/1b9f6bdb3116 提取码:wECR
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2025-01-01,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号