NeurIPS2023 | ResShift:通过残差位移实现的用于图像超分辨率的高效扩散模型

NeurIPS2023 | ResShift:通过残差位移实现的用于图像超分辨率的高效扩散模型

用户1324186
发布于 2023-12-11 18:42:39
发布于 2023-12-11 18:42:39
来源:NeurIPS2023 论文题目:ResShift: Efficient Diffusion Model for Image Super-resolution by Residual Shifting 论文链接:https://arxiv.org/pdf/2307.12348.pdf 论文作者:Zongsheng Yue, Jianyi Wang, Chen Change Loy 内容整理:阳浩宁 基于扩散的图像超分辨率(SR)方法主要因需要进行数百甚至数千次采样步骤,导致推理速度较慢而受到限制。现有的加速采样技术不可避免地在一定程度上牺牲性能,导致超模糊的SR结果。为了解决这个问题,本文提出了一种新颖高效的扩散模型用于SR,显著减少了扩散步骤的数量,从而在推理过程中消除了后加速的需求及其相关的性能下降。本文的方法通过在高分辨率图像和低分辨率图像之间移动残差来构建一个马尔可夫链,大幅提高了转换效率。此外,本文还精心设计了一个噪声序列,可以在扩散过程中灵活控制移动速度和噪声强度。大量实验证明,即使只有15个采样步骤,本文提出的方法在合成和真实数据集上都能获得优秀或者至少可与当前最先进方法相媲美的性能。
目录
- 简介
- 方法
- 模型设计
- 噪声序列
- 实验
- 实验设置
- 模型分析
- 合成数据上的测试
- 真实数据上的测试
- 总结
简介
图像超分辨率(SR)是低层次视觉中的一个基本问题,旨在从低分辨率(LR)图像中恢复高分辨率(HR)图像。由于真实场景中降解模型的复杂性和未知性质,这个问题严重缺乏明确性。最近,扩散模型在图像生成方面取得了空前的成功。此外,它还展现了在解决几个下游低层次视觉任务方面的巨大潜力,包括图像编辑、图像修补、图像着色等。一种常见的方法包括将低分辨率图像插入当前扩散模型(例如DDPM)的输入,并从头开始在SR训练数据上重新训练模型。另一种流行的方法是使用一个无条件预先训练的扩散模型作为先验,并修改其逆向路径以生成预期的高分辨率图像。不幸的是,这两种策略都继承了DDPM基础的马尔可夫链,这种方式推理效率低下,通常需要数百甚至数千个采样步骤。尽管已经开发了一些加速技术来减少推理中的采样步骤,但它们不可避免地导致性能显著下降,导致图像过度平滑的结果。因此,有必要设计一个新的扩散模型用于SR,同时实现高的效率和性能。 基于上述动机,本文提出了一种高效的扩散模型,用一个较短的马尔可夫链实现在高分辨率图像和其对应的低分辨率图像之间进行过渡。马尔可夫链的初始状态收敛到高分辨率图像的近似分布,而最终状态收敛到低分辨率图像的近似分布。为实现这一点,本文精心设计了一个过渡核,逐步地移动它们之间的残差。与现有基于扩散的SR方法相比,这种方法更高效,因为残差信息可以在几十个步骤内快速传输。此外,这种设计还允许对证据下界进行解析和简洁的表达,从而简化了训练优化目标的引入。基于构建的扩散核,本文进一步开发了一个高度灵活的噪声序列,控制每一步中残差的移动速度和噪声强度。这种序列通过调整其超参数促进了恢复结果的保真度和真实性之间的权衡。
方法
模型设计
本文提出的方法构建了一个将HR和LR图像连接起来的马尔可夫链,如图1所示。这样一来,对给定的任何低分辨率图像通过该马尔可夫链进行逆向采样,就可以完成超分辨率任务。下面是构建构建这一过程的具体方法。
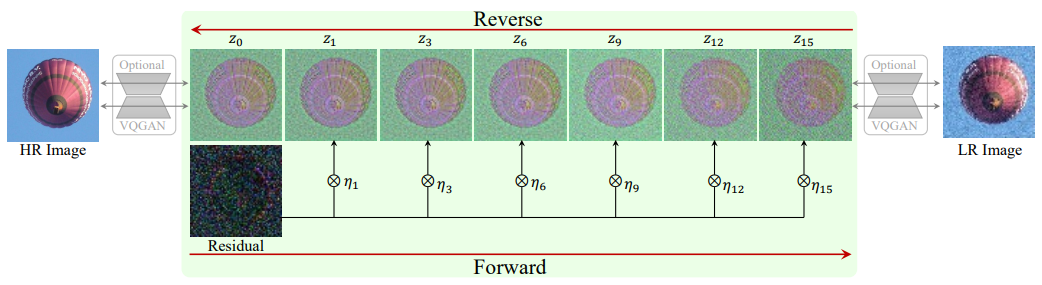
图1 模型总体示意图
设LR和HR图像之间的残差
。前向过程的目标是通过一个长度为
的马尔可夫链,逐渐调整残差
,从而将
转化为
。本文引入了偏移序列
,它随着时间步骤
单调增长,满足
。其概率分布如公式1所示。
其中
时
,
是控制噪声方差的超参数,用来提升这种方法的灵活性。值得注意的是,任意时间步骤t的边际分布是解析可积的,如公式2所示。
这种方法主要基于两个原则,第一个是关于标准差
的,它旨在实现从
到
之间的平滑转换。这是因为在图像数据处于
范围时,
和
之间的期望距离会被限定在
内,如公式3所示。
第二个原则与平均参数有关,即
,它可以推导出公式2中的边缘分布。此外,
和
的边缘分布分别收敛于
和
,作为HR图像和LR图像的两个近似分布。 反向过程的目标是通过公式4所示的表示估计后验分布。
其中
,
。
是可学习的参数,由将公式5所示的变分下界最小化获得。
目标分布
可由公式1和公式2推导得出,由公式6所示。
对比之前的表示形式,考虑到方差和
是相互独立的,这里的方差表示为
,均值如公式7所示。
其中
是一个深度神经网络,以
为参数,用于预测
。由此,目标函数可以简化为公式8的形式。
其中
。不过本文的实验表明忽略
可以提升性能。 为了减轻训练中的计算开销,还可以将上述模型移动到VQGAN的潜在空间中,让原始图像在空间维度上被压缩为4倍。这不需要对模型进行任何修改,只需将
和
替换为它们的潜在代码。
噪声序列
ResShift通过超参数
和偏移序列
决定扩散模型中的噪声。
调节了过渡过程中的整体噪声强度。下面将讨论如何构建
。 由公式2可知
步骤时的噪声级别与
成正比,因此本文主要关注设计
而非
。研究表明
应该足够小以保证
。结合
的附加条件,本文将
设置在
和
之间,并设置
以满足
。对于中间步骤,噪声设置如公式9所示。
其中
超参数
控制了
的增长率,如图2(h)所示。这种噪声序列在三个关键的方面展示了其灵活性。第一,对于较小的
,最终状态
收敛为图2(c)-(d)所示的LR图像周围的扰动。与最终状态为高斯噪声的损坏相比,该设计大大缩短了马尔可夫链的长度,从而提高了推理效率。其次,超参数
提供了对偏移速度的精确控制,从而在SR结果中实现了保真度-真实感的权衡。第三,通过设置
和
,本文的方法实现了与LDM非常相似的扩散过程。图2(e)-(f)展示了这一点,并且图2(g)的相对噪声强度进一步论证了这一点。
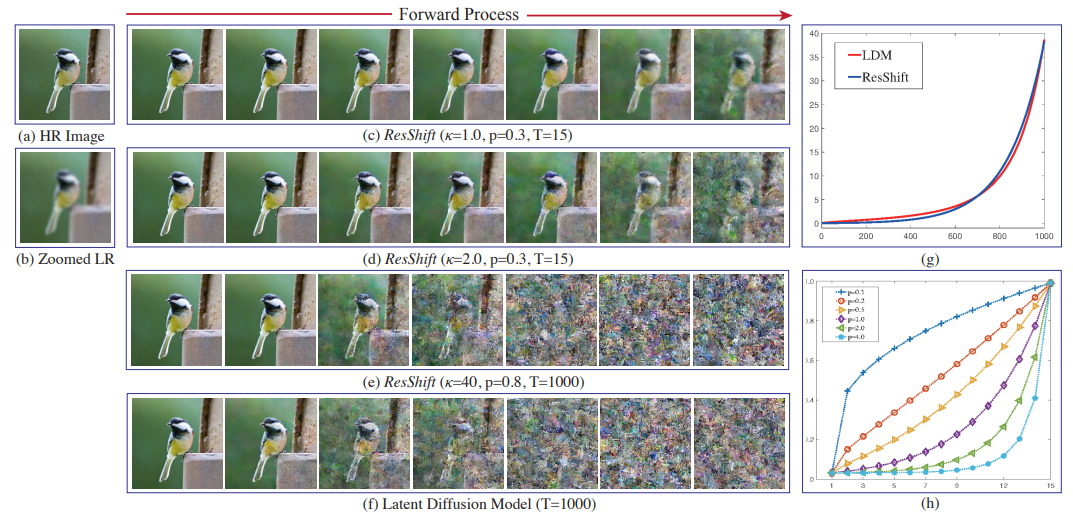
图2 噪声序列具体效果展示
实验
实验设置
训练使用的
分辨率的HR图像是根据LDM中的方法由ImageNet训练集中的图片随机裁剪而来,LR图片则使用了RealESRGAN中的退化方法得到。网络结构方面,ResShift使用了DDPM中的UNet结构,并将其中的自注意力模块替换为Swin Transformer块以提升在任意分辨率下的鲁棒性。 本文的测试集从ImageNet验证集中随机选择了3000张图片,并使用常用的退化模型得到LR图像。另外有两组真实世界的数据集被用来评价ResShift的功能。第一个是RealSR,它包含100张由Canon 5D3和Nikon D810照相机拍摄的图像。另一个数据集是本文收集的,命名为RealSet65,包含35张最近的架构中经常使用的LR图像和互联网上收集的30张图像。测试指标选择了PSNR,SSIM,LPIPS,MUSIQ和CLIPIQA来评价生成图像的质量。
模型分析
表1展示了不同的扩散步数
,超参数
和
下ResShift的性能。实验表明
和
会使ResShift在保真度和真实性之间做出权衡。而结合图3的结果,可以看出过大或过小的
都会使恢复的结果变得平滑。当
时,模型可以取得较好的结果,因此本文设置
。
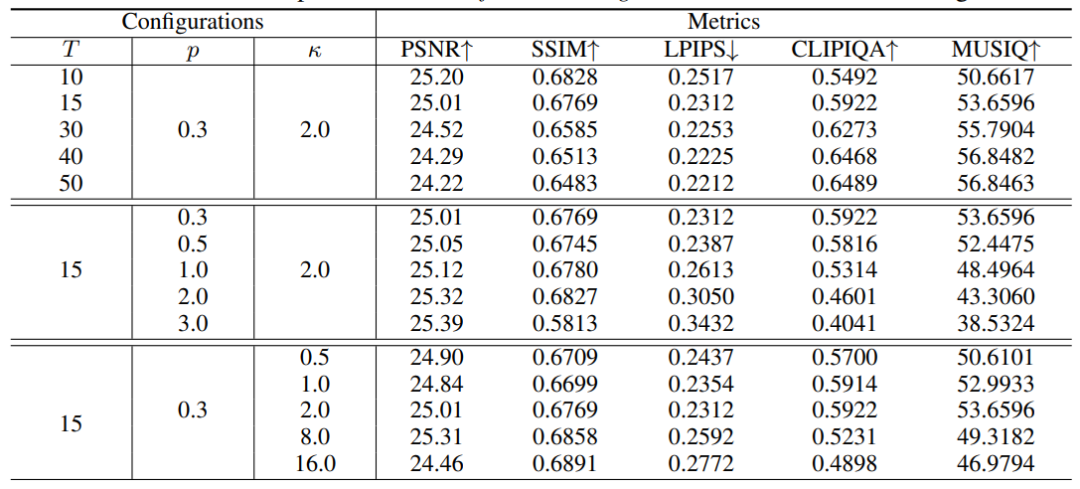
表1 不同配置下ResShift的性能对比
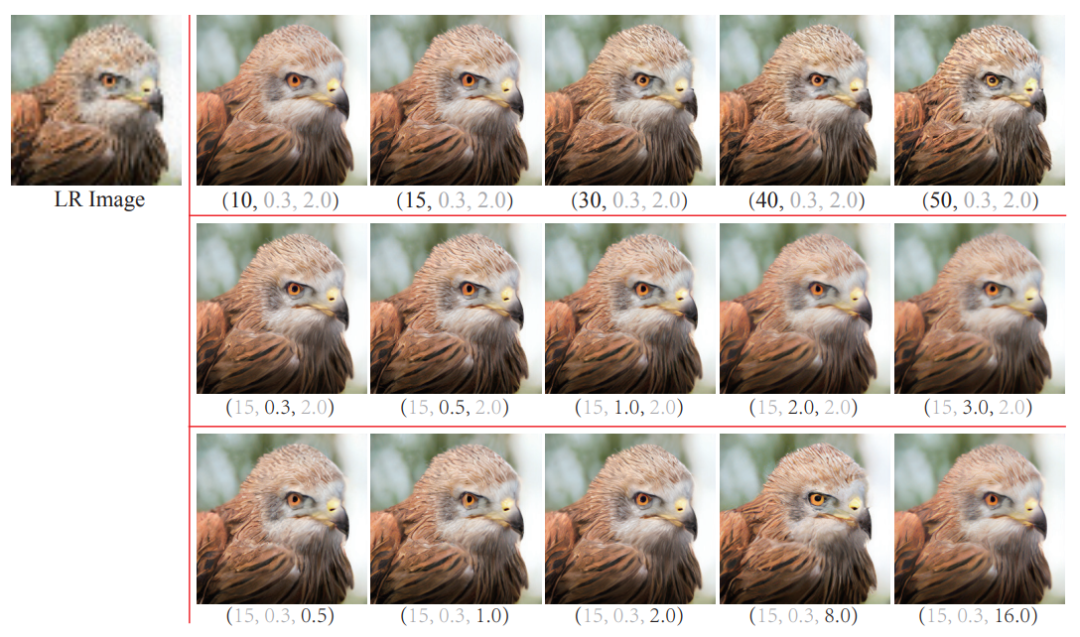
图3 不同配置下ResShift的效果展示
为了提升推理效率,需要将扩散步数
设置得较小,但这会让恢复图像的真实性下降。而将
设为一个较小的值可以改善这一点。综合考虑,本文取
。表2展示了ResShift和一些其他方法在性能和效率上的对比。结果表明,ResShift相比LDM方法在效率上有明显的提升,但其迭代采样机制仍然使其效率低于基于GAN的方法。未来仍然有必要探索进一步优化的方法来解决这一限制。
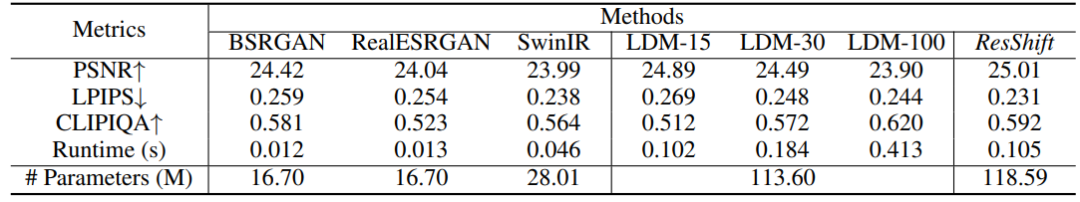
表2 不同方法的性能和效率对比
SR领域有一个知名的现象,即感知-失真权衡。具体来说,增强恢复模型的生成能力将导致保真度的恶化,同时增强恢复图像的真实性。这主要是因为生成能力强大的复原模型容易产生更多高频图像结构的假象,从而偏离底层的真实图像。图4展示了ResShift和LDM的感知-失真曲线,其中感知和失真分别由LPIPS和MSE表示。可以观察到,ResShift的感知-失真曲线始终位于LDM的曲线之下,表明它在平衡感知和失真方面的能力更强。

图4 ResShift和LDM的感知-失真曲线
合成数据上的测试
表3展示了ResShift和其他方法在ImageNet测试集上的性能。综合来看,ResShift在生成更真实的结果同时保持保真度方面表现出卓越的能力。这对SR的任务至关重要。
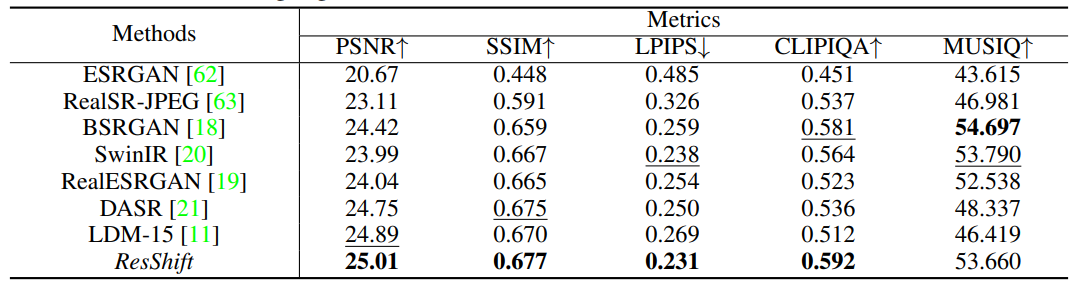
表3 不同方法在ImageNet测试集上的结果
真实数据上的测试
表4展示了ResShift和其他方法在CLIP-IQA和MUSIQ两个指标上的性能。总的来说,ResShift在解决现实世界的SR问题方面表现出了很好的能力。
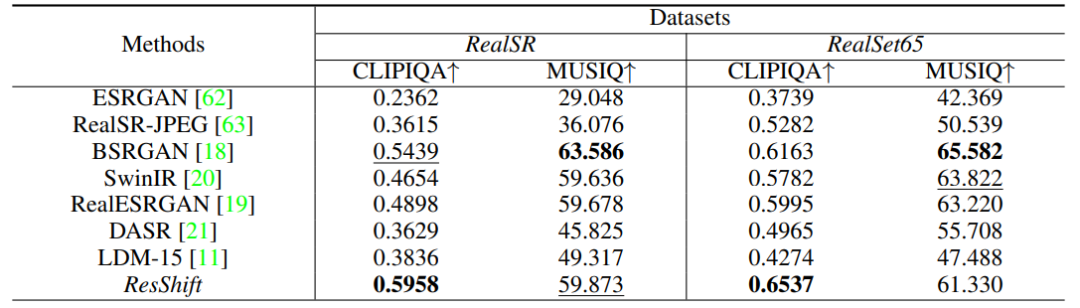
表4 不同方法在两个真实世界数据集上的结果
总结
这项工作介绍了一种名为ResShift的高效扩散模型,用于超分辨率(SR)。与现有的需要大量迭代才能达到满意结果的基于扩散的SR方法不同,ResShift只需进行15个采样步骤构建扩散模型,从而显著提高推理效率。其核心思想是将高分辨率图像向低分辨率图像而非高斯白噪声进行破坏,这可以有效缩短扩散模型的长度。对合成和真实数据集进行的大量实验证明了这种方法的优越性。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2023-12-06,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号