
首页
学习
活动
专区
圈层
工具
发布
综合排序丨最热优先丨最新优先
时间不限
【场景文字识别】场景文字识别
场景文字识别是在图像背景复杂、分辨率低下、字体多样、分布随意等情况下,将图像信息转化为文字序列的过程,可认为是一种特别的翻译过程:将图像输入翻译为自然语言输出。 场景图像文字识别技术的发展也促进了一些新型应用的产生,如通过自动识别路牌中的文字帮助街景应用获取更加准确的地址信息等。 在场景文字识别任务中,我们介绍如何将基于CNN的图像特征提取和基于RNN的序列翻译技术结合,免除人工定义特征,避免字符分割,使用自动学习到的图像特征,完成端到端地无约束字符定位和识别。 本例将演示如何用 PaddlePaddle 完成 场景文字识别 (STR, Scene Text Recognition) 。 任务如下图所示,给定一张场景图片,STR 需要从中识别出对应的文字"keep"。 ? 图 1. 输入数据示例 "keep" |2.
用户1386409
2018-04-02
30.5K0
标签:
通用文字识别-通用文字OCR-文字识别接口介绍
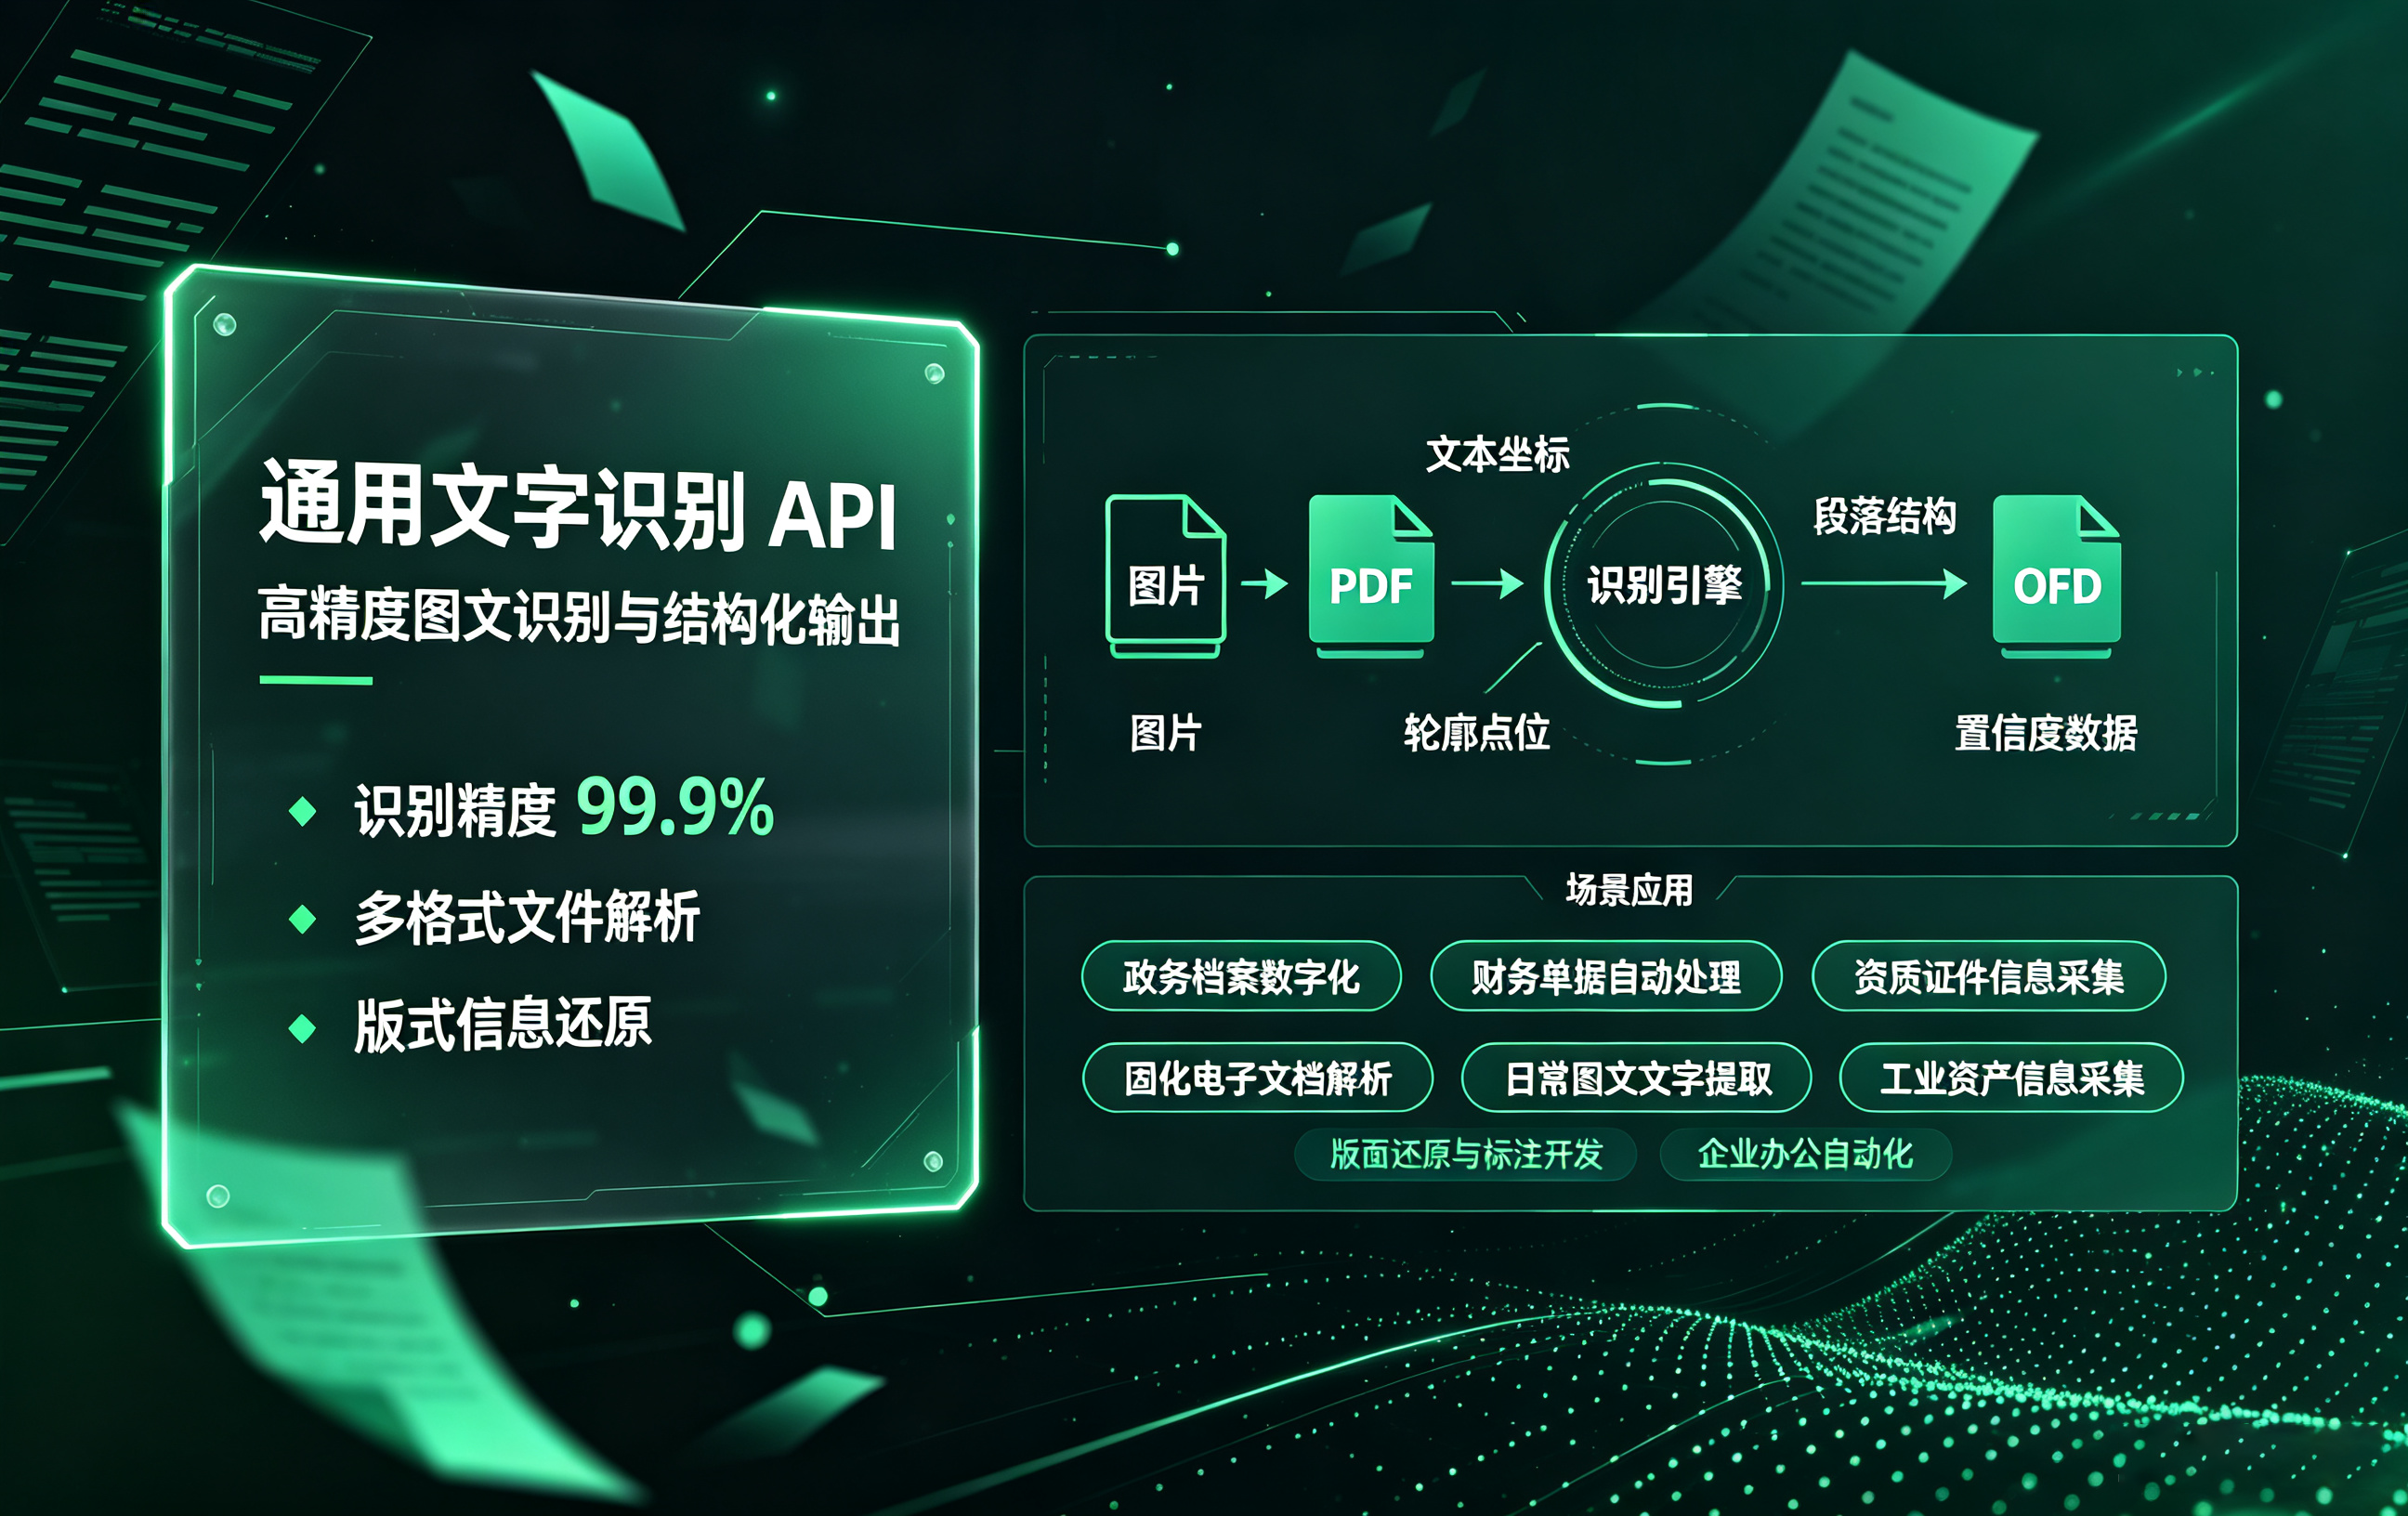
前言传统人工录入图文资料存在效率低、出错率高、无法留存文字位置版式信息等问题。 本通用文字识别 API 依托深度学习优化算法,识别精度最高可达 99.9%,支持图片、PDF、OFD 文件解析,同步返回文本坐标、轮廓点位、段落结构与置信度数据;可快速对接各类业务系统,完成图像文字结构化 通用文字识别在以下场景中应用广泛:政务档案数字化财务单据自动处理资质证件信息采集固化电子文档解析日常图文文字提取工业资产信息采集版面还原与标注开发企业办公自动化API介绍请求说明名称类型必须说明imageString 否图片base64pdfString否PDF文件的base64pdfNumString否需要识别的PDF文件的对应页码,不传默认识别第 1 页ofdString否OFD文件的base64ofdNumString 否需要识别的OFD文件的对应页码,不传默认识别第 1 页fileFile否文件urlString否文件地址image、pdf、ofd、file、url 必须提供一个,优先级:image > pdf >
聚美智数
2026-07-24
2630
标签:
文字识别0727
数学公式识别和物理公式识别有什么区别吗? 新增了二维码识别 本接口支持条形码和二维码的识别(包括 DataMatrix 和 PDF417)。 image.png 这个二维码识别有什么用呢? 条形码识别,我就是好奇,为什么便利店里扫码,可以直接识别那么快,还有各种奇形怪状的想法,奇思妙想的想法。
算法发
2020-07-29
29.2K0
标签:
Python文字识别
matplotlib pip3 install torch torchvision torchaudio pip install matplotlib pip install torchvision 训练数字识别模型 """ ****************** 训练数字识别模型 ******************* """ # -*- coding: utf-8 -*- import cv2 import imshow(images) print(labels) # 定义一个LeNet-5网络,包含两个卷积层conv1和conv2,两个线性层作为输出,最后输出10个维度 # 这10个维度作为0-9的标识来确定识别出的是哪个数字 /MNISTModel.pkl") 关闭开始训练 20次训练完成 已保存模型 实现MNIST手写数字识别 """ ****************** 实现MNIST手写数字识别 ******** enlarge_img) cv2.waitKey(0) # 定义一个LeNet-5网络,包含两个卷积层conv1和conv2,两个线性层作为输出,最后输出10个维度 # 这10个维度作为0-9的标识来确定识别出的是哪个数字
残浔
2023-05-11
20.9K0
标签:
文字识别0730
条码信息识别 那天我的手机没电了,然后我到最近的美宜佳超市去借了一个充电宝,借充电宝之前需要扫一下二维码。 但是我的手机已经关机,于是就买了一瓶水,扫描上面的条形码,然后顺便先充个电。 通过微信小程序可以实现条码信息识别吗?有客户实现过这个案例吗? 微信小程序识别的顺序是怎么样的呢?
算法发
2020-07-30
27.3K0
标签:
图片文字识别(2)
上篇文章主要对百度AI文字识别接口最基础的通用文字以及手写文字图片进行了接入识别,本篇文章我们来接着看几个实用性比较强的文字识别接口。百度AI接口对接挺容易的,签名加密都没有涉及到。 但是这样操作优缺点在哪呢: 优点:相对于读取本地照片,用户可以传入指定图片的url进行缓冲数据再进 行编码为BASE64,可以达到文字识别用户想要上传的图片。 表格文字识别(内含两个接口) 自动识别表格线及表格内容,结构化输出表头、表尾及每个单元格的文字内容。 本接口为异步接口,分为两个API:提交请求接口、获取结果接口。下面分别描述两个接口的使用方法。 但是我这里就不准备一一介绍了,有兴趣可以自行查看百度AI文字识别文档: https://ai.baidu.com/docs#/OCR-API/87932804 其实业务开发过程如果适当的引入人脸识别,文字识别等 而且百度AI还提供了一系列需要申请权限的接口,很大成都方便了我们的开发,我们不必去追究底层是如何识别图片中的文字的,就可以快速接入API识别我们需要的功能。
创译科技
2019-07-01
58.3K0
标签:
Tesseract ocr文字识别
https://blog.csdn.net/haluoluo211/article/details/77776697 前面很早做了图片的文字识别主要用到了开源框架Tesseract,当然做OCR 之前先要定位图片文字。 先上个图: 工作中项目组一般使用java因此代码,下面贴出java代码,最简单的图片识别: package com.recognition; import java.awt.*; import catch (TesseractException e) { System.err.println(e.getMessage()); } } } 图片文字提取
bear_fish
2018-09-19
26.9K0
标签:
ocr文字识别0804
今天我翻开ocr识别的demo发现,更新上线了智能卡证分类了。这意味着将为你的开发带来了极大的便利。 image.png 那我们来看一下这个接口给我们带来的能力是什么呢? DiscernType.N 否 Array of String 可以指定要识别的票证类型,指定后不出现在此列表的票证将不返回类型。不指定时默认返回所有支持类别票证的识别信息。 以下是当前支持的类型:IDCardFront: 身份证正面识别IDCardBack: 身份证背面识别Passport: 护照BusinessCard: 名片识别BankCard: 银行卡识别VehicleLicenseFront : 行驶证主页识别VehicleLicenseBack: 行驶证副页识别DriverLicenseFront: 驾驶证主页识别DriverLicenseBack: 驾驶证副页识别PermitFront: 当图片类型不支持分类识别或者识别出的类型不在请求参数DiscernType指定的范围内时,返回结果中的Type字段将为空字符串,Name字段将返回"其它" RequestId String 唯一请求 ID
算法发
2020-08-04
46.7K0
标签:
Tesseract Ocr文字识别
Tesseract的OCR引擎最先由HP实验室于1985年开始研发,至1995年时已经成为OCR业内最准确的三款识别引擎之一。 tesseract_cmd = 'tesseract' 修改为: tesseract_cmd = 'C:/Program Files (x86)/Tesseract-OCR/tesseract.exe' 四、代码识别 text-img.png" text = pytesseract.image_to_string(Image.open(path), lang='chi_sim') print(text) 作为非常优秀的Ocr识别库 ,tesseract当然可以训练自己的数据模型,从而达到为我所用目的,后续文字会介绍如果训练自己的文字识别库。
磊哥
2018-07-04
42K0
标签:
Tesseract Ocr文字识别
Tesseract的OCR引擎最先由HP实验室于1985年开始研发,至1995年时已经成为OCR业内最准确的三款识别引擎之一。 tesseract_cmd = 'tesseract' 修改为: tesseract_cmd = 'C:/Program Files (x86)/Tesseract-OCR/tesseract.exe' 四、代码识别 text-img.png" text = pytesseract.image_to_string(Image.open(path), lang='chi_sim') print(text) 作为非常优秀的Ocr识别库 ,tesseract当然可以训练自己的数据模型,从而达到为我所用目的,后续文字会介绍如果训练自己的文字识别库。
磊哥
2018-05-08
78.9K1
标签:
问题归档专栏文章快讯文章归档关键词归档开发者手册归档开发者手册 Section 归档