#WorkBuddy# 48 份日历 3.6 万对冲突对不上账:朴素解析召回仅 0.24%,七道关口做到 100% 零误报
原创
#WorkBuddy# 48 份日历 3.6 万对冲突对不上账:朴素解析召回仅 0.24%,七道关口做到 100% 零误报
原创
用户12784192
发布于 2026-11-18 10:45:55
发布于 2026-11-18 10:45:55
一、痛点:会议室冲突检测,"看起来能跑"和"跑对"是两回事
团队日历散落在几十份 .ics 文件里:钉钉导出的、日历应用同步的、邮件附件存的。要回答"下周三 Room-03 到底有没有撞期",最常见的做法是写个小脚本:正则抠出 DTSTART/DTEND,两两比一下区间。我们按这个思路写了 A 版本,又在它基础上补了周期规则(B 版本),最后做了全面治理(C 版本),用同一份语料、同一套真值对三者做了实测。
语料是自建的合成日历集:48 份 .ics 文件、共 1,131 KB、2,404 个 VEVENT、10 间会议室。时间形态刻意混用了 iCalendar 标准里的全部四种写法:UTC 尾缀 Z 的 790 个、带 TZID 的 1,096 个(Asia/Shanghai 844、America/New_York 252)、不带任何时区声明的 floating 337 个、VALUE=DATE 全天事件 181 个。另有 533 条 RRULE 周期规则、537 条 EXDATE 排除日期、7,212 行按 RFC 5545 折叠的长属性。真值由生成器按"全部归一到 UTC 后展开、同会议室重叠"口径算出:16,389 个场次、35,799 对冲突。
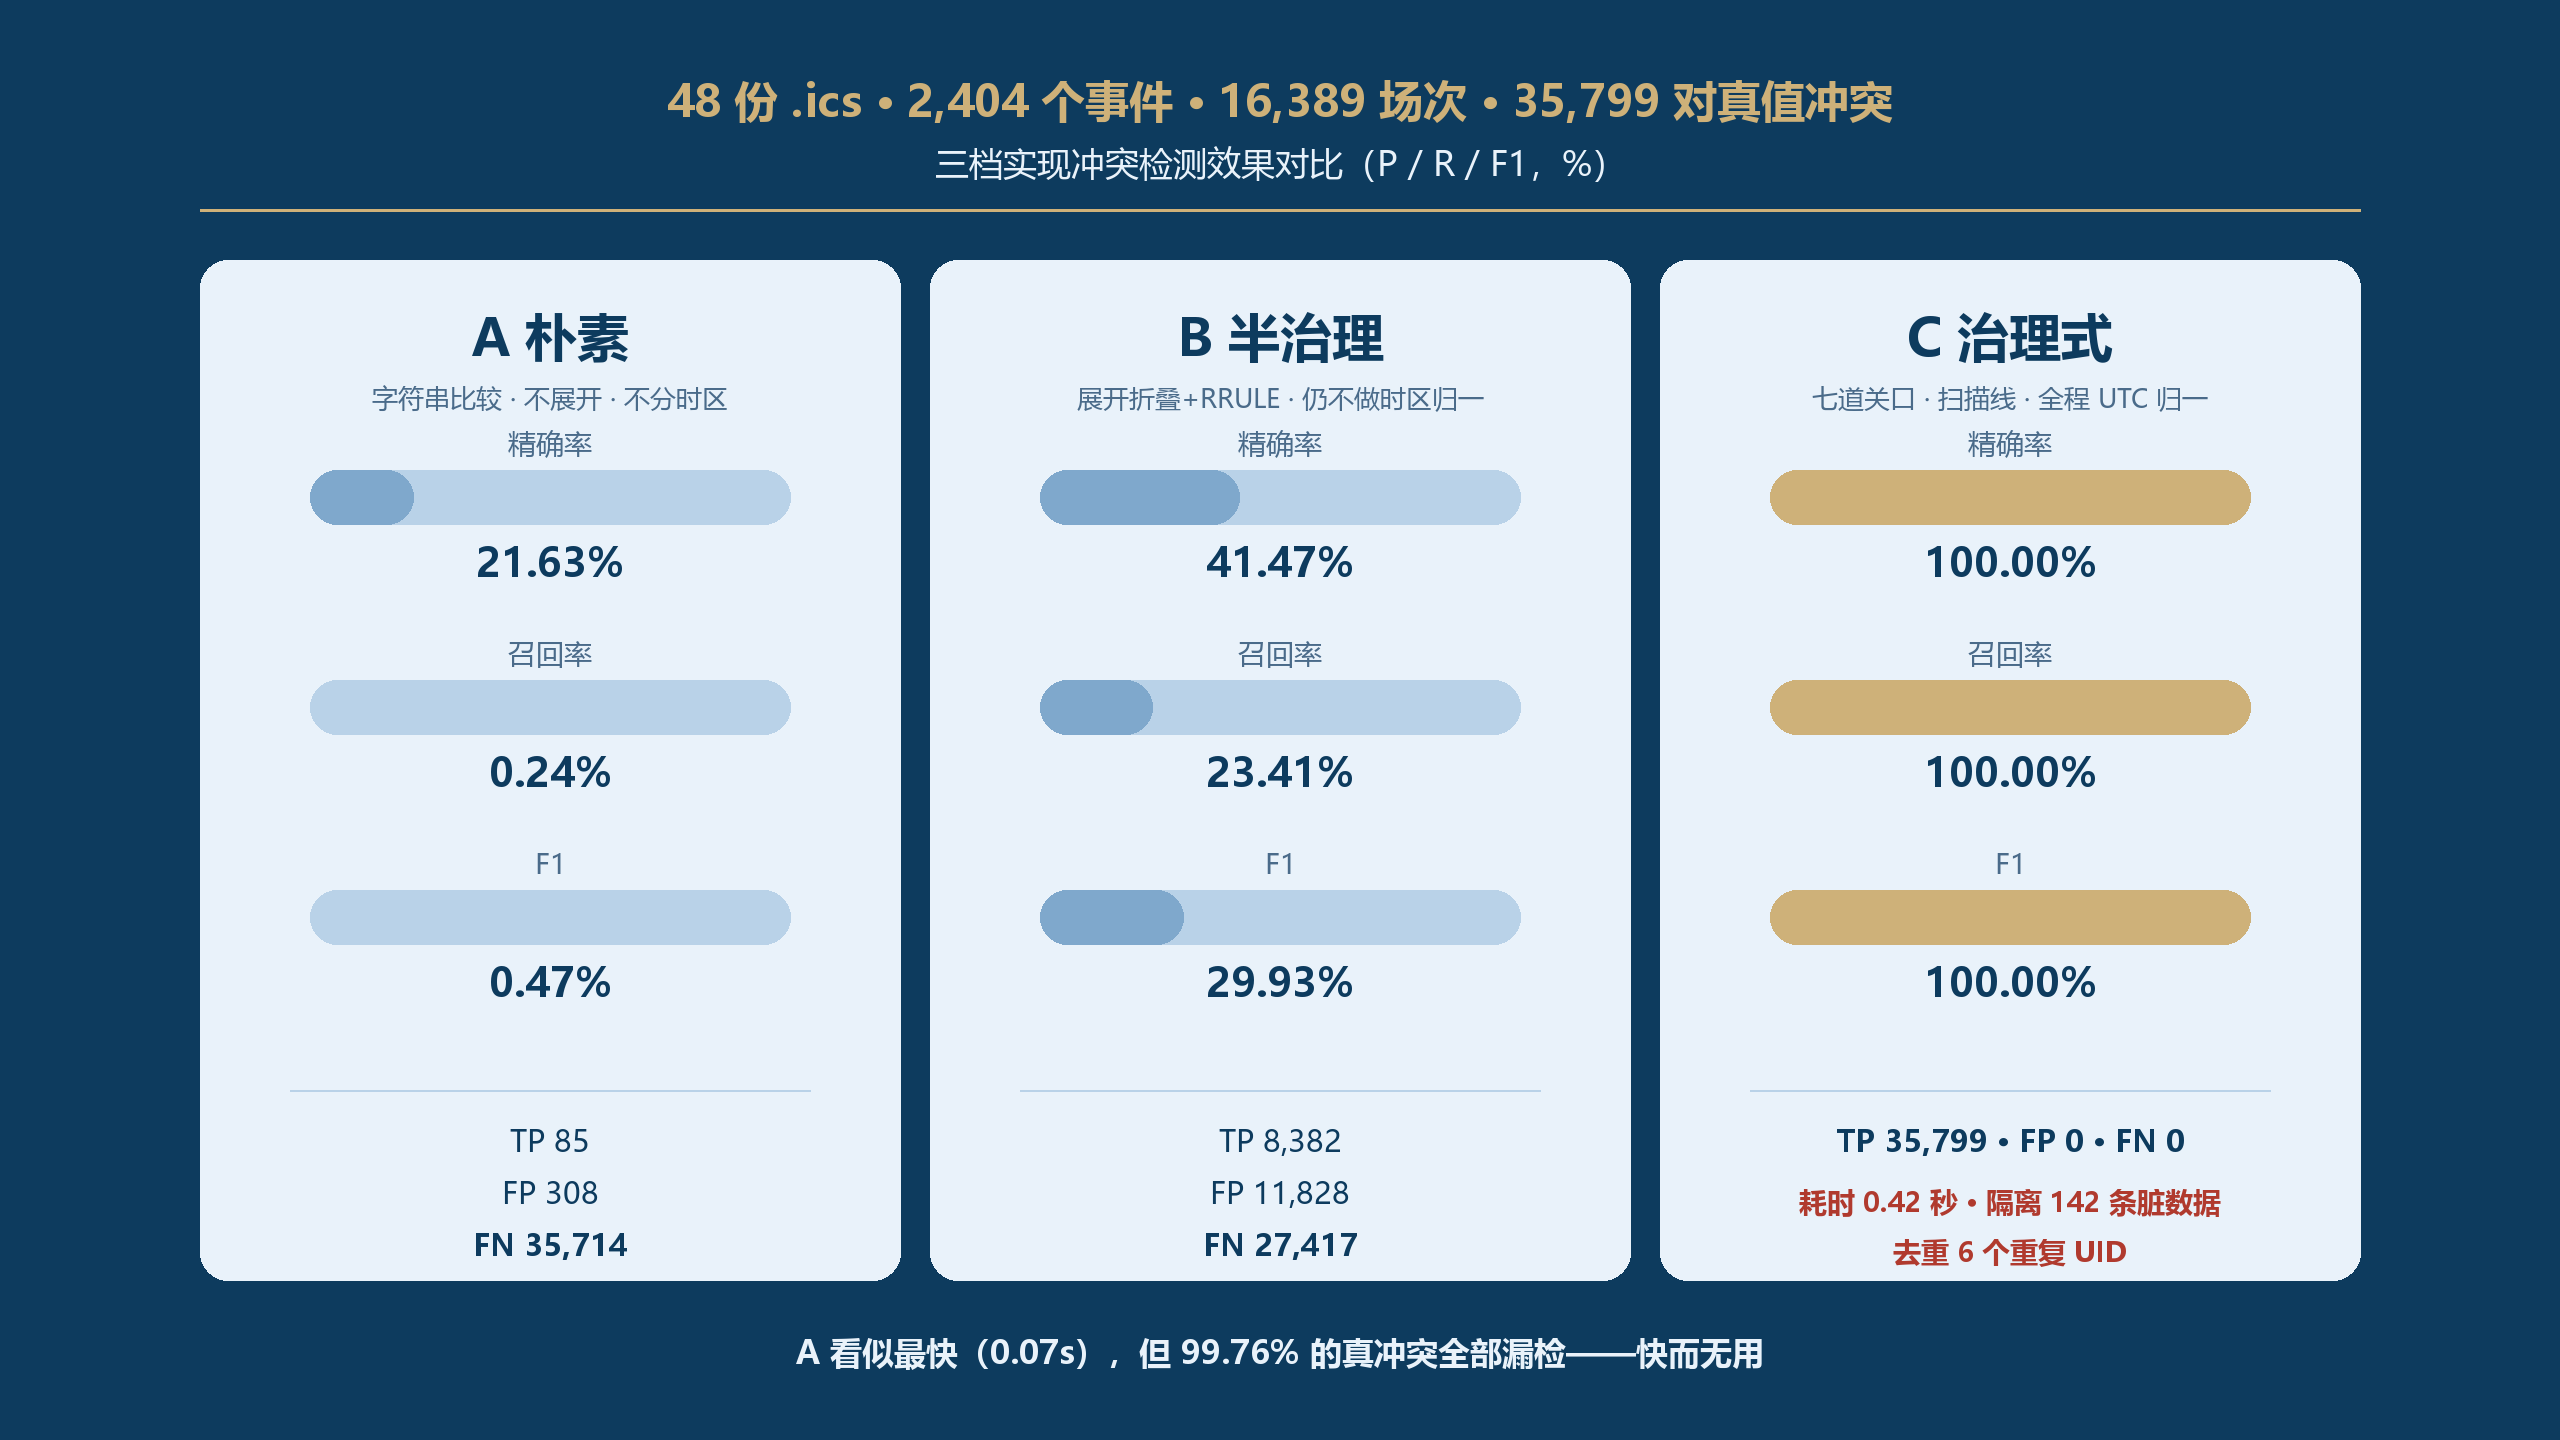
实测结果:A 版本只抓到 85 对真冲突,召回率 0.24%;B 版本召回率也只有 23.41%,还额外制造了 11,828 个假冲突。C 版本 35,799 对全中,零误报零漏检,全程 0.42 秒。
二、根因分析:三个"静默错误源"叠加
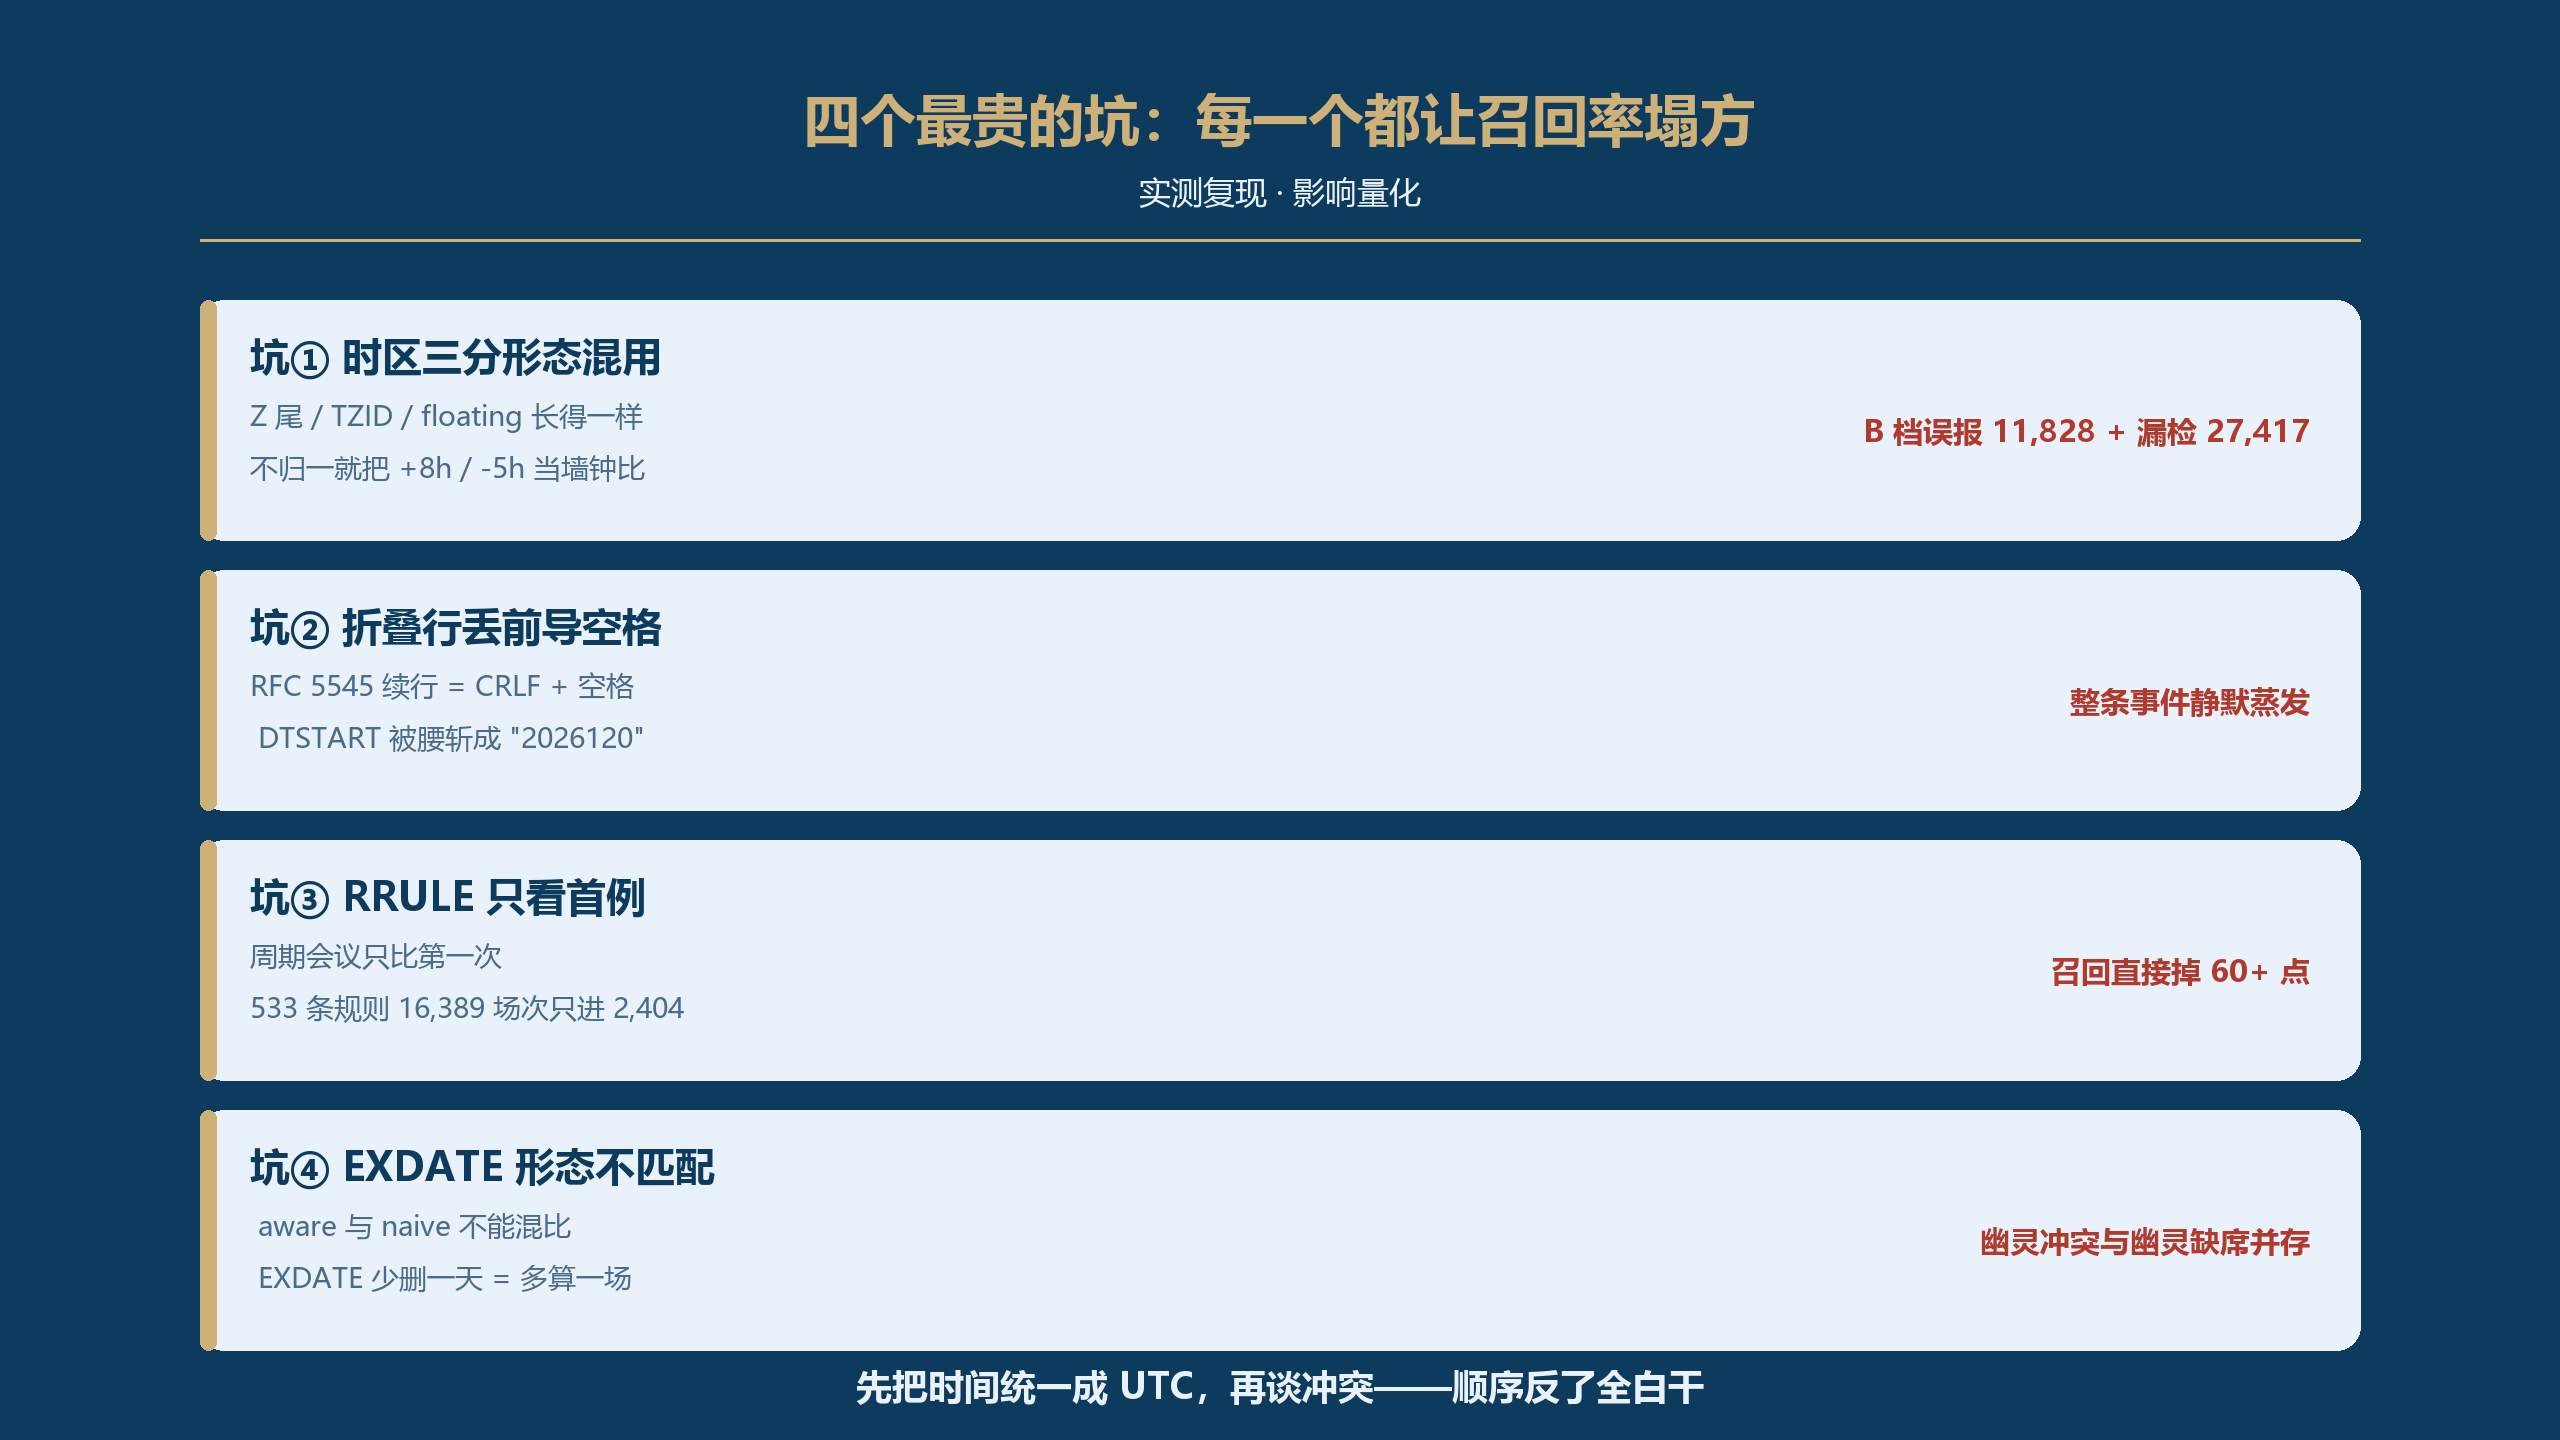
1. 时区三分形态混用,naive 比较全盘皆错。 .ics 里 DTSTART:20261201T090000Z、DTSTART;TZID=Asia/Shanghai:20261201T090000、DTSTART:20261201T090000 三种写法的值长得几乎一样,语义却分别差了 0、+8、+8(floating 按本机约定)小时。纽约时区还带 -5h 偏移。把字符串直接转 datetime 比较,等于把三个不同瞬间当成了同一时刻:真冲突因为"墙钟错开 8 小时"而漏检,假冲突反而成批冒出来。B 版本的 11,828 个误报、27,417 个漏检,主体都是这一条贡献的。
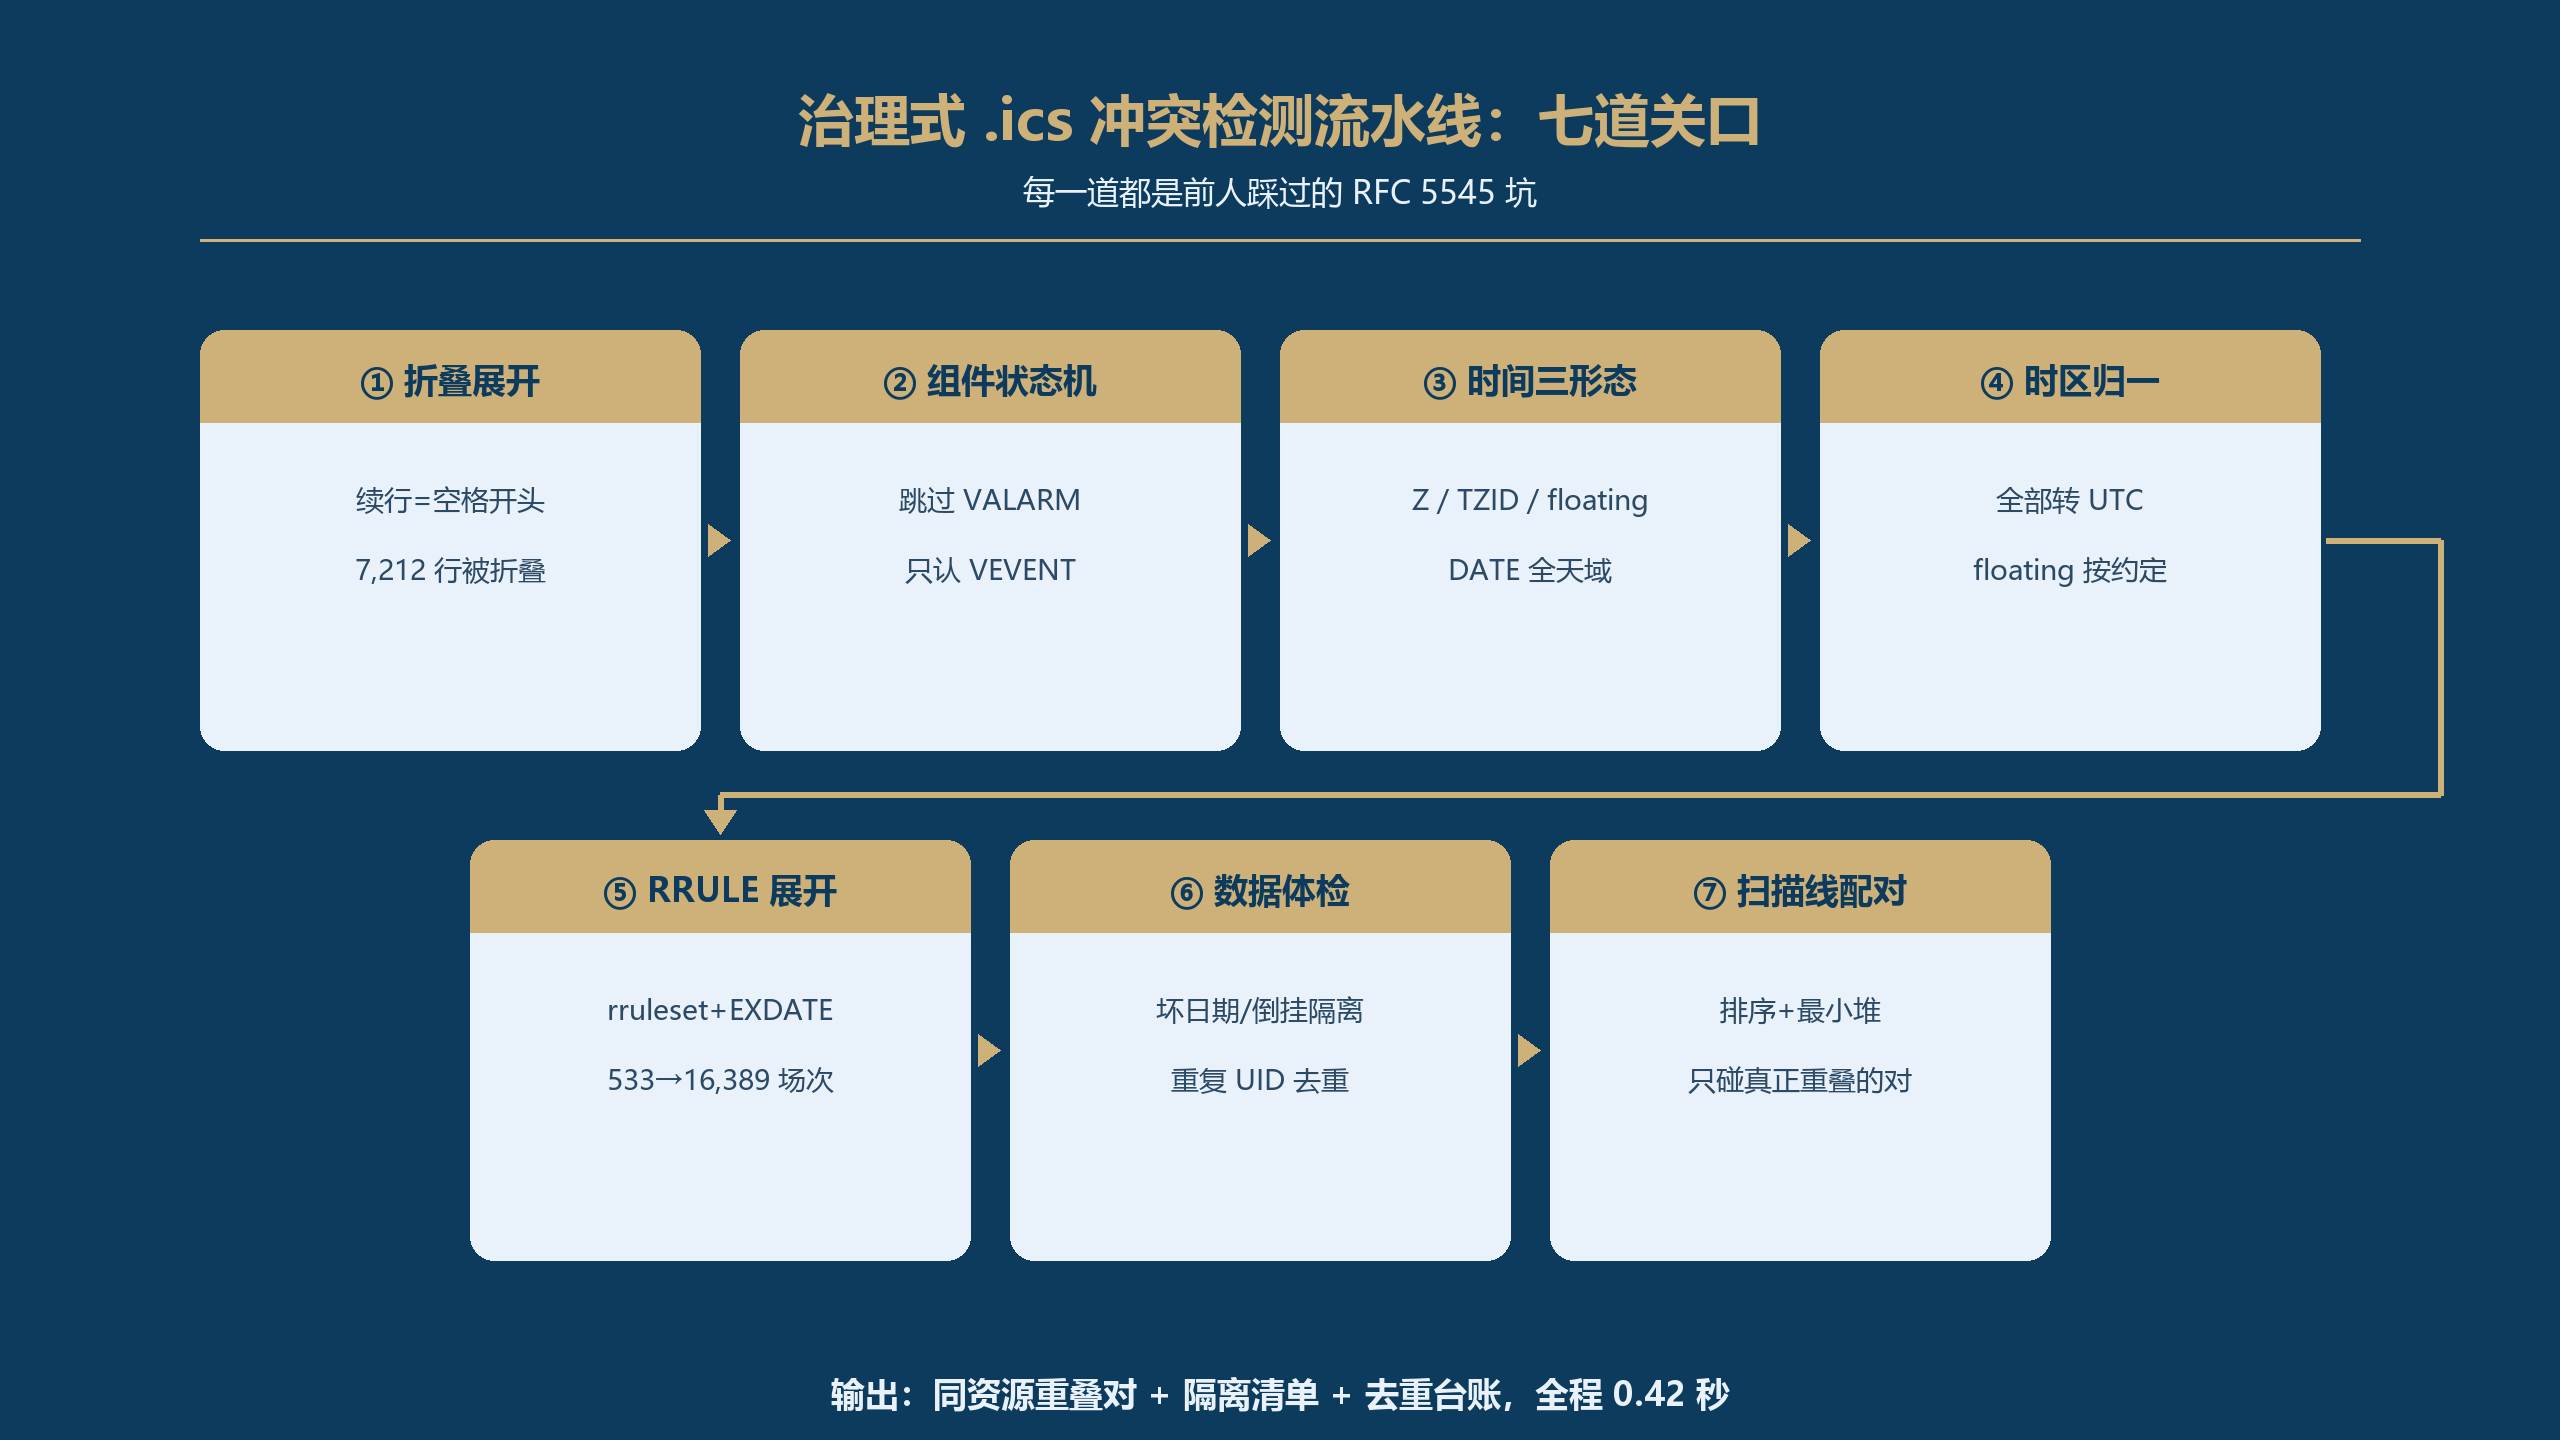
2. 折叠行与粘行,让时间字段静默残缺。 RFC 5545 规定超过 75 字节的属性行要用"换行 + 空格"续行;我们的语料里这类行有 7,212 个。解析器若不展开,DTSTART;TZID=Asia/Shanghai:20261201T0 后半截躺在下一行——strptime 抛异常,事件被 except 静默丢掉,A/B 两版各丢了 270 条。更隐蔽的是"粘行"损坏:续行丢了前导空格,2026120 和 1T091500 断成两行,前者解析失败,后者变成一条无人认识的垃圾属性,不报任何错。
3. RRULE 只比首例,六成场次根本没进比较池。 533 条周期规则展开后贡献了 16,389 个场次中的大部分;只取 DTSTART 第一例,相当于用 2,404 个采样点去覆盖 16,389 个时间点。A 版本召回率 0.24%,这一条是最大头。
三、真实数据对比
语料:48 份 .ics / 2,404 事件 / 16,389 场次 / 35,799 对真值冲突(seed=20261118,可复现)
档位 | 精确率 | 召回率 | F1 | TP / FP / FN | 耗时 |
|---|---|---|---|---|---|
A 朴素(字符串直比) | 21.63% | 0.24% | 0.47 | 85 / 308 / 35,714 | 0.072s |
B 半治理(展开但不归一时区) | 41.47% | 23.41% | 29.93 | 8,382 / 11,828 / 27,417 | 0.232s |
C 治理式(七道关口) | 100.00% | 100.00% | 100.00 | 35,799 / 0 / 0 | 0.423s |
C 版本的附加产出:隔离脏数据 142 条(坏日期 55、区间倒挂 53、粘行 34),去重重复 UID 6 个;扫描线全程只触碰 35,799 次——恰好等于真冲突数,一次多余的比对都没做。
四、可复制代码:治理式核心管线
import heapq
from datetime import datetime, timedelta, timezone
from zoneinfo import ZoneInfo
from dateutil.rrule import rruleset, rrulestr

UTC = timezone.utc
SH = ZoneInfo("Asia/Shanghai")
FLOAT_TZ = SH  # floating 时间按业务约定时区解释

def unfold(raw):
    """RFC 5545 折叠展开:续行必须以空格/Tab 开头,否则视为损坏"""
    lines = []
    for ln in raw.split("\r\n"):
        if ln[:1] in (" ", "\t") and lines:
            lines[-1] += ln[1:]
        else:
            lines.append(ln)
    return lines

def parse_dt(line):
    """三形态时间解析:Z 尾 / TZID / floating,全部返回 aware datetime"""
    head, val = line.split(":", 1)
    if "VALUE=DATE" in head:                      # 全天事件单独域
        d = datetime.strptime(val, "%Y%m%d").replace(tzinfo=SH)
        return d, d + timedelta(days=1)
    if ";TZID=" in head:
        z = ZoneInfo(head.split(";TZID=")[1].split(";")[0])
        return datetime.strptime(val, "%Y%m%dT%H%M%S").replace(tzinfo=z), None
    if val.endswith("Z"):
        return datetime.strptime(val[:-1], "%Y%m%dT%H%M%S").replace(tzinfo=UTC), None
    return datetime.strptime(val, "%Y%m%dT%H%M%S").replace(tzinfo=FLOAT_TZ), None

def expand(ev):
    """RRULE + EXDATE 展开;EXDATE 必须与 DTSTART 同为 aware 才能正确匹配"""
    start, _ = parse_dt(ev["DTSTART"])
    end, _ = parse_dt(ev["DTEND"]) if "DTEND" in ev else (start, None)
    if end < start:
        raise ValueError("interval-inverted")     # 区间倒挂 → 隔离
    if "RRULE" not in ev:
        return [(start, end)]
    rs = rruleset()
    rs.rrule(rrulestr(ev["RRULE"].split(":", 1)[1], dtstart=start))
    for ex in ev.get("EXDATE", []):
        rs.exdate(parse_dt(ex)[0])
    dur = end - start
    return [(o, o + dur) for o in rs]

def sweep(occs):
    """扫描线找重叠对:按开始排序 + 最小堆,只碰真正重叠的对"""
    occs = sorted(occs, key=lambda t: (t[0], t[1]))
    heap, pairs = [], []
    for s, e in occs:
        if e <= s:
            continue                              # 零时长不构成冲突
        while heap and heap[0][0] <= s:
            heapq.heappop(heap)
        for he, hu in heap:
            pairs.append((hu, s))
        heapq.heappush(heap, (e, s))
    return pairs
完整版还包含组件状态机(跳过嵌套 VALARM)、按 UID 的重复去重、坏日期隔离清单三段,逻辑不复杂但缺一不可。要点只有一句话:先把所有时间统一成 aware UTC,再谈冲突比较。
五、踩坑清单
- 文本模式读文件会吃掉
\r\n**。** Pythonopen()默认 universal newlines 把\r\n转成\n,按\r\nsplit 会得到一整行,解析结果为空。必须open(..., newline="")。这是本次排查中最花时间的一课。 - EXDATE 的时区形态必须与 DTSTART 一致。
rruleset.exdate()按 aware datetime 相等性匹配;一边 aware 一边 naive 永远删不掉,会多算出"幽灵场次"。 - dateutil 的
rrulestr拒绝"多时区输入"。 dtstart 传 aware、EXDATE 行里又带TZID参数时直接抛ValueError: specifies multiple timezone。正解是拆开:rrulestr只吃 RRULE 文本,EXDATE 解析成 aware datetime 后走rruleset.exdate()。 - 真值键要规范化再比较。 评估脚本最初一半的"误报"其实是键序颠倒:冲突对 (A, B) 按时间序存真值,却按 UID 序排检测键。统一成"按(开始时间, UID)排序"后 FP 瞬间归零——对账逻辑自身的键规范,和业务逻辑同样重要。
- WEEKLY
BYDAY的判定时区跟随 dtstart 的 tzinfo。 同一时刻在 UTC 和 Asia/Shanghai 可能落在不同的"星期几"上;真值与解析方必须用同一份 tzinfo 表示,否则周期展开直接错位。 - 全天事件是独立域。
VALUE=DATE的值只有 8 位,naive 解析器会在strptime上崩掉或静默丢弃(A/B 各丢 181 条);它的占用区间应按约定时区的 00:00–24:00 换算成 UTC 再参与比较。
六、给 WorkBuddy 的提示词模板
把下面这段发给 WorkBuddy,可以直接复刻这条管线(语料换成你自己的 .ics 目录即可):
请用 Python 写一个 .ics 日历冲突检测脚本,要求:① 读文件用 newline="",先按 RFC 5545 展开折叠行(续行以空格/Tab 开头,否则记为粘行损坏);② 时间解析支持 Z 尾 UTC、TZID、floating、VALUE=DATE 四种形态,统一转成 aware UTC(floating 按 Asia/Shanghai);③ 用 dateutil 的 rruleset 展开 RRULE 并按 aware datetime 匹配 EXDATE;④ 坏日期和 DTEND 早于 DTSTART 的事件进隔离清单不参与比较;⑤ 按 UID 去重;⑥ 同一 LOCATION 内用"按开始排序 + 最小堆"的扫描线输出重叠对;⑦ 最后输出:总事件数、展开场次、冲突对列表、隔离清单、耗时。
七、收尾
这轮实验里,A 版本 0.07 秒跑完、看似最快,但 35,714 对真冲突全部漏检——在数据治理这件事上,"跑得快但跑不对"比"跑得慢"贵得多。时区归一、折叠展开、规则展开这三道工序没有捷径,顺序也不能反:先统一时间轴,再展开场次,最后才轮到区间比较。全部数字来自 seed=20261118 的可复现实验,脚本与真值文件均已归档,欢迎照抄复测。
(本文语料为自建合成数据,不涉及任何真实日历与真实人事信息。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号