#WorkBuddy# 40 份数据库导出 SQL 导入全对不上账:朴素切分只剩 12% 数据,七道关口做到 100%
原创
#WorkBuddy# 40 份数据库导出 SQL 导入全对不上账:朴素切分只剩 12% 数据,七道关口做到 100%
原创
用户12784192
发布于 2026-11-16 10:49:45
发布于 2026-11-16 10:49:45
#WorkBuddy# 40 份数据库导出 SQL 导入全对不上账:朴素切分只剩 12% 数据,七道关口做到 100%
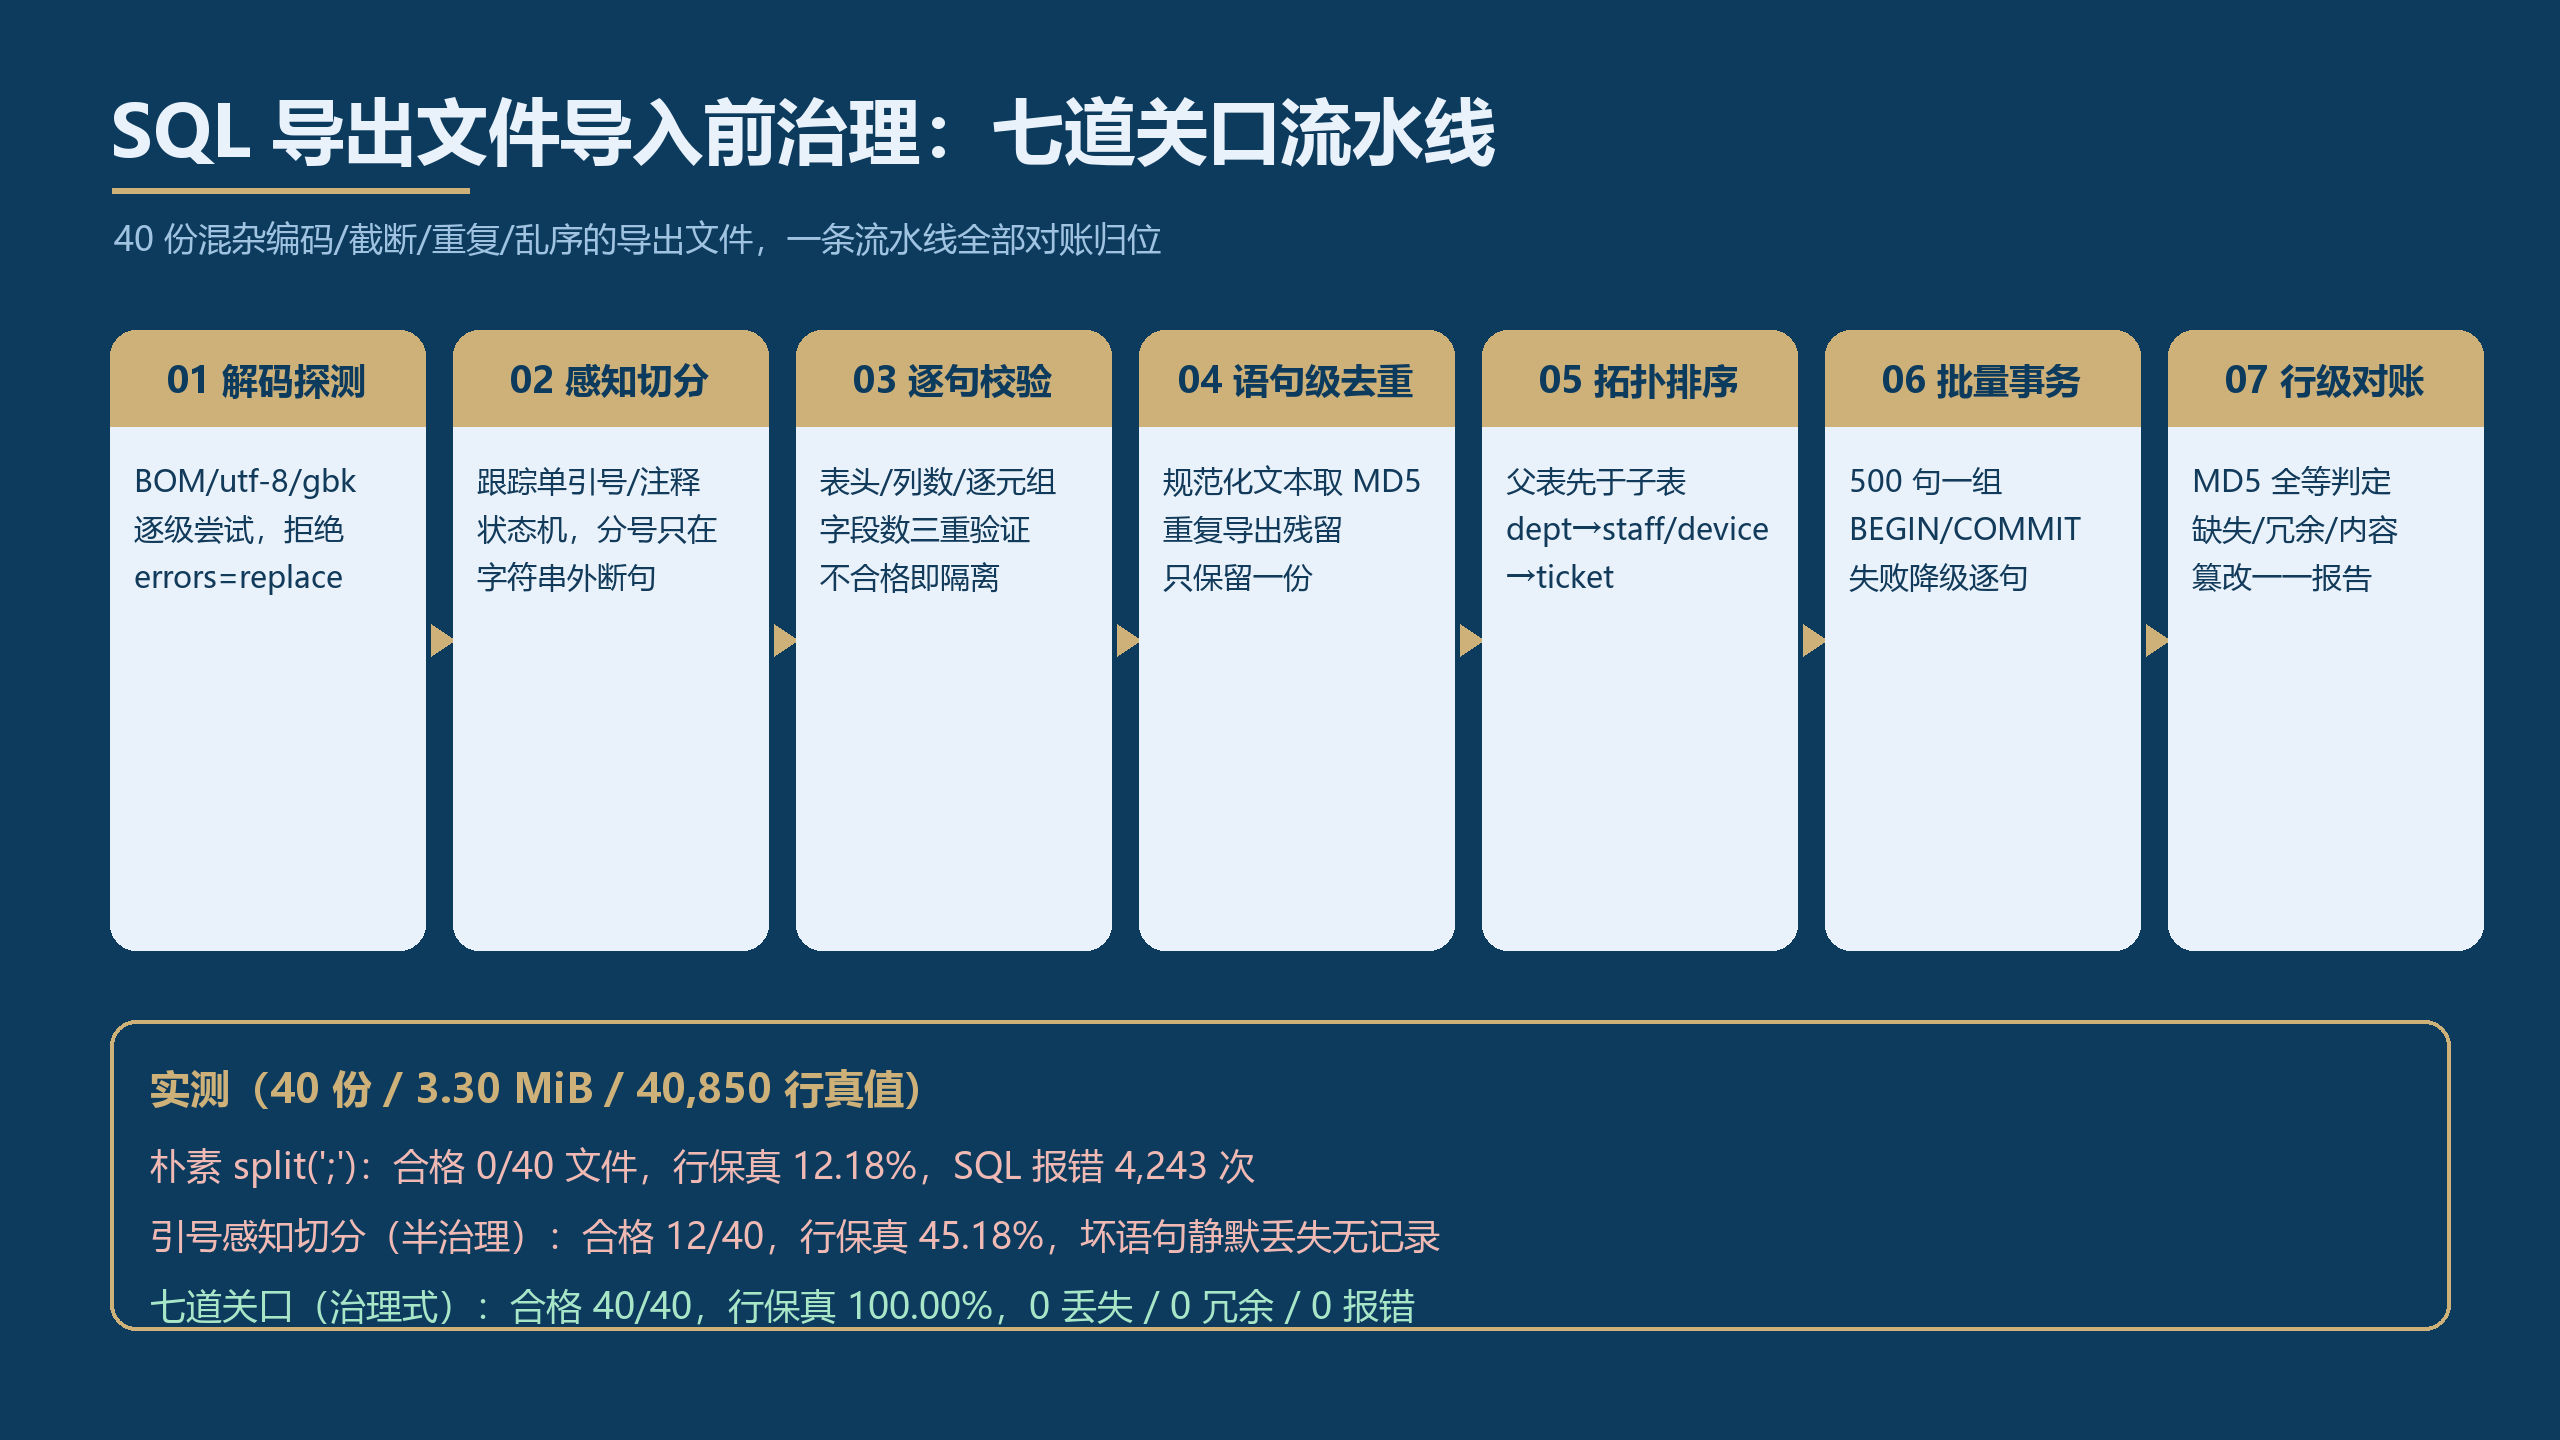
SQL 导出文件导入前治理:七道关口流水线
一、痛点开场
场景很常见:旧系统下线,运维甩过来 40 份 .sql 导出文件,要求全部导进新库、并且行数要能对上账。直觉做法是写个循环:读文件、按分号切开、逐句执行。我把这套朴素流程和治理式流水线在同一批文件上真实跑了一遍,结果差距远超预期——
朴素写法 4,243 次 SQL 报错,40 份文件没有一份能全对上账,41,000 多行数据只保住了 12.18%;治理式流水线 40/40 全部通过逐表 MD5 对账,行保真 100.00%,零丢失、零冗余、零报错。中间差的不是运气,是七道关口。
二、根因分析:导出文件从来不是「干净的」
真实导出文件几乎必然带着四类脏:
- 编码混杂。同一批导出里 utf-8、带 BOM 的 utf-8-sig、gbk 混在一起。本次语料里 gbk 文件占 5 份,
decode('utf-8', errors='replace')一把梭不会报错,但中文全部变成 U+FFFD,行数看着对、内容全是坏的——这类损坏对账才发现不了都不行。 - 朴素切分必炸。备注字段里藏着分号和转义引号(比如
已复核;待归档、客户'要求加急),按split(';')切分时一条多值 INSERT 被腰斩成两个语法错误片段。25 行一条的 INSERT 里只要有 1 行备注带分号,整条 25 行全丢。 - 导出中断留残骸。文件中间躺着截断语句和
@@@ EXPORT ABORTED @@@这类碎片。截断点落在字符串里时引号失去配对,后续所有真实分号都被当成字符串内容——一条坏语句吞掉整个尾部。 - 重复导出块与外键乱序。人工重跑导出会把最后一段语句复制一遍(重复导出残留),而子表语句排在父表前面时,外键约束一开就是级联失败。
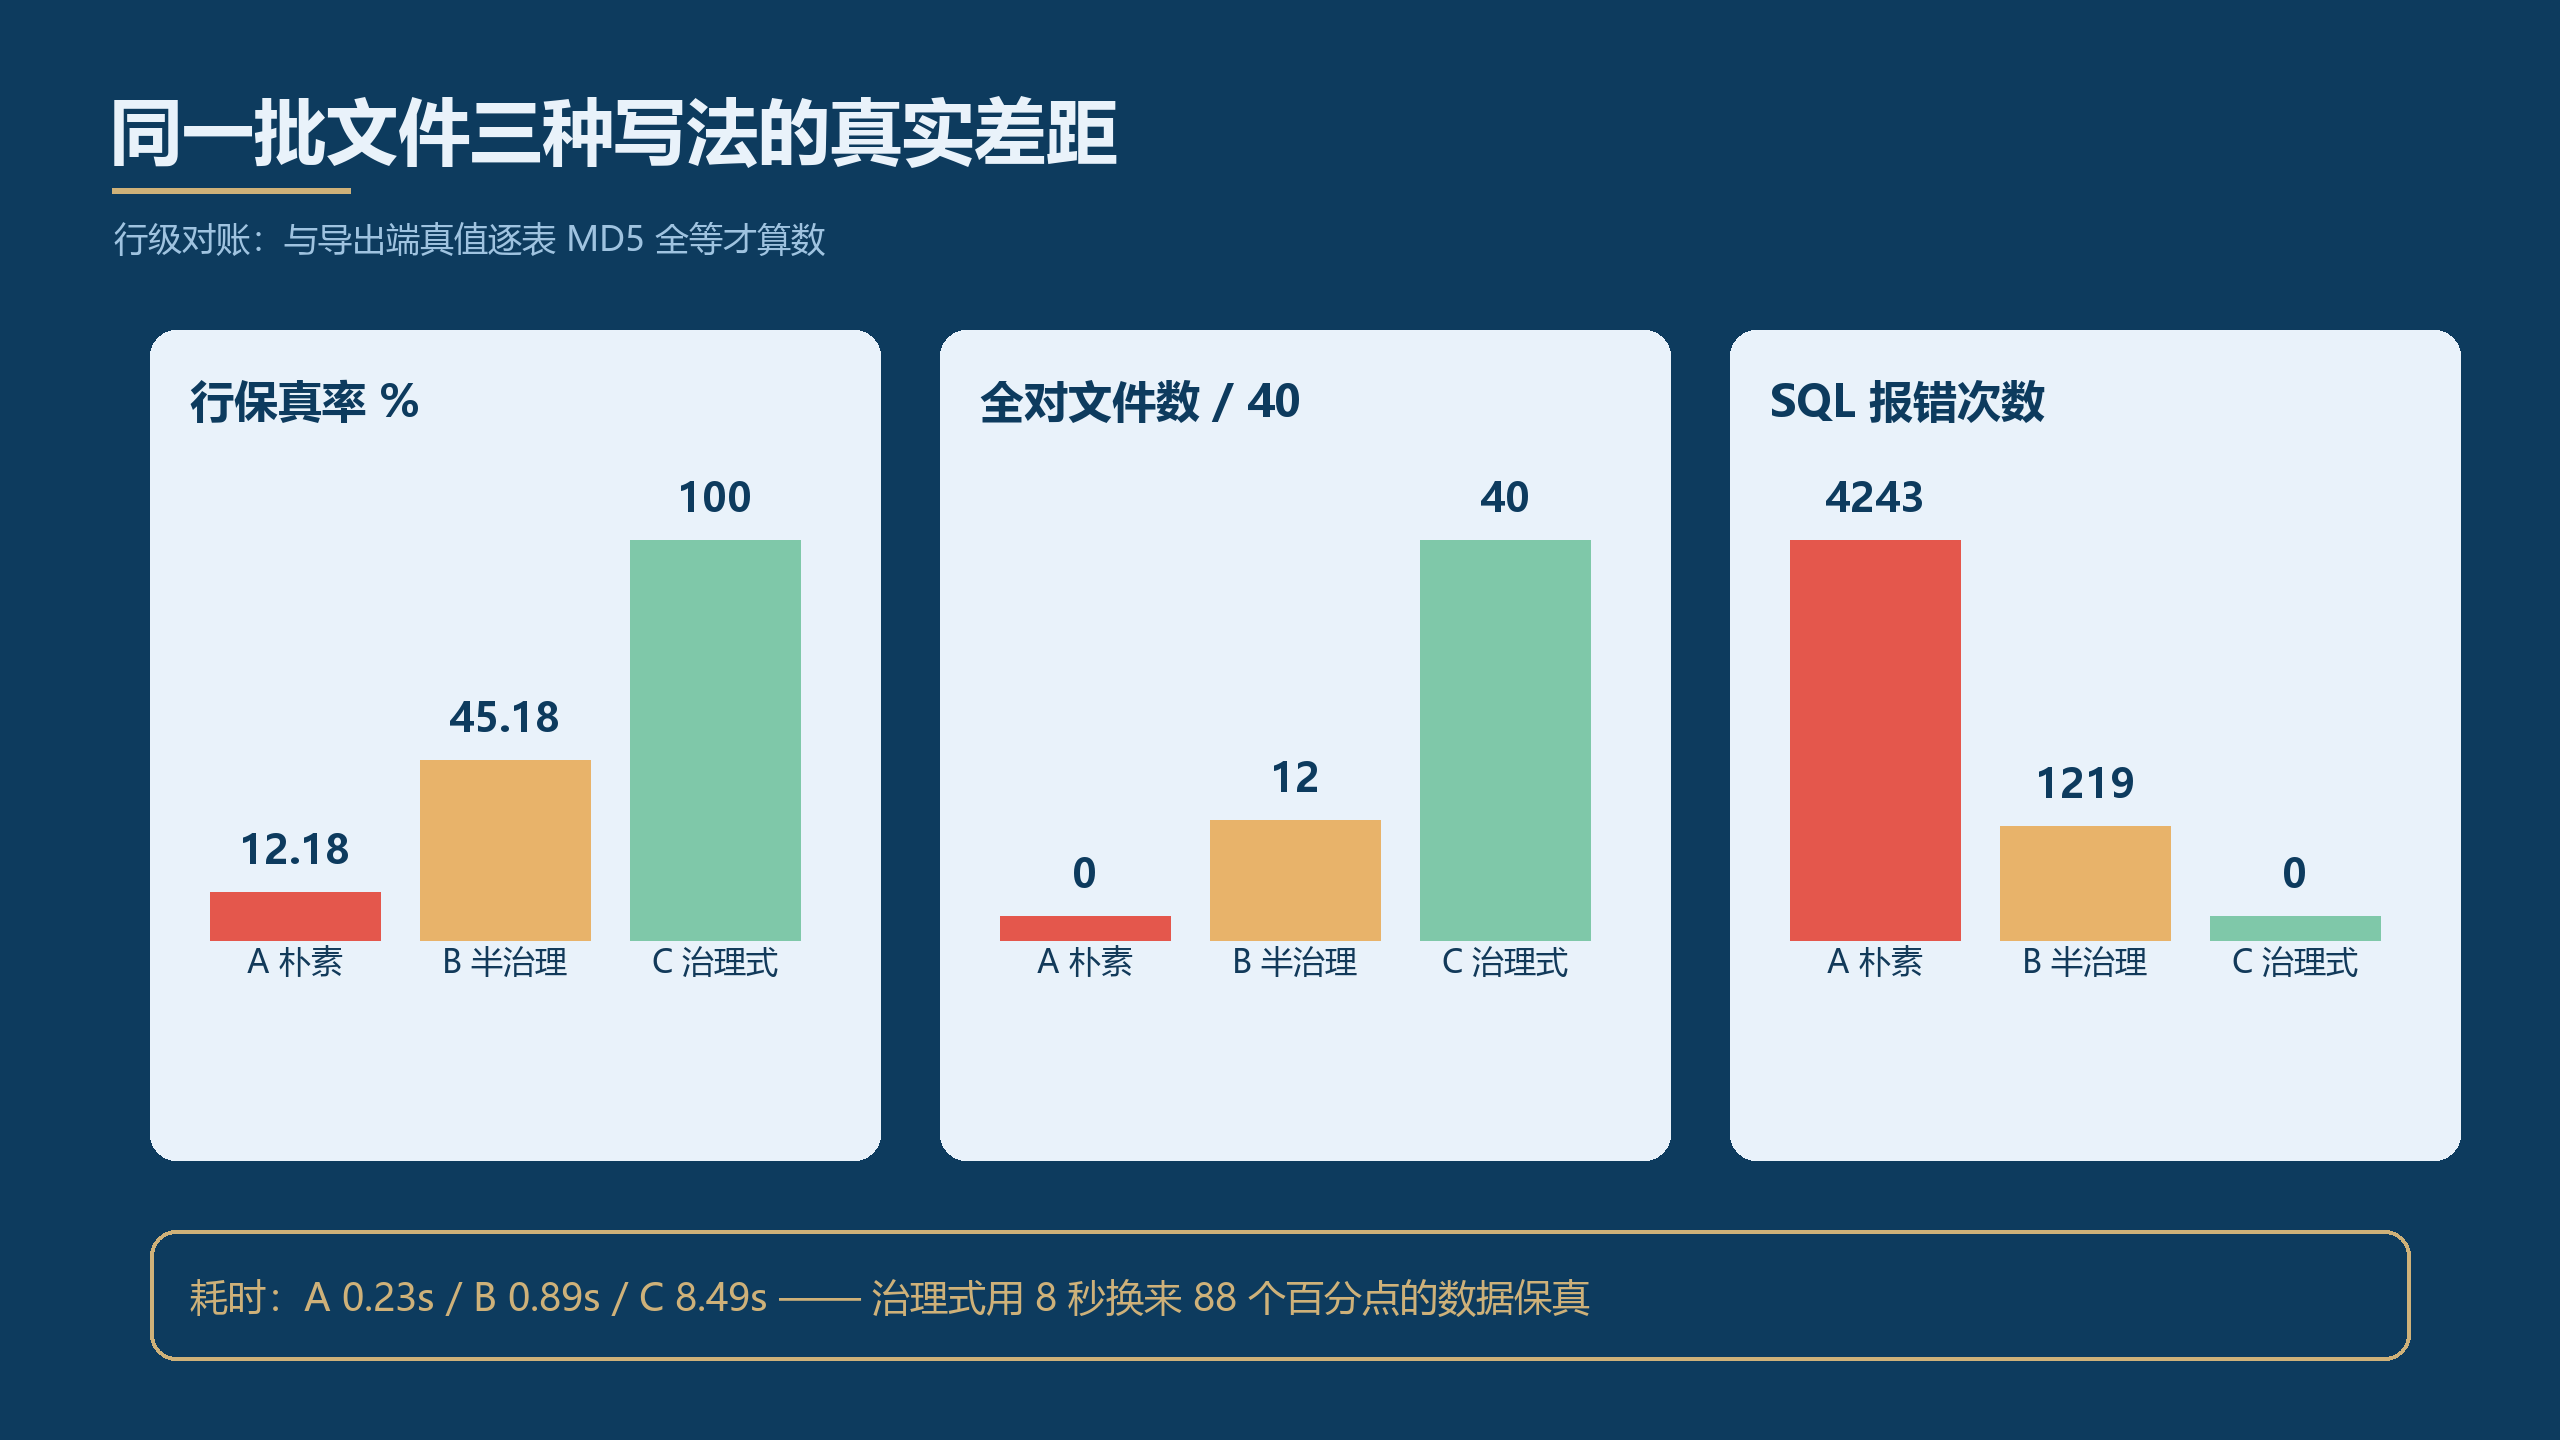
同一批文件三种写法的真实差距
三、真实数据对比
40 份合成导出文件、3.30 MiB、40,850 行真值(utf-8 23 份 / utf-8-sig 12 份 / gbk 5 份;含外键乱序 21 份、重复块 15 份、截断损坏 15 份),三档策略全部跑完:
指标 | A 朴素 split(';') | B 半治理(修编码+切分) | C 治理式(七道关口) |
|---|---|---|---|
全对文件数(逐表 MD5 全等) | 0 / 40 | 12 / 40 | 40 / 40 |
行保真率 | 12.18% | 45.18% | 100.00% |
丢失行数 | 35,875 | 22,395 | 0 |
冗余行数(重复导入) | 180 | 0 | 0 |
SQL 报错次数 | 4,243 | 1,219 | 0 |
坏语句处理 | 报错后数据丢失 | 静默跳过无记录 | 隔离 15 条,有台账 |
被吞语句打捞 | 无 | 无 | 打捞回 477 条 |
耗时 | 0.23s | 0.89s | 8.49s |
半治理版最危险:它修好了编码和切分,看起来「能跑」,但 1,219 条坏语句被 try/except 静默吞掉,22,395 行数据无声消失,没有任何日志——不跑对账根本不知道数据已经残了。
四、可复制代码(核心两件套)
第一件:引号/注释感知切分器。分号只在字符串和注释之外才算语句边界,并记录片段起始偏移供后续打捞:
def smart_split_ex(sql):
    """引号/注释感知切分:返回 [(语句, 干净结尾, 片段起始偏移)]"""
    out, buf, buf_start = [], [], 0
    i, n = 0, len(sql)
    in_s = in_line = in_block = False
    while i < n:
        c = sql[i]
        if in_line:
            buf.append(c)
            if c == "\n":
                in_line = False
            i += 1; continue
        if in_block:
            buf.append(c)
            if sql.startswith("*/", i):
                buf.append("/"); i += 2; in_block = False; continue
            i += 1; continue
        if in_s:
            buf.append(c)
            if c == "'" and sql[i + 1:i + 2] == "'":
                buf.append("'"); i += 2; continue   # 转义引号
            if c == "'":
                in_s = False
            i += 1; continue
        if sql.startswith("--", i):
            in_line = True
        elif sql.startswith("/*", i):
            in_block = True
        elif c == "'":
            in_s = True
        elif c == ";":
            out.append(("".join(buf).strip(), not in_s, buf_start))
            buf, buf_start = [], i + 1
            i += 1; continue
        if not buf:
            buf_start = i
        buf.append(c); i += 1
    tail = "".join(buf).strip()
    if tail:
        out.append((tail, not in_s, buf_start))
    return out
第二件:逐元组字段数校验。这是拦截「拼接复合语句」的关键——损坏区重同步时,两条语句拼成一条仍能通过引号/括号配对检查,只有逐元组核对字段数才能识破:
def parse_insert(stmt):
    m = re.match(r'INSERT INTO (\w+)\s*\(([^)]*)\)\s*VALUES', stmt, re.I)
    if not m:
        return None
    rest = stmt[m.end():].strip()
    tuples, fields, in_s, depth, started = [], 0, False, 0, False
    i = 0
    while i < len(rest):
        c = rest[i]
        if in_s:
            if c == "'":
                if rest[i:i+2] == "''":
                    i += 2; continue
                in_s = False
            i += 1; continue
        if c == "'":
            if depth == 1:
                started = True
            in_s = True
        elif c == '(':
            depth += 1
            if depth == 1:
                fields, started = 0, False
        elif c == ')':
            depth -= 1
            if depth == 0:
                tuples.append(fields + 1 if started else fields)
        elif depth == 1 and c == ',':
            fields += 1; started = False
        elif depth == 0 and c not in ' \n\r\t,':
            return None
        i += 1
    if in_s or depth != 0 or not tuples:
        return None
    ncols = len(m.group(2).split(','))
    ok = (m.group(1) in SCHEMA_COLS and ncols == SCHEMA_COLS[m.group(1)]
          and all(t == ncols for t in tuples))
    return (m.group(1), tuples, ncols) if ok else None
完整流水线在此基础上再加五步:解码探测(BOM → utf-8 → gbk)、语句级 MD5 去重、按 dept → staff/device → ticket 拓扑排序、500 句一组批量事务、导完逐表 MD5 对账。损坏点之后的残骸用「重同步打捞」处理:从每个 INSERT INTO 头部锚点尝试提取完整语句,本次共打捞回 477 条本会被吞掉的语句。
五、踩坑清单(每一坑都让首版结果失真)
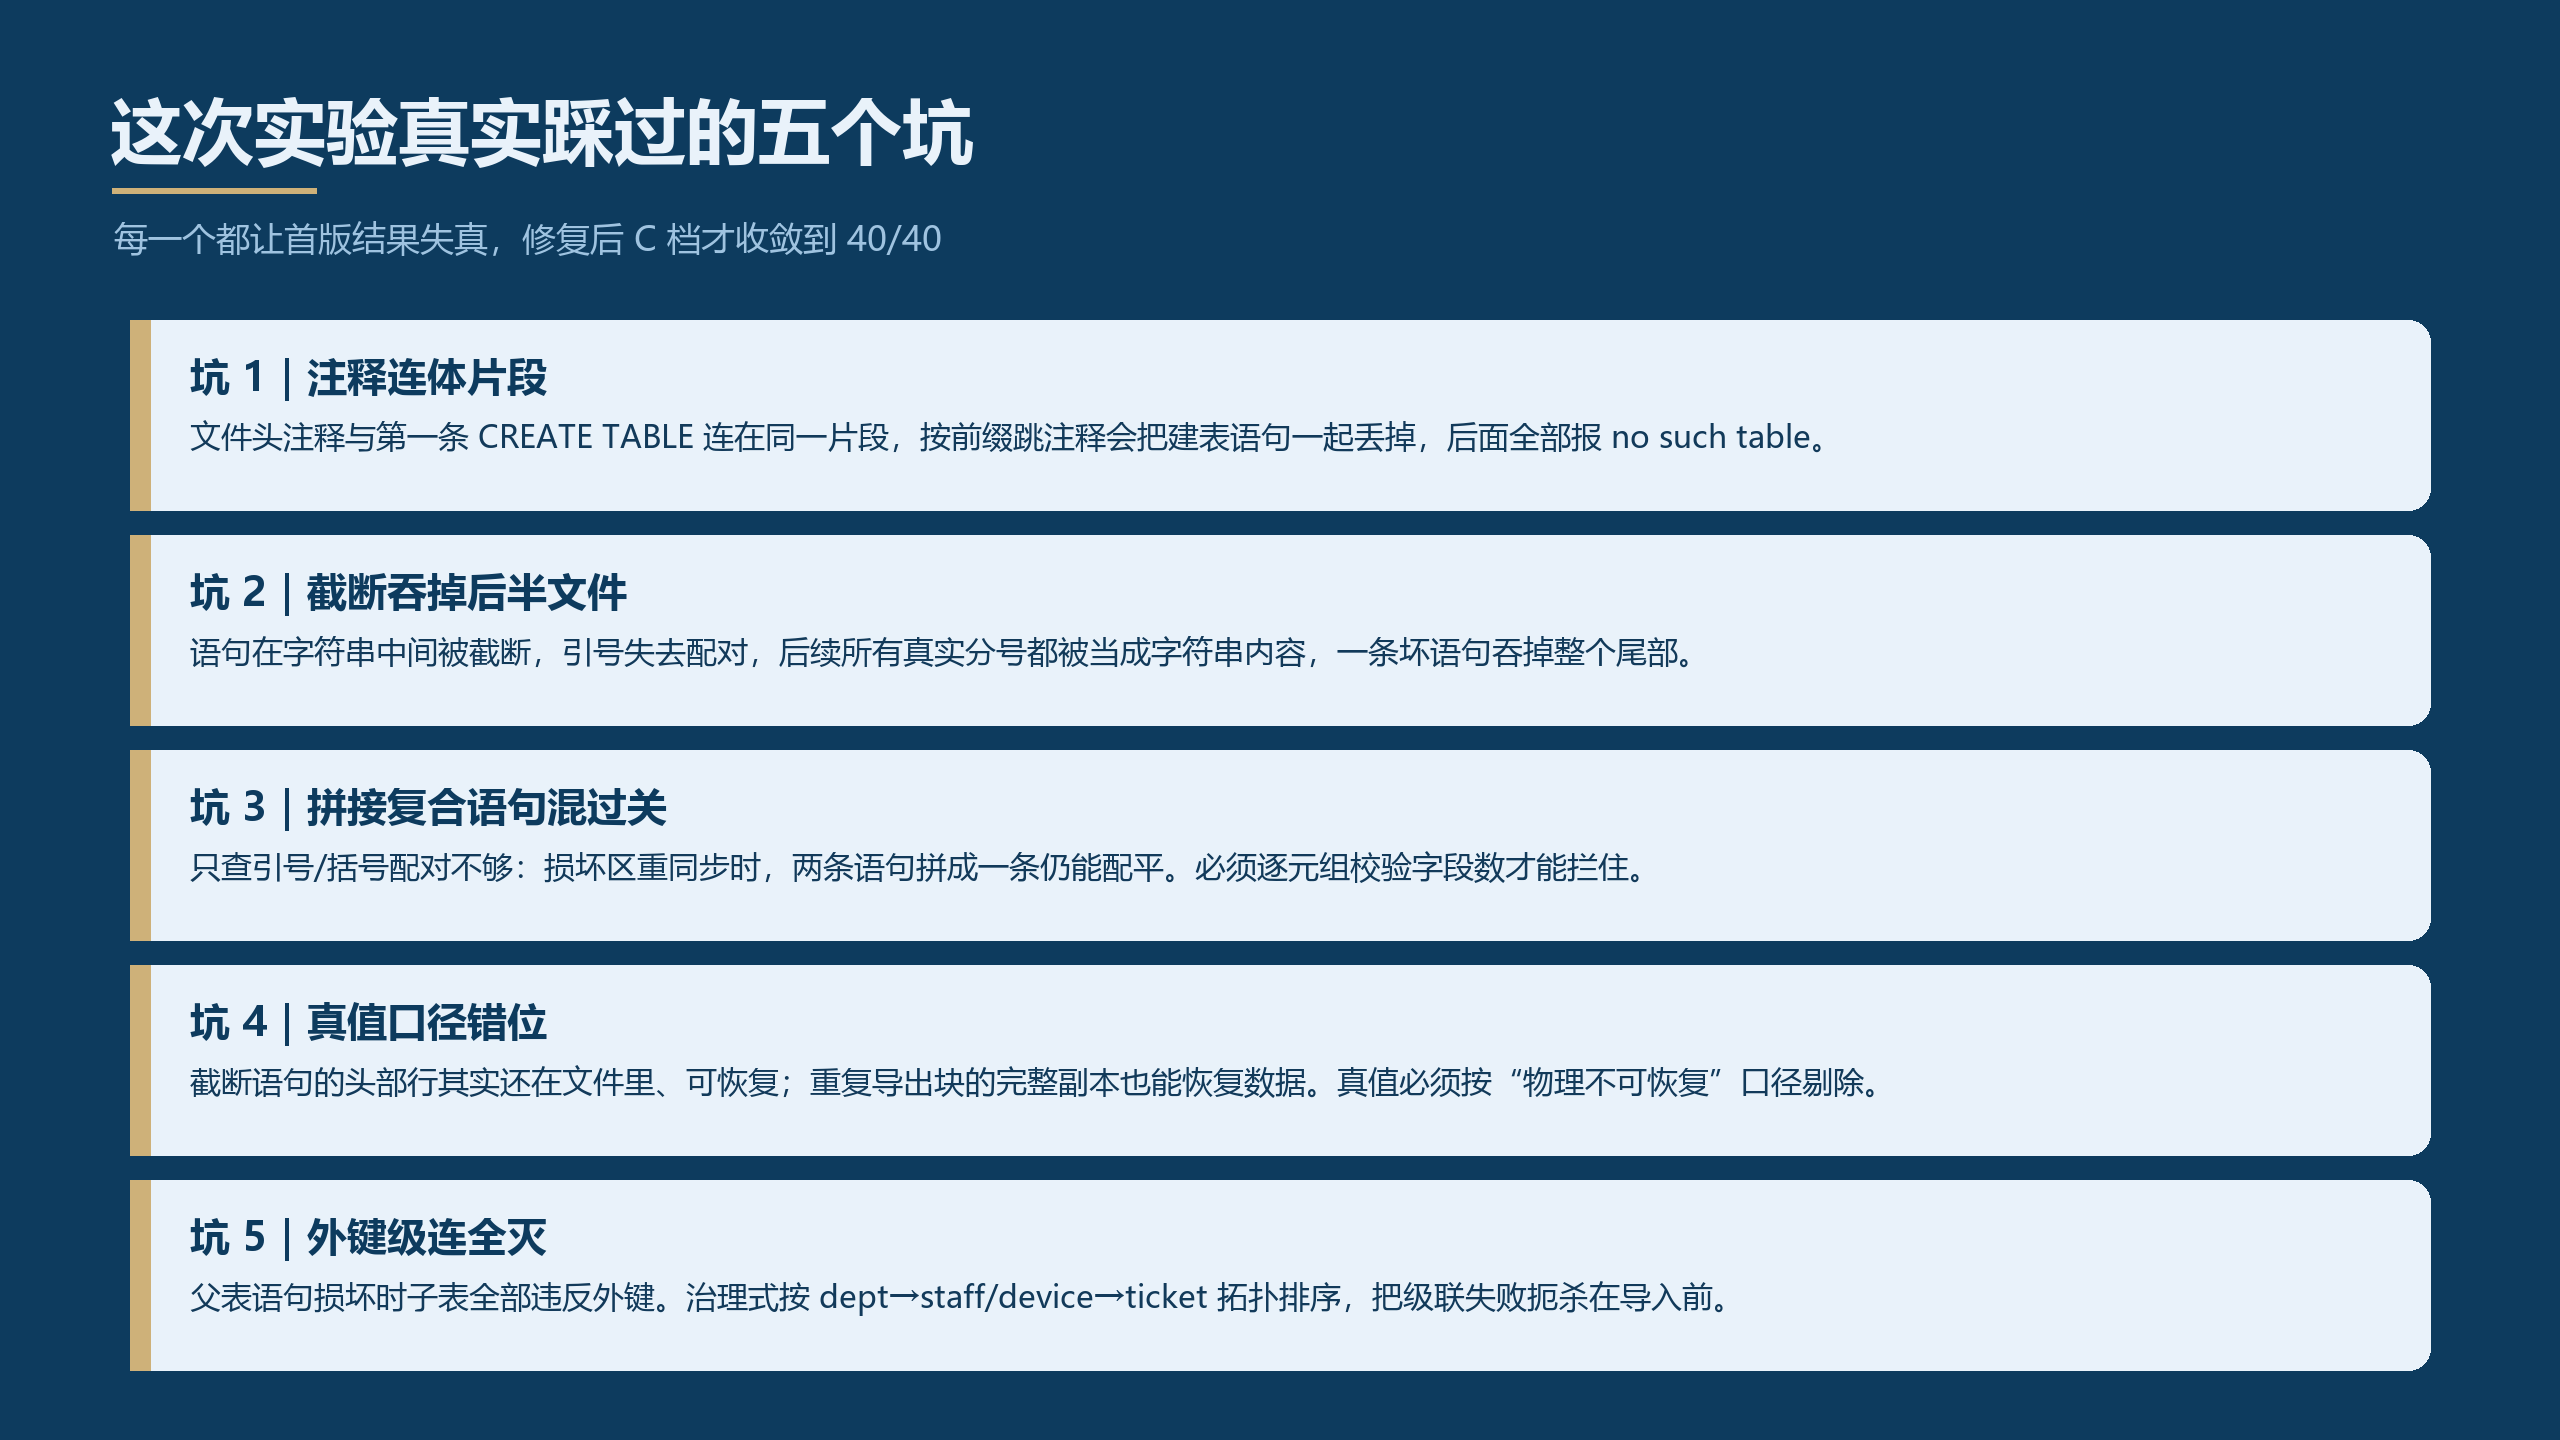
这次实验真实踩过的五个坑
- 坑 1|注释连体片段:文件头注释与第一条 CREATE TABLE 黏在同一片段,按「片段以 -- 开头就跳过」会把建表语句一起丢掉,后面全部报 no such table。跳过判据必须是「片段内所有行都是注释」。
- 坑 2|截断吞掉后半文件:截断点在字符串内时引号失配,切分器把整段尾部当字符串。解法是文件级重同步:从损坏点起在每个 INSERT 头部锚点重新提取完整语句,而不是片段内打捞。
- 坑 3|拼接复合语句混过关:只查配对不够,两条语句拼成一条引号括号都可能配平。逐元组字段数校验是最后一道闸,本次靠它拦下全部复合残骸。
- 坑 4|真值口径错位:截断语句的头部行还在文件里、可恢复;重复导出块的完整副本也能恢复数据。对账真值必须按「物理不可恢复」口径剔除,否则治理版会被冤枉出冗余行。
- 坑 5|外键级联全灭:父表语句损坏时子表全部违反外键。治理式按依赖拓扑排序,把级联失败扼杀在导入前;同时首条父表语句务必随片段一起执行,别被注释连体坑掉。
六、给 WorkBuddy 的提示词模板
帮我把目录下全部 .sql 导出文件导入 SQLite 并保证行数可对账。要求:① 逐文件做 BOM/utf-8/gbk 解码探测,禁止 errors=replace;② 引号与注释感知切分语句,记录片段偏移;③ 每条 INSERT 做「表名在 schema、列数一致、逐元组字段数一致」三重校验,不合格写入隔离清单而不是静默跳过;④ 语句级 MD5 去重后再导入;⑤ 按「父表先于子表」拓扑排序;⑥ 500 句一组批量事务,失败降级逐句执行并计数;⑦ 导完逐表与真值清单做 MD5 对账,输出丢失/冗余/损坏三类明细和总耗时。跑完先给我对账报告,确认无误再落盘。
七、收尾
0.23 秒的朴素导入换来的是 12.18% 的数据保真和 4,243 条报错;8.49 秒的治理式流水线换来的是 40/40 全对账。导入前多花 8 秒做治理,换来的是「行数对得上、内容对得上、坏了有台账」——数据库迁移这件事,快的方案和对的方案从来不是同一个。完整实验脚本与对账报告已随文附图,可直接复用到你自己的导出文件上。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号