#WorkBuddy# 10 万个时序点缺了 7.27%:零值填充 MAE 84.9,季节画像加边缘漂移压到 1.2
原创
#WorkBuddy# 10 万个时序点缺了 7.27%:零值填充 MAE 84.9,季节画像加边缘漂移压到 1.2
原创
用户12784192
发布于 2026-11-12 10:33:33
发布于 2026-11-12 10:33:33
#WorkBuddy# 10 万个时序点缺了 7.27%:零值填充 MAE 84.9,季节画像加边缘漂移压到 1.2
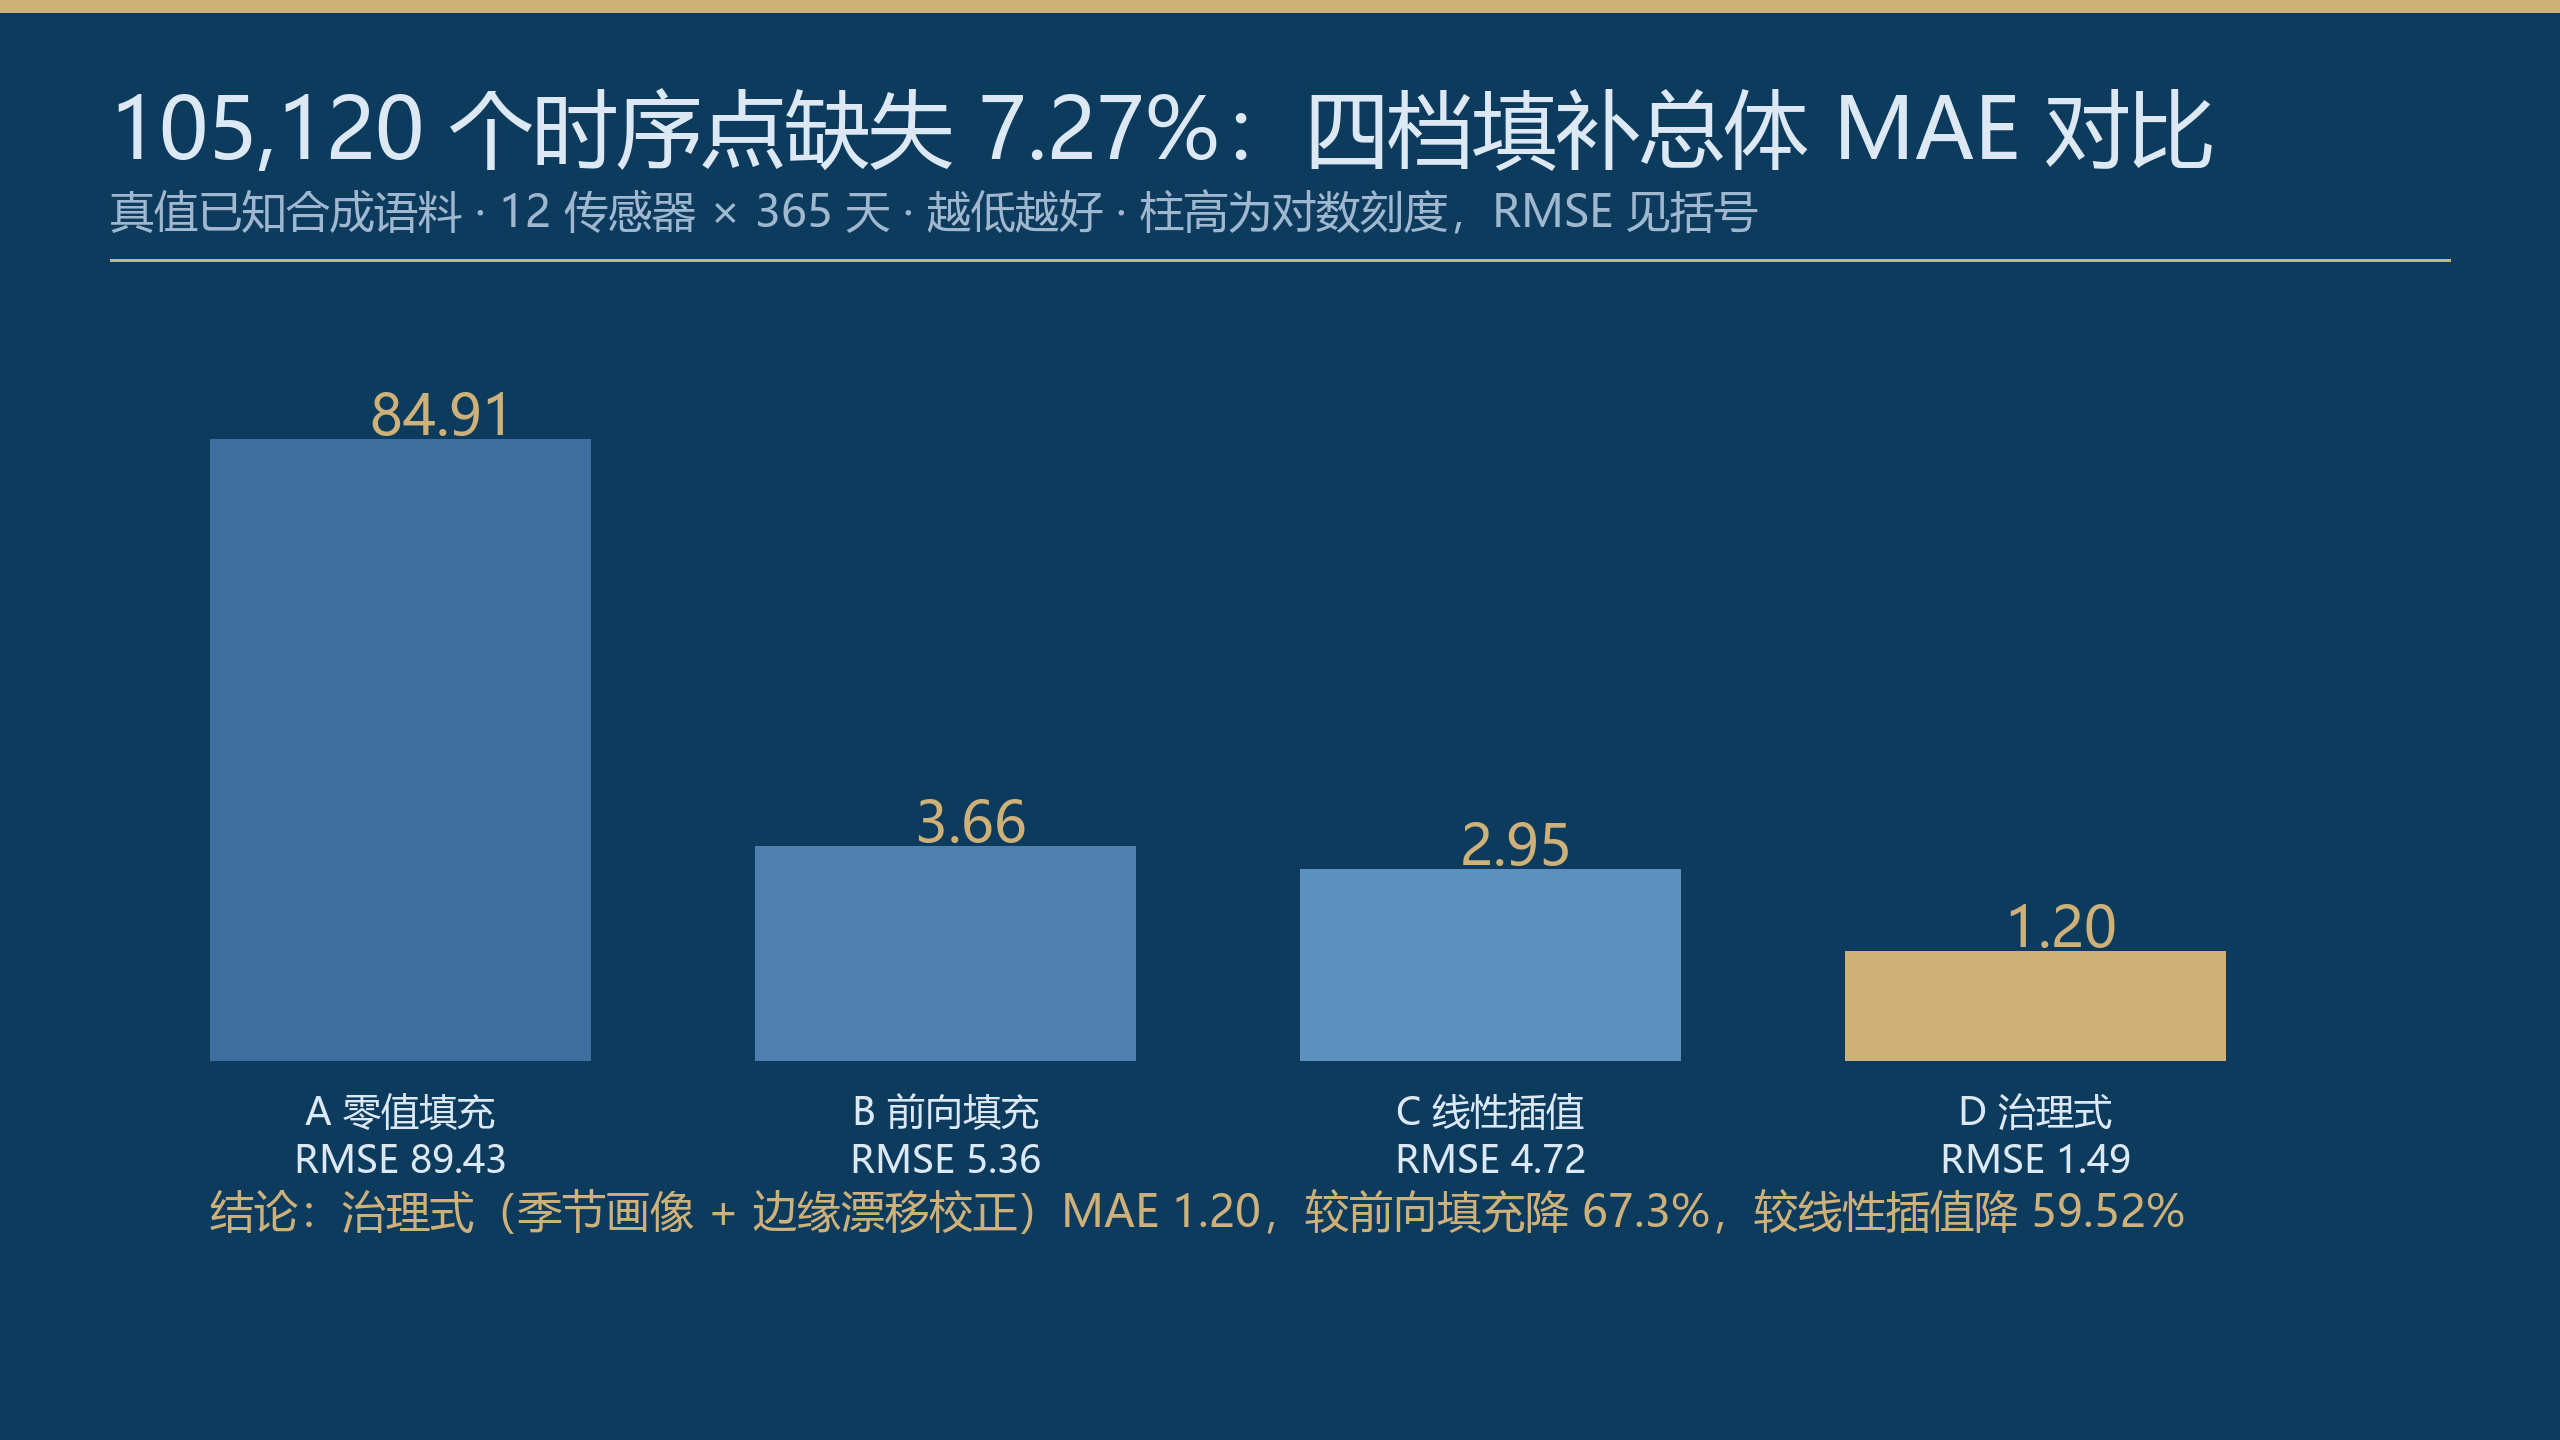
四档填补总体 MAE 对比
一、痛点:填补缺口的三种"默认动作"都不对
做数据归档和报表自动化时,时序数据缺段是常态:设备断电、网络抖动、采集进程重启,落到文件里就是一串空洞。多数人的第一反应是三种"默认动作"——缺了补零、缺了抄上一个值(前向填充)、或者干脆 interpolate() 线性插值拉一条直线过去。这三种做法在短缺口下看不出问题,一旦碰到整日停测这种长断点,补出来的曲线要么贴地、要么僵尸值、要么一条直线横穿本该起伏的日周期。
问题在于这三种做法都没有利用时序数据最重要的结构:周期性。本文用一份真值已知的合成语料(12 个传感器 × 365 天 × 24 小时 = 105,120 个点,注入 7,647 个缺失点,缺失率 7.27%,包含散点缺失 5,233 点、块状缺口 96 段共 1,584 点、整日停测 24 段共 864 点),把四种填补策略放在同一把尺子下量——因为真值已知,MAE 和 RMSE 都是硬数字,不是感觉。
二、根因分析:为什么直线插值扛不住长缺口
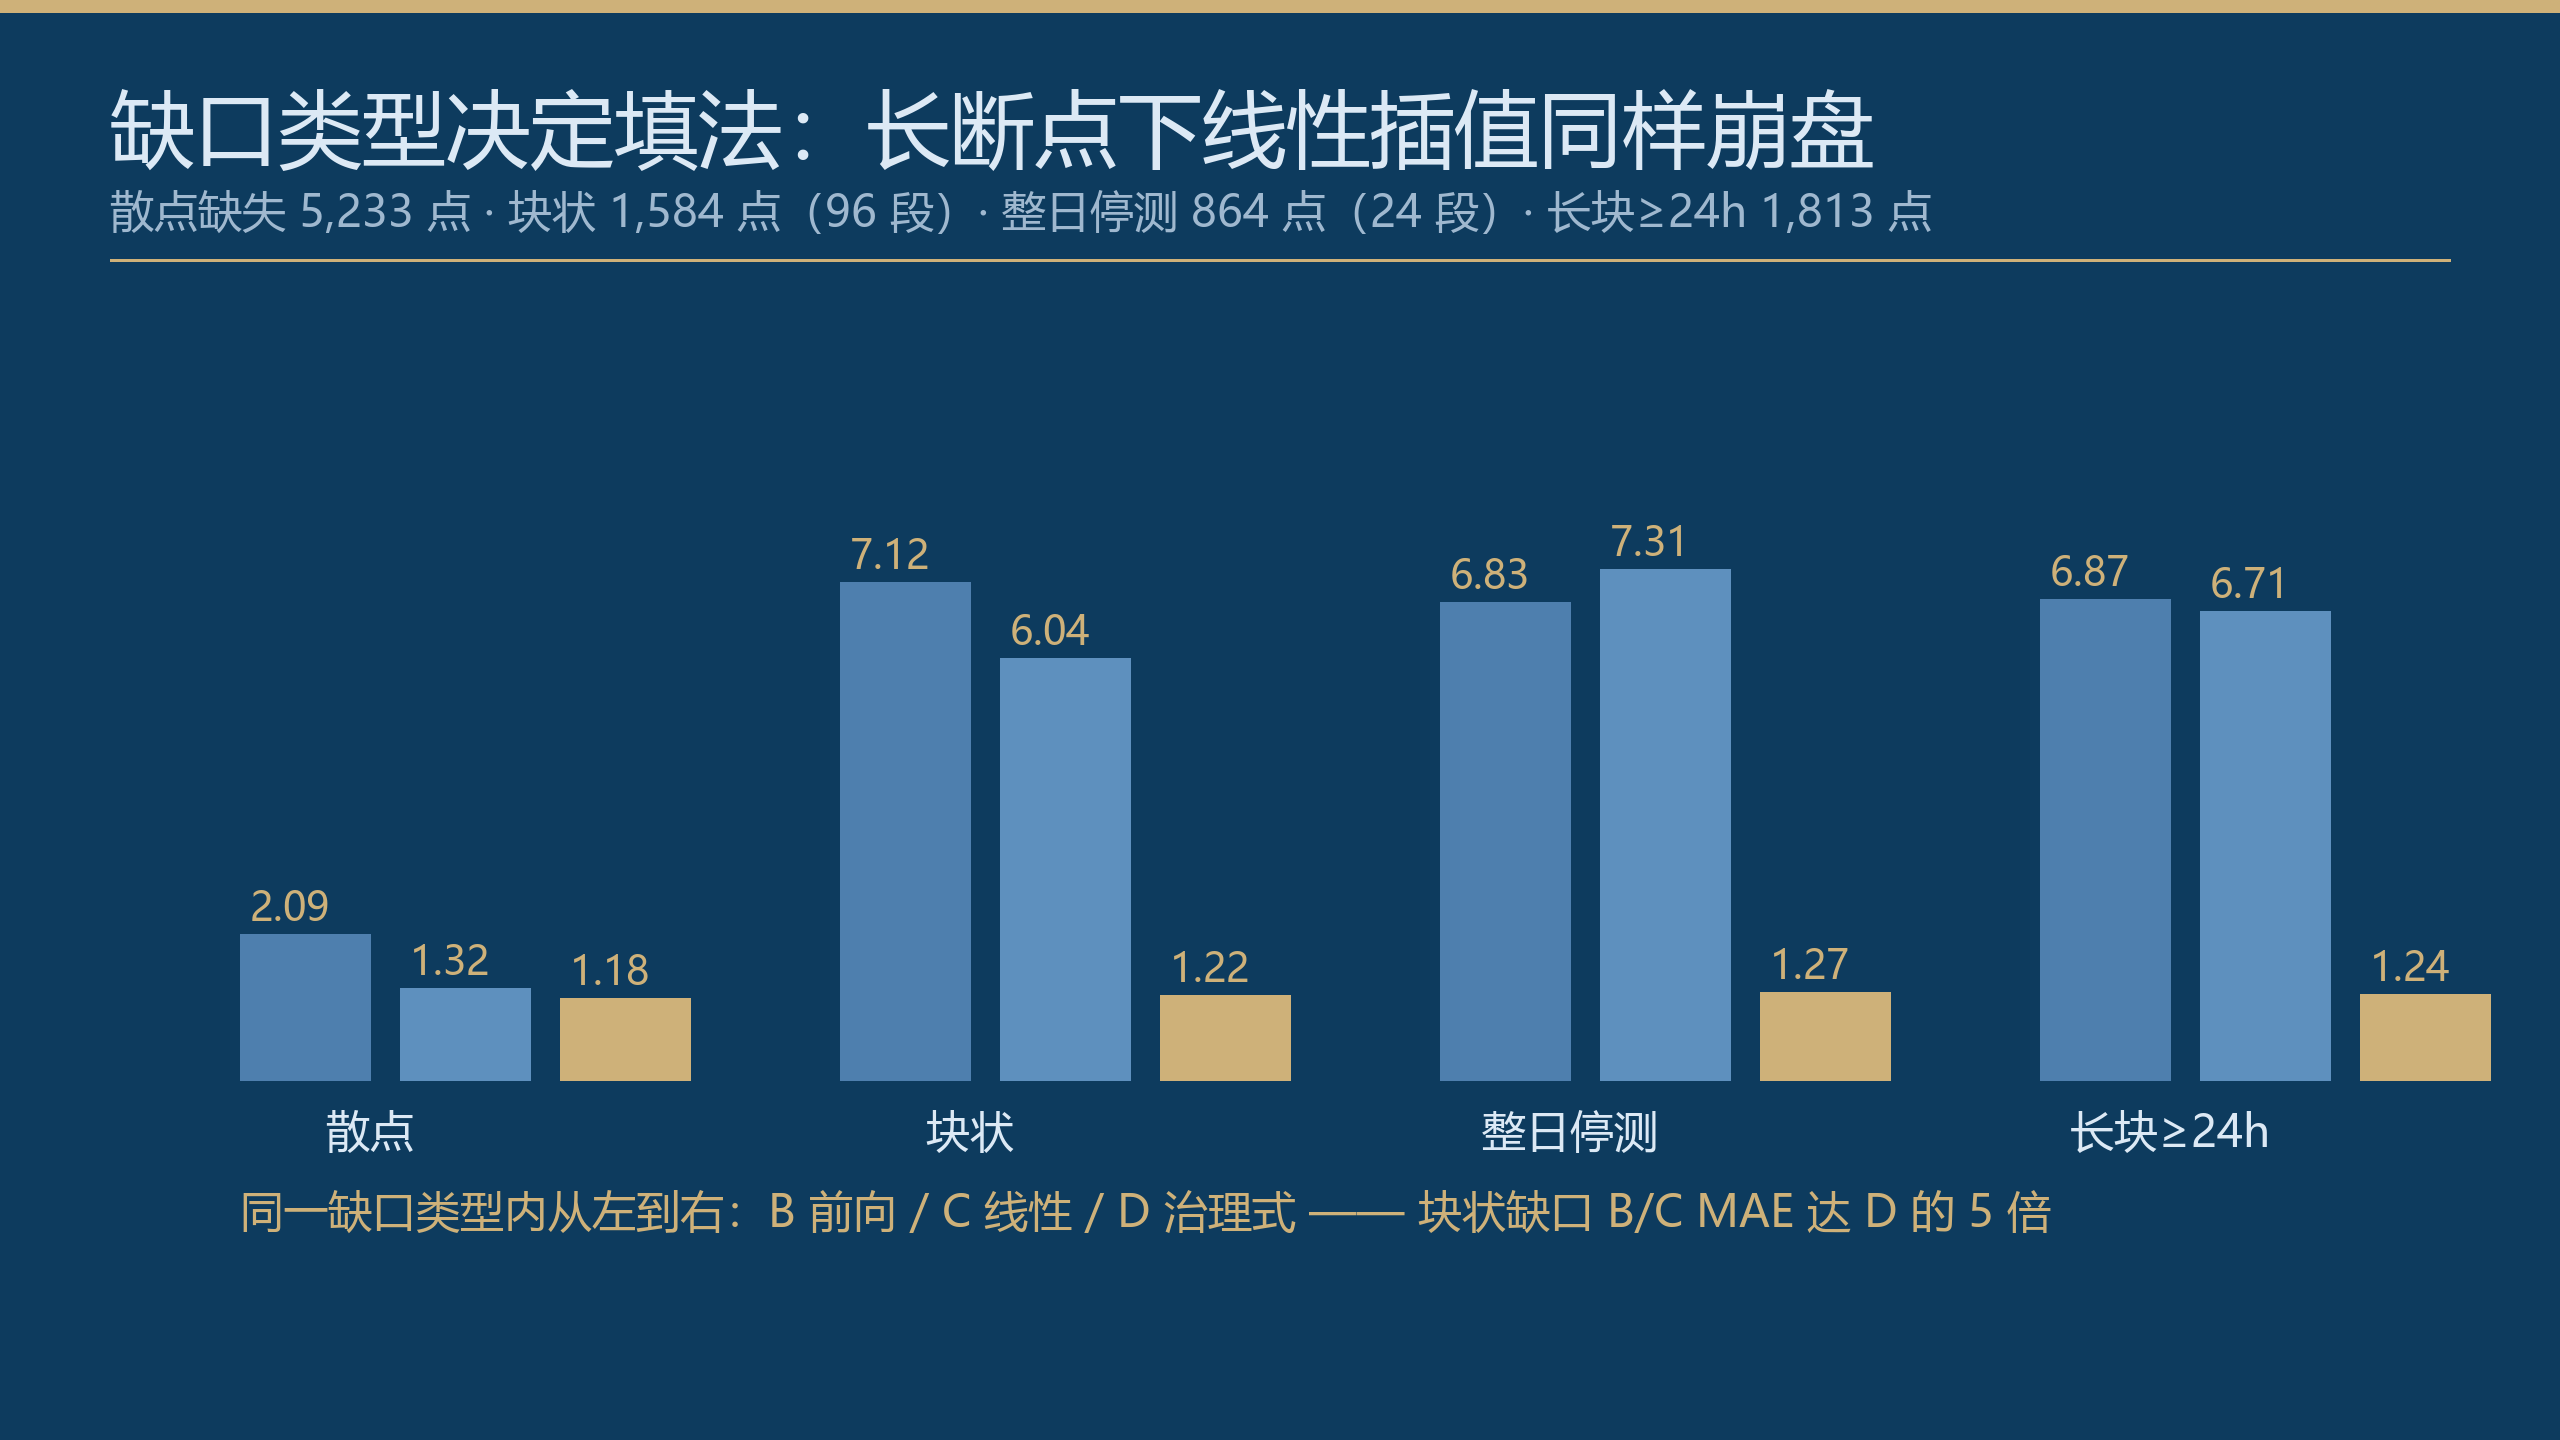
缺口类型决定填法
线性插值的数学假设是"相邻两点间变化近似线性"。对 1~2 小时的短缺口,这个假设成立;但对 24 小时以上的缺口,插值线要从缺口左端的午后峰值直接拉到右端的清晨低谷——中间本该有完整的一轮日周期起伏,全被一条直线抹平。实测数据印证了这一点:
缺口类型 | 缺失点数 | B 前向填充 MAE | C 线性插值 MAE | D 治理式 MAE |
|---|---|---|---|---|
散点缺失 | 5,233 | 2.09 | 1.32 | 1.18 |
块状缺口(6~36h) | 1,584 | 7.12 | 6.04 | 1.22 |
整日停测 | 864 | 6.83 | 7.31 | 1.27 |
长块 ≥24h | 1,813 | 6.87 | 6.71 | 1.24 |
规律非常清晰:缺口越短,B/C 与 D 的差距越小;缺口越长,直线类方法崩得越惨。散点缺口下线性插值 MAE 1.32 尚可接受,长块缺口下它和前向填充一样停在 6.7~6.9,而治理式方法仍然稳在 1.24——差距 5 倍以上。
治理式方法的核心是两步:先用全量历史算出每个「星期几 × 小时」的平均画像(即"周二下午 3 点通常是多少"),再对每个缺口做边缘漂移校正——用缺口两端的观测残差做线性过渡,把"这个传感器这几天整体偏高/偏低"的偏置补回去。长缺口(>48h)时边缘信息衰减,残差按比例淡出到零,只保留画像基线。
三、可复制代码:三档实现,60 行以内
import numpy as np
import pandas as pd

# X: (n_sensors, n_steps) 观测矩阵,缺失处为 NaN;dow/hour: 星期几/小时数组
# --- C 线性插值(注意 pandas 3.0 必须显式 limit_direction)---
C = pd.DataFrame(X.T).interpolate(method="linear",
                                  limit_direction="both").values.T

# --- D 治理式:季节画像 + 边缘漂移校正 ---
D = X.copy()
for s in range(X.shape[0]):
    y = X[s]
    prof = np.zeros((7, 24))
    for d in range(7):
        for h in range(24):
            sel = (dow == d) & (hour == h)
            prof[d, h] = np.nanmean(y[sel])        # 画像只用观测值
    resid = y - prof[dow, hour]                    # 全序列残差
    miss = np.isnan(y)
    mi = np.where(miss)[0]
    for seg in np.split(mi, np.where(np.diff(mi) > 1)[0] + 1):
        a, b = seg[0], seg[-1]
        L = b - a + 1
        left  = resid[a - 1] if a > 0 else 0.0
        right = resid[b + 1] if b + 1 < len(y) else left
        if a == 0 and b + 1 >= len(y):
            fill_r = np.zeros(L)                   # 两端皆无观测
        elif a == 0:
            fill_r = np.full(L, right)
        elif b + 1 >= len(y):
            fill_r = np.full(L, left)
        elif L <= 48:
            fill_r = np.linspace(left, right, L + 2)[1:-1]
        else:                                      # 长缺口残差淡出
            fade = min(1.0, 48.0 / L)
            fill_r = np.linspace(left, right, L + 2)[1:-1] * fade
        D[s, a:b + 1] = prof[dow[a:b + 1], hour[a:b + 1]] + fill_r
这套逻辑在 105,120 点规模上单次填补耗时 0.175 秒(纯 numpy 双层画像循环,未做向量化优化),完全够日常归档流水线使用。
四、踩坑清单(全部实测复现)
pandas 3.0 移除了
fillna(method="ffill")。实测在 pandas 3.0.6 上直接抛TypeError: NDFrame.fillna() got an unexpected keyword argument 'method'。迁移写法:df.ffill()/df.bfill()。 pandas 3.0 不再认大写freq="H",pd.date_range(freq="H")抛ValueError: Invalid frequency: H。必须写小写freq="h"。老脚本升级 pandas 时这两处会集中爆雷。interpolate()默认只向前向后"缝内"填补:序列头部的 NaN 不会被处理,实测 5 点示例残留 1 个 NaN。必须加limit_direction="both"(配合bfill兜底更稳),否则头部缺口静默漏填,下游统计悄悄失真。 画像窗口不能贪短。第一版实验只用最后 8 天算画像,结果"画像+漂移"法的 MAE 与"同期朴素"(上周同刻原值)完全相同——8 天窗口里每个「星期几×小时」只有一个样本,画像退化成了上周快照。改用全量历史(8,736 个观测点/传感器)后才拉开差距。教训:画像的最小样本量取决于周期结构的信噪比,宁可多喂历史。 缺口分段要用np.diff > 1切连续段,不能逐点循环——散点缺失 5,233 点逐点处理是 O(N) 次画像查询,切段后只循环 96+24 段,速度差一个数量级。 评估时整日停测要单独分型。把整日缺口混进"块状"里统计,线性插值的表现会被均值掩盖(它对整日缺口 MAE 7.31,比前向填充 6.83 还差——两端同为同相位的周期点,直线恰好横穿谷底)。
五、给 WorkBuddy 的提示词模板
把下面这段直接发给 WorkBuddy,可复用本文全部能力:
对目录 <路径> 下所有时序类数据文件做缺口治理:① 逐文件检测缺失率与缺口分型(散点/块状/整日),输出缺口清单;② 用「星期几×小时」季节画像加边缘漂移校正填补,长缺口(>48h)残差淡出;③ 填补前后各出一份统计(均值/方差/分位数)确认分布未漂移;④ 填补值打
imputed=true标记写入新列,原始值永不覆盖;⑤ 全部数字写进校验报告,禁止编造。
关键约束是第 ④ 条:填补值必须可追溯,审计时能区分"测到的"和"补出来的"。
六、顺带把 24h 预测也解决了
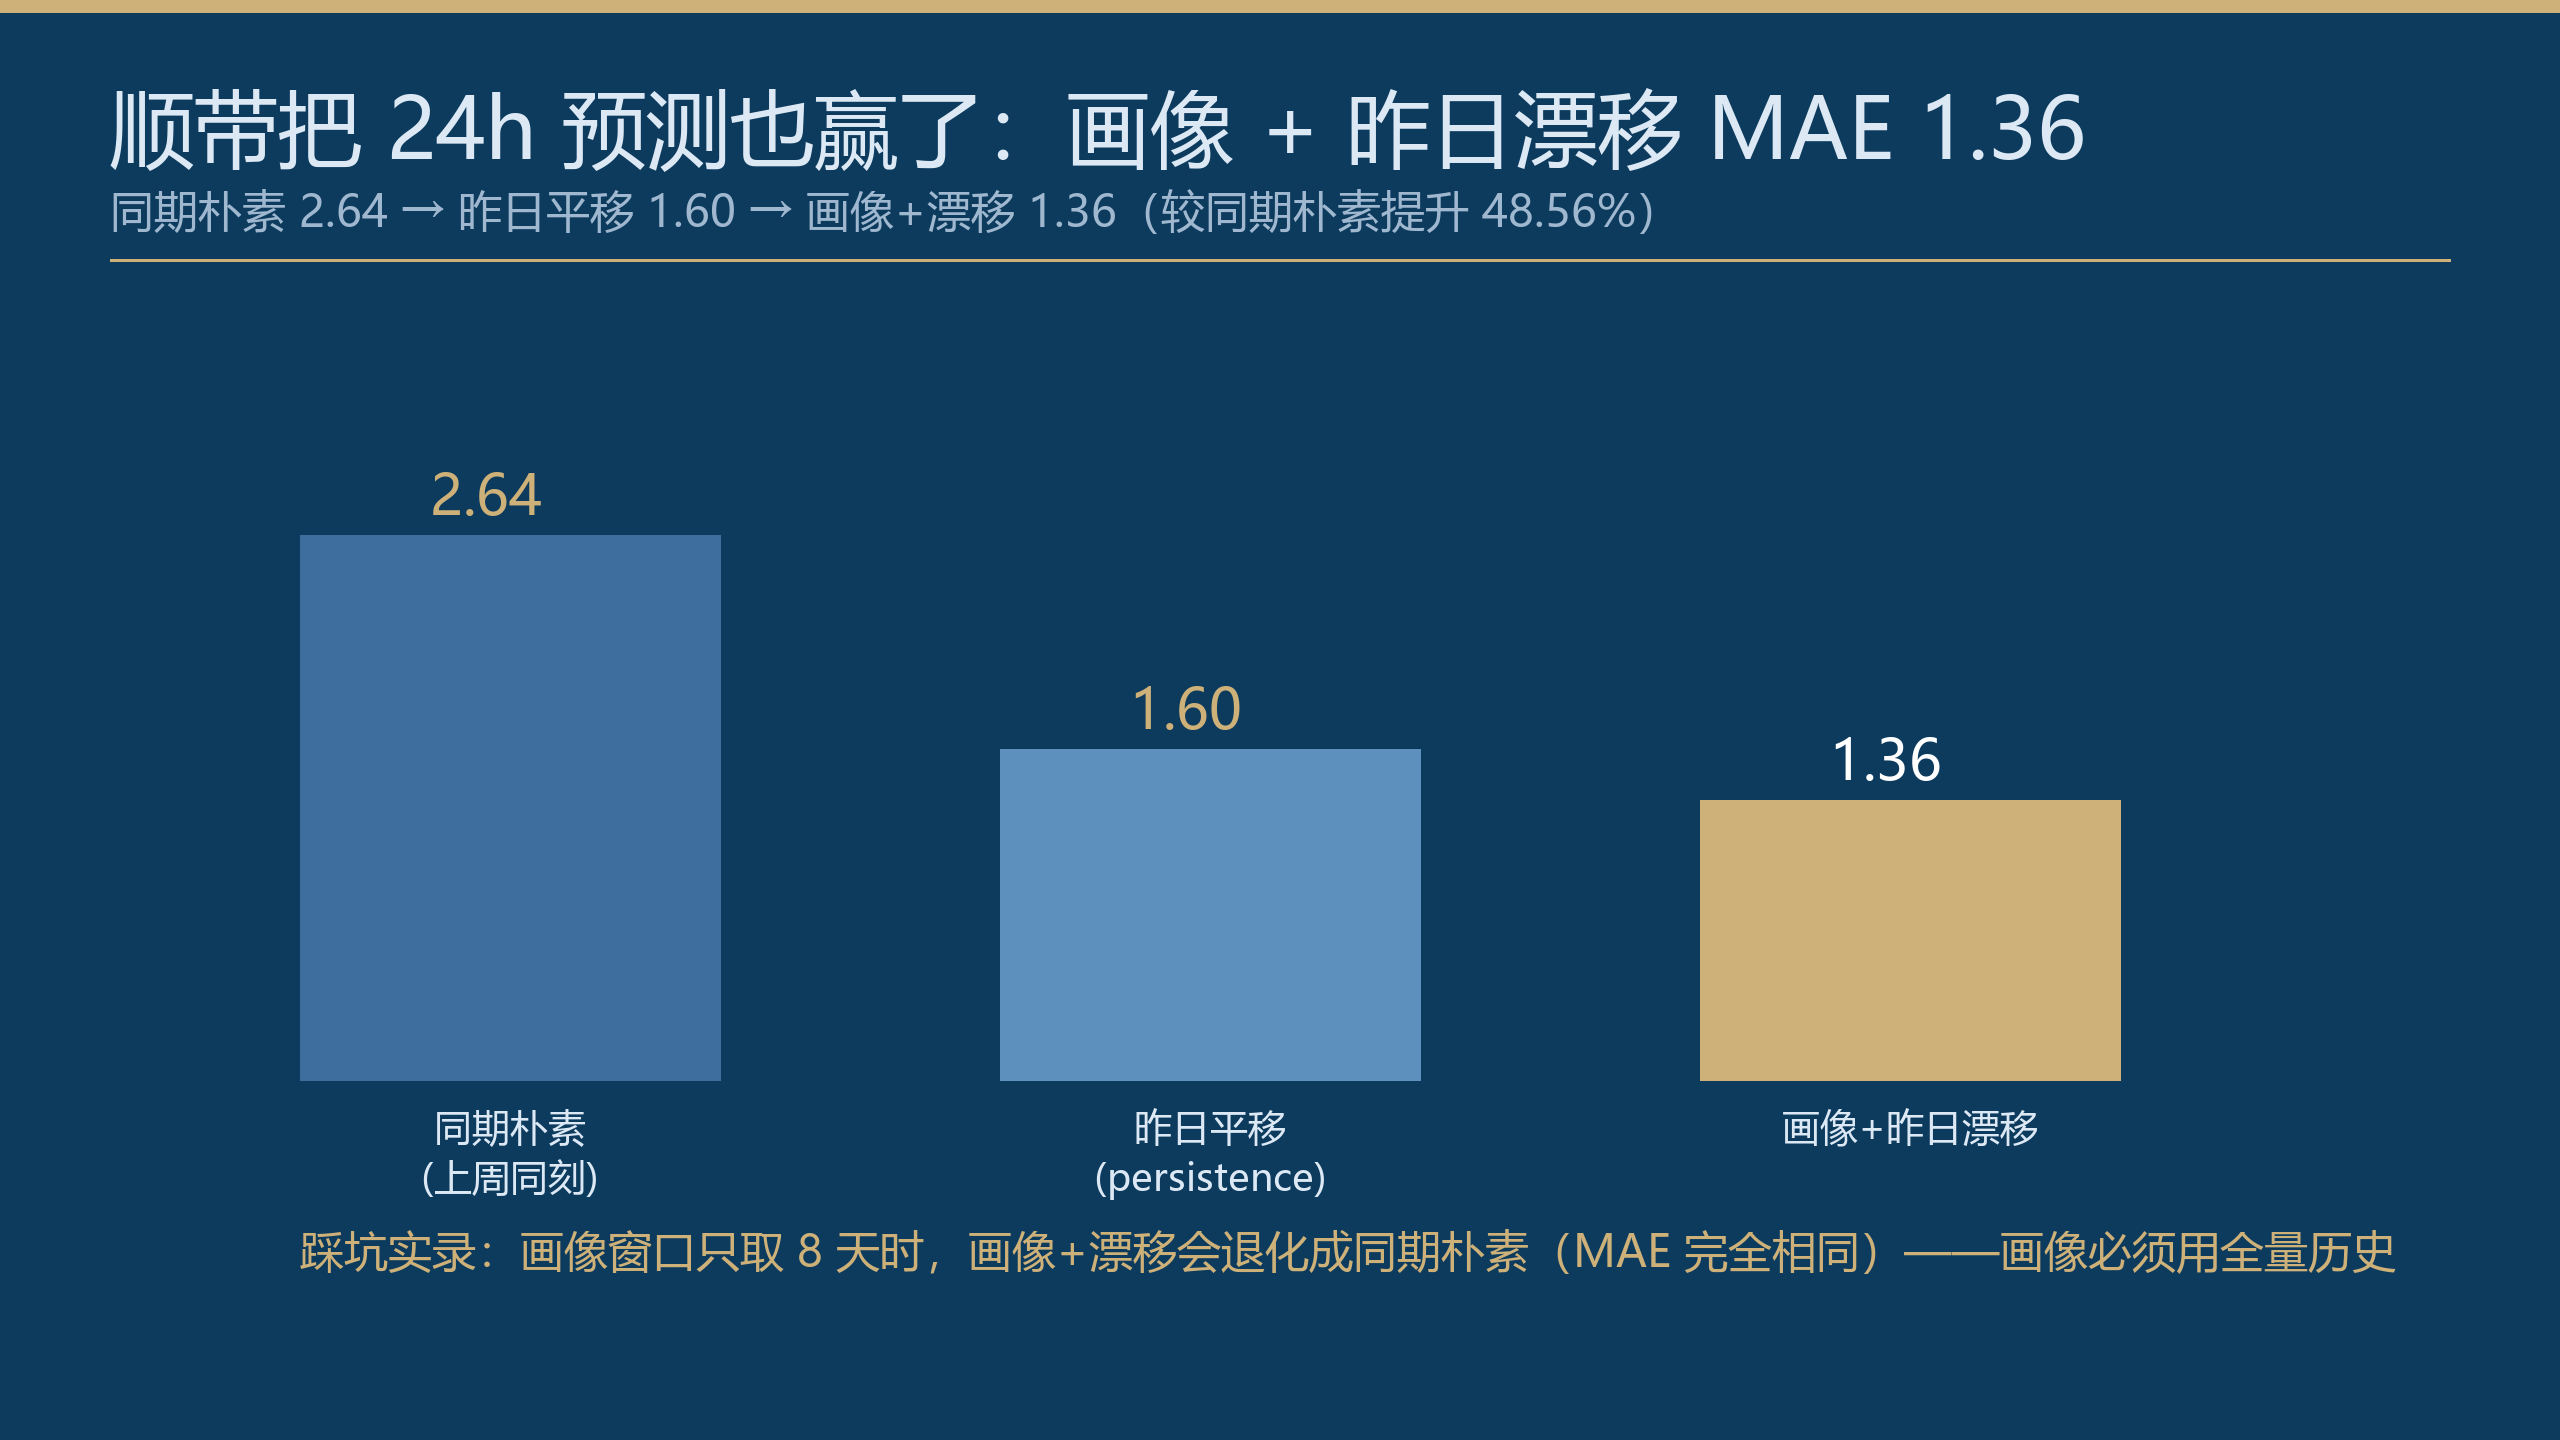
24h 预测三法对比
同一套画像结构稍加改造就能做短期预测:用全量历史算画像,叠加"昨日残差均值"作为漂移项。实测预测次日 24 小时:同期朴素 MAE 2.64、昨日平移(persistence)1.60、画像+昨日漂移 1.36——比同期朴素提升 48.56%。也就是说,填补和预测共享同一套周期画像代码,一次实现两处受益。
收尾
时序补全这件事,难点从来不是算法复杂度,而是"别用错默认动作"。三种默认动作(补零/前向/直线)在短缺口下都过得去,恰恰让人放松警惕,直到长断点出现才暴雷。治理式方案只多了两个概念——季节画像和边缘漂移——代码不到 60 行,长块缺口 MAE 从 6.71 压到 1.24,降幅 81.5%。如果你的归档流水线里还有 interpolate() 裸奔,值得花十分钟换成画像方案。
(本文语料为按固定种子合成的仿真数据,用于让填补误差可对真值硬核评估;方法与结论可直接迁移到真实传感器/业务时序。实验环境:Windows 11 / Python 3.13 / pandas 3.0.6 / numpy 2.5.3,脚本与结果 JSON 均可复现。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号