#WorkBuddy# 300 条业务正则里 44 颗炸弹:语法检查全放行,静态扫描 17 条误报,双形状探针才做到零漏检
原创
#WorkBuddy# 300 条业务正则里 44 颗炸弹:语法检查全放行,静态扫描 17 条误报,双形状探针才做到零漏检
原创
用户12784192
发布于 2026-11-11 10:53:38
发布于 2026-11-11 10:53:38
#WorkBuddy# 300 条业务正则里 44 颗炸弹:语法检查全放行,静态扫描 17 条误报,双形状探针才做到零漏检
四档检出能力对比
一、痛点:正则没人审,线上炸了才知道
每个后端仓库里都躺着一堆正则:校验手机号、解析日志、剥离 HTML、匹配订单号。它们的共同特点是——没人审。写的时候能跑,测试的时候能过,直到某天一条 60 个字符的用户输入把 CPU 打满,大家才知道这叫 ReDoS(Regular Expression Denial of Service,正则灾难性回溯)。
我让 WorkBuddy 把这件事变成一条流水线:从"语法检查"到"静态规则"再到"实测探针",把 300 条业务正则全部过一遍。本文所有数字都是真机实测跑出来的,不是估算。
实验环境:Windows 11 + CPython 3.13.14,语料为自建合成的 300 条互不重复的业务正则(覆盖 69 个模式家族:邮箱、身份证、IPv4、日志行、服务名工单号,以及各种"看起来没问题"的嵌套量词写法),与任何真实业务无关。
二、根因:三层防线,每一层都有自己的盲区
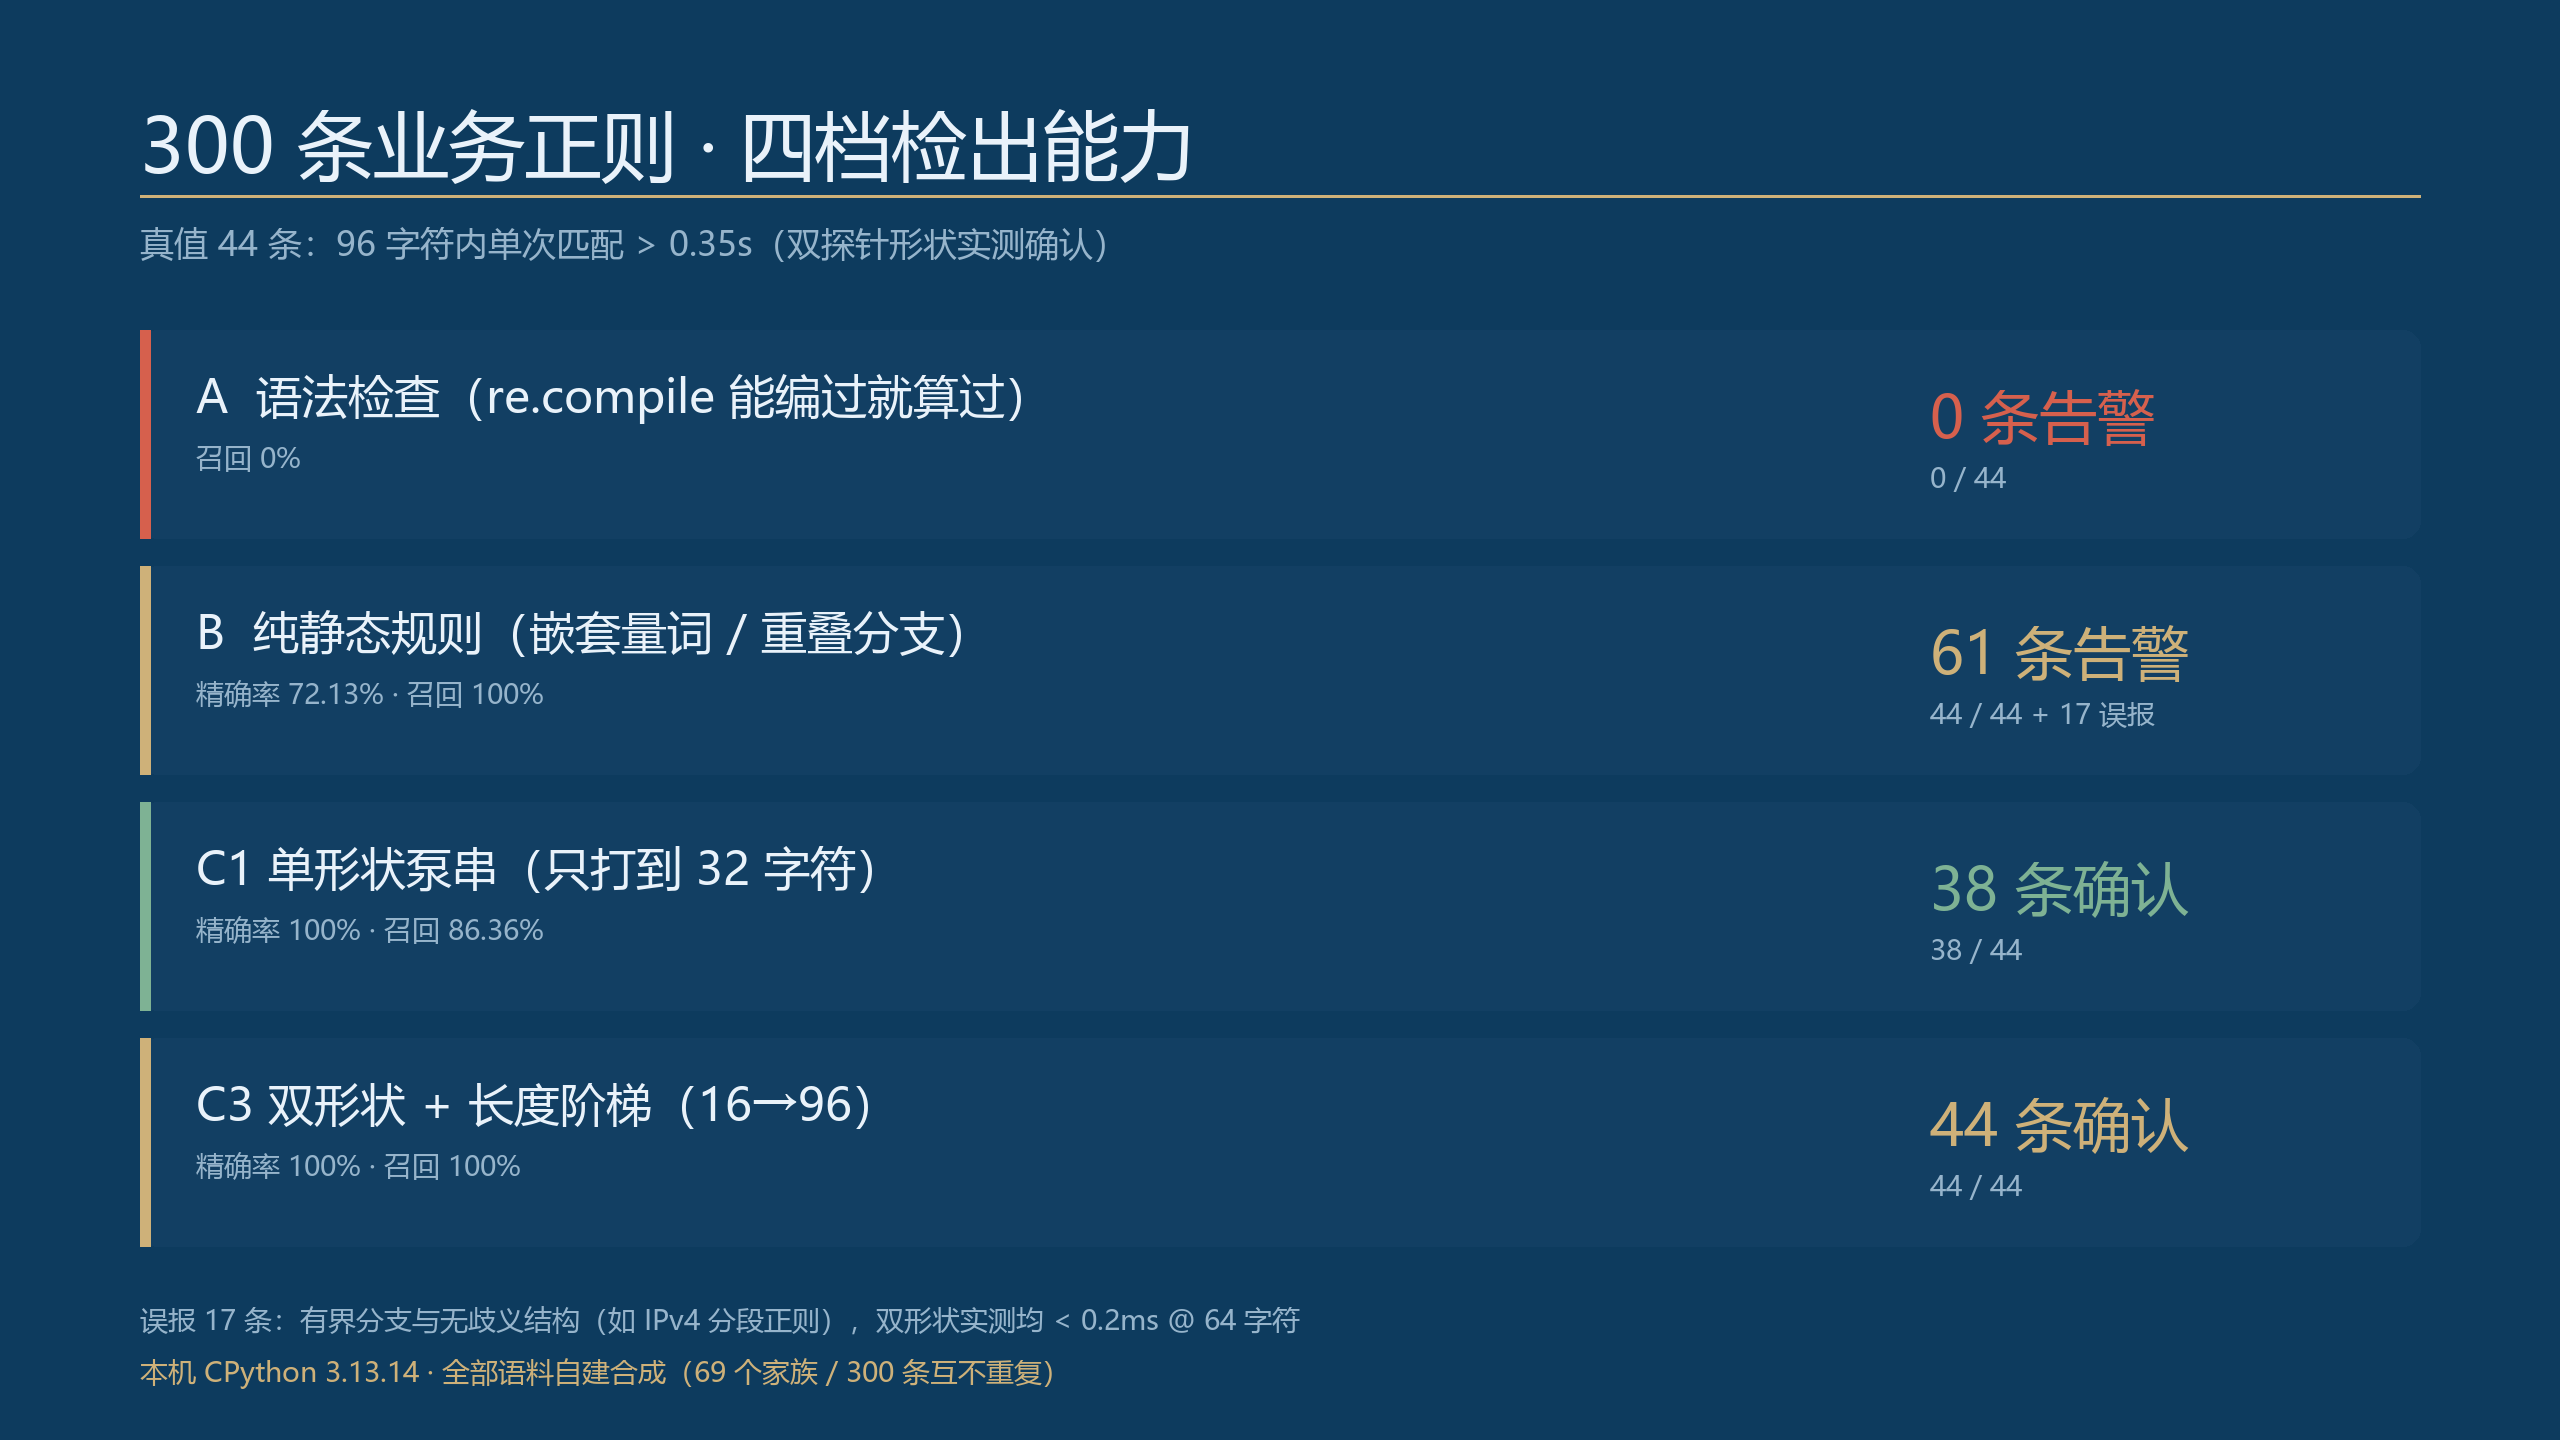
第一层,语法检查(re.compile)。 Python 的 re 模块只管语法合法性,不管性能。300 条正则全部编译通过,0 条告警。语法层对 ReDoS 完全免疫——这是防线的第一个洞。
第二层,静态规则。 灾难性回溯有两个经典来源:嵌套量词(([a-z]+)+)和重叠分支((a|aa)+)。用括号深度扫描加量词检测,300 条里标红了 61 条。但静态规则有个天生缺陷:它看不出量词是不是有界的。IPv4 正则 ^((25[0-5]|2[0-4]\d|1\d\d|[1-9]?\d)\.){3}…$ 结构上也是"组内分支 + 组外量词",但每个分支长度有硬上限,回溯树是封闭的。61 条告警里最终只有 44 条真能炸,17 条是误报,精确率 72.13%。
第三层,实测探针。 拿构造好的攻击串去跑,超时即定性。看起来最可靠,但它有两个隐蔽的变量:
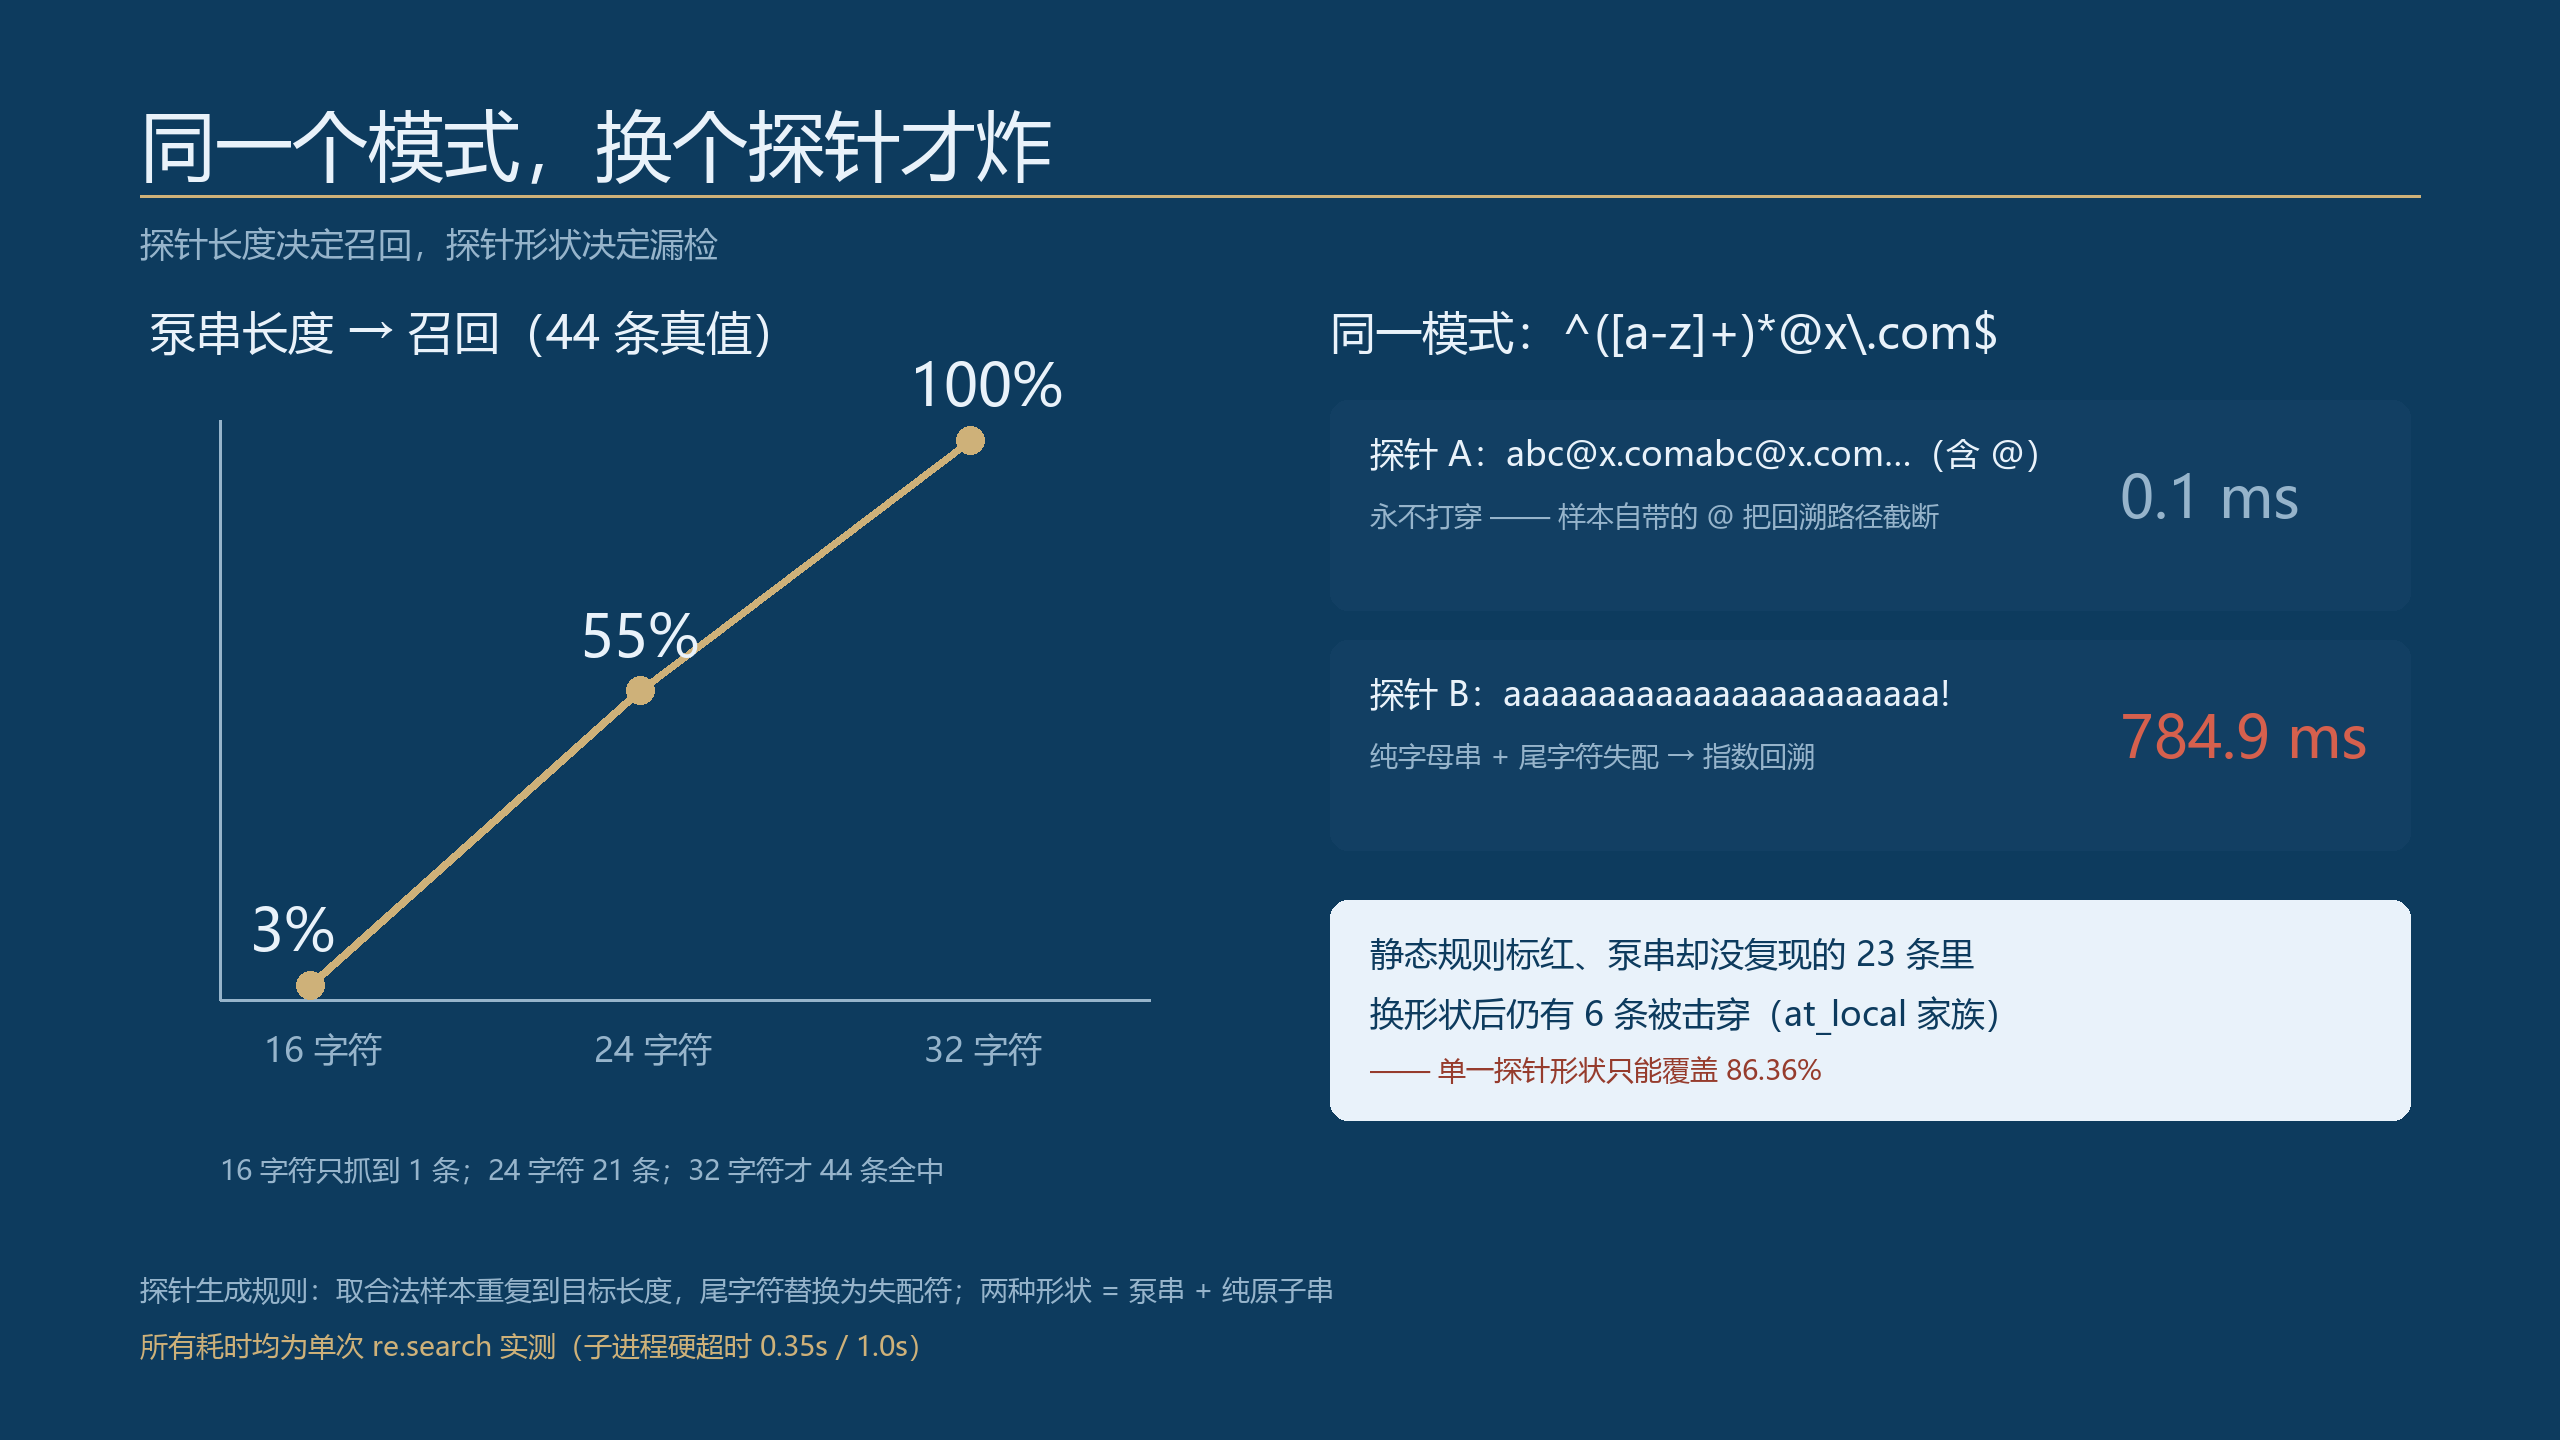
- 探针长度。长度阶梯 16 → 24 → 32 字符,召回率是 2.63% → 55.26% → 100%。16 字符的探针几乎什么都测不出来。
- 探针形状。这是本次实验最大的意外:
^([a-z]+)*@x\.com$这条模式,用合法样本泵出来的探针是abc@x.comabc@x.com…!——样本自带的@会把回溯路径提前截断,怎么跑都是 0.1ms。换成纯字母串aaaa…!,24 字符直接 784.9ms。同一条正则,换个探针形状就从"安全"变"炸弹"。
探针长度与形状决定检出
三、真实数据:四档方案对比
真值口径:96 字符以内、单次 re.search 超过 0.35 秒即判定为"可复现炸弹"(子进程硬超时)。泵串探针确认 38 条,换形状探针再补 6 条,最终 44 条真值。
档位 | 方法 | 告警/确认 | 精确率 | 召回率 | 人工复核量 |
|---|---|---|---|---|---|
A | 语法检查(re.compile) | 0 | — | 0% | 0(全放行) |
B | 纯静态规则 | 61 条告警 | 72.13% | 100% | 61 条 |
C1 | 单形状泵串(≤32 字符) | 38 条确认 | 100% | 86.36% | — |
C3 | 双形状 + 长度阶梯 | 44 条确认 | 100% | 100% | 0 |
几个值得记住的细节:
- 静态规则的 17 条误报全部集中在 4 个家族:double_star 6、host_star 5、word_dot_star 5、url_path 1。双形状探针在 64 字符内实测全部低于 0.2ms——它们不是"漏网之鱼",是真的安全。
- 6 条被换形状探针补上的,全是 at_local 家族(
^([a-z]+)*@x\.com$型)。单形状探针的召回率就被这一族卡在 86.36%。 - 成本:300 条全量阶梯实测 214.4 秒(平均 0.71 秒/条,304.89ms),第二种形状只对静态命中的 61 条补测,增量不到 40 秒。这个成本放进 CI 完全可接受。
四、可复制代码:三态分级流水线
核心逻辑不到 60 行:静态定位 → 阶梯探针实测 → 三态分级(确认 / 排除)。
import re, time, multiprocessing as mp

LADDER = (16, 24, 32, 40, 48, 64, 80, 96)
BUDGET = 0.35  # 单次匹配预算(秒)

def group_quants(pat):
    """记录每个右括号后紧跟量词时所在的括号深度"""
    depth, out, in_cls = 0, [], False
    for i, ch in enumerate(pat):
        if in_cls:
            in_cls = ch != "]"
            continue
        if ch == "[":
            in_cls = True
        elif ch == "(":
            depth += 1
        elif ch == ")":
            nxt = pat[i + 1:i + 2]
            if nxt and nxt in "*+{":
                out.append((depth, nxt))
            depth = max(0, depth - 1)
    return out

def static_hit(pat):
    gq = group_quants(pat)
    ds = {d for d, _ in gq}
    return (any(d >= 2 for d in ds) and any(d >= 1 for d in ds)) or \
           bool(re.search(r"\([^()]*\|[^()]*\)\s*[*+]", pat))

def child(pat, probes, q):
    rx = re.compile(pat)
    for L, p in probes:
        t0 = time.perf_counter()
        rx.search(p)
        if time.perf_counter() - t0 > BUDGET:
            q.put(L)          # 首个打穿预算的探针长度
            return
    q.put(None)

def probe_shapes(good, alt):
    """两种形状:泵串(保结构)+ 纯原子串(破坏结构依赖)"""
    out = []
    for base in (good, alt or good, "a"):
        for L in LADDER:
            out.append((L, (base * 80)[:L] + "!"))
            out.append((L, (base * 80)[:L - 1] + "@"))
    return out

def audit(pattern, good, alt):
    q = mp.Queue()
    p = mp.Process(target=child, args=(pattern, probe_shapes(good, alt), q))
    p.start(); p.join(30)
    hit_len = None if p.is_alive() else q.get()
    if p.is_alive():
        p.terminate()
    verdict = "确认炸弹" if hit_len else ("静态命中·未复现" if static_hit(pattern) else "排除")
    return verdict, hit_len

if __name__ == "__main__":
    print(audit(r"^([a-z]+)*@x\.com$", "abc@x.com", "abd@x.com"))
    # -> ('确认炸弹', 24)
五、加固:改写必须机器验收,不能凭感觉
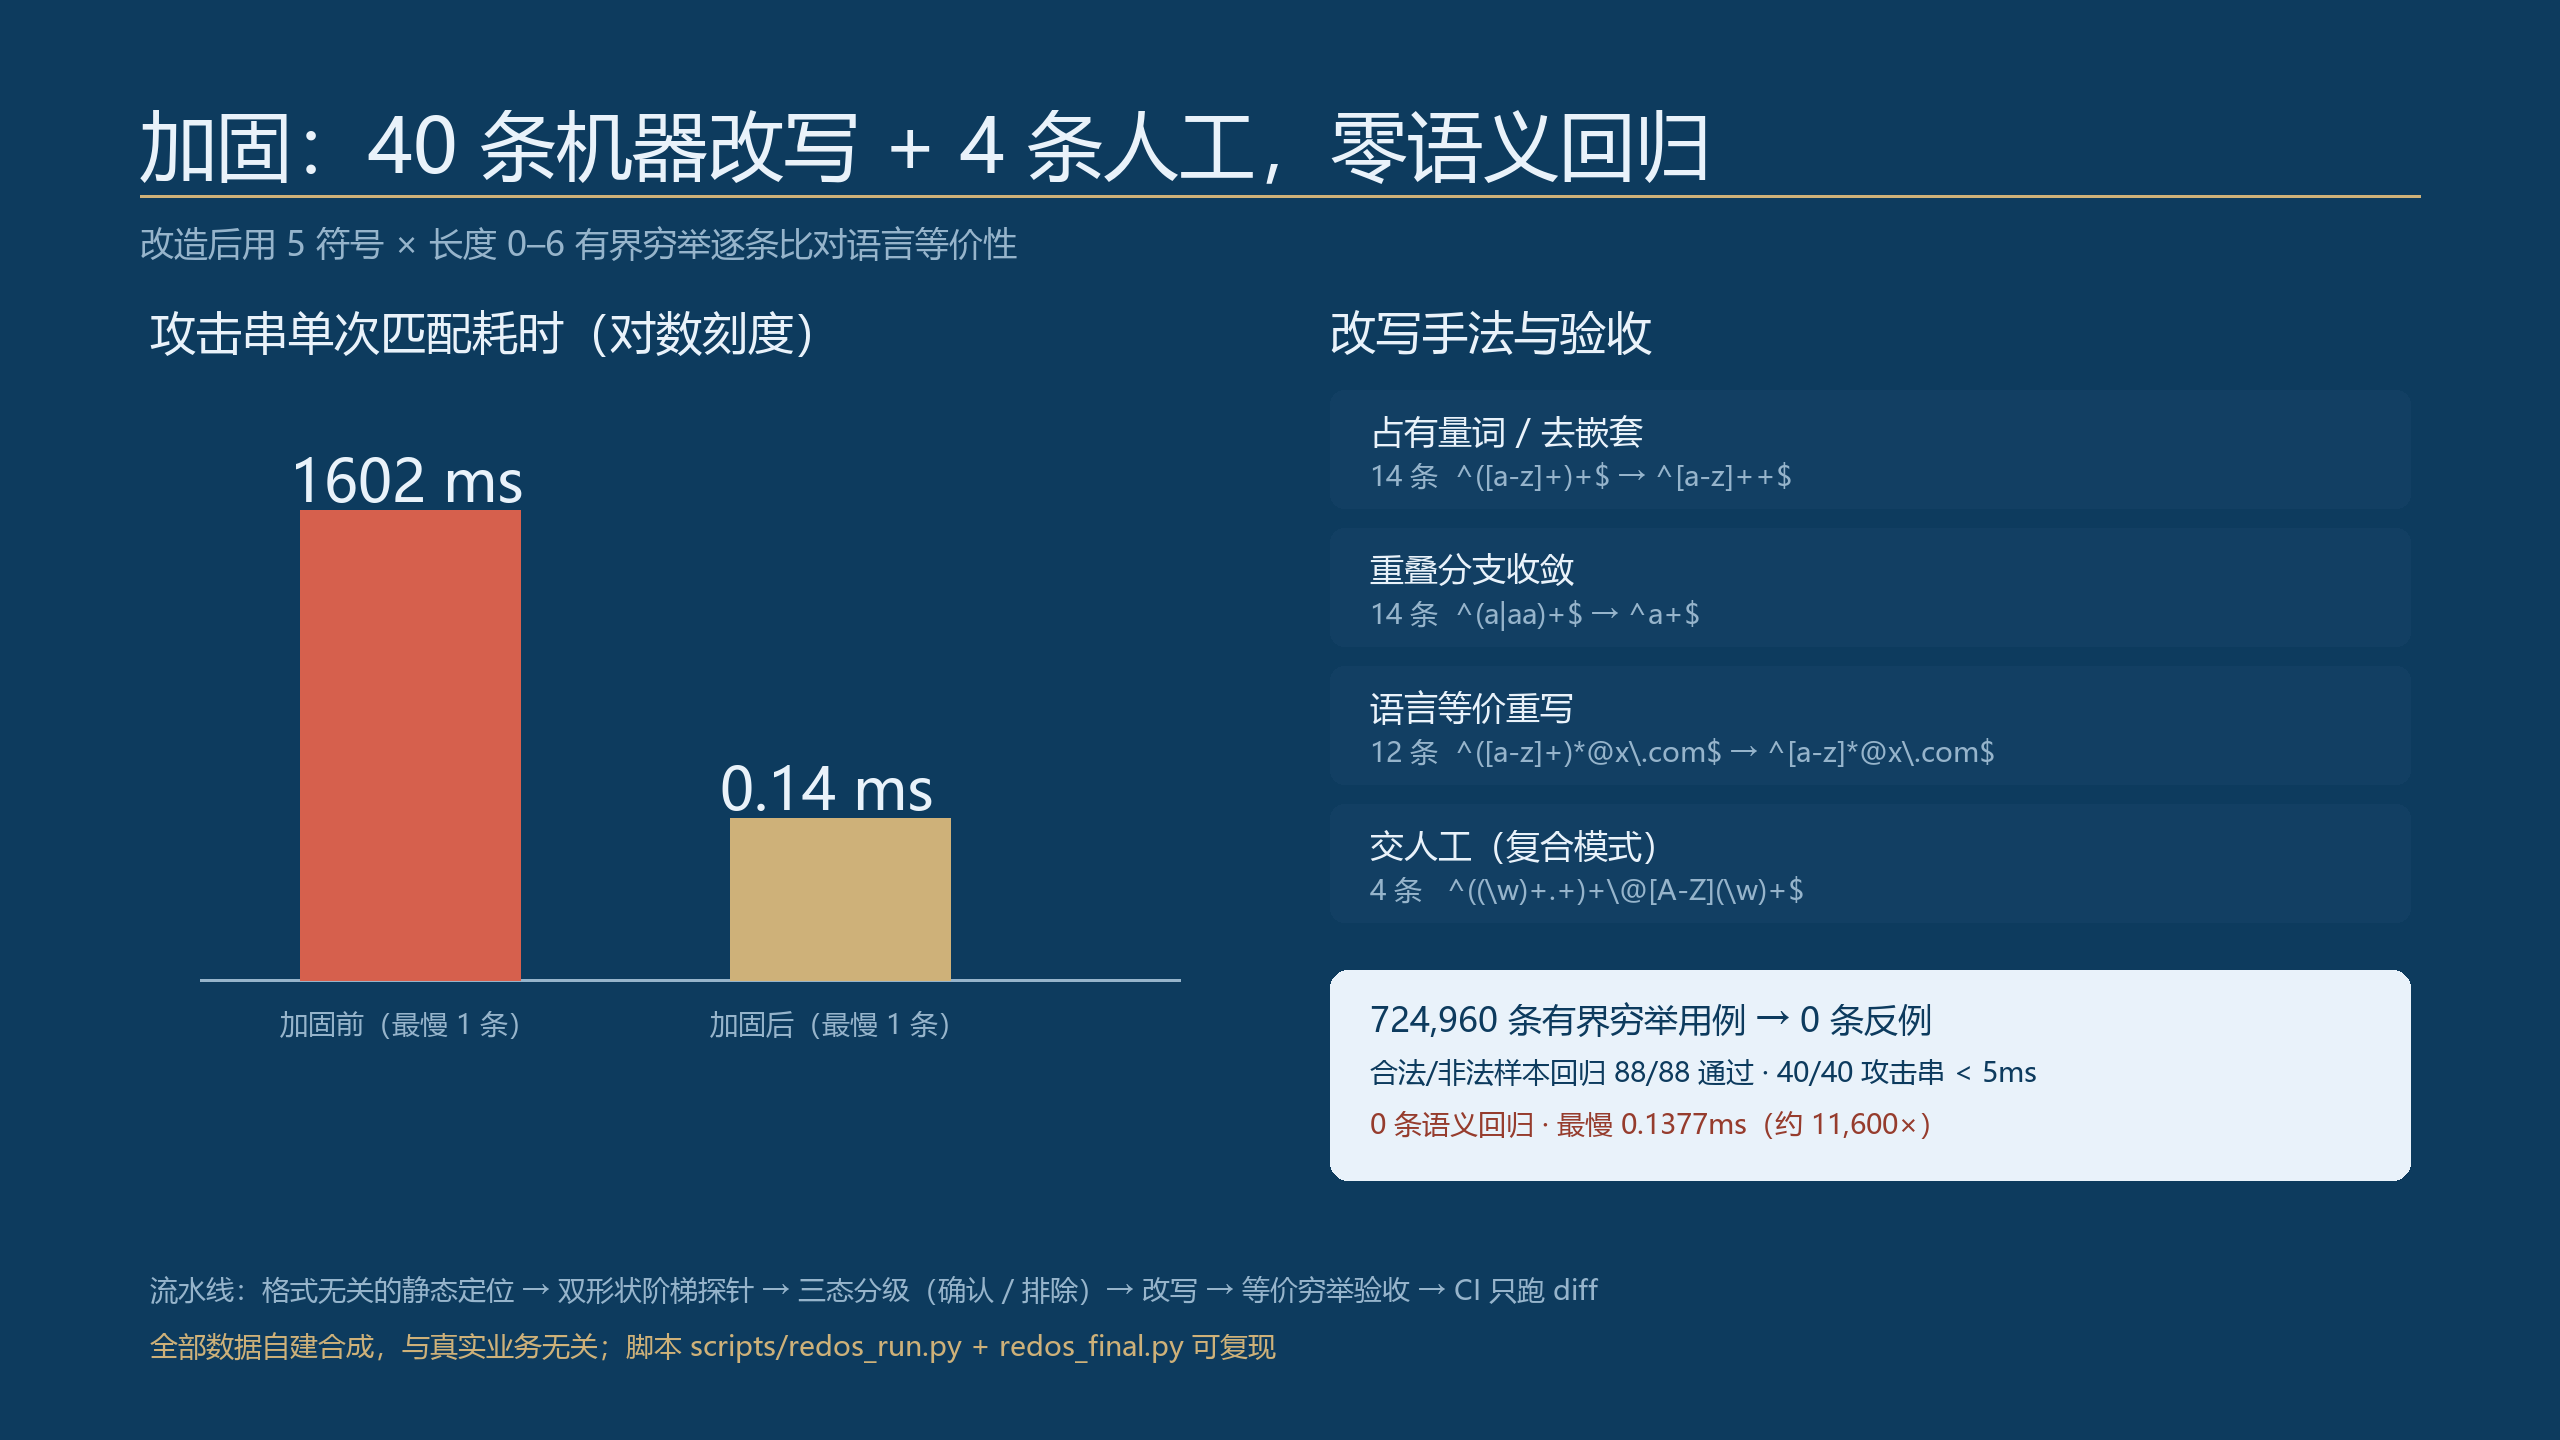
44 条确认炸弹里,40 条用三类手法机器改写,4 条复合模式交人工:
手法 | 数量 | 示例 |
|---|---|---|
占有量词 / 去嵌套 | 14 |
|
重叠分支收敛 | 14 |
|
语言等价重写 | 12 |
|
交人工 | 4 |
|
改写最大的风险是顺手改掉了语言(能匹配的串变少了)。我的做法是有界穷举验收:从模式里提取字面量字符组成字母表(封顶 5 个符号),枚举长度 0–6 的全部字符串,逐条比对改写前后的 fullmatch 结果——44 条共跑了 724,960 个用例,0 条反例;合法/非法样本回归 88/88 通过。
效果:40 条改写后,攻击串单次匹配从最慢 1601.66ms 降到最慢 0.1377ms(约 11,600 倍),40/40 全部低于 5ms,0 条语义回归。
加固手法与穷举验收
六、踩坑清单
- 样本泵串会被样本自身的结构字符截断。
abc@x.com泵出来的探针永远带@,([a-z]+)*在@处就被迫停机——回溯树根本没展开。探针必须准备第二种"破坏结构"的形状(纯原子串)。 - 预算影响定性。同一批模式,0.35s 预算和 1.5s 预算的判定结果不同:预算越长,越多"慢"被确认为"炸"。预算必须写进结论(本文:0.35s @ 96 字符内)。
- Windows 下 multiprocessing 的 worker 必须写在模块顶层。写在函数里会报
Can't get local object;写在python -的 stdin 脚本里,子进程会去重新执行<stdin>直接崩。 q.get_nowait()在join()之后偶发拿不到数据(队列 feeder 线程还没刷完),会被误判成超时。统一改成q.get(timeout=1.0)。- 有界穷举的字母表要从模式字面量推导。纯
a字母表验证不了带@、.的模式;但符号超过 5 个、长度超过 6,用例数会指数膨胀(5^7 ≈ 7.8 万/条),44 条就要跑几分钟。 - 占有量词(
++)和原子组((?>...))是 Python 3.11+ 才支持的,老版本改写方案要退回"去嵌套/收敛分支"。 re.fullmatch和re.search的判定口径必须全文一致。穷举等价性用fullmatch,攻击串计时用search,混用会得到自相矛盾的等价结论。
七、给 WorkBuddy 的提示词模板
把这段贴给 WorkBuddy,它可以直接在会话里跑完整个体检:
请对以下正则清单做 ReDoS 体检:① 先做静态扫描——括号深度 ≥2 且组外有量词、或组内有
|分支且组外有量词的,标记为候选;② 对每条候选构造两种探针(合法样本泵串 + 纯原子串),长度阶梯 16/24/32/48/64,子进程硬超时 0.35 秒实测;③ 输出三态报告:确认(实测打穿)/ 排除(双形状均 <0.2ms)/ 存疑(静态命中但未复现,列出让人工换输入验证);④ 对确认条目给出改写建议(占有量词 / 分支收敛 / 去嵌套),并用 5 符号 × 长度 ≤6 的有界穷举验证改写前后 fullmatch 结果完全一致;⑤ 全程给我真实计时数字,不许估算。
八、收尾
300 条正则、三层防线,最后真正让人放心的组合是:静态规则负责不漏(召回 100%),双形状实测负责不冤枉(精确率 100%),穷举验收负责不改坏(0 反例)。任何单独一层都会放走炸弹或者冤枉好人。
复现脚本:redos_gen.py(语料生成)、redos_run.py(阶梯实测)、redos_altprobe.py(换形状复测)、redos_final.py(指标合并与加固验收),全部数字由脚本真实产出。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号