#WorkBuddy# 20 对 Excel 台账 90 万个单元格:逐格 diff 误报 12.7 万处、漏检近 4 成,字段级对账怎么做到 100%
原创
#WorkBuddy# 20 对 Excel 台账 90 万个单元格:逐格 diff 误报 12.7 万处、漏检近 4 成,字段级对账怎么做到 100%
原创
用户12784192
发布于 2026-11-05 09:37:48
发布于 2026-11-05 09:37:48
#WorkBuddy# 20 对 Excel 台账 90 万个单元格:逐格 diff 误报 12.7 万处、漏检近 4 成,字段级对账怎么做到 100%
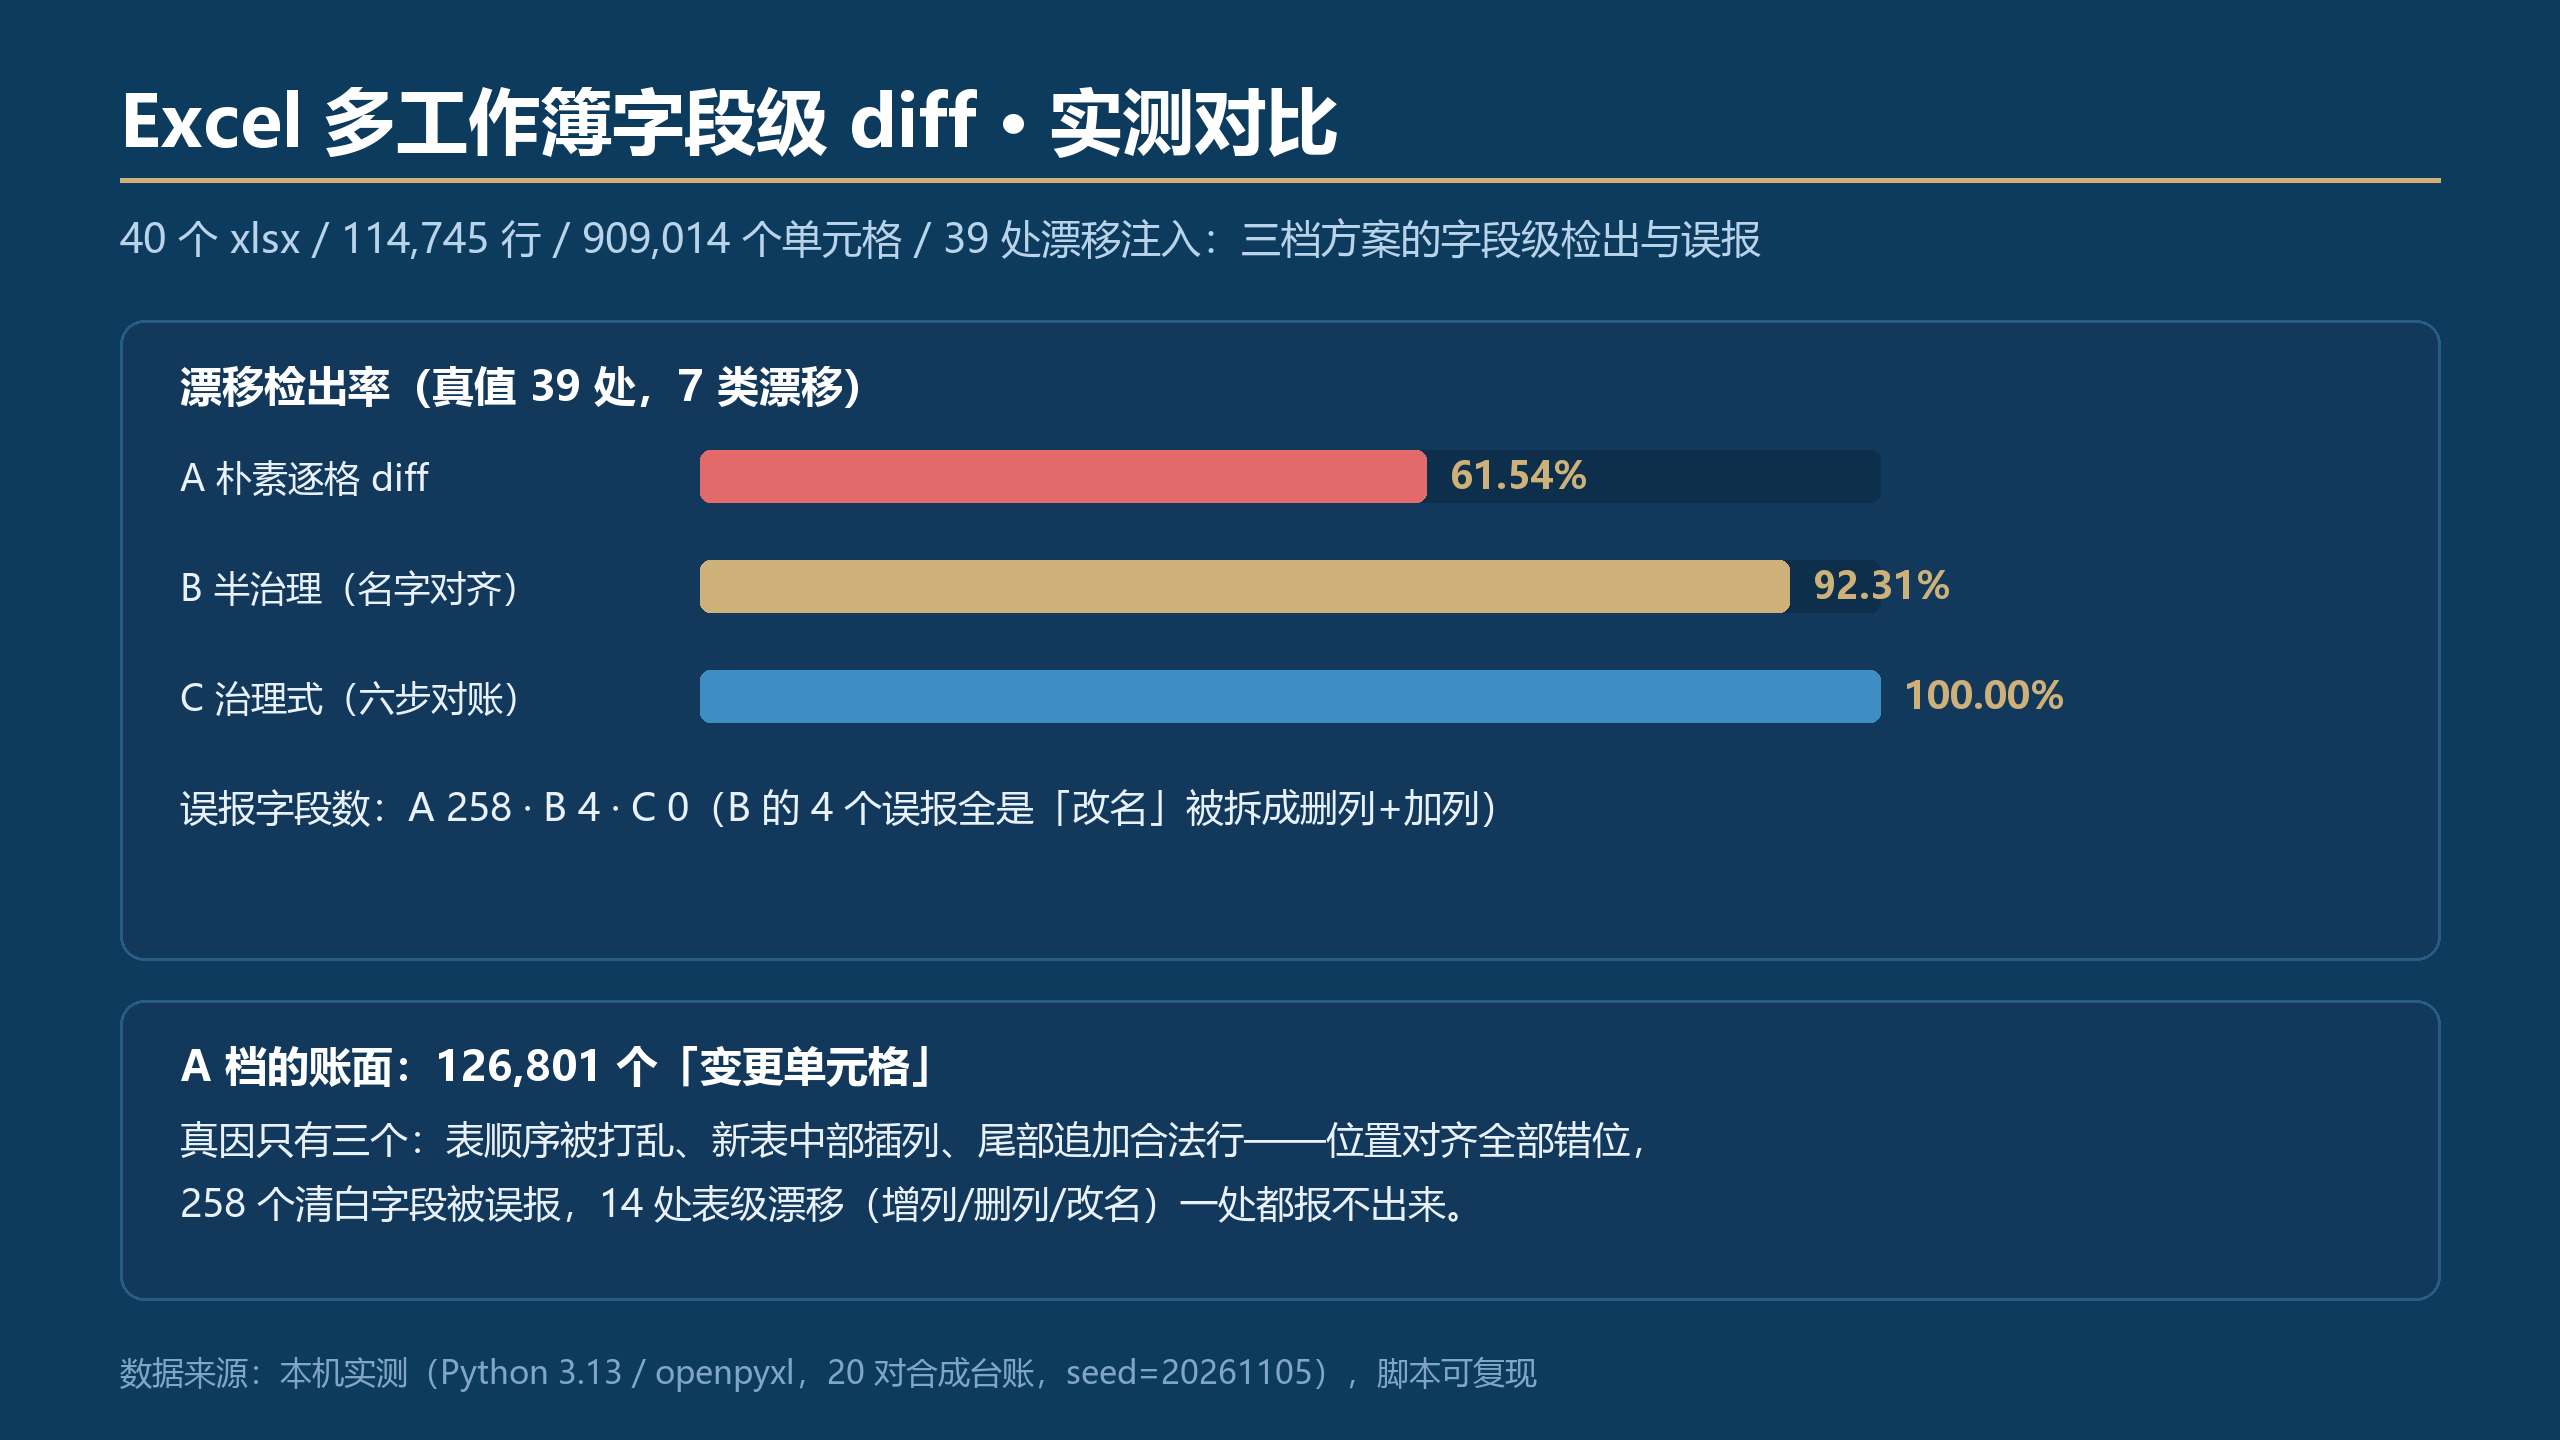
三档方案字段级检出与误报对比
痛点开场
手头有两份 Excel 台账:上月归档一份,本月导出一份。领导问:"这个月数据有什么变化?"你想都没想就写了个脚本:两个文件用 pandas 读进来,逐个单元格比,不一样的打标记。脚本几秒跑完,输出 12 万个"变更单元格"——没人看得懂,也没人敢用。
更危险的是反过来的场景:脚本说"只有 3 处变化",你信了。但实际上新表里有一列被悄悄删了、有一列名字从"负责人"改成了"责任人"、还有一列 30% 的单元格从数字变成了文本——这些它一个都没报。
我把这个场景做成了一次可复现的实验:20 对合成工作簿(40 个 xlsx、114,745 行数据、909,014 个单元格),往里面精确注入 39 处字段级漂移,然后让三档方案分别去查。结论先放这里:朴素逐格 diff 检出 61.54%、误报 258 个字段;半治理 92.31%、误报 4 个;治理式六步对账 100.00%、误报 0。
根因分析:位置对齐和名字对齐都会骗你
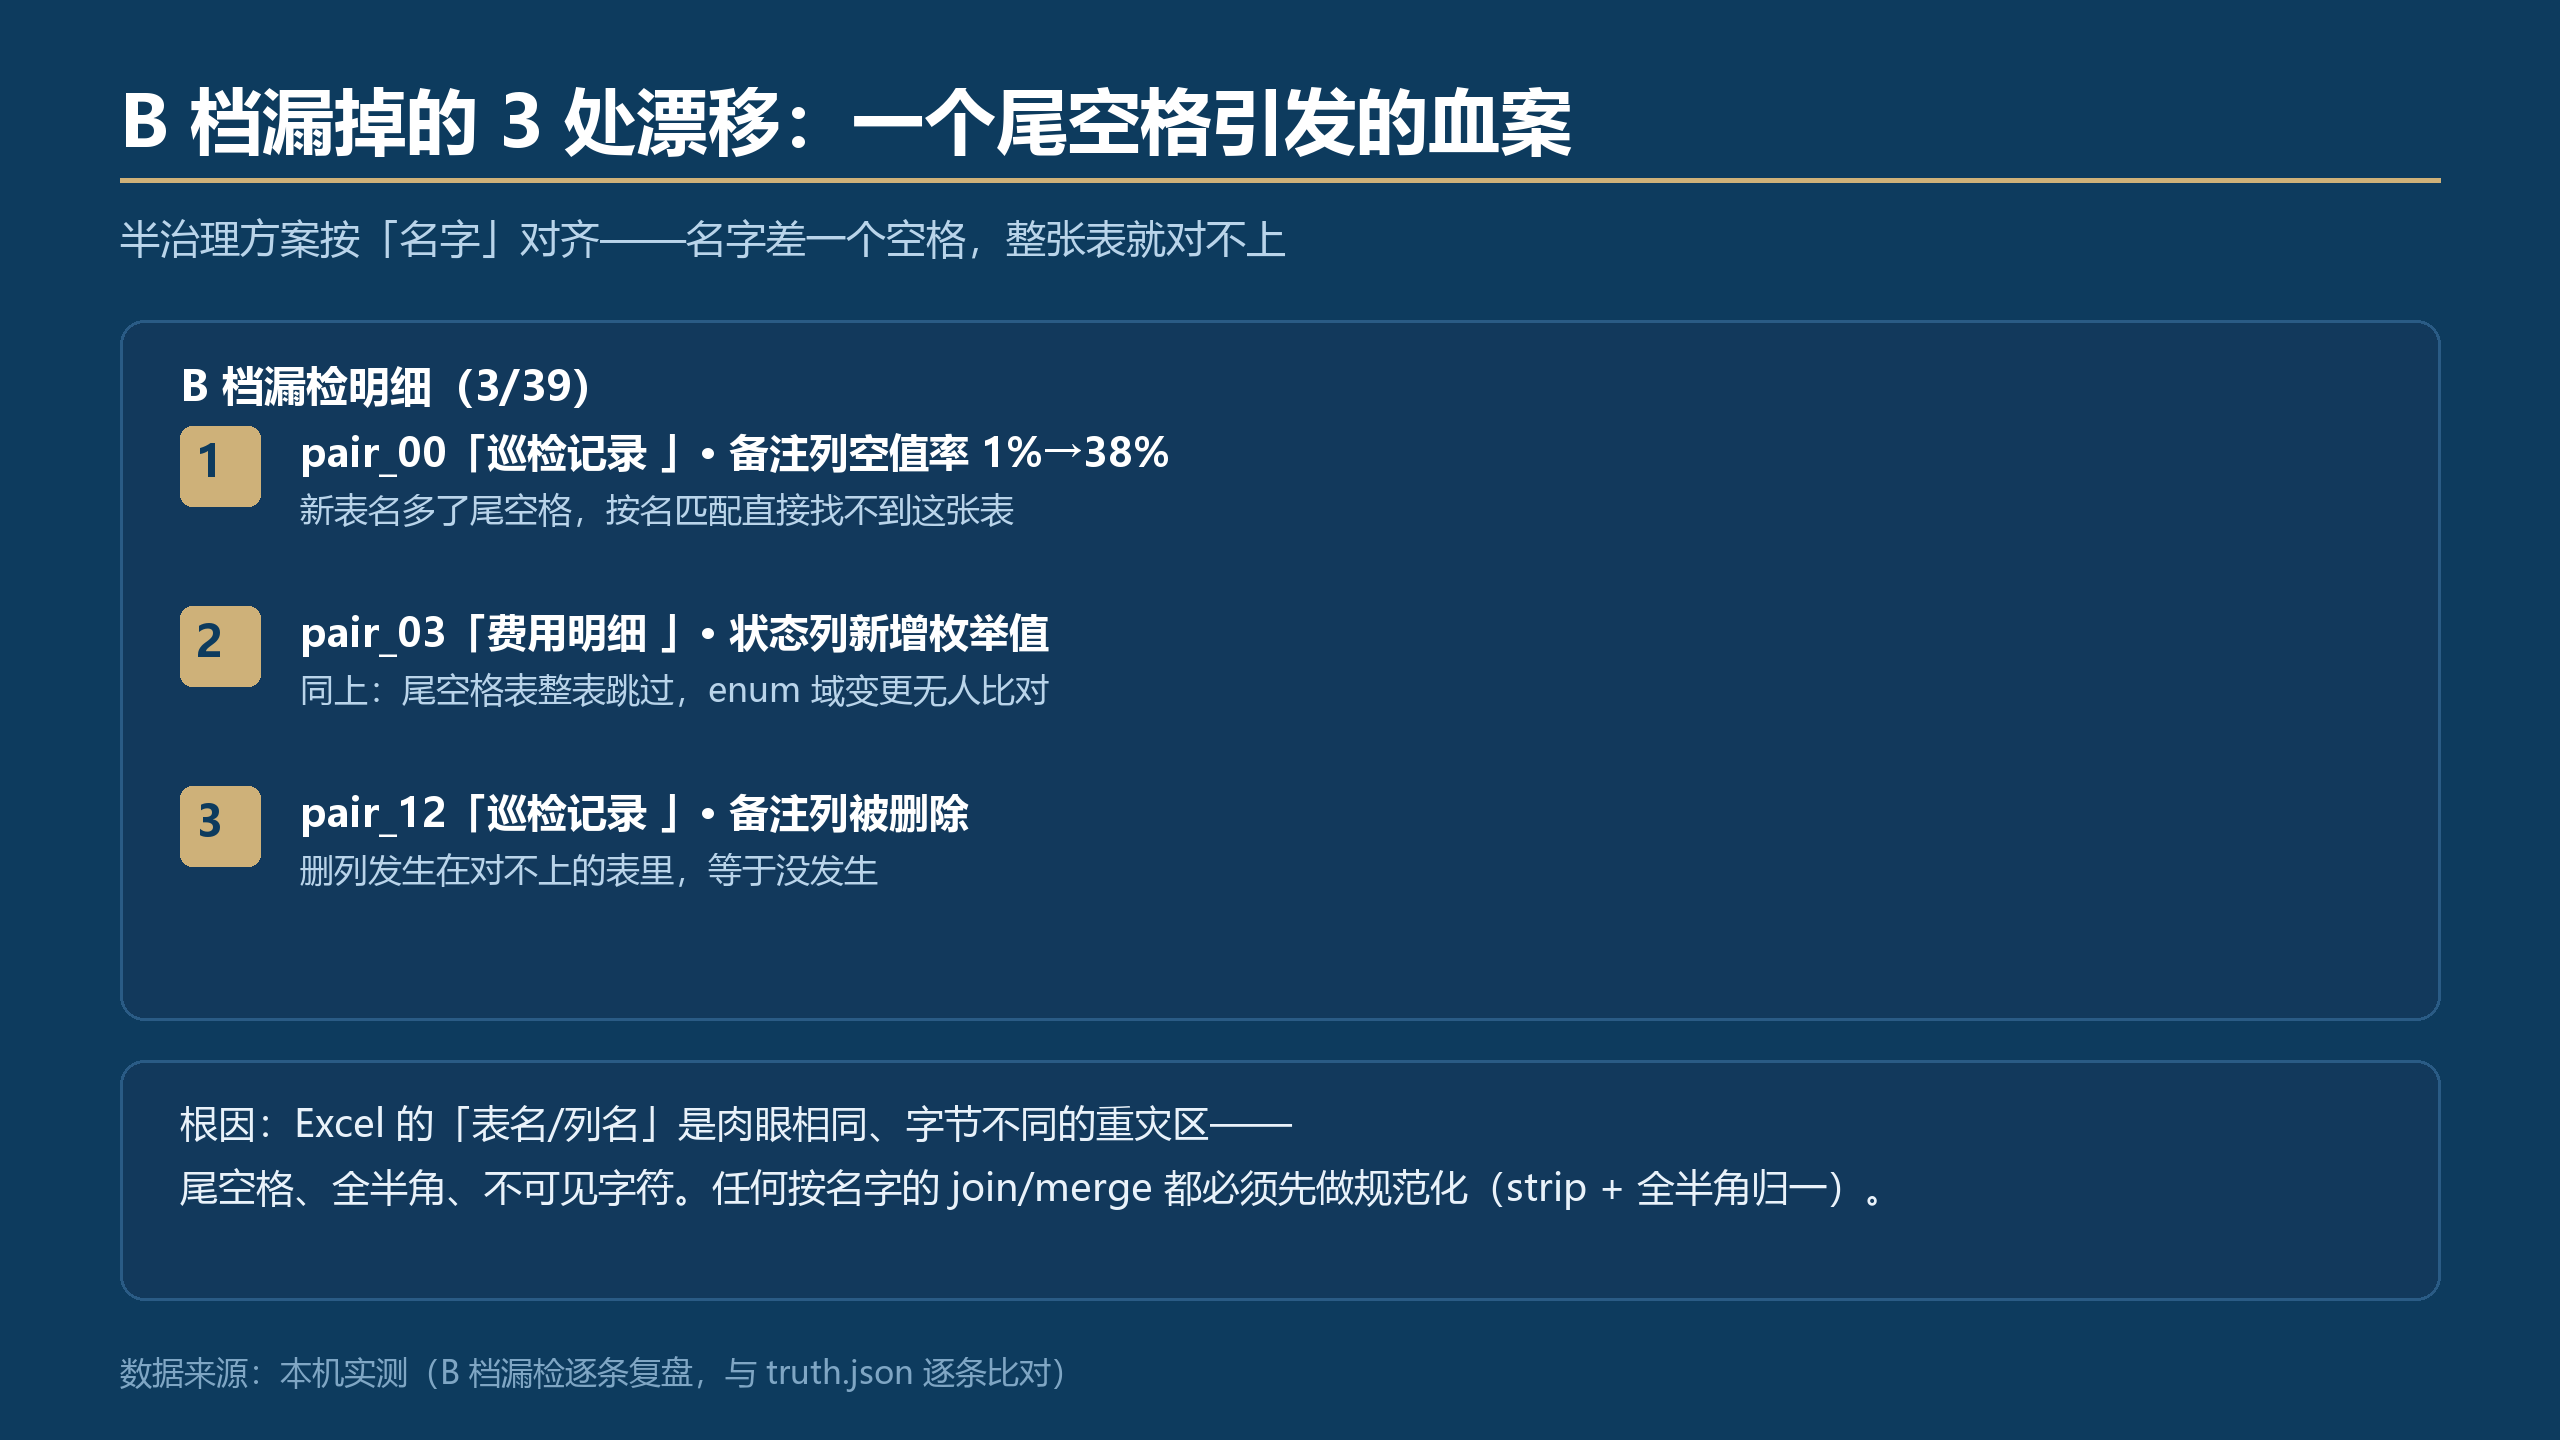
B 档 3 处漏检复盘:表名尾空格
三档方案的实测差距,全部来自"怎么对齐"这一个决定:
A 档(朴素逐格 diff):按工作表顺序对齐表、按行列下标对齐单元格。听起来天经地义,实际上三个常见的正常变动就能让它全盘错位——①新文件的工作表顺序被调整过(导出工具不保证顺序);②有人在表中部插了一列(后面所有列整体右移一格);③尾部追加了一批合法新行。结果:126,801 个单元格被报"变更",其中 258 个字段是彻头彻尾的误报;而真正的 14 处表级漂移(增列 5、删列 5、改名 4)一处都识别不出来——位置 diff 的世界观里根本没有"字段"这个概念。
B 档(半治理,按名字对齐):先按表名找到同一张表,再按列名对齐,然后做 dtype 检查和空值率对比。它解决了 A 的大部分问题,但栽在一个意想不到的坑上:表名尾空格。实测 B 档漏掉的 3 处漂移,全部发生在表名被加了尾空格的表里——"巡检记录"和"巡检记录 "在肉眼里是同一张表,在字符串比较里是两个东西。按名匹配直接查无此表,整张表的漂移就此隐身。
C 档(治理式六步对账):在 B 的基础上补了四块:表名先做规范化(strip + 全半角归一);对名字对不上的列,用前 200 行数据做指纹识别改名(数据一样、名字不同的自动认亲);对枚举类字段做新旧取值集合 diff;对数值列做值域校验(负值、超老域 10 倍的异常值)。39 处漂移全部检出,0 误报,顺手把主键对账的 1,451 行新增差异也列了清单。
真实数据对比
方案 | 检出率(39 处真值) | 误报字段 | 漏检构成 | 耗时 |
|---|---|---|---|---|
A 朴素逐格 diff | 61.54%(24/39) | 258 | 表级漂移 14 处全漏 + 尾空格表 1 处 | 14.63s |
B 半治理(名字对齐) | 92.31%(36/39) | 4(改名被拆成删+增) | 3 处全在尾空格表里 | 16.40s |
C 治理式六步对账 | 100.00%(39/39) | 0 | 无 | 15.28s |
注:C 档同时产出键对账结果——新旧版本主键差异 1,451 行(尾部合法追加的新记录),单独列清单,不与漂移混报。误报的代价不是"多看几行",而是让报告整体失去可信度:A 档 258 个误报字段意味着每一条真实预警都淹没在噪声里。
可复制代码:改名指纹识别 + 枚举域 diff
核心思想:先把字段对齐,再谈值不同。改名识别是 B 档做不到、C 档拉开差距的关键——不用任何第三方库,20 行搞定:
import json

def col_vals(header, rows, name, limit=200):
    ci = header.index(name)
    return [r[ci] if ci < len(r) else None for r in rows[:limit]]

def match_renames(old_header, old_rows, new_header, new_rows):
    """数据指纹一致 -> 视为改名,返回 {旧列名: 新列名}"""
    old_un = [c for c in old_header if c not in new_header and c != "记录编号"]
    new_un = [c for c in new_header if c not in old_header and c != "记录编号"]
    pairs = {}
    for co in old_un:
        fp_old = json.dumps(col_vals(old_header, old_rows, co), default=str)
        for cn in new_un:
            if fp_old == json.dumps(col_vals(new_header, new_rows, cn), default=str):
                pairs[co] = cn
                new_un.remove(cn)
                break
    return pairs
第二块是枚举域与类型漂移检测——专抓"数字变文本"和"状态字段混进新值":
def check_column(old_vals, new_vals, null_jump=0.10):
    old_nn = [v for v in old_vals if v is not None]
    num_old = all(isinstance(v, (int, float)) for v in old_nn[:100]) and len(old_nn) > 50
    alerts = {}
    # 类型漂移:旧列是数值,新列混进文本(如 "1,024.00"、"000123")
    if num_old:
        str_hits = sum(1 for v in new_vals if isinstance(v, str))
        if str_hits >= 5:
            alerts["type_drift"] = str_hits
    else:
        # 枚举域:低基数字段的新取值
        dom_o = set(map(str, old_nn))
        dom_n = set(map(str, [v for v in new_vals if v is not None]))
        if len(dom_o) <= 20 and dom_n - dom_o:
            alerts["enum_drift"] = sorted(dom_n - dom_o)
    # 空值率跳变
    no, nn = old_vals.count(None), new_vals.count(None)
    if len(new_vals) and (nn - no) / len(new_vals) > null_jump:
        alerts["null_spike"] = f"{no}/{nn}"
    return alerts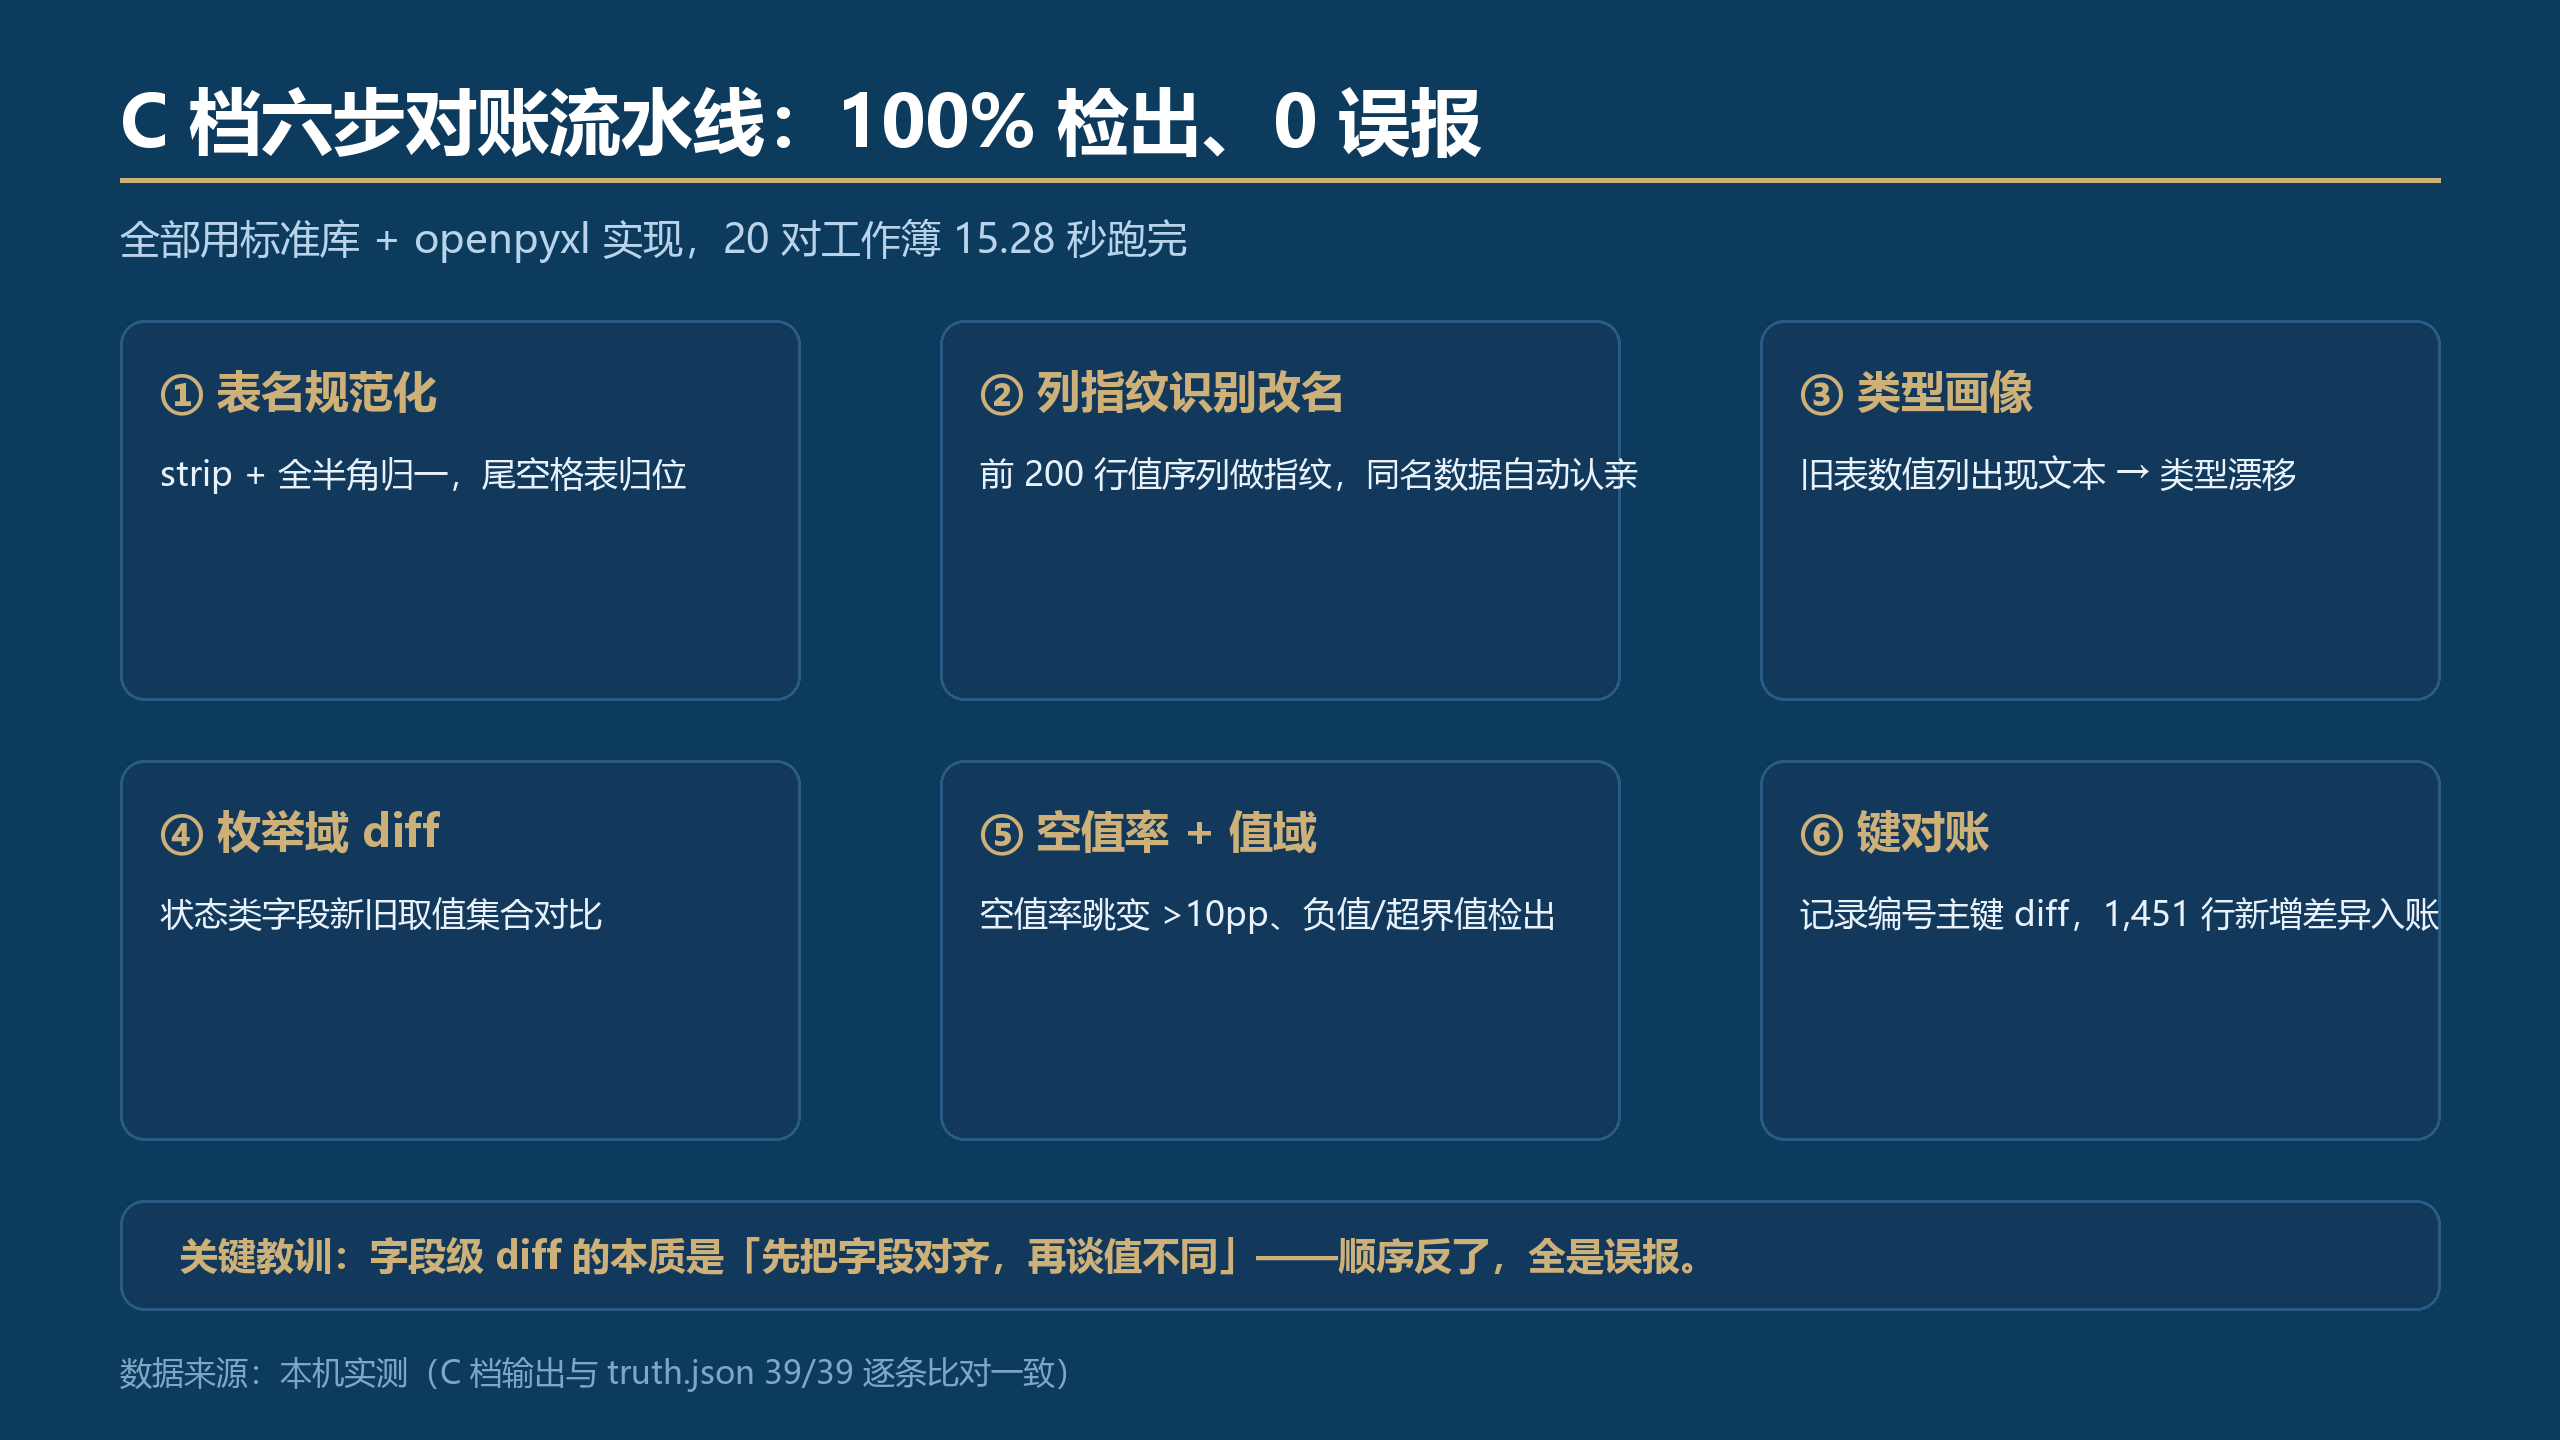
C 档六步对账流水线
踩坑清单
这次实验本身翻过的车,比结论更值钱:
- openpyxl read_only 模式的行会"缺尾巴":行尾的空单元格会被裁掉,
row[ci]直接 IndexError。必须自己写cell(row, i)兜底返回 None——逐格 diff 脚本一半的崩溃来自这里。 - 改名只改表头不改数据键:第一版语料里,"负责人→责任人"只重命名了表头,数据键没迁移,新列整列读出来是 None——指纹识别永远失败。造测试数据时,改名 = 改表头 + 迁移数据,两步缺一不可。
- 循环变量残留导致"张冠李戴":重构列对齐逻辑时,值级检查分支里残留了上一个循环的列名变量,39 处漂移全部报到同一个错误列上——而且检出逻辑本身是对的,纯粹是"贴标签"贴错了。字段级报告的每个数字都必须回溯到真值逐条核对,不能只看总数。
- 表名尾空格是真实世界的高发问题:用户手工建的表、系统导出的表都可能出现。任何按名字的 join/merge 之前,先
strip()加全半角归一。 - 尾部追加行要和漂移分开报:新版本多出来的合法记录是"业务增长",不是"数据漂移"。用主键对账单独列清单,混在漂移报告里只会稀释可信度。
给 WorkBuddy 的提示词模板
把这段发给 WorkBuddy,让它替你跑字段级对账:
帮我对两份 Excel 台账做字段级 diff,文件是 old.xlsx 和 new.xlsx,要求:
1. 工作表按"规范化表名"对齐(strip + 全半角归一),不按顺序;
2. 列先按列名匹配,名字对不上的用前 200 行数据指纹识别改名,
   识别成功的报"改名",剩下的报"新增列/删除列";
3. 每个对齐后的字段输出四项检查:类型漂移(旧数值列出现文本)、
   枚举域变更(低基数字段的新取值)、空值率跳变(>10 个百分点)、
   值域异常(负值或超旧域 10 倍);
4. 主键单独对账:只报新增/消失的主键,不与漂移混在一起;
5. 最终输出按 严重度 排序的漂移清单:表名 / 字段 / 漂移类型 / 证据,
   并单独列出"仅值不同"的合法变更行数。
不要逐单元格输出差异——我只关心字段级的结论。
收尾
回到开头的问题:"这个月台账有什么变化?"——正确的答案从来不是 12 万个变更单元格,而是 39 条带证据的字段级结论:哪张表、哪个字段、什么类型的漂移、证据是什么。
顺序很重要:先对齐字段,再比较值。位置对齐会被打乱的表顺序和插列摧毁,名字对齐会被一个尾空格击穿。把规范化、改名指纹、枚举域、空值率、值域、主键对账这六步串起来,字段级 diff 才配得上"对账"两个字。这套流程已经固化进我的 WorkBuddy 自动化,每晚 15 秒跑完 20 对工作簿——第二天早上,我只看结论。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号