#WorkBuddy# 280 个二进制包、5.6 万条记录:定长步长只认对 5.42%,八道关口做到 99.01%
原创
#WorkBuddy# 280 个二进制包、5.6 万条记录:定长步长只认对 5.42%,八道关口做到 99.01%
原创
用户12784192
发布于 2026-11-03 10:17:21
发布于 2026-11-03 10:17:21
#WorkBuddy# 280 个二进制包、5.6 万条记录:定长步长只认对 5.42%,八道关口做到 99.01%
@@FIG1@@
一、痛点开场:解析器说"全部成功",但三分之一的值是错的
手头有一种私有二进制容器格式:文件头 + 字符串表 + 一串 TLV 记录,监控探针每几分钟落一个盘。接口文档只写了三句话:记录 = 类型(1 字节)+ 长度(4 字节)+ 数据;字符串在文件头部的字符串表里;数值是变长整数。
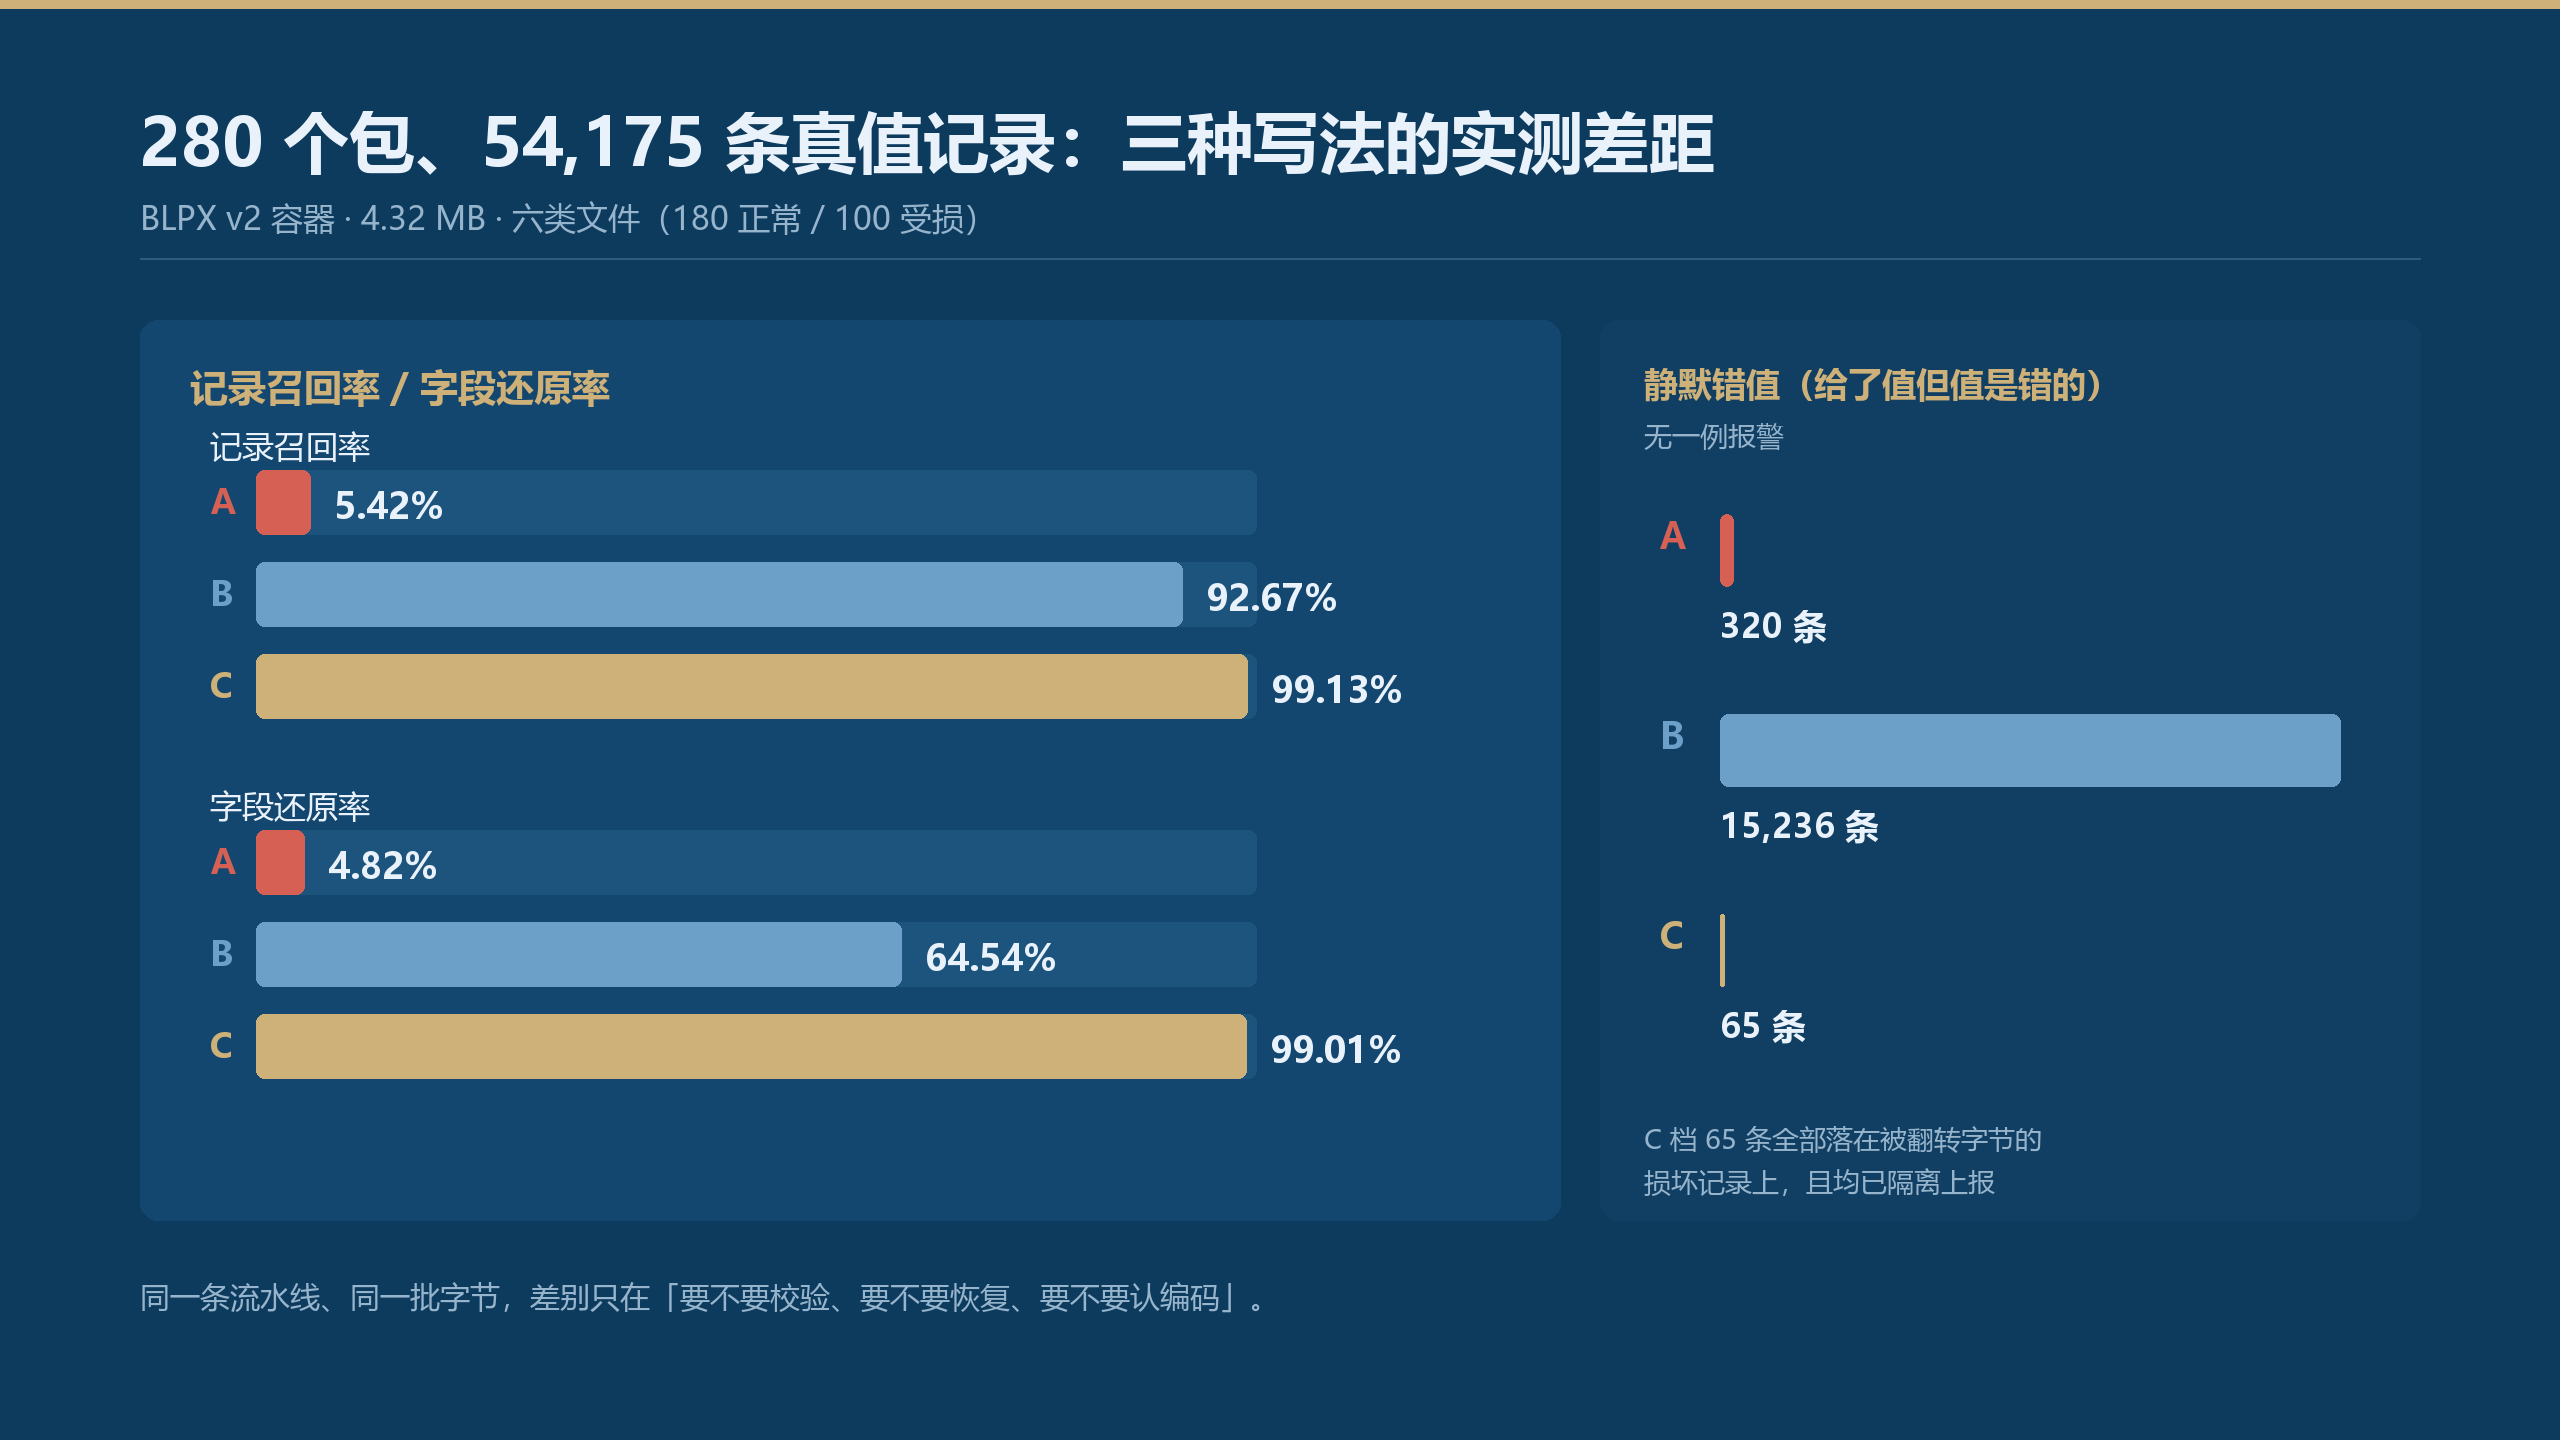
第一版解析器 0.3 秒跑完 280 个文件,零异常、零告警。直到对账时才发现:有 15,236 条记录的值是错的,且没有一条报错。
这就是二进制解析和文本解析最大的区别:文本解析错了通常抛异常,二进制解析错了会产出一个"看起来完全正常"的错值——类型读到了、长度读到了、字符串也解出来了,只是它们全都属于别的记录。
本文用一个可复现的实验把这件事量化:合成 280 个 BLPX v2 容器包(4.32 MB、56,335 条记录),注入六类损伤,然后用三种写法各解析一遍。所有数字均为实测,脚本与真值随文可查。
二、语料:280 个包、六类损伤、54,175 条真值
项目 | 数值 |
|---|---|
文件数 | 280 个(4,317,650 字节) |
记录总数 | 56,335 条(真值 54,175 条,截断文件尾部不计入分母) |
记录类型 | 数值 16,319 / 键值 11,959 / 二进制块 8,667 / 文本 6,499 / 嵌套 6,413(内含子记录 28,872 条)/ 填充 4,318 |
文件类别 | 完好 180 / 截断 30 / 字节翻转 30 / 长度字段溢出 20 / 对齐区污染 10 / 尾部垃圾 10 |
字符串表 | 抽样 40 个文件共 1,595 个条目,其中 515 条(32.29%)带 GBK 编码标记 |
记录平均长度 | 78.0 字节,4 字节对齐 |
格式里埋了几个"文档里不会写清"的细节,每一个都是真实的工程坑:
- 记录起始地址按 4 字节对齐,间隙填 0,对齐 padding 不计入长度字段;
- 字符串表每个条目的长度字节最低位是编码标记(0 = UTF-8,1 = GBK),最高位才是长度;
- 数值用 zigzag 变长整数,scale 1000,绝大多数超过 127,需要多字节 varint;
- 二进制块内部长度是大端 u16,与文件其他部分的小端相反(模拟历史遗留);
- 90% 的记录带 CRC32 尾部,10% 不带。
三、根因分析:三种写法,三种死法
A 档:把变长记录当定长切
最省事的写法是假设"每条记录 32 字节",用固定步长循环读。第一条约有六成概率蒙对,第二条开始读取位置就落进上一条的 payload 中间——类型、rid、长度全部读在别人的数据体上。
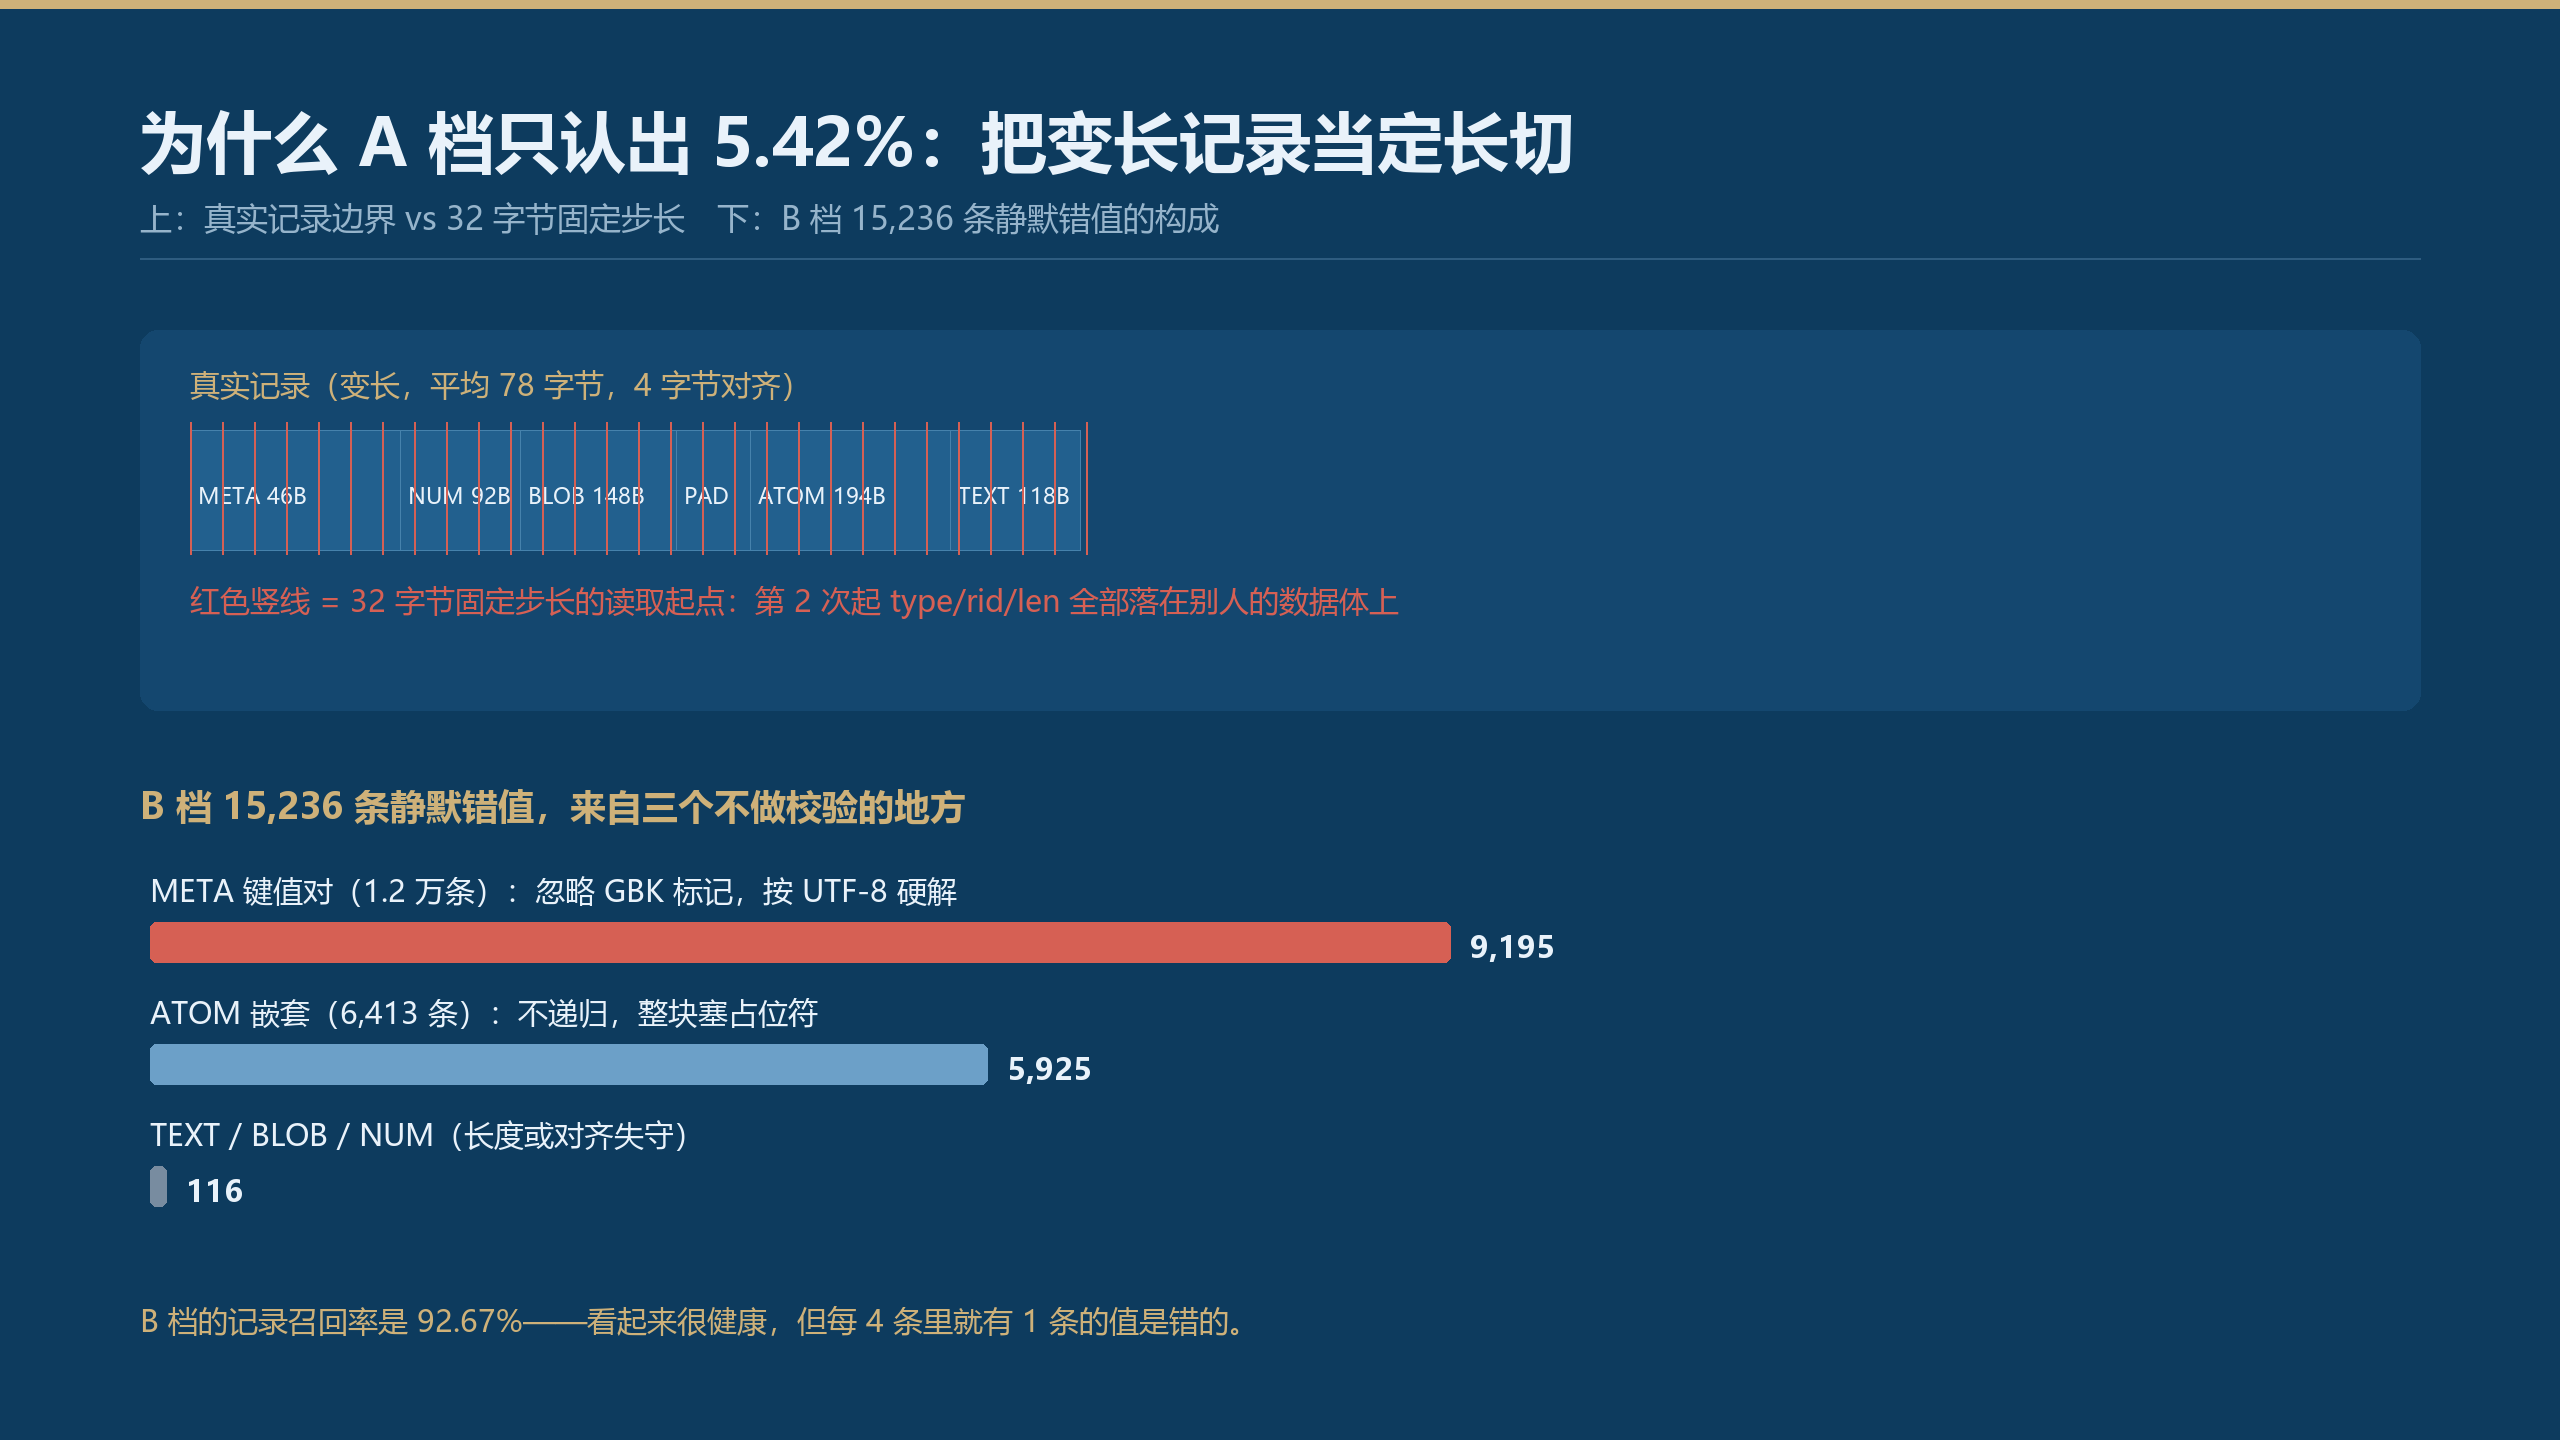
实测 54,175 条真值记录只匹配上 5.42%,字段还原率 4.82%。更糟的是它还给出了 320 条静默错值:解析器对这些记录输出了值,值是错的,但没有任何报警。
B 档:会走 TLV,但"不校验"
第二档是大多数人的真实水平:老老实实按 length 字段遍历、处理对齐、正确解析 varint——记录召回率立刻跳到 92.67%。看起来已经很健康了。
但静默错值高达 15,236 条,构成如下:
错值来源 | 条数 | 根因 |
|---|---|---|
键值对(META) | 9,195 | 忽略字符串条目的 GBK 编码标记,一律按 UTF-8 硬解,键名错位、值替换成乱码 |
嵌套(ATOM) | 5,925 | 不递归展开子记录,整块塞一个占位符 |
文本 / 块 / 数值 | 116 | 内部长度字段大小端读反、个别长度失守 |
B 档的问题不是"解析不出来",而是解析出来的东西它自己不知道是错的。92.67% 的召回率配上 64.54% 的字段还原率,中间那 28 个点的窟窿全部是无声的。
C 档:八道关口
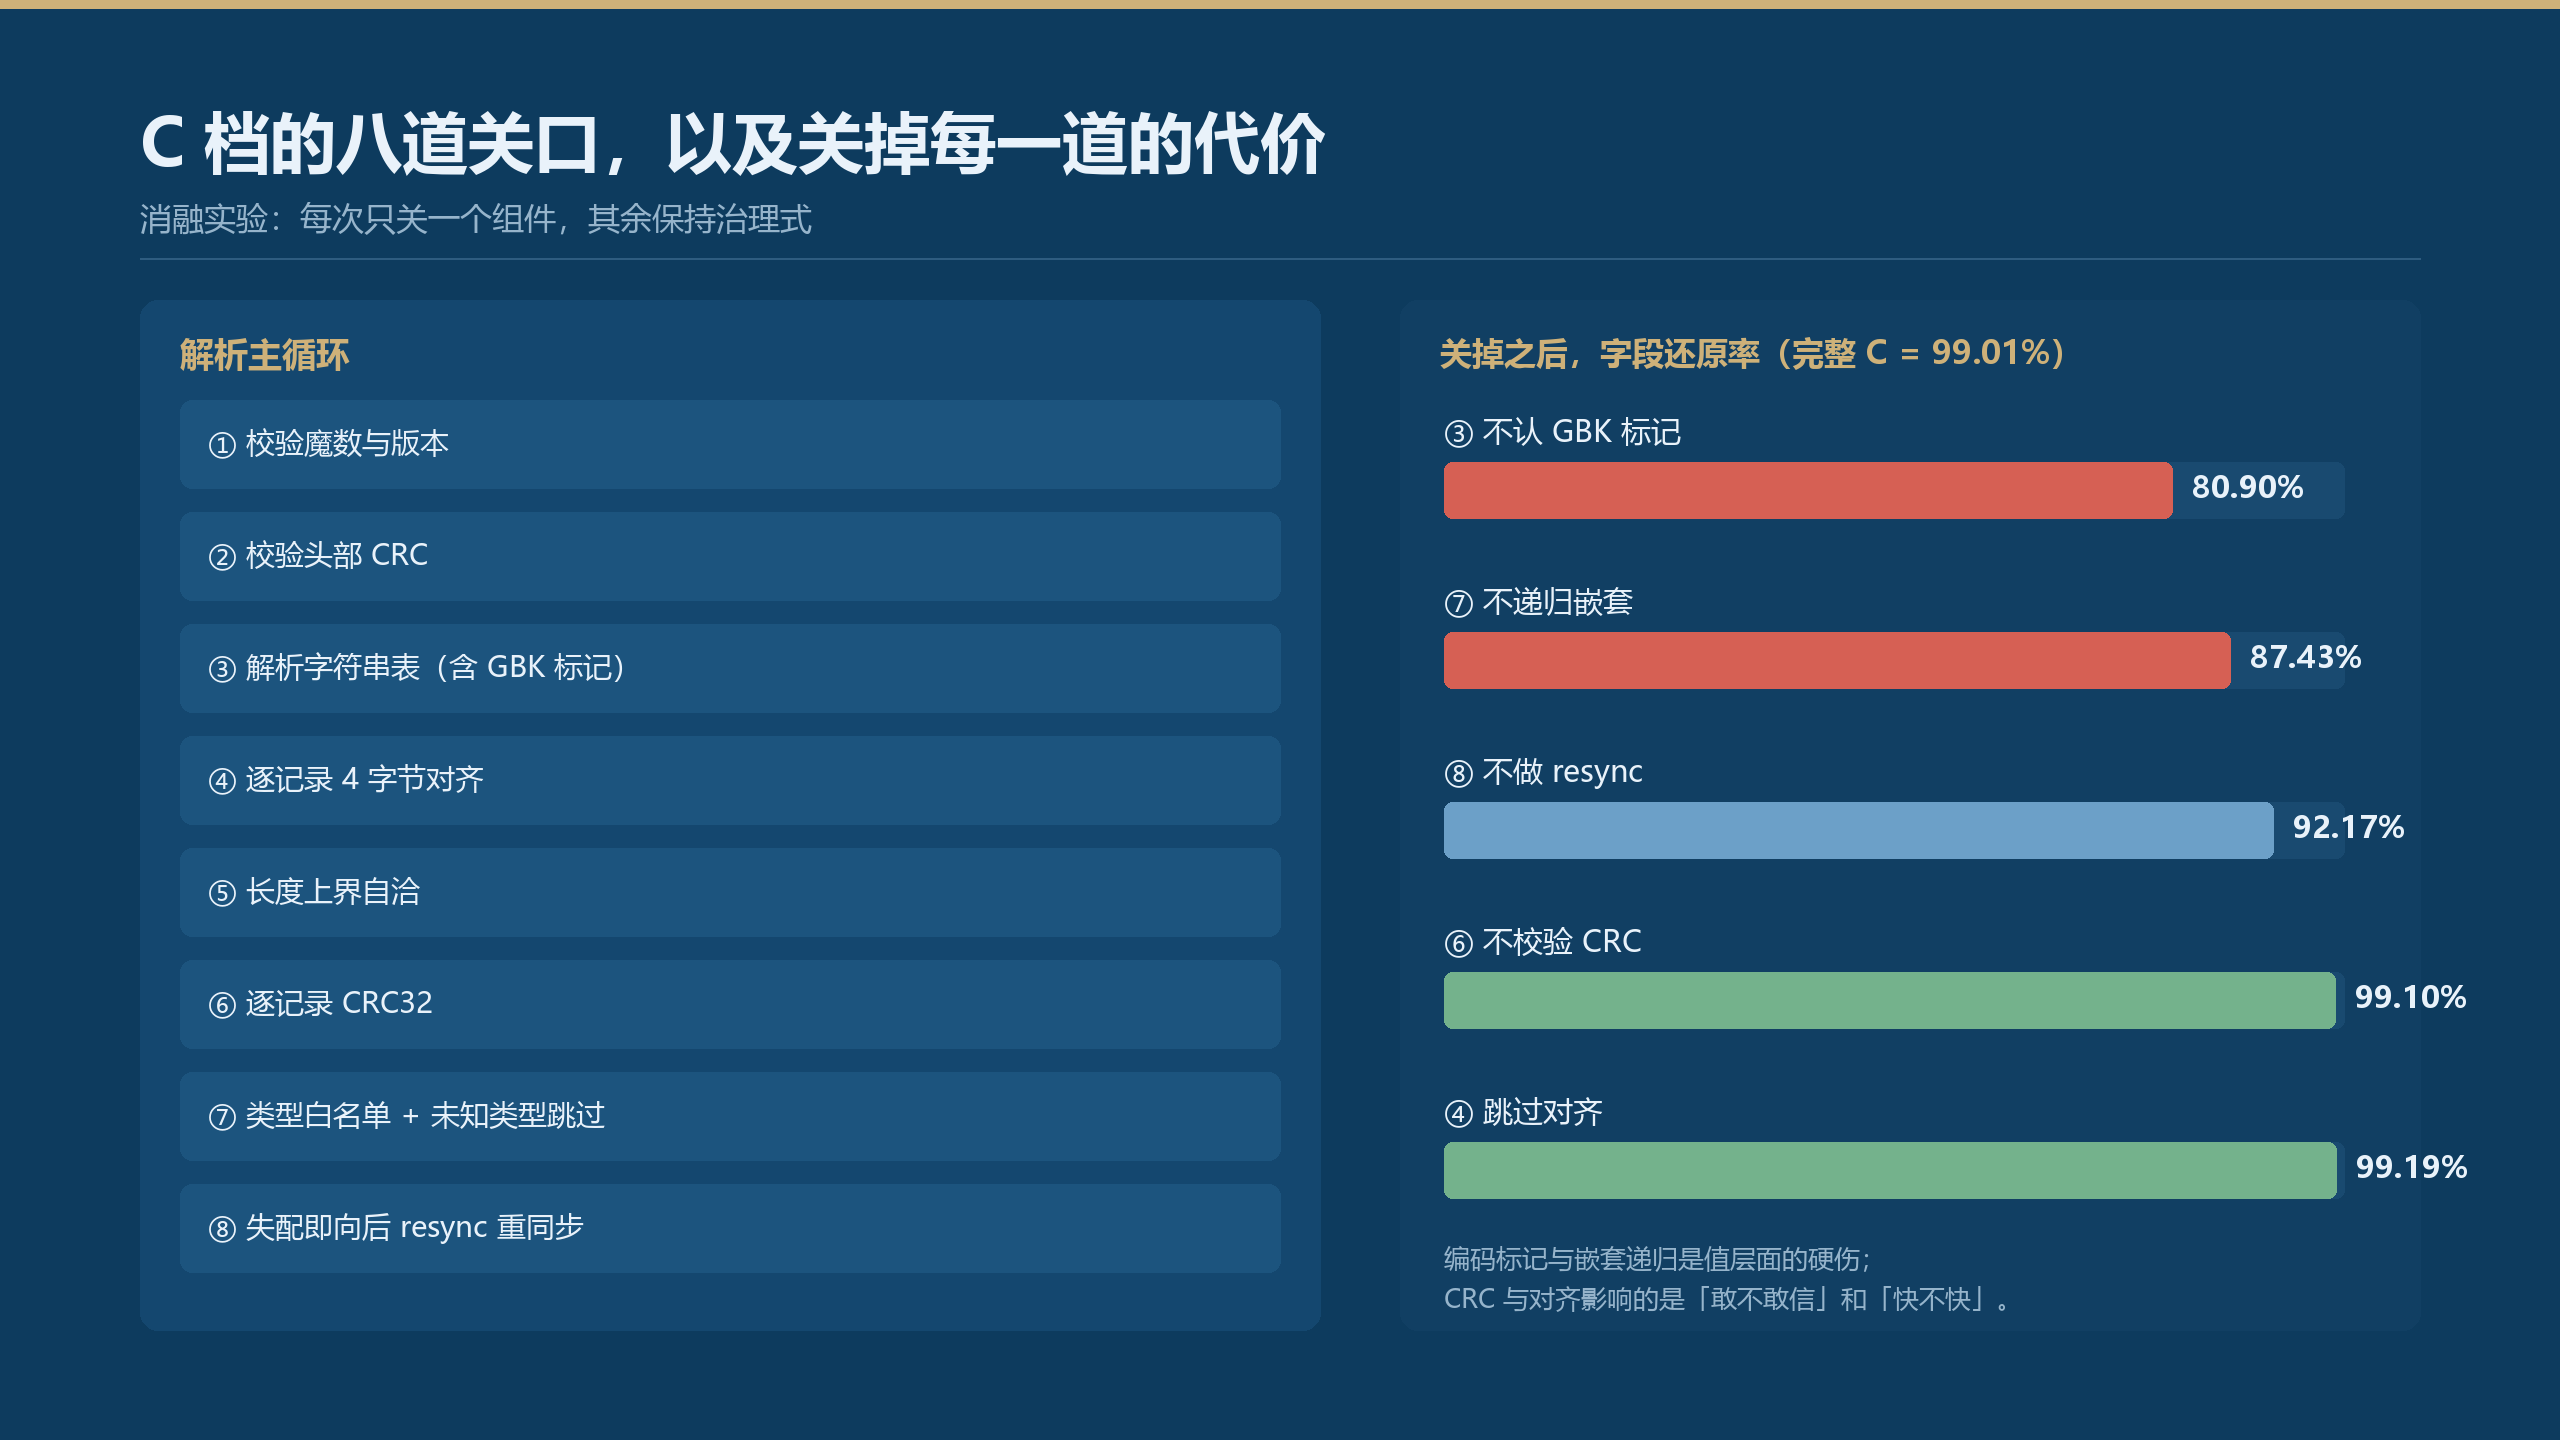
治理式解析在 B 档基础上加八道关口:魔数与版本校验、头部 CRC、字符串表编码标记、逐记录 4 字节对齐、长度上界自洽、逐记录 CRC32、类型白名单、失配即向后 resync 重同步。
@@FIG3@@
结果:记录召回 99.13%、字段还原 99.01%、静默错值 65 条——且这 65 条全部落在被翻转字节的损坏记录上,全部被隔离上报,没有一条假装正常。
四、真实数据对比
指标 | A 固定步长 | B 半治理 | C 治理式 |
|---|---|---|---|
记录精确率 | 64.37% | 100% | 100% |
记录召回率 | 5.42% | 92.67% | 99.13% |
F1 | 9.99 | 96.19 | 99.56 |
字段还原率 | 4.82% | 64.54% | 99.01% |
静默错值 | 320 | 15,236 | 65(全部隔离) |
CRC 损坏记录处置 | 0/218 | 4/218 | 216/218 |
受损文件打捞率 | 4.98% | 53.72% | 97.02% |
耗时(280 文件) | 0.32 s | 0.296 s | 0.427 s |
吞吐 | 13.5 MB/s | 14.6 MB/s | 10.1 MB/s |
C 档比 B 档慢 0.13 秒(280 个文件、4.32 MB),买回来的是 28.5 个百分点的字段还原率和 15,171 条被消灭的静默错值。
一个具体的文件能说明差距:pack_0036.blpx(14,156 字节,真值 161 条,长度字段被改大 3 处)。A 档解析出 13 条、对 9 条;B 档在第一条坏长度处直接放弃,剩 146 条全丢;C 档恢复 151 条且 151 条全部正确,2 条隔离上报。
五、可复制代码:核心行走器
记录行走的主循环(对齐、上界校验、CRC、resync):
TYPE_OK = {1, 2, 3, 4, 5, 6}

def find_next(buf, start, end):
    """失配后向后扫描:类型合法 + 长度自洽 + CRC 命中才算可信头"""
    for p in range(start, min(end - 8, start + 200000)):
        t = buf[p]
        if t not in TYPE_OK:
            continue
        rf = buf[p + 1]
        rid, plen = struct.unpack_from("<HI", buf, p + 2)
        if plen > 8 * 1024 * 1024 or p + 8 + plen > end:
            continue
        if rf & 1:                      # 带 CRC 的记录必须 CRC 命中
            if p + 12 + plen > end:
                continue
            want = struct.unpack_from("<I", buf, p + 8 + plen)[0]
            if zlib.crc32(buf[p + 8:p + 8 + plen]) & 0xFFFFFFFF != want:
                continue
        return p
    return None

def walk(data, pos, end, st, out, quar):
    while pos + 8 <= end:
        pos += (-pos) & 3               # 绝对偏移 4 字节对齐
        if pos + 8 > end:
            break
        t, rf = data[pos], data[pos + 1]
        rid, plen = struct.unpack_from("<HI", data, pos + 2)
        if t not in TYPE_OK:            # 未知类型:向前重同步,不放弃整文件
            nxt = find_next(data, pos + 1, end)
            if nxt is None:
                break
            pos = nxt
            continue
        need = 8 + plen + (4 if rf & 1 else 0)
        if plen > 8 * 1024 * 1024 or pos + need > end:
            quar.append({"rid": rid, "reason": "len_oob"})
            nxt = find_next(data, pos + 1, end)
            if nxt is None:
                break
            pos = nxt
            continue
        payload = data[pos + 8:pos + 8 + plen]
        if rf & 1:
            want = struct.unpack_from("<I", data, pos + 8 + plen)[0]
            if zlib.crc32(payload) & 0xFFFFFFFF != want:
                quar.append({"rid": rid, "reason": "crc"})   # 隔离,不产出猜测值
                pos += need
                continue
        out.append((rid, t, payload))
        pos += need
字符串表:长度字节的最低位是编码标记,必须先摘掉再算长度:
def load_strtab(raw):
    items, pos = [], 0
    while pos < len(raw):
        hdr, pos = read_varint(raw, pos)     # 标准 LEB128,7 位一组
        blen, enc = hdr >> 1, hdr & 1        # 最低位是编码标记
        chunk = raw[pos:pos + blen]
        pos += blen
        items.append(chunk.decode("gbk") if enc else chunk.decode("utf-8"))
    return items
六、消融:每一道关口值多少分
每次只关掉一个组件,其余保持治理式:
关掉的关口 | 字段还原率 | 静默错值 | 说明 |
|---|---|---|---|
完整 C 档 | 99.01% | 65 | 基准 |
不认 GBK 标记 | 80.90% | 9,875 | 值层面硬伤,键名错位 |
不递归嵌套 | 87.43% | 6,336 | 28,872 条子记录整块丢失 |
不做 resync | 92.17% | 56 | 坏记录之后全文件放弃 |
不校验 CRC | 99.10% | 274 | 召回率反而升到 99.61% |
跳过对齐 | 99.19% | 65 | 耗时 0.427 s 到 0.828 s(约 1.94 倍) |
两个反直觉的发现值得单独说:
其一,CRC 是召回率的"敌人"。 关掉 CRC 后召回率从 99.13% 升到 99.61%,因为原本被隔离的 218 条损坏记录不再被拦截、直接进了输出。指标变好看了,静默错值却翻了 4 倍。如果只用召回率考核解析器,最优解恰恰是关掉所有校验。
其二,对齐不是精度问题,是性能问题。 跳过对齐后精度几乎不变(99.19%),因为 resync 会兜底重扫——但代价是每条错位记录都要触发一次向后扫描,耗时翻倍。resync 在本实验中共触发 103 次、累计扫描 18,296 字节(占语料 0.42%),恢复成本极低,但它是最后防线,不该当日常路径用。
七、踩坑清单
- 变长格式上永远不要用固定步长。第一条蒙对只是运气,错位之后解析器不会报错,只会安静地给错值;
- 字符串表的编码标记是长度的一部分。先
hdr >> 1再取长度,最低位单独判编码;GBK 按 UTF-8 硬解一次就错位 9,195 条; - 多字节 varint 必须按 7 位一组循环。本实验数值 scale 1000 后几乎全部超过 127,单字节 varint 全军覆没;
- 一个文件里允许两种字节序。块内部大端、容器小端是历史遗留的常态,解长度前先确认端序;
- 嵌套记录的头结构往往和顶层不同(子记录 u16 长度 vs 顶层 u32),复用同一个解头函数会把两种格式解串;
- 校验会拉低召回率,但那是它的工作。被 CRC 拦下的记录不是"损失",是"真相";
- 隔离要留痕。每条被隔离的记录都记 rid 和原因(crc / len_oob / parse),对账时才知道窟窿在哪;
- 截断文件的真值要按"完整落在文件内"裁剪,否则你在惩罚一个无能为力的解析器。
八、给 WorkBuddy 的提示词模板
遇到"帮我把这批二进制文件解析出来"时,可以直接用这个模板:
请按以下步骤解析 <目录> 下的二进制文件:
1. 先侦察:读 3 个样本的前 256 字节,确认魔数、头部字段、记录结构假设;
2. 生成真值:先解析 5 个最小文件,人工核对记录数与抽样字段后再全量跑;
3. 三档对比:定长步长版 / 纯 TLV 版 / 带校验恢复版,输出召回率、字段还原率、静默错值数;
4. 校验关口:头部 CRC、逐记录 CRC、长度上界、对齐、未知类型跳过、失配 resync;
5. 损伤处置:损坏记录一律隔离并写明原因,禁止产出猜测值;
6. 交付:解析结果 + 隔离清单 + 三档指标对比表。
九、收尾
二进制解析的分数不是靠"能读出来"挣的,是靠"知道哪一条不能信"挣的。0.296 秒的 B 档和 0.427 秒的 C 档,差的不是速度,是 15,171 条被无声吞掉的错值。下一次写解析器,先问自己三个问题:对齐处理了吗?编码标记认了吗?坏了之后是停下、隔离、还是继续往前走?
(本文语料、解析脚本、真值与全部指标均为本地实测产出,可在 WorkBuddy 会话中一键复现。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号