#WorkBuddy# 12 万行网关日志对账:42,083 个配对里 23,050 个是错的,我怎么把它做到 98.91
原创
#WorkBuddy# 12 万行网关日志对账:42,083 个配对里 23,050 个是错的,我怎么把它做到 98.91
原创
用户12784192
发布于 2026-11-02 13:12:03
发布于 2026-11-02 13:12:03
上周帮朋友看一个"接口耗时统计"的问题。他有一套按小时轮转的网关日志,想把每个请求的端到端耗时算出来,做个 P95 报表。
脚本不长,两百行,跑起来也不报错,三秒出结果。但报表里的 P95 是 1,842 ms,而监控平台上是 310 ms。他怀疑监控不准。
我让他把脚本给我看,第一眼就发现问题:脚本确实没报错,但它 45% 的配对是错的。两个日志行拼在一起,看起来天衣无缝,算出来的数字却根本不是同一个请求的耗时。
这种错最要命——它不抛异常,不入错误日志,只是安静地给你一个错误答案。
我把这件事完整复现了一遍:自建 27 个日志文件、122,324 行、61,200 条请求,用三档方案跑同一批数据,把每一档的配对精确率、召回率、耗时准确率全部算出来。本文所有数字都是真实跑批结果,脚本和语料生成器都可复现。
一、先说结论:三档方案的差距
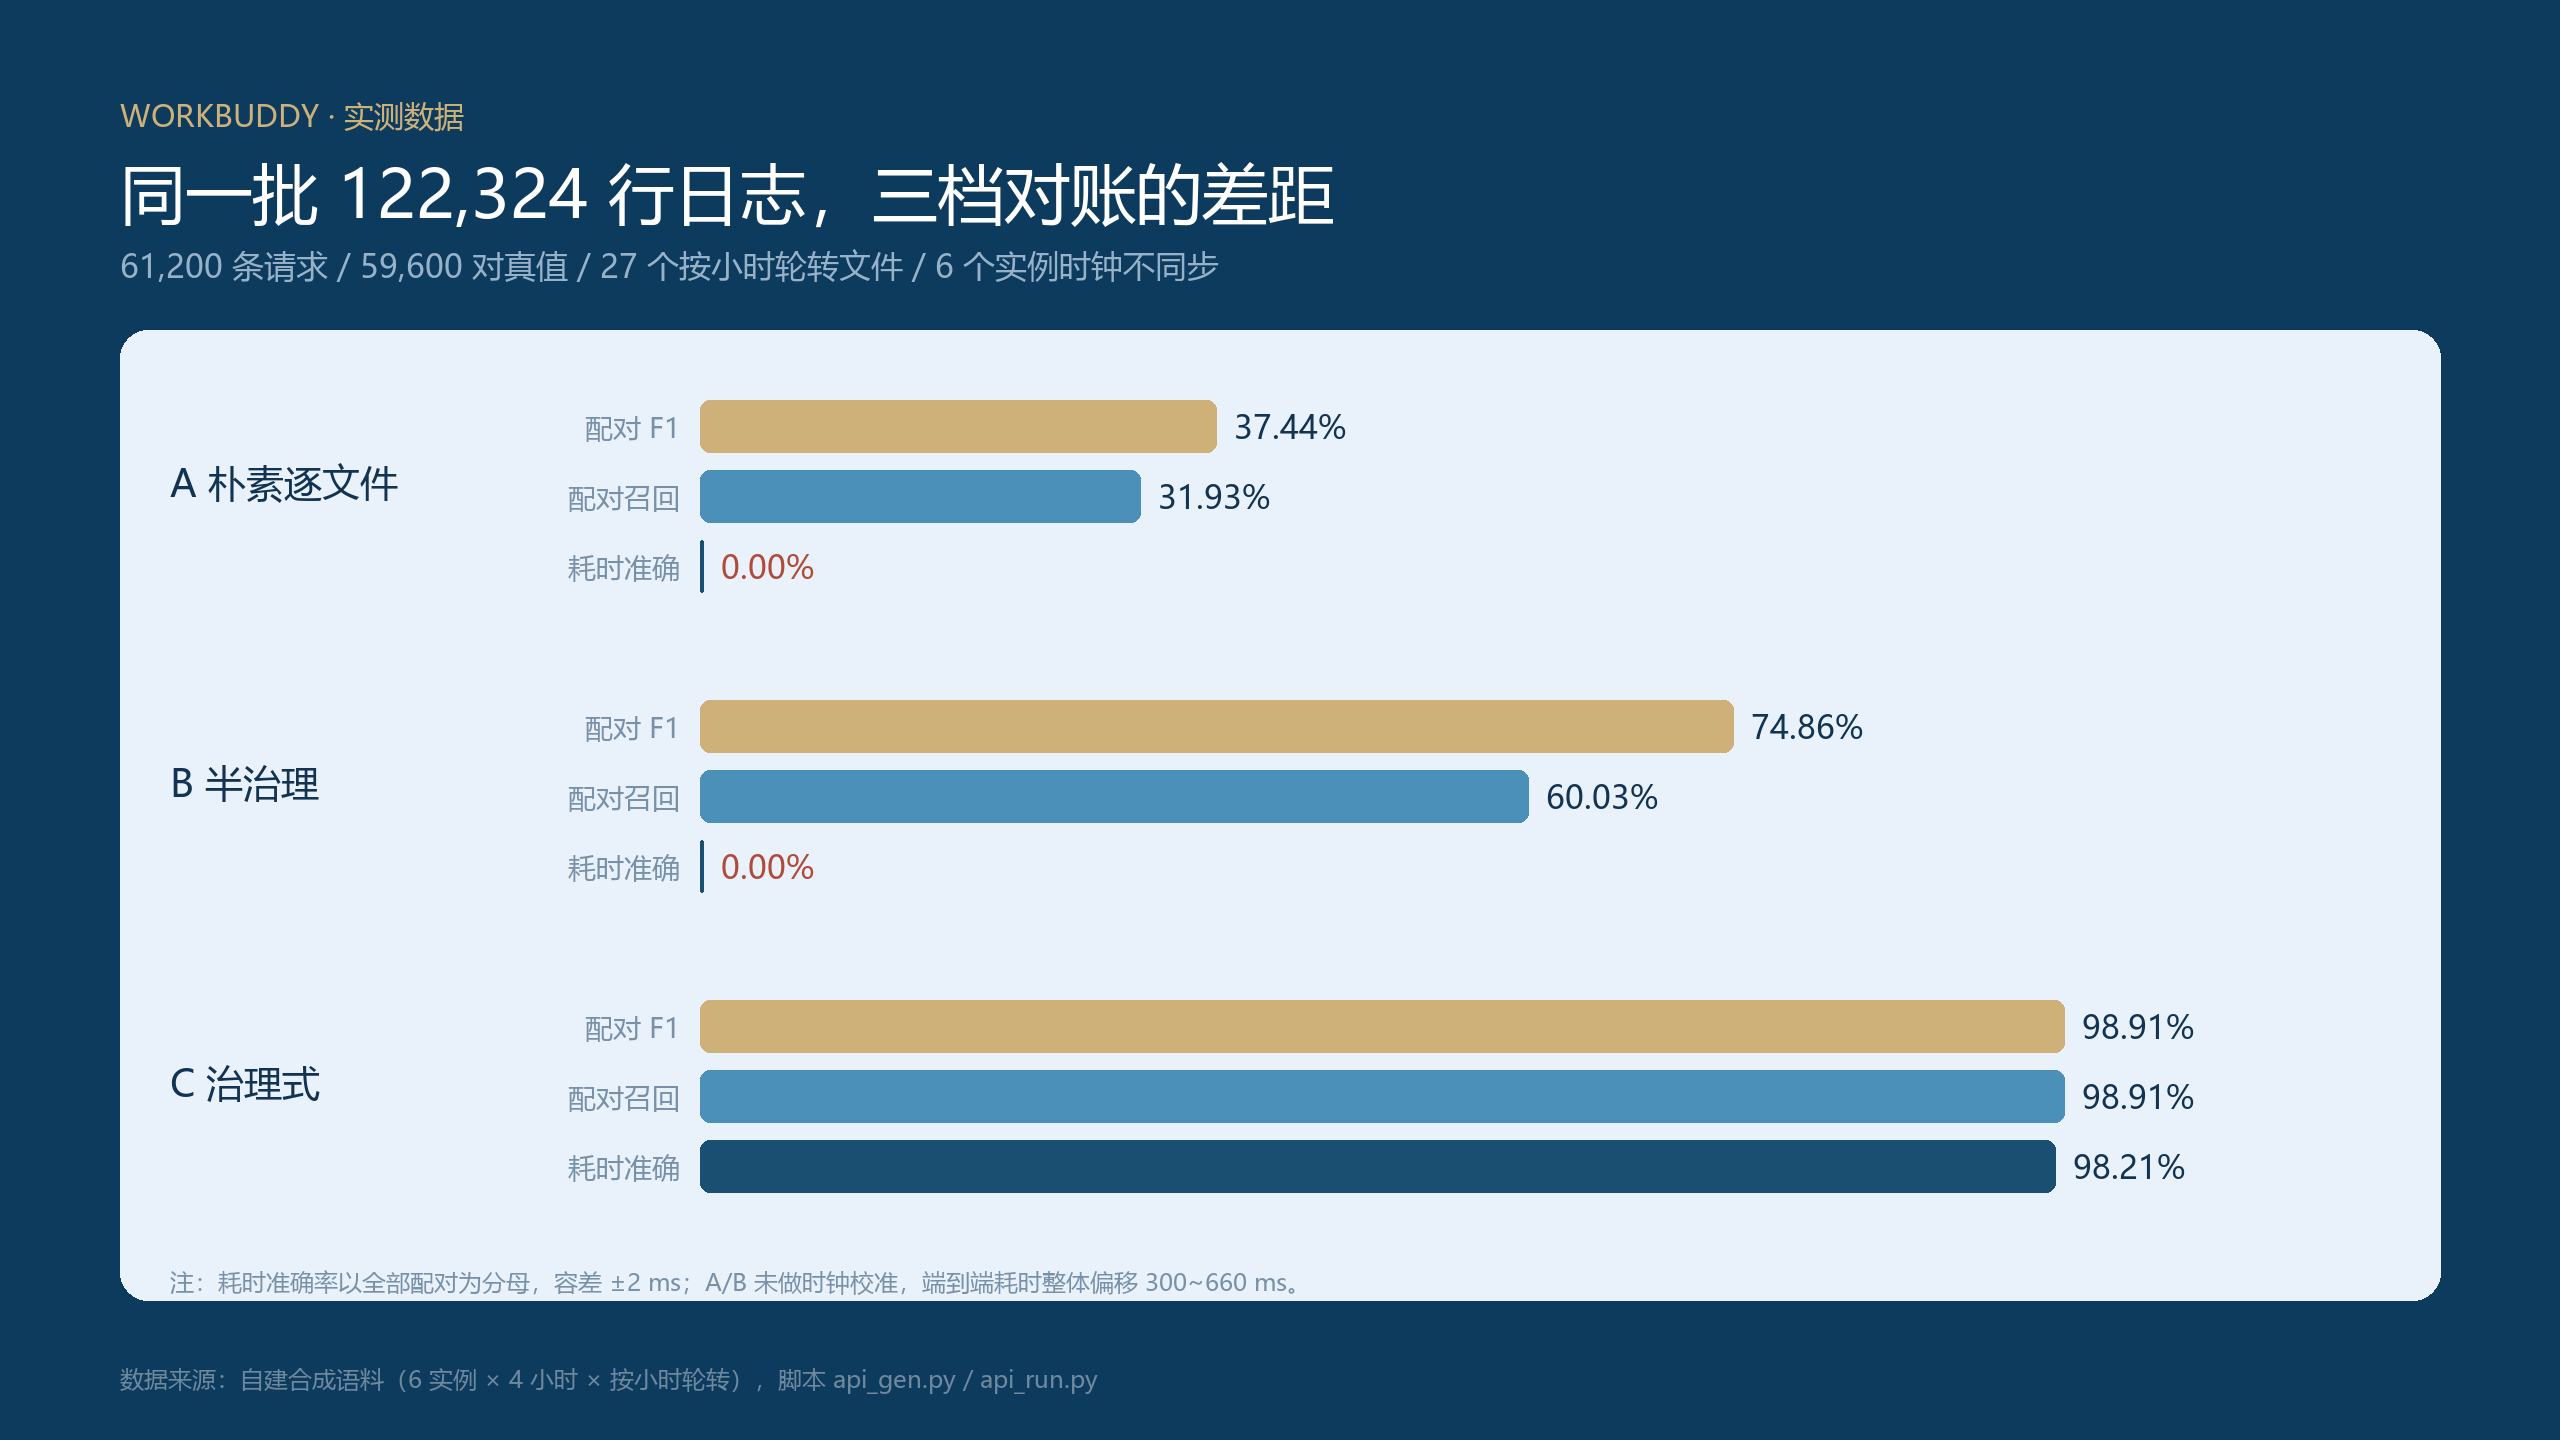
同一批 122,324 行日志,三档方案的结果:
档位 | 配对输出 | 配对精确率 | 配对召回率 | 配对 F1 | 耗时准确率 | 错配条数 | 耗时 |
|---|---|---|---|---|---|---|---|
A 逐文件栈配对 | 42,083 | 45.23% | 31.93% | 37.44 | 0.00% | 23,050 | 0.278 s |
B 全局 dict 按 tid | 35,980 | 99.44% | 60.03% | 74.86 | 0.00% | 203 | 0.303 s |
C 六道关口 | 59,600 | 98.91% | 98.91% | 98.91 | 98.21% | 652 | 0.877 s |
三个数字值得单独拎出来说:
- A 档输出了 42,083 个配对,其中 23,050 个是错的,占 54.8%。它照样能算出一个 P95,只是那个数字没有意义。
- A 和 B 的"耗时准确率"都是 0.00%。不是接近 0,是一个都没对上。原因很简单:它们的系统偏差中位数是 362 ms 和 364 ms,而我判定耗时准确的标准是 ±2 ms。
- C 档没有把准确率做到 100%,98.91% 就是真实水平。剩下那 1.09% 我下面会交代清楚是什么,不藏。
二、语料与真值:先让结果可判定
要证明"配对对不对",必须有真值。所以这批日志是我按已知规则生成出来的,每一条请求从出生就带着答案。
- 规模:6 个实例 × 4 小时,按小时轮转,27 个文件,122,324 行,10.08 MiB
- 请求:61,200 条(60,000 条基础 + 1,200 条重试),响应 60,500 条
- 真值配对:59,600 对
- 缺失响应(超时/崩溃没回):1,600 条
- 孤儿响应(trace 在日志里找不到请求):900 条
- 重复采集(同一行被采了两遍):600 条
- 补录文件(延迟落盘):300 条
- 重试组(同一 trace 两条 REQ):1,200 组
- 实例时钟偏移:-665 ms 到 +512 ms,绝对值均值 421.5 ms,漂移率 1~3 ms/h
刻意埋进去的脏法有六类:跨整点落盘、文件内相邻行逆序(模拟并发写,8% 概率)、tid 大小写/0x 前缀变体(11% 的响应行)、同 trace 双请求、重复采集、双时钟源。
三、根因:五个错位叠在一起
1. 文件内乱序,把 heapq.merge 的前提打穿了
这一条是我第一次跑就踩进去的,也是最隐蔽的。
多文件归并的标准写法是 heapq.merge(*streams, key=...)。它有一个不会写在文档首页的前提:每一路输入流内部必须已按 key 有序。而网关是并发写日志的,同一文件里相邻两行的顺序本来就可能颠倒——我的语料里给了 8% 的相邻交换概率。
后果不是"这一行位置略偏",而是这一行会被推迟到整个归并流的末尾附近。因为它比流里已经输出的位置更小,归并器只能等所有流都推过这个值,才轮到它。
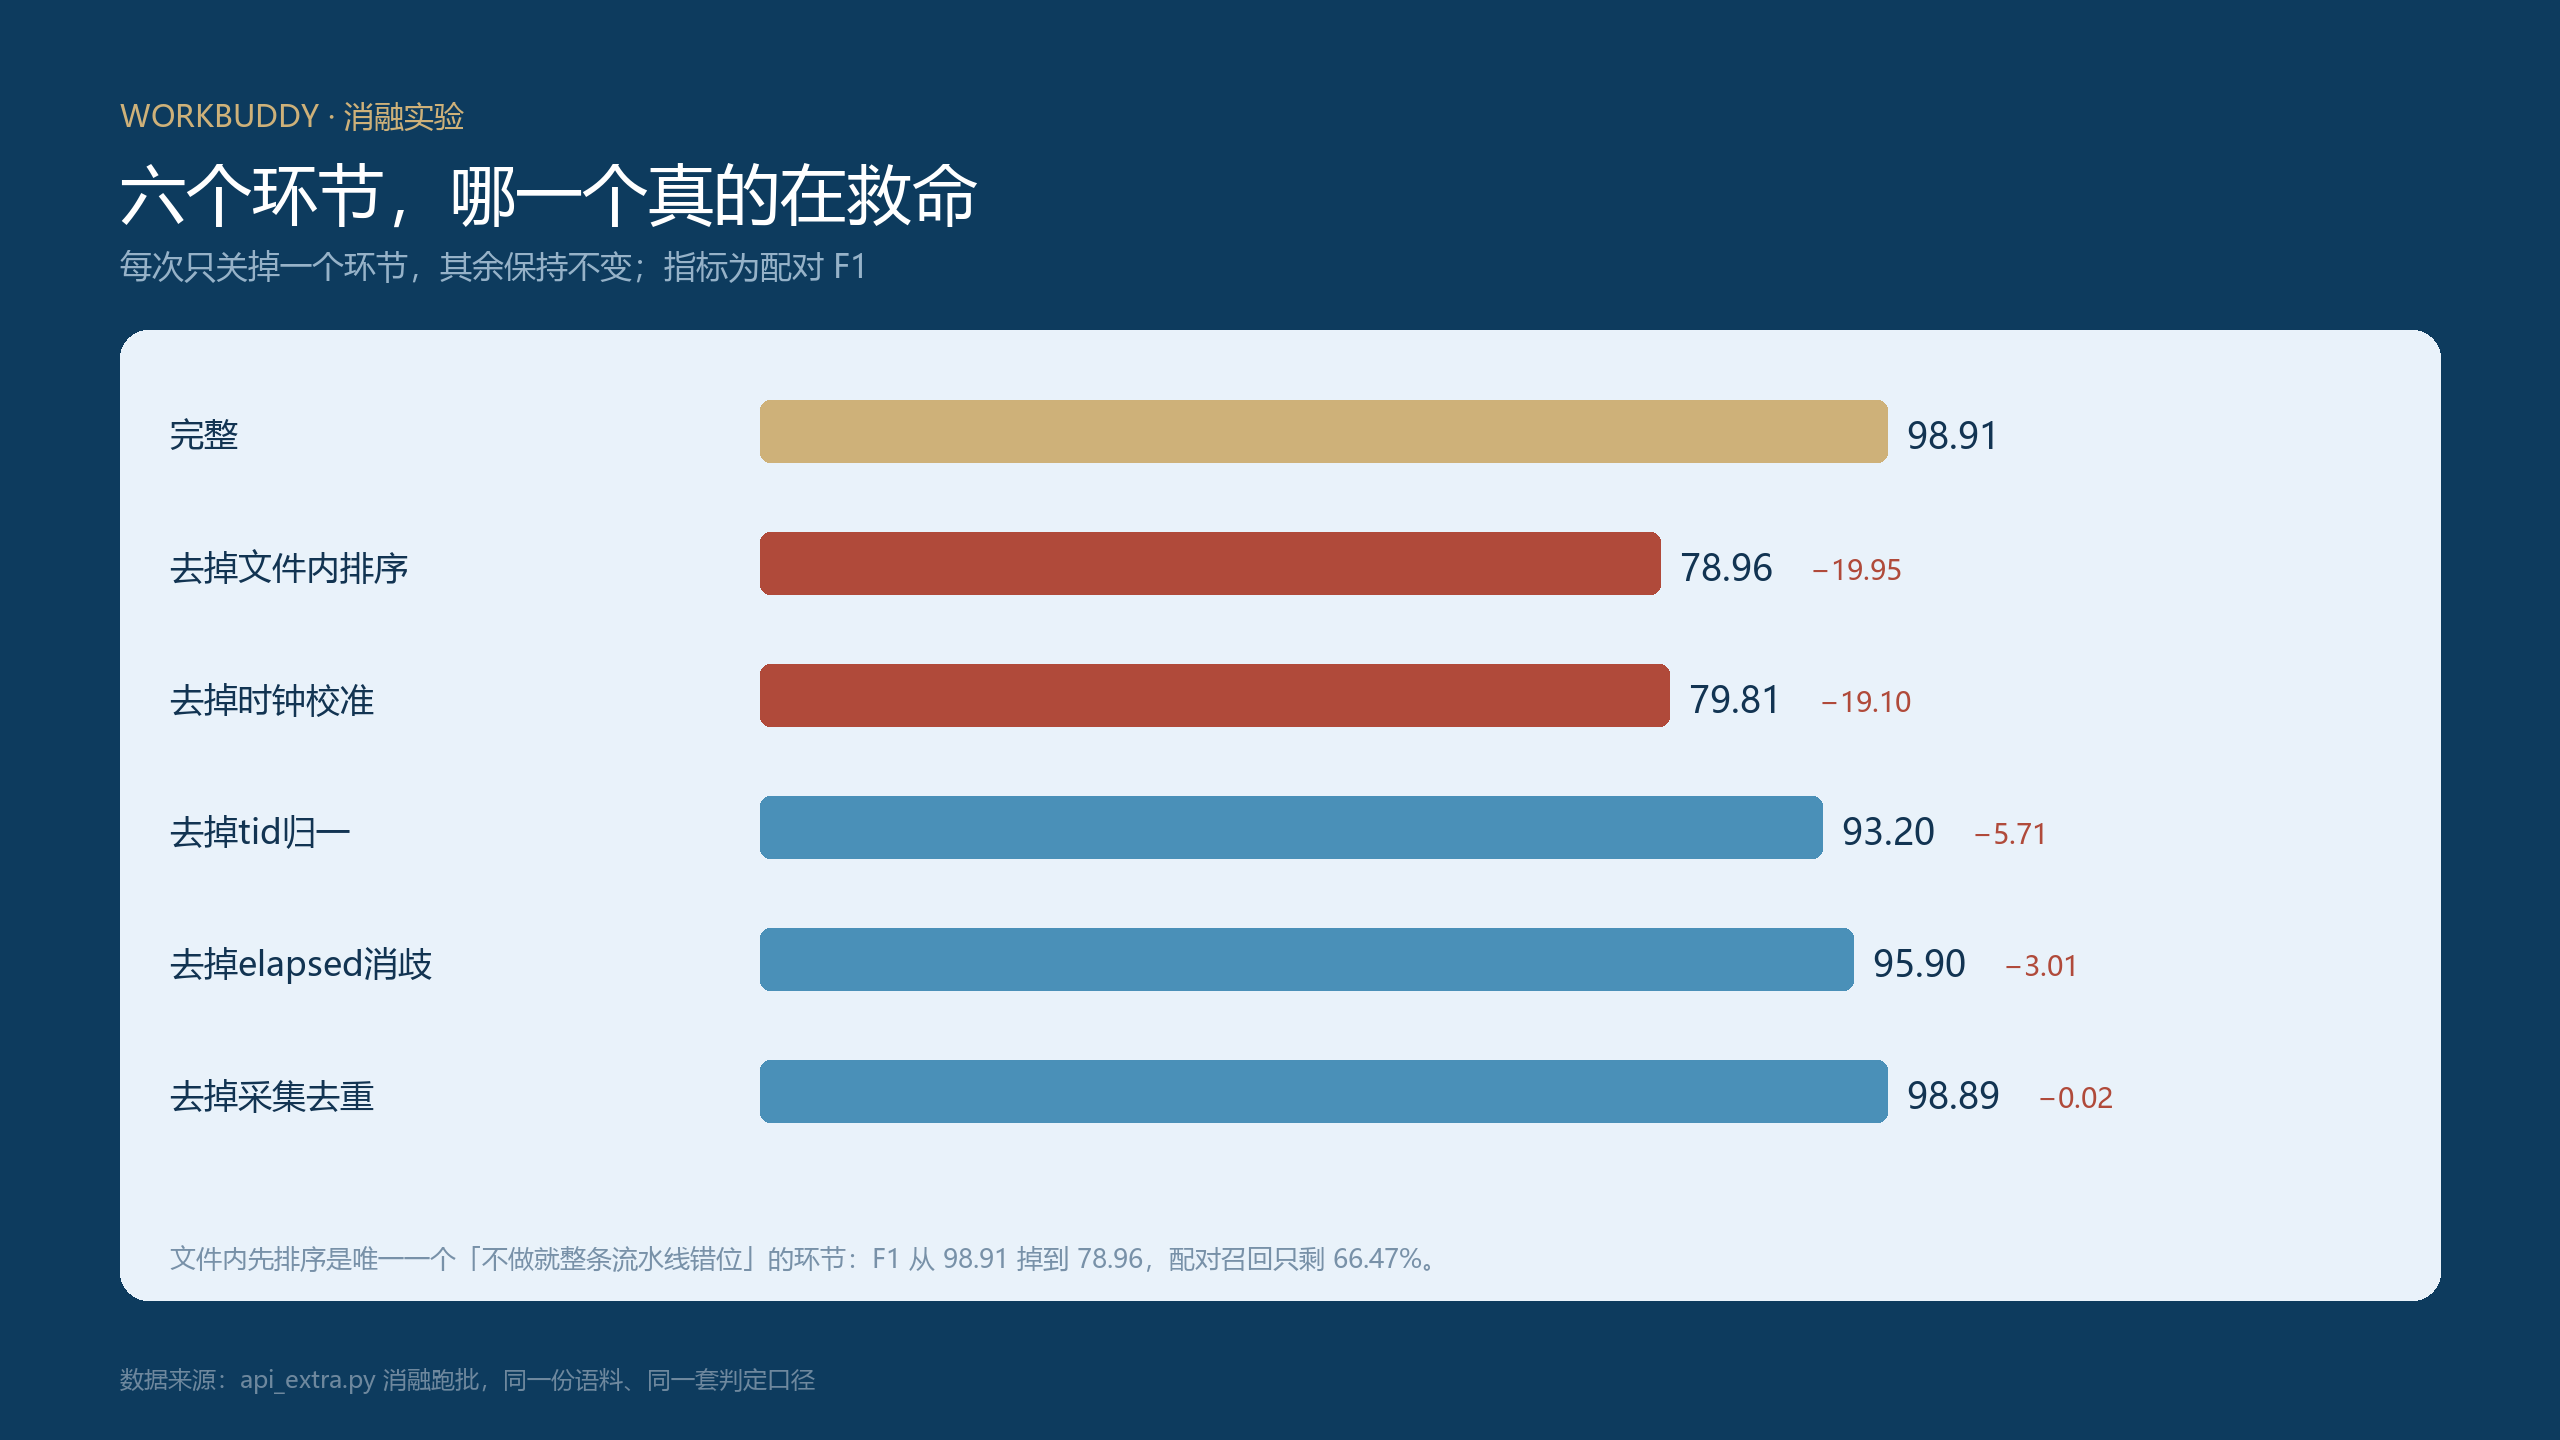
实测:不排序直接归并,配对召回 66.47%,F1 78.96;每个文件先 sort 再归并,F1 98.91。
差值 19.95 个点,全部来自"文件内先排一次序"这一行代码。
2. 双时钟源:只有一半的行该减偏移
这条是我第二版才发现的,而且发现方式很难看:第一版跑出来 F1 只有 64.62%,系统偏差中位 364 ms。
原因是我写了一句"统一校时":把每一行的时间都减去它所在实例的时钟偏移。听起来很合理,实际完全错——REQ 行是网关自己打的,本来就在网关时钟上;只有 RESP 行是后端实例打的,才带实例时钟偏移。
把 REQ 行也减一遍,等于凭空给它加了一个负偏移。偏差恰好等于该实例的偏移量,所以中位 364 ms 和偏移均值 421.5 ms 是同一个数量级。
改法只有一行:只对 kind == "RESP" 的行做校时。
3. tid 归一:11% 的响应行本来就配不上
网关写的 trace_id 是小写十六进制,后端实例写的可能是全大写,也可能是 0x 前缀。我的语料里给了 8% 大写、3% 带前缀。
按原始字符串做字典键,这 11% 的响应全部变成孤儿,对应的请求全部变成"缺失"。实测:不做归一,配对召回 88.10%,F1 93.20%,孤儿报告从 900 涨到 7,425。
归一函数三行:
def norm_tid(s: str) -> str:
    if s[:2].lower() == "0x":
        s = s[2:]
return s.replace("-", "").lower()注意顺序:先去前缀,再去连字符,最后转小写。反过来的话大写的 0X 前缀会留在字符串里。
4. 同一 trace 两条 REQ:字典会被覆盖,FIFO 会错配
客户端超时会重发,同一个 trace_id 在日志里就有两条 REQ。
用 dict[tid] = req 的写法,第二条直接把第一条盖掉。B 档就是这么干的:错配只有 203 条,但配对召回掉到 60.03%——每条被覆盖的请求,都带走了它自己的响应。
换成 deque 保留多条之后,还有个坑:FIFO 会错配。因为重试后的第二条请求往往很快就返回了(我给的分布是 50~400 ms),而第一条慢请求要 2~4 秒才返回。按到达顺序先来先配,会把"快响应"配给"慢请求",两个都算错。
我用 RESP 行自带的 elapsed(实例内耗时)做一致性消歧:在同一 trace 的多条候选请求里,选 |实际间隔 - elapsed| 最小的那条。
实测:895 组解出,305 组因为没有 elapsed 无法判定(我的语料里 25% 的响应行 elapsed 是 -)。这 305 组就是最后那 652 条错配的主要来源。
这 1.09% 我没有强行修掉。工程上它属于"日志信息不足,不可判定",正确做法是打标进人工复核队列,而不是猜一个看起来合理的答案。消融实验也印证了:去掉 elapsed 消歧,F1 从 98.91 掉到 95.90。
5. 重复采集:600 条一模一样的行
采集侧重发会把同一行写两遍。不处理的话,第二条会配给下一条同 tid 的请求,或者变成孤儿。实测:不做去重,孤儿报告从 900 涨到 1,500,多出来的 600 条全是重复行。
去重键用 (tid, 秒级时间, 状态码),不用整行哈希——整行哈希对字段顺序变化太敏感。
6. 末小时外推:97.17% 就是这么来的
分小时看耗时准确率:0h 100%、1h 100%、2h 100%、3h 97.17%。
原因很朴素:校时靠心跳行插值,而最后一个小时之后没有下一个心跳点,只能拿最后已知偏移做外推。漂移率 1~3 ms/h,外推一小时就是 1~3 ms 的误差,正好卡在 ±2 ms 判定线的两侧。
这不是 bug,是数据边界。想消掉它只能让心跳更密,或者接受末段精度略降。
四、六道关口
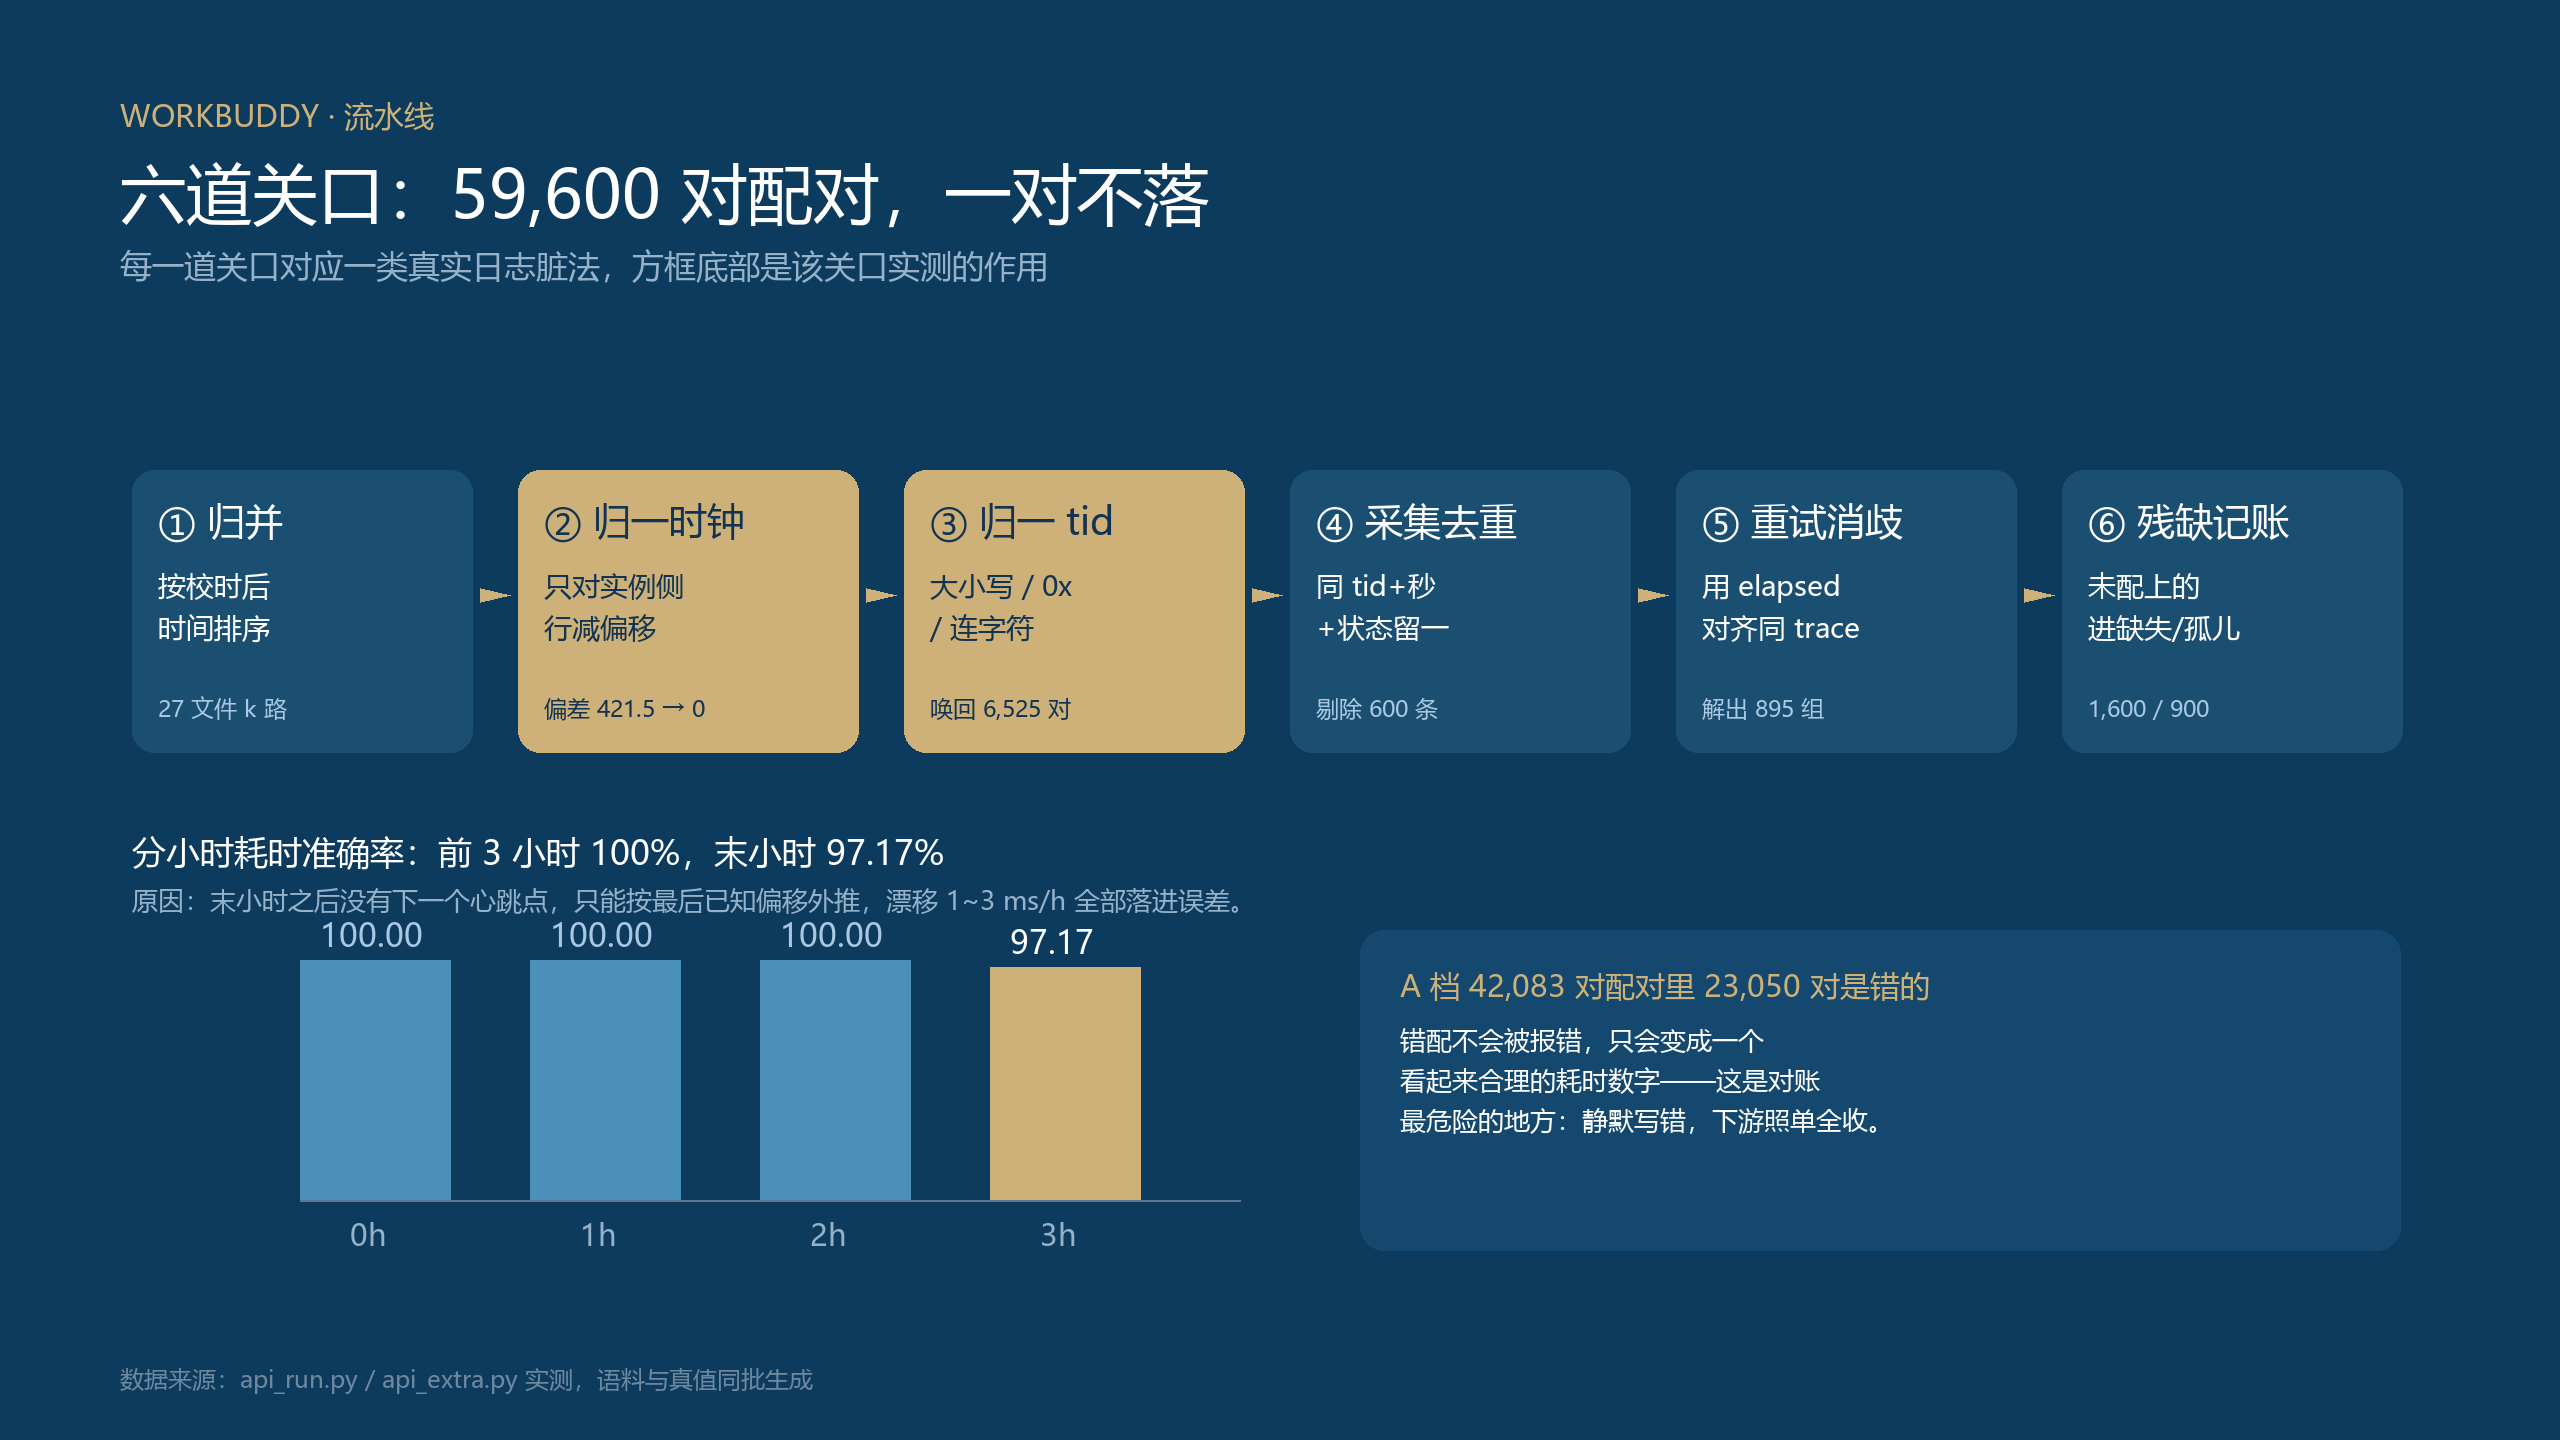
按顺序:
- 文件内先排序,再 k 路归并(否则归并前提不成立)
- 只对实例侧的行校时,偏移用前后两个心跳线性插值
- tid 归一(去
0x、去连字符、转小写) - 采集去重(
tid + 秒级时间 + 状态码) - 重试消歧(用
elapsed做最小残差匹配) - 残缺记账(未配上的请求进"缺失"、未配上的响应进"孤儿",绝不静默丢弃)
第 6 条容易被忽略,但它决定了对账结果可解释:一份对账报告如果只说"配上了 59,600 对",你没法判断剩下 1,600 条去哪了。必须让每一行都有归宿。
五、可复制的核心代码
下面这段是六道关口的主循环,去掉了解析和统计部分:
import heapq, bisect
from collections import defaultdict, deque

def reconcile(files, hb_map, window_ms=300_000):
    """
    files: 已按小时归档排序的日志文件列表
    hb_map: {host: [(local_ts, skew_ms), ...]} 心跳校准点,需已排序
    """
    def skew_of(host, ts):
        arr = [x[0] for x in hb_map[host]]
        val = [x[1] for x in hb_map[host]]
        i = bisect.bisect_left(arr, ts)
        if i == 0:
            return val[0]
        if i >= len(arr):
            return val[-1]                      # 末段外推:精度会略降
        t0, t1 = arr[i - 1], arr[i]
        v0, v1 = val[i - 1], val[i]
        if t1 == t0:
            return v0
        return v0 + (v1 - v0) * (ts - t0) / (t1 - t0)

    def stream(fn):
        rows = []
        for r in read_rows(fn):                 # 返回 dict(ts, host, kind, tid, status, elapsed)
            if r["kind"] == "RESP":
                # 关键:只有后端实例写的行才在实例时钟上
                rows.append((r["ts"] - skew_of(r["host"], r["ts"]), r))
            else:
                rows.append((r["ts"], r))
        rows.sort(key=lambda x: x[0])           # 关键:文件内必须先排序
        return rows

    pairs, missing, orphan = [], [], []
    pending = defaultdict(deque)
    seen = set()

    for gw_ts, r in heapq.merge(*[stream(f) for f in files], key=lambda x: x[0]):
        if r["kind"] == "HB":
            continue
        tid = norm_tid(r["tid"])
        if r["kind"] == "REQ":
            pending[tid].append((gw_ts, r["lid"]))
            continue

        key = (tid, round(gw_ts), r["status"])
        if key in seen:                         # 采集重复
            continue
        seen.add(key)

        dq = pending.get(tid)
        if not dq:
            orphan.append(r["lid"])
            continue

        # 同 trace 多条 REQ:用实例内耗时做最小残差消歧
        best = 0
        if len(dq) > 1 and r["elapsed"] is not None:
            best = min(range(len(dq)),
                       key=lambda i: abs((gw_ts - dq[i][0]) - r["elapsed"]))

        q_ts, q_lid = dq[best]
        delta = gw_ts - q_ts
        if delta > window_ms or delta < -2:
            del dq[best]
            missing.append(q_lid)
            orphan.append(r["lid"])
            continue

        del dq[best]
        pairs.append((q_lid, r["lid"], round(delta)))

    for dq in pending.values():                 # 收尾也必须记账
        for _, lid in dq:
            missing.append(lid)
    return pairs, missing, orphan
跑批性能:122,324 行、27 个文件,C 档 0.877 秒,约 13.9 万行/秒。其中解析占大头,配对逻辑本身不到 0.3 秒。
六、踩坑清单
坑 | 表现 | 后果 | 修法 |
|---|---|---|---|
文件内乱序直接归并 | 不报错,结果整体错位 | F1 −19.95 | 每文件先 |
给所有行统一减时钟偏移 | 耗时为负、偏差约等于偏移量 | 召回 64.62% | 只对 |
tid 未归一 | 孤儿数暴涨 | 召回 −10.81 | 去 |
| 静默丢请求 | 召回 60.03% | 用 |
多条 REQ 用 FIFO 配对 | 快响应配给慢请求 | 错配约 600 | 用 |
不去重采集重复行 | 孤儿多 600 条 | 精确率微降、账不平 |
|
末小时无后续校准点 | 该时段耗时偏移 1~3 ms | 准确率 97.17% | 加密心跳或标注精度 |
未配上的一扔了之 | 报告"配上了 59,600 对" | 无法对账 | 缺失/孤儿分别记账 |
最后一条是我最想强调的:对账工具的价值不只在于配对了多少,更在于没配上的那些能不能被解释。
七、给 WorkBuddy 的提示词模板
这类活我一般不自己从头写,直接把约束讲清楚让 WorkBuddy 起框架,然后自己盯要点。下面这段可以直接用:
# 提示词模板:日志对账脚本
帮我写一个日志请求-响应对账脚本,输入是多个按小时轮转的 .log 文件,每行格式:
时间|主机|类型(REQ/RESP/HB)|trace_id|字段5|字段6|字段7

硬性要求:
1. 每个文件内部先按时间排序,再做 k 路归并(多线程写日志会导致行序颠倒,
   直接 merge 会让逆序行被推迟到流末尾)
2. 只有 RESP 行的时钟是后端实例时钟,必须用 HB 行的 skew 值做线性插值校准;
   REQ 行是网关时钟,绝对不要校准
3. trace_id 做归一:去 0x 前缀、去连字符、转小写,三步顺序不能换
4. 同一 trace 可能有多条 REQ(重试),用 deque 存,不要用 dict 覆盖;
   配对时若 RESP 带 elapsed,选 |时间差 - elapsed| 最小的那条
5. 采集重复行按 (trace_id, 秒级时间, 状态码) 去重
6. 未配对的 REQ 和 RESP 分别输出到 missing / orphan 两个列表,不允许静默丢弃
7. 最后输出:配对精确率/召回率/耗时准确率(±2ms)、缺失与孤儿的 P/R、分小时耗时准确率

先给我一个 60 行以内的核心函数,不要写 CLI 和报表。
要点是把"为什么"写进约束里。只说"要做时钟校准",它很可能给你一个"所有行统一减偏移"的实现——我第一版就是这么错的。
八、最后
这次实测最让我警惕的不是 45.23% 的精确率,而是它跑得又快又好,还给出了一个看起来很专业的 P95。
如果没人拿它跟监控平台对一次,这个数字会一直躺在报表里,被用来做容量规划、被写进复盘文档。
对账这件事,召回率比精确率更值得盯:错配至少还会在交叉验证时露馅,漏配是彻底静默的——你不知道有 25,220 条请求压根没进统计。
所以我现在做这类工具,第一件事不是写配对逻辑,而是先把"每一行都要有归宿"这条约束钉死:配上的进 pairs,没配上的进 missing 或 orphan,三个数加起来必须等于总行数。账不平,就先别谈准确率。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号