#WorkBuddy# 400 对文本版本,朴素脚本 60.5% 静默写错:增量 diff 与补丁的五个关口
原创
#WorkBuddy# 400 对文本版本,朴素脚本 60.5% 静默写错:增量 diff 与补丁的五个关口
原创
用户12784192
发布于 2026-11-02 07:43:45
发布于 2026-11-02 07:43:45
#WorkBuddy# 400 对文本版本,朴素脚本 60.5% 静默写错:增量 diff 与补丁的五个关口
做文档版本管理的人迟早会碰到同一件事:几百份文件各有五六个版本,你想只存"改动",于是写了个 difflib.unified_diff 存补丁。脚本跑完不报错,日志一路绿灯,你还挺满意。直到某天要还原其中一版,打开一看,内容对不上——而脚本从来没告诉过你。
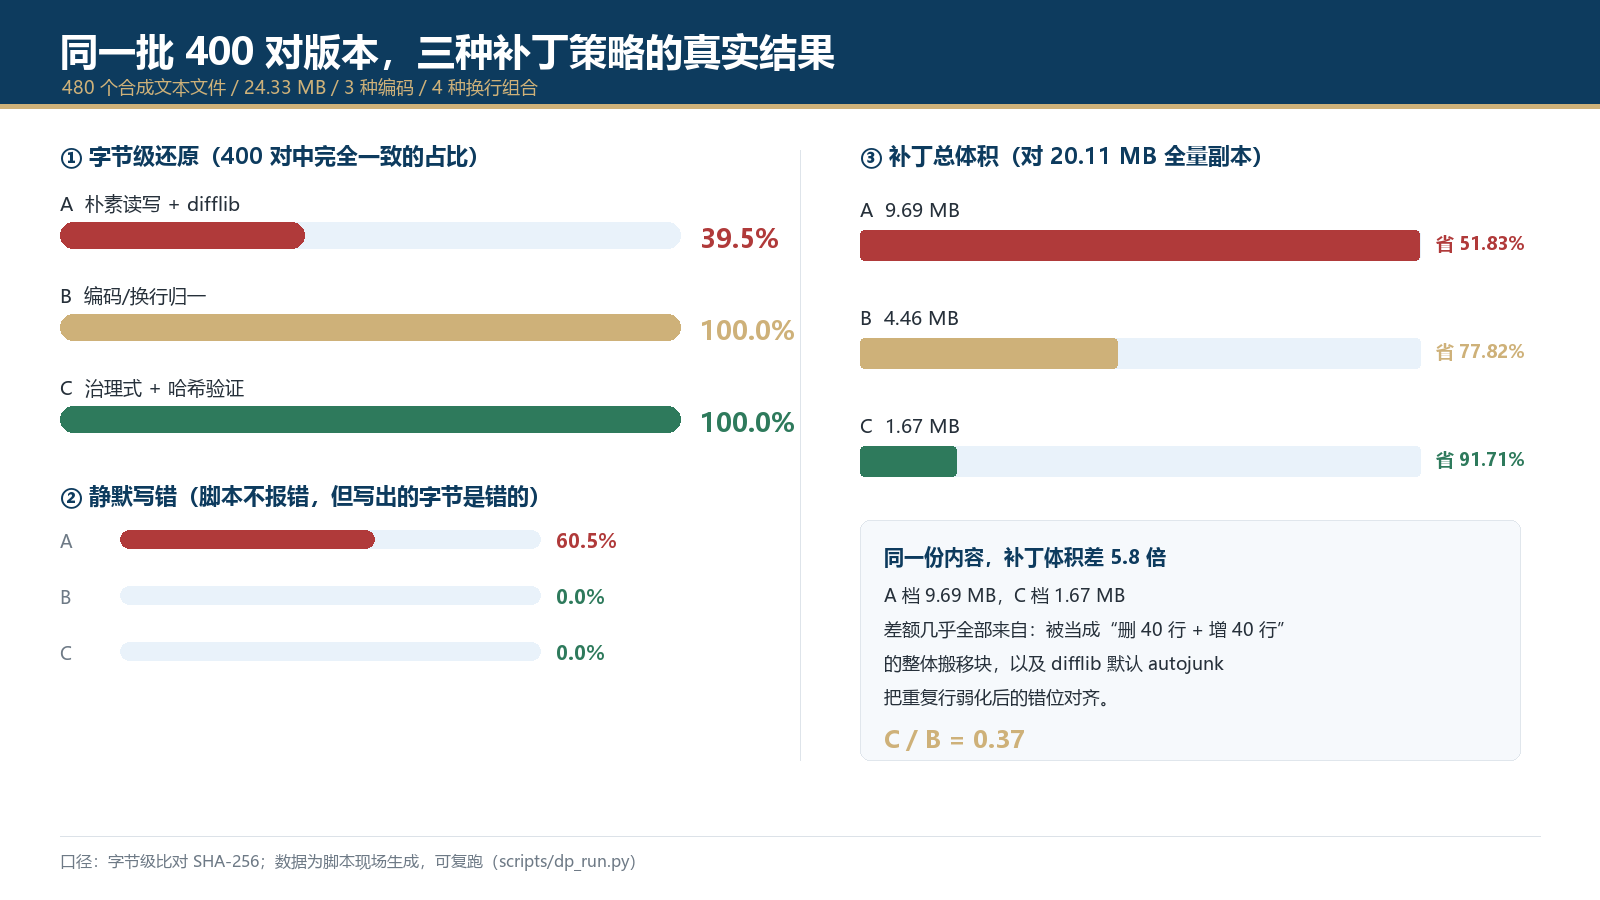
我按这个思路做了一次完整实测:80 份合成技术文档、每份 6 个版本、共 480 个文件 24.33 MB、400 对相邻版本。三档策略对比下来,最朴素那档的字节级还原率只有 39.5%,更麻烦的是有 60.5% 的配对被"静默写错"——补丁应用成功、脚本零异常、写出的字节是错的。治理式那一档 400 对全部逐字节一致,补丁体积只有朴素档的 17.2%。
这篇把根因拆开讲,代码可以直接抄。
一、先看一组让人不太舒服的数字
实验语料全部是脚本现场生成的合成文本(不含任何真实业务内容),每份文档 900~1200 行,版本之间叠加四类变化:
- 内容编辑:改 1,235 处、插 649 处、删 667 处
- 整块搬移:217 次,共 7,615 行(把一段 25~45 行的区块从文首挪到文中)
- 换行翻转:CRLF ↔ LF 随机
- 编码切换:UTF-8 / UTF-8-BOM / GBK 三选一(最终 204 / 203 / 73 个文件)
- 缩进切换:2 空格 ↔ 4 空格
后三类在语义上什么都没改。按"真正要写进补丁的行数"算,下限是 4,003 行(替换按 2 行算、插入删除各 1 行、一次搬移算 1 行)。这就是后面所有"噪声倍数"的分母。
@@IMG1@@
三档的成绩单:
指标 | A 朴素 | B 半治理 | C 治理式 |
|---|---|---|---|
字节级还原(400 对) | 158 对 / 39.5% | 400 对 / 100% | 400 对 / 100% |
静默写错(不报错但写错) | 242 对 / 60.5% | 0 | 0 |
补丁总体积 | 9.69 MB | 4.46 MB | 1.67 MB |
相对 20.11 MB 全量副本节省 | 51.83% | 77.82% | 91.71% |
补丁报告行数 | 147,816 | 68,226 | 14,098 |
噪声倍数(÷4,003) | 36.93× | 17.04× | 3.52× |
耗时(400 对) | 77.4 s | 1.51 s | 23.75 s |
注意 A 档的"51.83% 节省"其实是个假象:它省下的空间,一部分来自把文件写坏。
二、根因:三个默认值,一个缺失的校验
1. 文本模式 open() 会把换行"修好",代价是你再也还原不出原字节
用 open(path).read() 读、open(path,'w').write() 写,中间会经历两次隐式转换:读入时通用换行把 \r\n 统一成 \n,写出时再按当前平台换行符输出。在 Windows 上,这意味着所有 LF 文件写回去都变成了 CRLF。
按目标文件的换行 × 编码分组统计 A 档的失败,结果干净得有点残酷:
分组 | 配对数 | 字节一致率 |
|---|---|---|
UTF-8 / CRLF | 69 | 100% |
UTF-8-BOM / CRLF | 89 | 100% |
UTF-8 / LF | 92 | 0% |
UTF-8-BOM / LF | 77 | 0% |
GBK / CRLF | 36 | 0% |
GBK / LF | 37 | 0% |
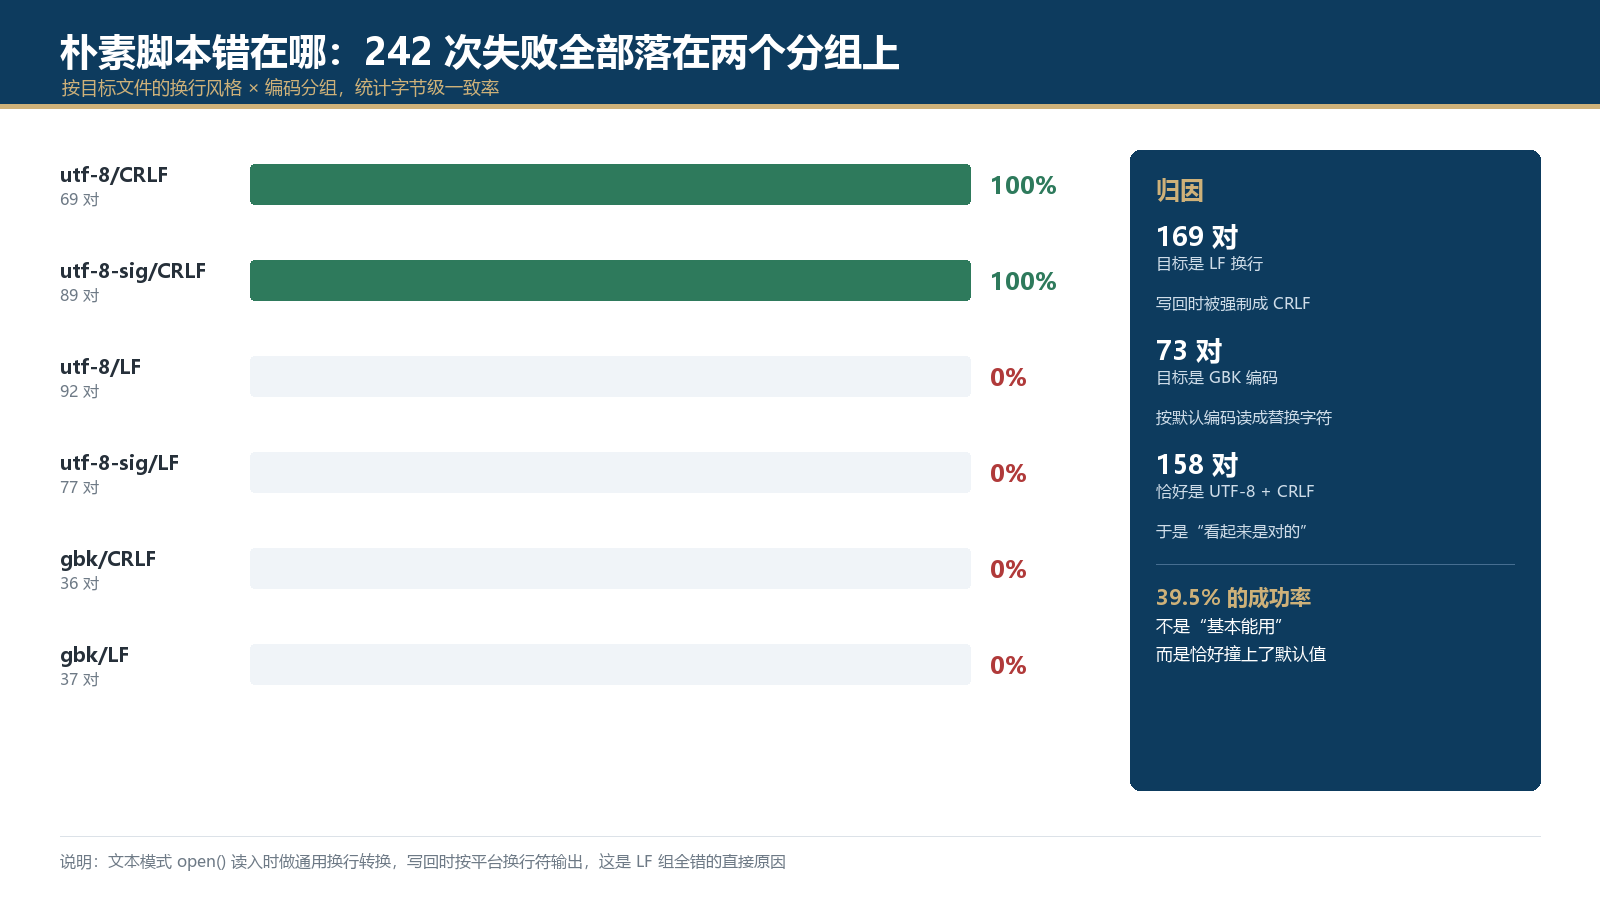
39.5% 的成功率不是"基本能用",而是恰好撞上了默认值:158 对成功 = 69 + 89,全部是"UTF-8 编码 + CRLF 换行",正好是本机默认读写的组合。剩下 242 对失败 = 169 个 LF 文件 + 73 个 GBK 文件,一个不差。
2. 默认编码读 GBK,得到的是替换字符
open() 不带 encoding 时用当前解释器的默认编码。GBK 文件按 UTF-8 解,中文全变成替换字符——补丁能生成、能应用,但你写回去的已经是垃圾了。这类失败最阴险:不抛异常。
3. difflib 的 autojunk=True 会把 10 行差异放大成 2,066 行
SequenceMatcher 默认开启 autojunk:如果某个元素在序列中出现超过 1% 且总数超过 200,就被判定为"流行元素",不参与匹配。文档里最流行的是什么?空行、模板句、重复的条目符号。
同一批 400 对,只切换这个开关:
口径 | 报告差异行数 | 相对倍数 |
|---|---|---|
| 68,226 | 3.64× |
| 18,728 | 1.00× |
最坏的一对:真实差异 10 行,默认参数报出 2,066 行。这不是精度问题,是对齐被彻底打乱了。
4. 最重要的一条:没人校验补丁应用后的结果
前三件事都能靠"检查一下"发现,唯独第四件不行——因为朴素脚本从头到尾没有"结果应该长什么样"的概念。补丁应用函数返回了一个列表,脚本就认为成功了。
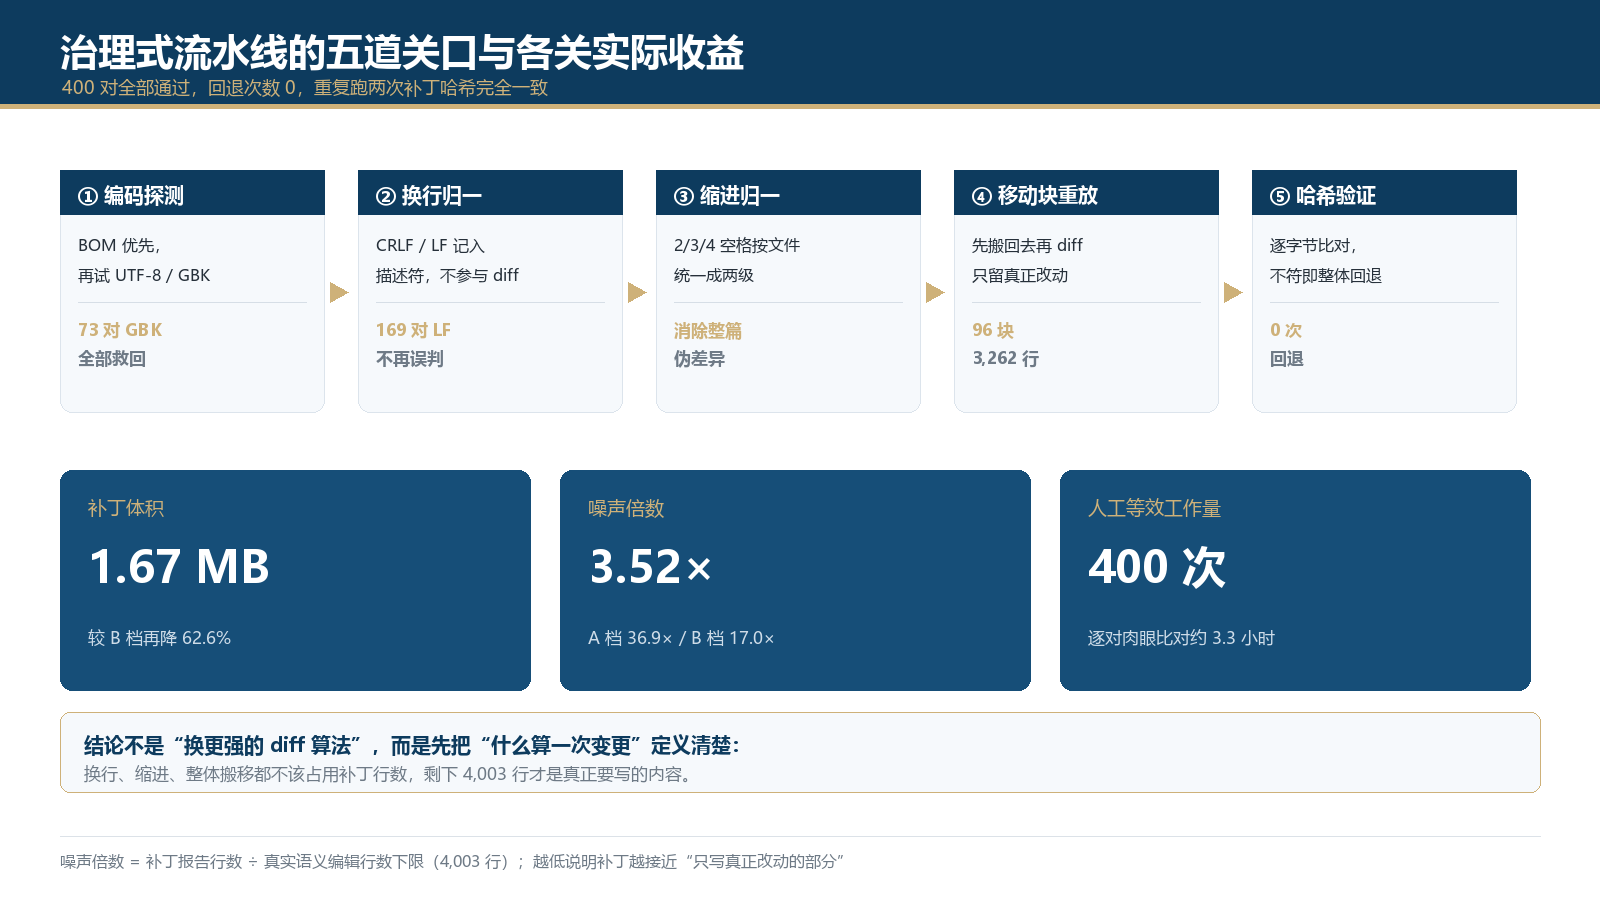
治理式的做法是:应用完立刻按目标文件的编码、换行、BOM、缩进重新渲染成字节,与目标文件做 SHA-256 比对。不符就整体回退成压缩全量。这次 400 对里回退 0 次,但正是这道关口,把"静默写错"从 60.5% 压到 0。
三、五道关口
@@IMG3@@
① 编码探测:先看 BOM,再严格试 UTF-8,最后 GBK。不用 chardet 之类——三类文件用顺序试解就够,够快也够稳。
② 换行归一:把换行风格记进一个描述符,正文统一成 \n 再比。还原时按描述符写回去。
③ 缩进归一:按文件探测缩进单位(2/3/4 空格),统一折算成两级缩进。2 空格换 4 空格这种"整篇都变了"的版本,在这一步被清零。
④ 移动块重放:先把被搬走的块搬回原位,再 diff。这样一次 40 行的搬移只占 1 行补丁,而不是"删 40 行 + 增 40 行"。
⑤ 哈希验证:逐字节比对,不符即回退。
核心代码(节选,完整可跑版本在文末说明):
def detect_enc(data):
    if data.startswith(codecs.BOM_UTF8):
        return "utf-8-sig", True
    for enc in ("utf-8", "gbk"):
        try:
            data.decode(enc)
            return enc, False
        except UnicodeDecodeError:
            continue
    return "latin-1", False

def canon(lines, unit):
    # 缩进折算成两级;换行在外部统一为 \n;BOM 已剥离
    out = []
    for ln in lines:
        s = ln.lstrip(" ")
        lv = (len(ln) - len(s)) // unit if unit else 0
        out.append("  " * lv + s)
    return out

def build_patch(src_bytes, dst_bytes):
    se, _ = detect_enc(src_bytes)
    de, bom = detect_enc(dst_bytes)
    a = canon(src_bytes.decode(se).lstrip("\ufeff").replace("\r\n", "\n").split("\n"), unit_of(src_bytes))
    b = canon(dst_bytes.decode(de).lstrip("\ufeff").replace("\r\n", "\n").split("\n"), unit_of(dst_bytes))

    ops = difflib.SequenceMatcher(None, a, b, autojunk=False).get_opcodes()
    moves = pick_moves(a, b, move_candidates(a, b, ops))   # 只采纳能缩小补丁的搬移
    base = replay_moves(a, moves) if moves else a
    patch = unidiff(base, b, autojunk=False)               # 关键:关掉 autojunk

    desc = {"e": de, "b": bom, "n": eol_is_crlf(dst_bytes), "u": unit_of(dst_bytes)}
    return {"moves": moves, "patch": patch, "desc": desc}

def apply_and_verify(src_bytes, packed):
    base = replay_moves(to_canon(src_bytes), packed["moves"])
    for candidate in apply_verified(base, parse_patch(packed["patch"])):
        if hashlib.sha256(render(candidate, packed["desc"])).hexdigest() == dst_sha:
            return candidate
    return None                                            # 交给调用方回退压缩全量
四、几个真的会咬人的坑
坑 1:**difflib.unified_diff** 没有 autojunk 参数。 想关掉它,得自己用 SequenceMatcher(autojunk=False).get_grouped_opcodes(n) 拼 hunk。我第一次直接传 autojunk=False 进 unified_diff,400 对全部抛 TypeError,错误率 100%——而且因为包在 try 里,表面看只是"失败率变了"。
坑 2:移动块不能靠 opcode 段落硬匹配。 文档里有大量重复的样板段,一次删除段和一次插入段内容相同的情况不止一种,"第一个匹配上的"未必是真正搬走的那块。第一版直接取首个匹配,重建出的基线文件反而更乱:补丁从 18,728 行涨到 53,904 行。改成"每个候选都重放一遍、选能真正缩小补丁的那个",才回到 14,098 行。
坑 3:搬移检测的召回不是 100%,别在报告里假装是。 这次只认出 96 块 / 3,262 行,占真值 7,615 行的 42.84%。剩下那些仍然以"删一遍增一遍"的形式躺在补丁里。诚实的口径是:移动块识别贡献了约 4,600 行的额外压缩,不是全部。
坑 4:**context** 别调成 0。 上下文越少,补丁越容易"落在内容几乎相同的另一处"。这次 400 对里有 201 对(50.25%)存在多个可应用位置,全靠哈希验证兜住。用 n=0 省下来的那点字节,换来的是静默写错。
坑 5:治理式的代价是慢 15 倍。 B 档 1.51 秒,C 档 23.75 秒——多出来的时间全花在多候选重放和逐字节验证上。如果你的场景是"写完就不管",用 B;如果是"半年后要靠它还原",那 23 秒换 60% 的正确率,没什么可犹豫的。
坑 6:幂等要单独测。 同一对文件跑两次,补丁的 SHA-256 必须一致。这次测了 120 对,120 对一致。不一致通常意味着候选选择依赖了字典顺序之类的隐式状态,那种 bug 在现场极难复现。
五、给 WorkBuddy 的提示词模板
我平时用下面这段让 WorkBuddy 直接产出这套流水线,比逐条描述需求省事得多:
请为「长文本增量补丁」场景写一套可复跑的 Python 脚本,要求:
1. 生成合成语料:N 份文档 × M 个版本,版本间叠加内容编辑、整块搬移、换行翻转、
   编码切换(utf-8 / utf-8-sig / gbk)、缩进切换,并输出真值 JSON(含每对的最小补丁行数)。
2. 实现三档策略:A 朴素(open() 默认参数 + difflib 默认参数)、
   B 半治理(编码探测 + 换行归一)、C 治理式(再叠加缩进归一、移动块重放、
   结果哈希验证、失败回退压缩全量)。
3. 每档输出:字节级一致率、静默写错率、补丁体积、相对全量节省率、
   报告行数、噪声倍数(报告行数 ÷ 真值最小行数)、耗时。
4. 额外做三组对照:autojunk 开/关的差异行数、A 档按「编码 × 换行」分组的失败归因、
   C 档跑两次的补丁哈希是否一致。
5. 所有数字必须现场跑出来,不要编;跑不出来就写明卡在哪一步。
六、收尾
这件事真正的教训不在算法。difflib 没问题,unified_diff 也没问题,问题在于我们从没定义过"什么算一次变更"。
换行从 CRLF 变成 LF,算不算变更?缩进从 2 空格变 4 空格呢?一整段从第三章挪到第五章呢?默认答案都是"算"——于是 4,003 行的真实改动,被报成 147,816 行;于是补丁比文件本身小不了多少,"增量"名存实亡。
把这几个定义写清楚,剩下的都是工程细节:编码探测、描述符、搬移重放、哈希验证、失败回退。五道关口,没有一道需要多聪明的算法,但少一道,就会有一批文件在半年后的某个下午安静地坏掉。
实验脚本:dp_gen.py(造语料与真值)、dp_run.py(三档流水线)、dp_extra.py(归因与幂等)。全部合成数据,随机种子固定,可直接复跑验证上面每一个数字。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号