#WorkBuddy# 240 个自动化任务一把梭 3.96 秒跑完,只有 60% 的产出是对的:我给任务编排加了四道关口
原创
#WorkBuddy# 240 个自动化任务一把梭 3.96 秒跑完,只有 60% 的产出是对的:我给任务编排加了四道关口
原创
用户12784192
发布于 2026-10-30 10:24:09
发布于 2026-10-30 10:24:09
#WorkBuddy# 240 个自动化任务一把梭 3.96 秒跑完,只有 60% 的产出是对的:我给任务编排加了四道关口
痛点开场:跑完 ≠ 跑对
把一批任务交给编排脚本批量执行,是自动化里最常见的动作:几十上百个任务,脚本从上到下一把梭,几秒钟"全部执行完毕",看着很爽。
但我最近做了一次较真的实验:合成一张 240 个任务、359 条依赖边的任务图——模拟真实批处理里"任务之间有先后依赖、资源偶发抖动、个别任务注定要失败"的常态,往里埋了 3 组循环依赖(10 个任务)、44 个会在第 2~3 次尝试才成功的瞬时故障、6 个怎么跑都失败的硬失败任务。然后让三档编排策略各真实跑一遍。
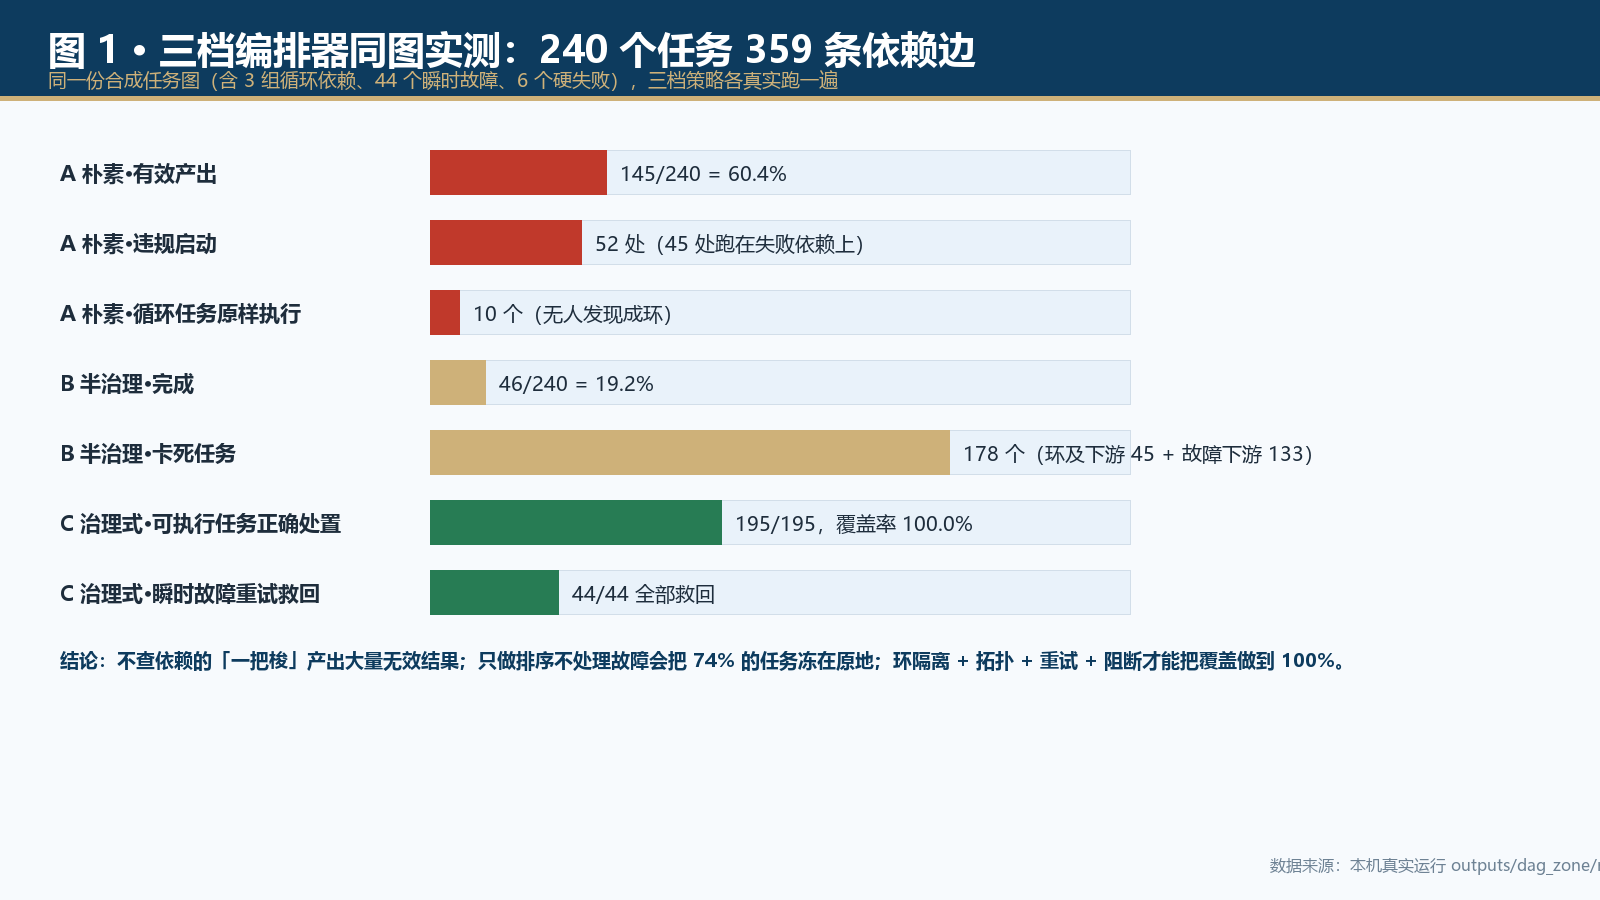
结果:最朴素的"清单序一把梭"3.96 秒跑完 240 个任务,有效产出只有 145 个(60.4%)——52 个任务在依赖还没就绪时就启动了,其中 45 个直接跑在失败依赖的上游产物上;10 个循环依赖任务被原样执行,没有任何报错。跑得快,但将近四成的结果是废的,而且你从日志上完全看不出来。
更扎心的是第二档:做了拓扑排序、看似"正规"的编排器,只完成了 46 个任务(19.2%),178 个任务被冻在原地。
@@FIG1@@
根因分析:三个坑各自独立,缺一个都致命
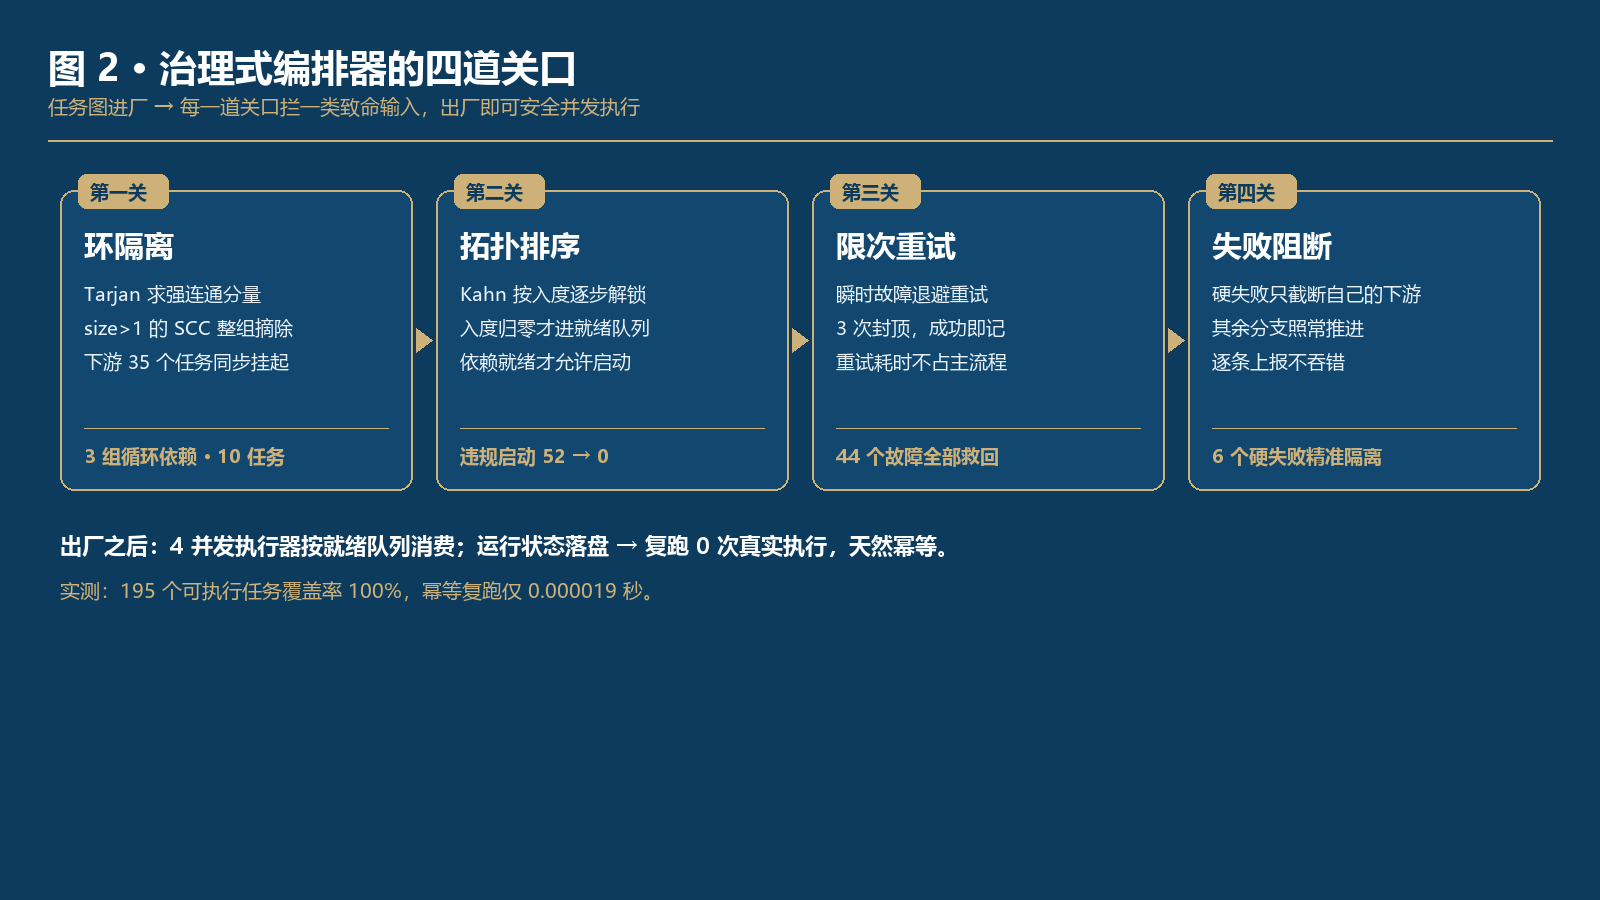
坑一:执行顺序不等于依赖顺序。 任务的"清单顺序"通常等于文件名或创建顺序,而依赖关系是后来长出来的。一旦存在"前向依赖"(任务 A 依赖排在它后面的 B),清单序执行就是错的。正确做法只有拓扑排序:按入度逐步解锁,入度归零才进就绪队列。
坑二:拓扑排序解决不了环。 Kahn 算法遇到循环依赖会静默卡死——环上所有节点入度永远大于 0,永远进不了就绪队列。实验里 3 组环连同它们的下游共 45 个任务全部冻结。环必须在调度前先摘除:用 Tarjan 求强连通分量(SCC),size 大于 1 的 SCC 就是环,整组隔离、下游同步挂起,并明确上报。
坑三:不重试,瞬时故障会冻结整棵下游树。 实验里 44 个瞬时故障任务,不重试就是终态失败;半治理档没有重试机制,一个失败任务的下游全部进不了就绪队列——133 个任务因为 44 个本可自愈的故障被冻结。反过来,加了"3 次封顶"的退避重试后,44 个瞬时故障全部在第 2~3 次尝试中救回。
还有一条容易被忽略:失败要阻断、但不能扩散。硬失败任务(实验里 6 个)重试几次都没用,正确动作是只截断它自己的下游、其余分支照常推进,并把失败逐条上报——而不是让一个坏任务污染整批,也不是假装无事发生。
真实数据对比
同一份任务图,三档策略的真实运行结果(数据均为本机实测,可复现):
指标 | A 朴素·清单序一把梭 | B 半治理·拓扑排序 | C 治理式·四道关口 |
|---|---|---|---|
有效产出 | 145/240(60.4%) | 46/240(19.2%) | 189 完成 + 6 隔离,可执行 195 覆盖 100% |
违规启动(依赖未就绪就跑) | 52 处(45 处跑在失败依赖上) | 0 | 0 |
循环依赖处置 | 10 个原样执行,无报错 | 45 个任务静默冻结 | 3 组环全部隔离并上报 |
瞬时故障 | 50 个终态失败(含 6 硬失败) | 16 个失败 + 133 个下游冻结 | 44/44 重试全部救回 |
硬失败处置 | 与成功任务混在一起 | 下游静默冻结 | 精准隔离,逐条上报 |
耗时 | 3.96 s | 0.29 s(跑一半就退出) | 1.31 s(4 并发) |
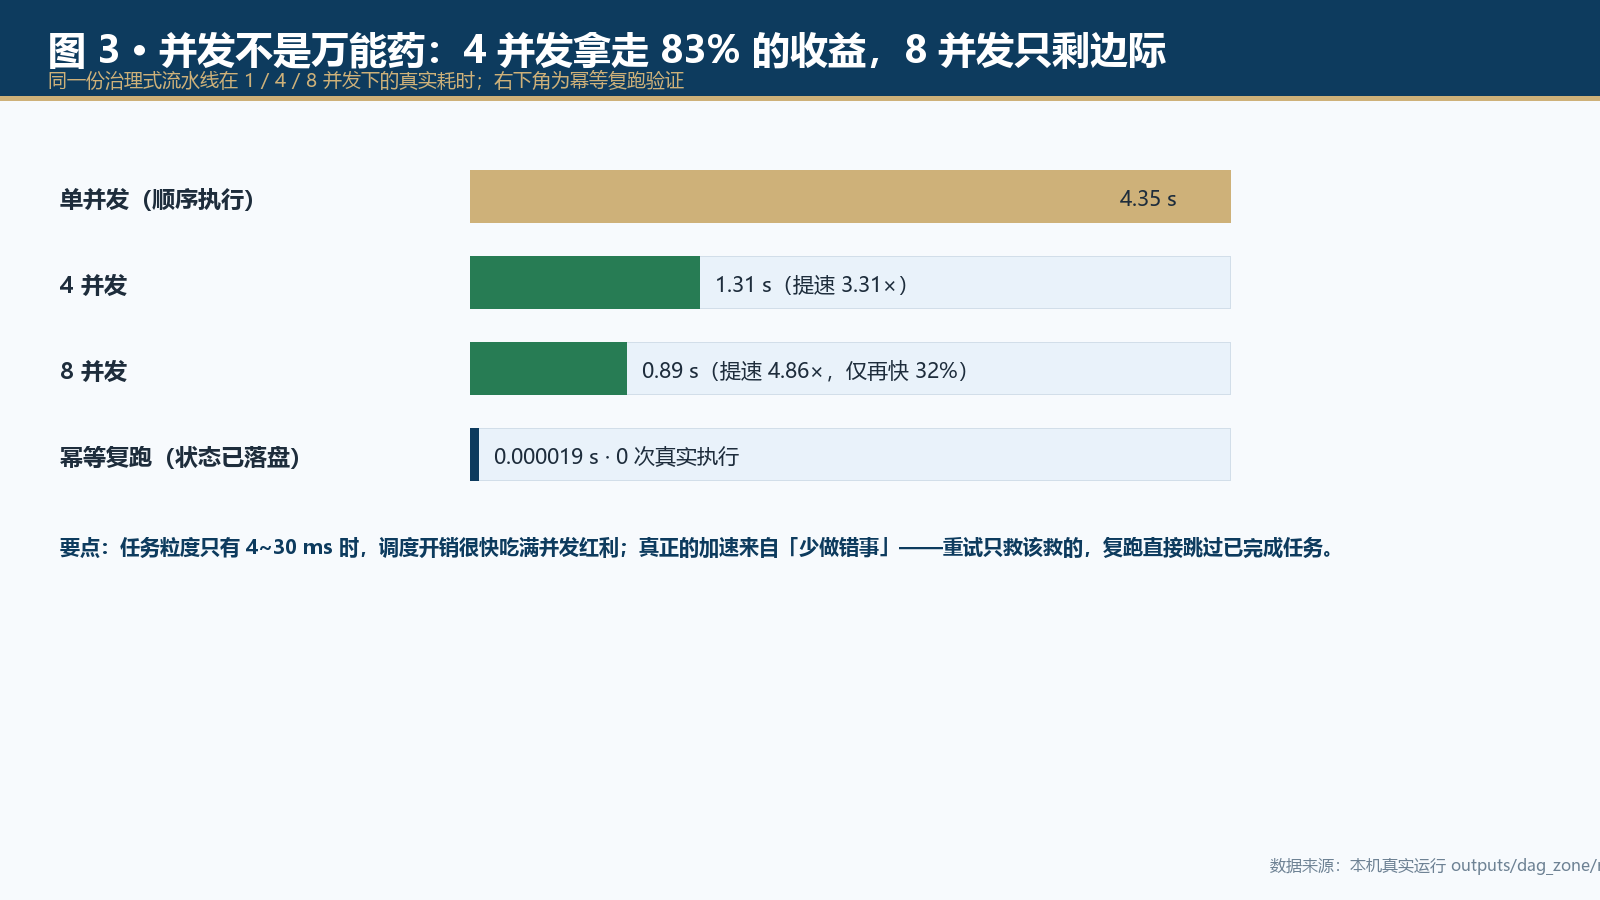
并发不是万能药。同一份治理式流水线在 1 / 4 / 8 并发下分别耗时 4.35 s / 1.31 s / 0.89 s——4 并发拿到 3.31 倍提速(约 83% 的收益),8 并发只有 4.86 倍,因为任务粒度只有 4~30 ms,调度开销很快吃满红利。
@@FIG2@@
可复制代码:四道关口的最小实现
第一关,环隔离:Tarjan 求强连通分量,size 大于 1 的整组摘除。
def tarjan_scc(n_nodes, depsets):
    """iterative Tarjan,返回所有 size>1 的强连通分量(即循环依赖组)"""
    index = {}; low = {}; onstk = set(); stk = []; sccs = []
    counter = [0]
    for root in range(n_nodes):
        if root in index: continue
        work = [(root, 0)]
        while work:
            v, pi = work[-1]
            if pi == 0:
                index[v] = low[v] = counter[0]; counter[0] += 1
                stk.append(v); onstk.add(v)
            recurse = False
            neighbors = list(depsets[v])
            for i in range(pi, len(neighbors)):
                w = neighbors[i]
                if w not in index:
                    work[-1] = (v, i + 1); work.append((w, 0)); recurse = True; break
                elif w in onstk:
                    low[v] = min(low[v], index[w])
            if recurse: continue
            if low[v] == index[v]:
                scc = []
                while True:
                    w = stk.pop(); onstk.discard(w); scc.append(w)
                    if w == v: break
                if len(scc) > 1: sccs.append(scc)
            work.pop()
            if work:
                u = work[-1][0]; low[u] = min(low[u], low[v])
    return sccs
第二、三、四关合并进主循环:Kahn 就绪队列 + 限次重试 + 失败阻断。
def run_pipeline(runnable, depsets, dependents, execute, workers=4):
    """runnable: 环隔离后的可执行集;execute(i) 返回 (ok, attempts)"""
    pending = set(runnable)
    depcnt = {i: len(depsets[i]) for i in runnable}
    done, hard_failed, blocked = set(), set(), set()
    with ThreadPoolExecutor(workers) as pool:
        while pending:
            ready = sorted(i for i in pending if depcnt[i] == 0)
            if not ready:
                raise RuntimeError("调度死锁:就绪队列为空,说明环隔离不彻底")
            futs = {pool.submit(execute, i): i for i in ready}
            wait(futs)
            for f, i in futs.items():
                ok, att = f.result()
                pending.discard(i)
                if ok:
                    done.add(i)
                    for j in dependents.get(i, []):
                        if j in depcnt: depcnt[j] -= 1
                else:
                    hard_failed.add(i)
                    stack = [i]                      # 只截断自己的下游
                    while stack:
                        x = stack.pop()
                        for y in dependents.get(x, []):
                            if y not in blocked:
                                blocked.add(y); stack.append(y)
                    pending -= blocked
    return done, hard_failed, blocked
最后是幂等:每次执行完,把"已完成 / 已隔离 / 已失败"的裁决落盘成状态文件。下一轮调度先把状态表加载进来,已裁决的任务直接跳过。实测复跑整张图只花了 0.000019 秒、0 次真实执行——这就是"少做错事"换来的加速,比堆并发划算得多。
@@FIG3@@
踩坑清单
- "跑完了"和"跑对了"是两回事。 日志全绿不代表产出有效,必须拿依赖就绪率、违规启动数这类指标做验收,而不是只看退出码。
- Kahn 遇环是静默卡死,不抛异常。 不做环检测,你的流水线只是"安静地不干活",监控上表现为任务数永远差一截。Tarjan 摘环要放在调度最前面。
- 重试要有封顶次数,且区分瞬时与硬失败。 无限重试会拖垮整批;不区分则要么浪费(对硬失败重试)、要么误杀(对瞬时故障放弃)。
- 失败阻断要"截断下游、放行旁支"。 一刀切全批中止和假装无事继续跑,都是错的。
- 幂等是复跑的前提。 状态不落盘,失败重跑就得从头再来;状态落盘后,重跑只补差额,成本趋近于零。
- 并发度要按任务粒度定。 毫秒级任务堆到 8 并发只剩边际收益,先把调度开销降下来(少做错事)再谈加机器。
给 WorkBuddy 的提示词模板
把这段模板贴给 WorkBuddy,它能帮你把一批散装任务变成带四道关口的编排器(本模板在本机实测跑通,语义已按上述实验校准):
# 角色:任务编排治理助手
# 输入:./tasks/ 目录下的任务清单(每行一个任务,deps 字段声明依赖)
请按以下四道关口为我构建批处理编排器:
1. 环隔离:用 Tarjan 强连通分量检测循环依赖,size>1 的 SCC 整组摘除,
   连同下游挂起并生成 <隔离清单.json>,不执行、只上报;
2. 拓扑调度:Kahn 按入度解锁,任何任务必须等全部依赖就绪才能启动,
   统计"违规启动数",要求为 0;
3. 限次重试:可执行文件重试 3 次封顶、指数退避(200ms 起),
   重试成功的任务单独计数并写进报告;
4. 失败阻断:重试耗尽仍失败的硬失败任务,只截断其下游、放行旁支,
   逐条写入 <失败清单.json>,退出码非 0;
最后:把每个任务的裁决(done/isolated/failed/blocked)落盘到
./state/execution_state.json,重跑时先读状态表,已裁决任务直接跳过;
输出执行报告,必须包含:有效产出率、违规启动数、重试救回数、隔离数。
收尾
这次实验最反直觉的一点是:性能最好的策略不是并发最高的,而是"废动作"最少的。 朴素档跑得最快(3.96 秒),但 39.6% 的产出是废的;治理式档多花了 0.29 秒(对比朴素顺序执行),却把 195 个可执行任务全部正确处置、44 个瞬时故障全部救回、3 组循环依赖全部拦截,复跑成本趋近于零。
自动化编排的本质不是"把任务都跑一遍",而是保证每个任务在正确的前提满足时才跑、跑不动的明确告诉你为什么跑不动。四道关口——环隔离、拓扑调度、限次重试、失败阻断——加上一份落盘的状态文件,就是这个保证的最小实现。下次你的批处理脚本"几秒全绿"时,不妨先问一句:违规启动了几次?
(实验环境:Windows + Python 3,合成任务图 240 节点 / 359 边,随机种子 20261030,全部数据可由同一脚本复现。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号