AI Infra全栈拆解:大模型应用背后的基础设施,算力集群、网络、存储与服务治理体系26.0
原创
AI Infra全栈拆解:大模型应用背后的基础设施,算力集群、网络、存储与服务治理体系26.0
原创
未闻花名
发布于 2026-10-20 17:36:05
发布于 2026-10-20 17:36:05
一、前言
最近大家都在聊大模型、Agent、RAG,很多人把注意力放在Prompt、智能体逻辑、检索算法上。但在实际落地的时候会发现,再好的模型权重、再精巧的业务逻辑,如果底层基础设施扛不住,一切都是空中楼阁。这就是AI Infra,AI基础设施。
起初在一知半解的情况下容易把AI Infra简单等同于GPU服务器集群,这个理解比较片面,随着慢慢深入,了解到GPU只是硬件底座,完整的AI Infra是一整套软硬件协同体系,覆盖模型训练、微调、评测、推理上线、监控运维全生命周期。从服务器、高速网络、分布式存储,到容器编排、资源调度、显存优化、模型版本管理,都属于AI Infra的范畴。
普通软件业务的基础设施,面向的是普通CPU业务,IO、内存压力相对可控。但大模型有完全不一样的特征:训练阶段需要超大显存、超高带宽跨机通信;推理阶段存在突发热点流量、动态显存占用、流式输出。传统云原生架构直接拿来跑大模型,往往会遇到通信瓶颈、显存抢占、资源浪费、调度失效等问题。今天我们就由浅入深,完整拆解AI Infra。先理清基础概念,再分层讲解硬件底座、集群编排、训练侧基础设施、推理侧基础设施,最后聊可观测性与落地选型。
二、AI Infra基础概念
1. AI Infra介绍
AI Infra全称AI Infrastructure,人工智能基础设施,是支撑AI模型开发、训练、微调、部署、线上服务的整套软硬件平台。
传统业务Infra服务通用业务,比如Web服务、数据库、消息队列。AI Infra专门针对深度学习,尤其是大模型的特性做定制优化。它的目标很简单:高效利用算力、降低模型训练和推理成本、保障线上服务稳定可控。
AI Infra整体可以拆成四层,由底层向上依次为:
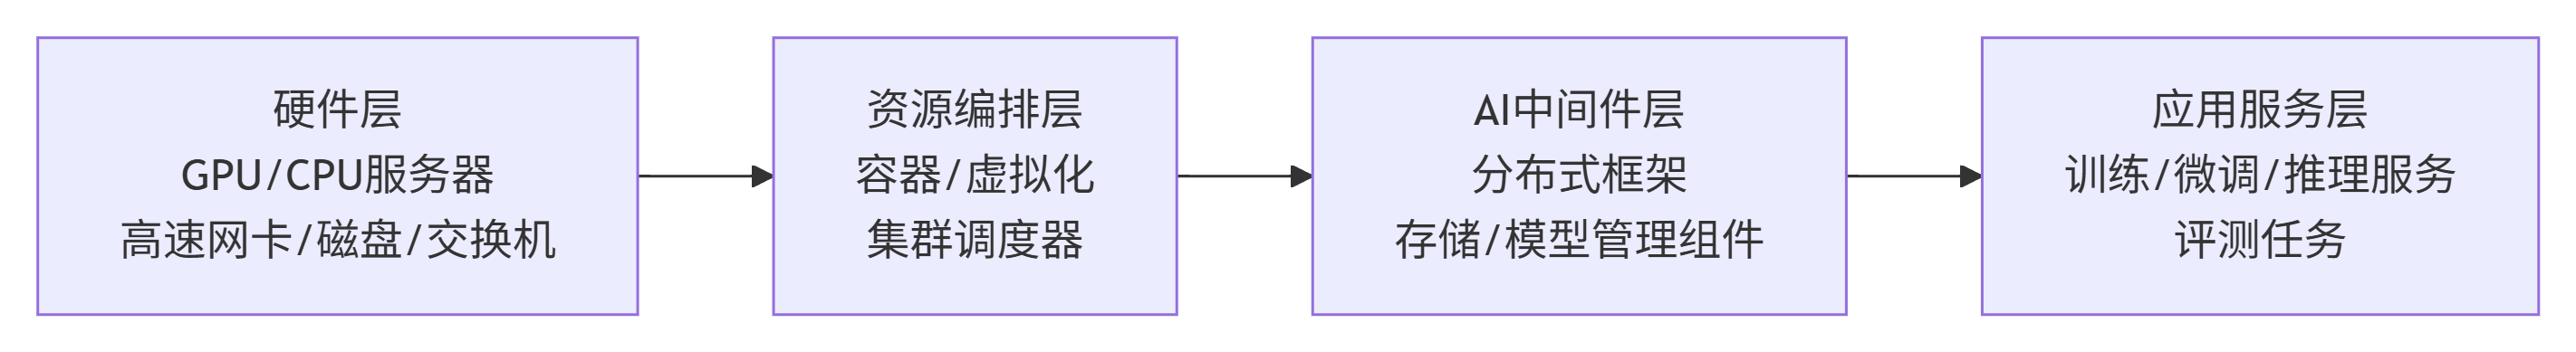
- 硬件层:GPU/CPU服务器、高速网卡、磁盘、交换机
- 资源编排层:容器、虚拟化、集群调度器
- AI中间件层:分布式框架、存储组件、模型管理组件
- 应用服务层:训练任务、微调任务、模型推理服务、评测任务
起初我们就是只采购硬件,缺少上层AI中间件和调度体系。机器买回来了,GPU利用率常年低于30%,多任务之间互相抢占资源,任务失败之后不能断点续训,人力成本极高,算力白白浪费。
2. AI Infra核心目标
搭建AI Infra,不是简单堆机器,要实现四个核心目标:
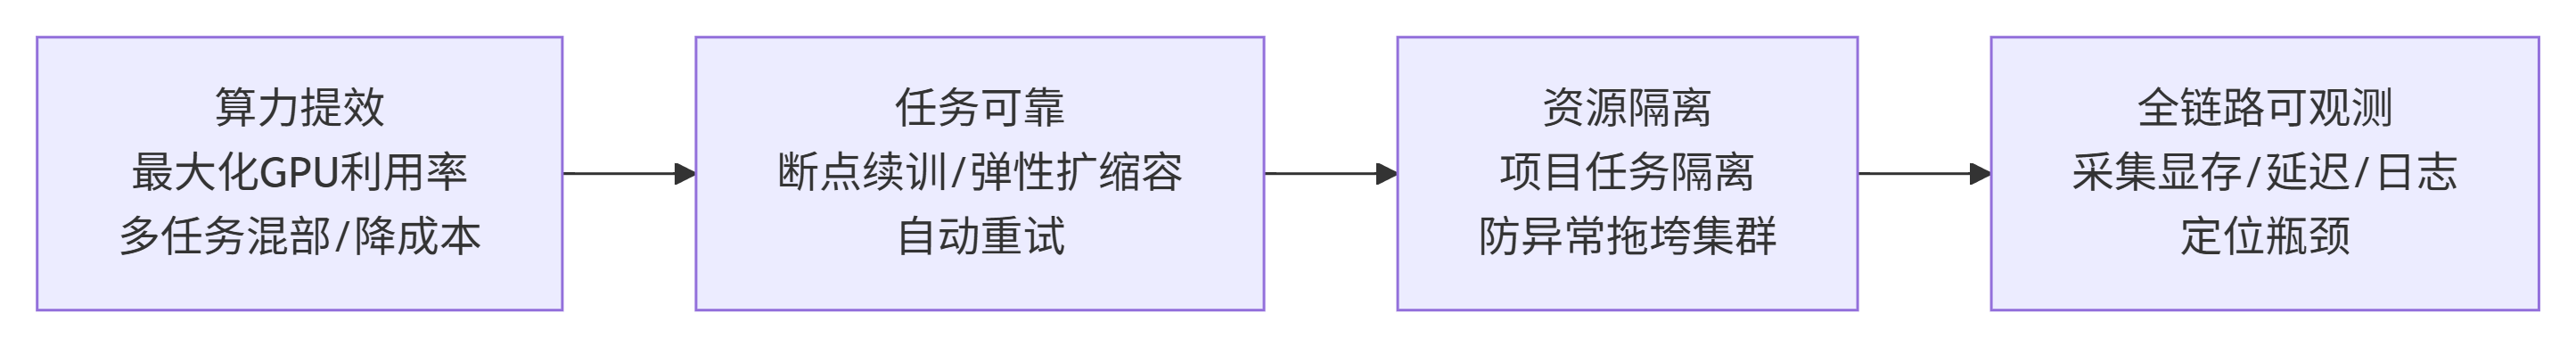
- 算力提效:最大化GPU利用率,减少空闲算力,支持多任务混部,降低单位Token成本。
- 任务可靠:训练支持断点续训,推理服务支持弹性扩缩容,任务崩溃自动重试。
- 资源隔离:不同项目、不同团队的任务资源隔离,避免一个异常任务耗尽显存,拖垮整个集群。
- 全链路可观测:采集GPU显存、算力使用率、网络带宽、推理延迟、错误日志,方便定位瓶颈。
普通互联网业务更看重CPU、内存、磁盘IO。而大模型场景下,显存、跨节点网络带宽才是第一优先级瓶颈。大模型训练时,张量并行、流水线并行会产生大量跨卡、跨服务器数据传输,普通千兆网络完全无法支撑,必须使用IB高速网络或者RoCE。
3. 与通用Infra差异
通用云原生基础设施,面向无状态Web服务、数据库、消息队列。AI Infra面向GPU密集型任务,二者差异巨大。
- 1. 资源维度不同:通用Infra看CPU核数、内存;AI Infra新增GPU卡数、显存、NVLink、网络带宽指标。
- 2. 任务生命周期不同:通用服务长期在线;训练任务可能连续跑数天甚至数月,属于长任务;推理服务是常驻在线服务。
- 3. 资源抢占风险不同:GPU显存属于独占资源,一旦显存溢出任务直接崩溃;普通进程内存超限可以OOM kill,影响范围更小。
- 4. 扩缩容逻辑不同:大模型推理扩缩容不能像普通容器秒级启停,加载大权重文件需要大量时间,冷启动耗时很长。
简单示例:查看GPU硬件信息基础代码
以下示例是AI Infra最基础的检测脚本,在任务调度前,用来确认节点GPU数量、显存规格。集群调度组件,底层也会采集这类硬件指标,用于任务分配。
import torch
# 查看GPU设备信息,AI Infra硬件检测基础脚本
def check_gpu_info():
    print(f"PyTorch版本: {torch.__version__}")
    print(f"CUDA可用: {torch.cuda.is_available()}")
    if torch.cuda.is_available():
        device_count = torch.cuda.device_count()
        print(f"GPU卡数量: {device_count}")
        for i in range(device_count):
            gpu_name = torch.cuda.get_device_name(i)
            total_mem = torch.cuda.get_device_properties(i).total_memory / 1024 / 1024 / 1024
            print(f"GPU{i}: {gpu_name}, 总显存: {total_mem:.2f} GB")

if __name__ == "__main__":
    check_gpu_info()
三、AI Infra硬件底座
1. 算力芯片选型
硬件是AI Infra的根基,算力芯片主要分为GPU、ASIC、NPU三类,当前大模型场景主流还是GPU。GPU擅长并行矩阵运算,而大模型Transformer架构的核心就是海量矩阵乘法,二者天然匹配。
- NVIDIA GPU:行业主流,CUDA生态完善,NVLink高速互联,适合训练、微调、推理全场景。例如A100、H100,多用于大规模训练;L4、A10多用于线上推理。
- 国产NPU:适配国内自主需求,生态正在完善,适合私有化部署场景。
- ASIC专用芯片:例如TPU,定制化程度高,适合大规模集群,通用性偏弱。
选型需要区分训练卡和推理卡:
- 训练卡看重超大显存、NVLink互联带宽;
- 推理卡看重性价比、低功耗,支持动态批处理、模型量化。
2. 服务器与互联网络
单台服务器算力有限,大模型训练必须多机集群,网络是仅次于显存的第二大瓶颈。
- NVLink:服务器内部GPU之间的高速互联,单机内多卡通信,带宽远高于PCIe,单机张量并行必备。
- InfiniBand(IB):跨服务器高速网络,大规模分布式训练首选,低延迟、超高带宽。
- RoCE:以太网实现的RDMA,成本低于IB,很多中型集群选择这个方案。
- 普通以太网:千兆/万兆,只适合小规模测试、推理集群,不适合大模型训练。
很多自建集群容易遇到的情况:GPU卡很好,但网络用普通万兆网卡,多机训练时大部分时间都在等待数据传输,GPU利用率上不去,大量算力浪费。
3. AI场景存储体系
大模型场景存储分为三类,每一类用途不同,AI Infra会分层搭建。
- 本地SSD:服务器本地盘,存放模型权重、训练数据集,读写速度快,用于临时缓存。
- 分布式并行存储:如Lustre、BeeGFS,训练集群核心存储。支持多节点并发读写,海量数据集加载,训练过程持续读取样本。
- 对象存储:如S3、OSS,用来存放模型版本、日志、数据集归档,成本低,适合冷数据持久化保存。
· 训练的时候,如果存储IO跟不上,GPU会出现空等数据,算力闲置,这就是IO瓶颈。所以AI存储不能直接用普通云盘,需要高并发并行文件系统。
4. 硬件资源规划思路
规划硬件资源,不能盲目采购,要结合业务场景判断。
- 大规模预训练:优先H100/A100 + IB网络 + 并行分布式存储,多节点高带宽互联。
- SFT微调:可以使用中高端GPU,集群规模更小,网络要求低于预训练。
- 线上推理:L4、A10等推理卡,可混部,对跨机网络需求低,重点考虑显存、成本。
- 小实验原型:单卡/单机,普通SSD,万兆网即可,快速验证算法。
硬件层面的规划,直接决定上层软件架构的上限。硬件短板,软件层面很难弥补。比如没有高速RDMA网络,无论怎么调分布式框架参数,多机训练通信延迟降不下来。
四、集群资源编排与调度
1. 容器化基础
现代AI Infra基本都基于容器。Docker打包环境,解决经典的“本地能跑,集群跑不起来”的环境问题。AI任务依赖CUDA、cuDNN、PyTorch/TensorFlow等组件,版本冲突问题非常严重。容器镜像把GPU驱动、框架、依赖库统一打包。提交任务时直接拉镜像,环境一次性就绪。
Kubernetes(K8s)是容器编排标准。原生K8s并不支持GPU,需要nvidia-container-toolkit + GPU device plugin扩展,K8s才能识别、调度GPU资源。
2. AI任务调度器
原生K8s调度器只适合普通业务,不适合大模型长任务,AI集群一般会搭配专门调度组件。 主流方案:
- KubeRay:Ray集成K8s,现在大模型领域非常热门,支持GPU资源申请、分布式任务管理,训练、推理一站式调度。
- Volcano:云原生AI调度器,支持任务排队、优先级、抢占,适合企业内部多团队共享集群。
- Ray:独立集群调度框架,不依赖K8s,上手简单,适合中小AI集群。
调度器核心能力:
- GPU资源感知:按卡分配资源,支持多张GPU一次性分配给同一个任务。
- 任务排队:集群满负载时,任务进入队列,资源释放后自动启动。
- 任务优先级:核心业务任务优先拿到算力,非紧急实验任务降低优先级。
- 弹性抢占:低优先级任务在资源紧张时暂停,释放算力给高优先级任务。
Ray任务提交示例:实现AI调度
以下示例演示Ray远程任务申请GPU资源。在AI集群调度中,用户提交任务声明需要几张GPU,调度器在集群里找满足条件的节点,分配资源启动任务。
import ray

# 初始化ray,连接AI集群
ray.init(address="auto")

@ray.remote(num_gpus=1)
def run_ai_task():
    import torch
    if torch.cuda.is_available():
        return f"任务GPU可用,GPU数量: {torch.cuda.device_count()}"
    return "无可用GPU"

if __name__ == "__main__":
    res = ray.get(run_ai_task.remote())
    print(res)
3. 资源混部与隔离
集群资源混部,就是在同一套硬件上同时跑训练、微调、推理任务,最大化GPU利用率。 混部有很大挑战:
- 显存隔离:GPU显存硬件隔离难度高,任务显存溢出容易互相影响。
- 抢占风险:训练任务算力波动大,会抢占推理任务算力,导致线上推理延迟飙升。
工程上常用方案:
- 节点分组隔离:一部分节点专门跑训练长任务,一部分节点专门跑推理服务,互不干扰。
- 优先级策略:推理任务优先级最高,训练任务低优先级。资源紧张时,优先保障推理。
- 配额管理:给不同团队分配GPU资源配额,防止单个团队占用全部集群资源。
4. 模型版本与数据集管理
AI Infra不只是调度算力,还要管理模型资产。
- 模型版本管理:记录每一次训练产出权重、参数配置、数据集版本,方便回滚、复现实验,主流工具如MLflow、DVC。
- 数据集版本管理:数据集改动之后,标记版本,实验可以绑定数据集版本,保证实验可复现。
通常很容易视这一块,实验做完,不知道是用哪个数据集、哪个参数训练出来的,模型迭代完全不可追溯,后续问题排查极其困难。
五、训练侧AI Infra
1. 分布式训练基础
大模型无法单卡训练,必须分布式训练。分布式训练有四种并行策略,AI Infra要支撑这几种并行模式:
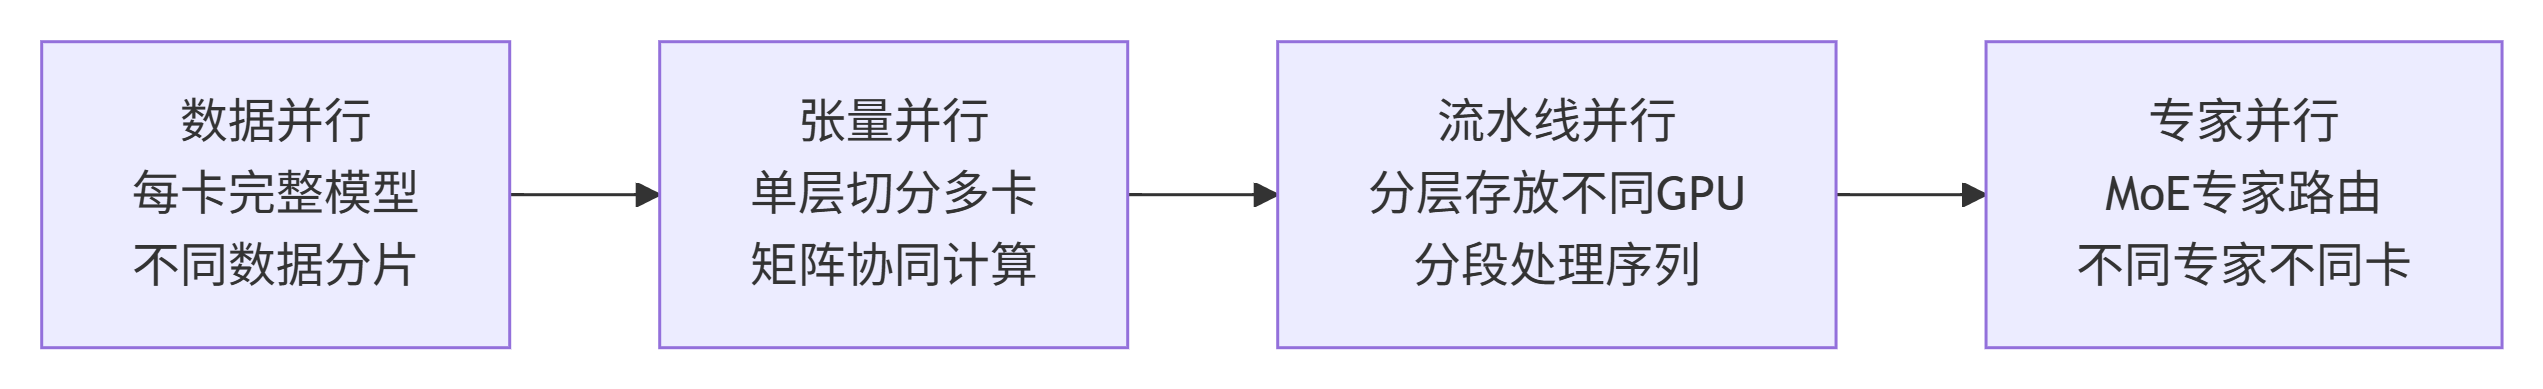
- 数据并行:每个GPU保存完整模型,输入不同数据,计算梯度后汇总更新权重。适合中小模型。
- 张量并行:把模型单一层切分到多张GPU,计算矩阵乘法时多卡协同,大模型常用。
- 流水线并行:把模型分层放在不同GPU,分段处理序列,减少单卡显存占用。
- 专家并行:MoE模型使用,不同专家路由到不同GPU。
底层通信依赖NCCL,NVIDIA集合通信库,是分布式训练核心组件。AI Infra网络优化,很大一部分就是优化NCCL通信性能。
2. 训练任务组件
训练侧基础设施包含大量配套组件:
- 训练框架:PyTorch、DeepSpeed、Megatron-LM。DeepSpeed、Megatron是专门面向大模型分布式训练的库,提供显存优化、梯度检查点、ZeRO显存分片。
- 断点续训组件:定期保存checkpoint。训练任务跑几天遇到故障中断,可以从最近的checkpoint恢复,不用从头训练。
- 训练指标采集:采集loss、学习率、GPU利用率,用TensorBoard、Wandb可视化。
- 数据加载组件:Dataloader,分布式场景下做数据分片,避免多卡读取重复样本。
3. Checkpoint存储与迁移
Checkpoint就是训练过程保存的模型权重文件,文件体积巨大,大模型checkpoint动辄几十GB到TB级别。 AI Infra需要解决:
- 高速写入:训练过程周期性保存权重,并行存储保证写入速度,不阻塞训练。
- 跨集群迁移:训练完成后,把权重从训练集群导出,传输到推理集群部署。
- 多版本归档:保存多轮checkpoint,方便对比不同阶段模型效果,选择最优版本上线。
4. 训练任务监控
训练任务监控重点指标:GPU利用率、显存占用、NCCL通信带宽、训练loss、样本吞吐。 常见训练侧问题:
- GPU利用率低:大概率是数据加载慢,IO瓶颈;或者网络带宽不足,多机通信等待。
- 显存持续上涨:代码存在内存泄漏,或者batch size设置过大,会触发OOM。
- Loss不下降:更多是算法、数据问题,但基础设施可以保障训练稳定运行。
六、推理侧AI Infra
1. 推理与训练的区别
训练是更新模型权重,推理是加载固定权重对外提供服务。二者对基础设施诉求完全不一样。
- 训练:高吞吐、长时间运行,需要更新权重,对双向通信带宽要求高。
- 推理:低延迟、高并发,流式输出,权重只读,流量波动大,要控制单请求显存占用。
推理侧AI Infra核心目标:降低首token延迟,提升并发,减少显存占用,控制单Token成本。
2. 推理引擎
推理引擎是推理侧AI Infra核心组件,做模型压缩、显存调度、批处理优化。 主流引擎:vLLM、TensorRT-LLM、Text Generation Inference。 核心优化手段:
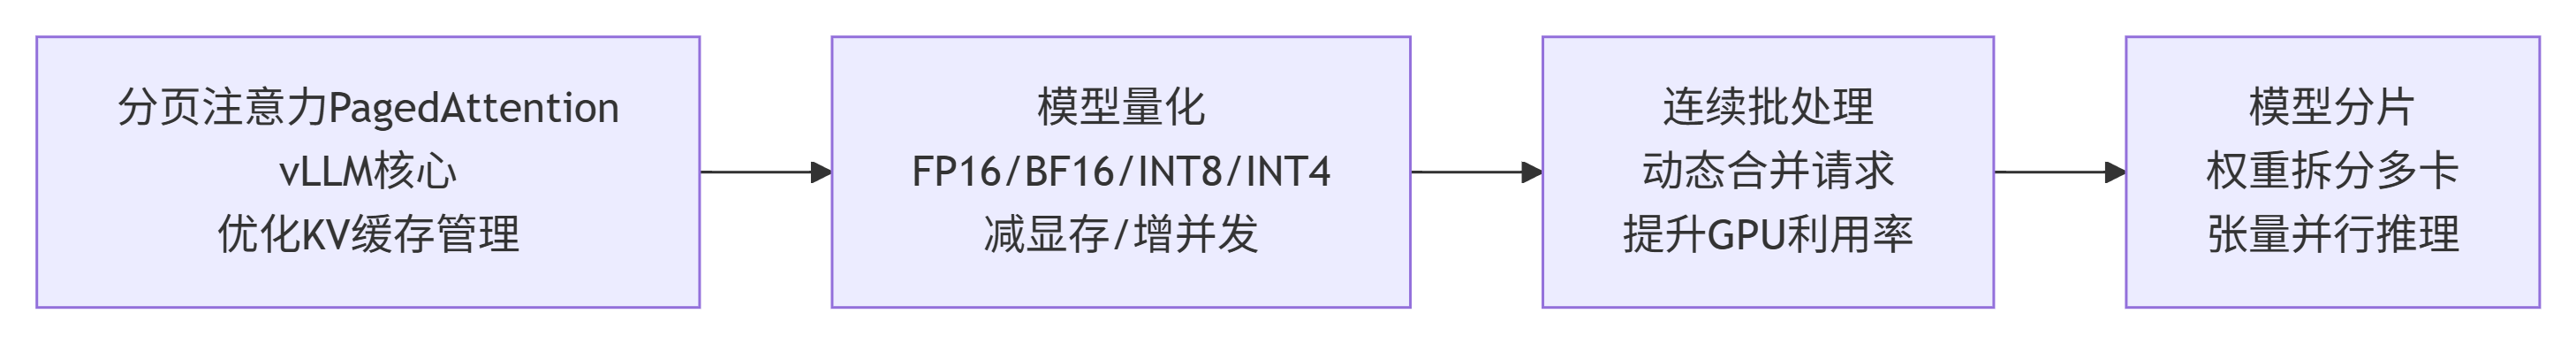
- PagedAttention:分页注意力,vLLM核心技术,大幅优化KV缓存管理,提升并发能力。
- 模型量化:FP16、BF16、INT8、INT4量化,减少显存占用,同一张卡承载更多并发请求。
- 连续批处理:动态合并用户请求,不需要等待一个请求完成再处理下一个,提升GPU利用率。
- 模型分片:大模型权重拆分到多卡,单卡放不下完整权重时使用张量并行推理。
3. 推理服务编排
推理服务是常驻在线服务,需要网关、负载均衡、弹性扩缩容。
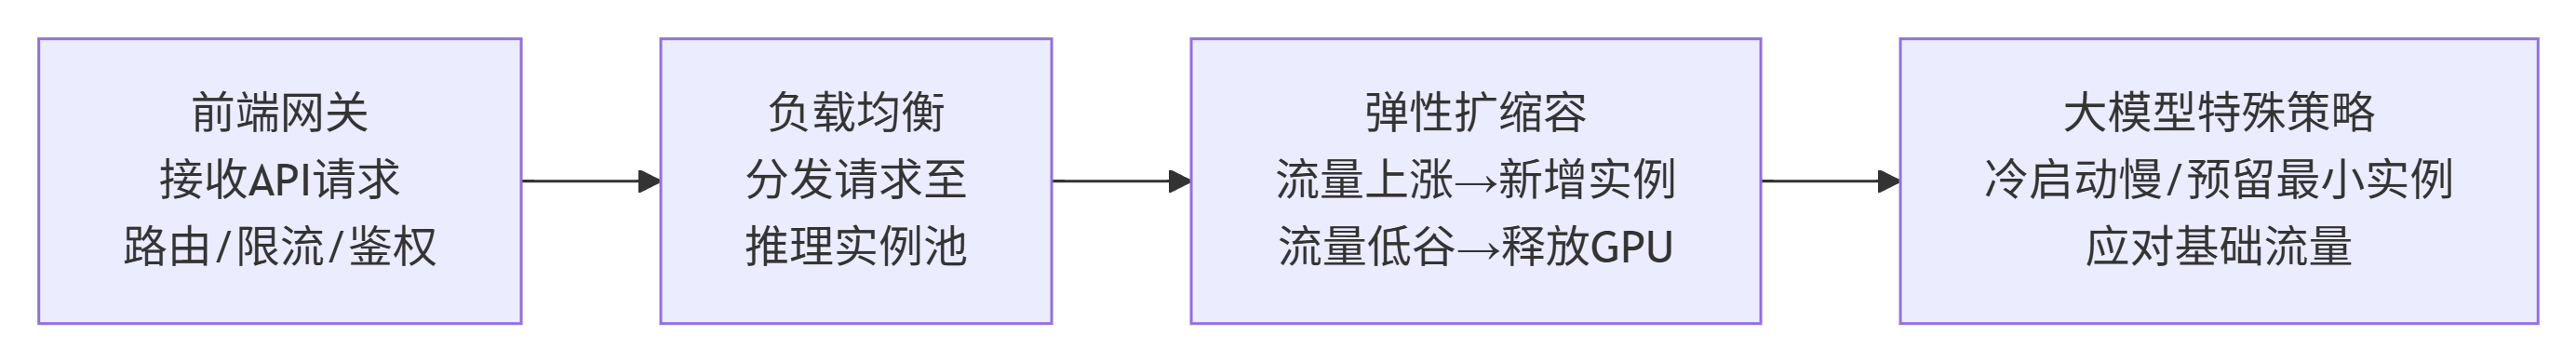
- 前端网关:接收用户API请求,路由到后端推理实例,限流、鉴权。
- 负载均衡:在多个推理实例之间分发请求。
- 弹性扩缩容:流量上涨自动新增推理实例;流量低谷释放GPU资源,节省成本。 但大模型推理实例冷启动慢,加载权重耗时,扩缩容策略不能照搬普通Web服务。一般会预留最小实例数应对基础流量。
4. 推理监控与限流
推理侧重点监控指标:首token延迟、token生成速度、QPS、KV缓存使用率、GPU显存。 同时需要限流机制,防止突发流量把推理集群打垮。可以按用户、按接口设置QPS上限。
vLLM极简推理服务调用示例:
示例展示推理引擎加载模型并生成文本。生产AI Infra中,会把这个服务封装成API,加上网关、监控、限流对外提供服务。
from vllm import LLM, SamplingParams

# 基础采样参数设置
sampling_params = SamplingParams(temperature=0.7, max_tokens=256)

# 加载模型,推理引擎自动管理KV缓存
llm = LLM(
    model="your-model-path",
    tensor_parallel_size=1,
    gpu_memory_utilization=0.85
)

prompts = ["解释什么是AI Infra"]
outputs = llm.generate(prompts, sampling_params)

for output in outputs:
    print(f"Prompt: {output.prompt}")
    print(f"Result: {output.outputs[0].text}")
七、AI Infra可观测与运维
1. 监控指标体系
AI Infra不能等任务崩溃才发现问题,需要完整监控体系,分为三大类指标。
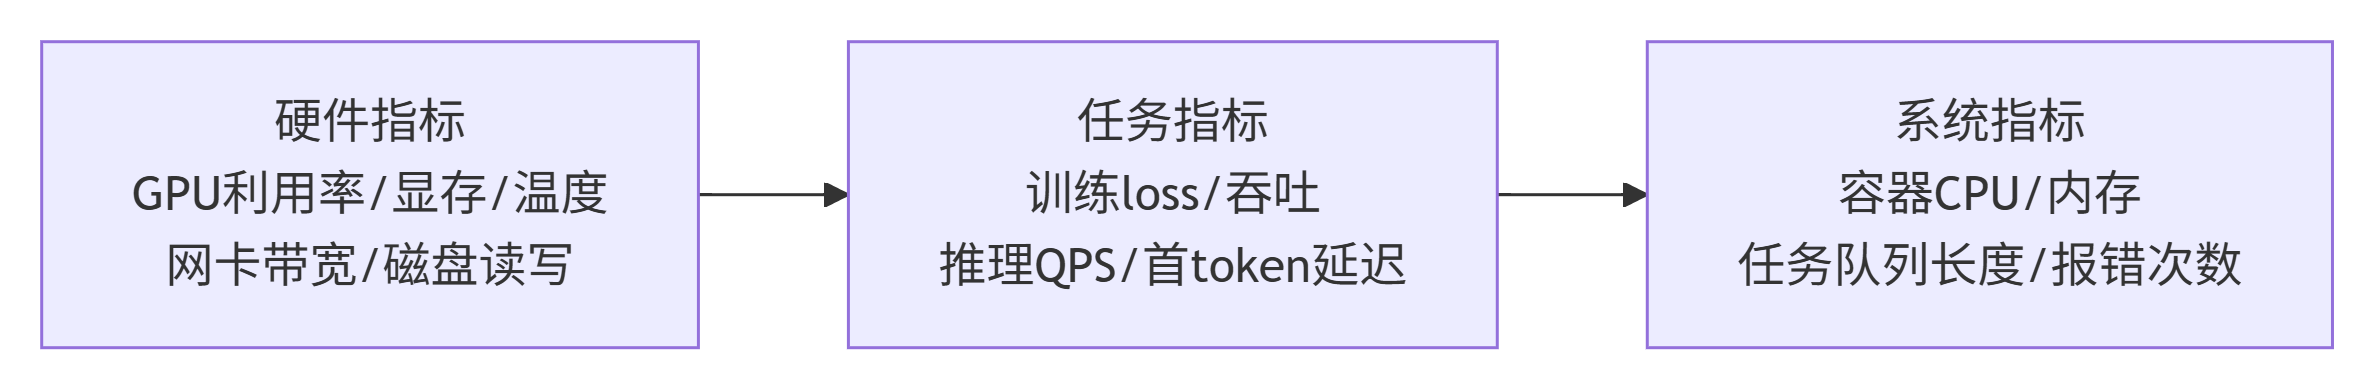
- 硬件指标:GPU利用率、显存、温度、网卡带宽、磁盘读写。
- 任务指标:训练loss、吞吐、推理QPS、首token延迟。
- 系统指标:容器CPU、内存、任务队列长度、报错次数。
常用组件:Prometheus采集指标,Grafana做可视化看板,Alertmanager配置告警。
2. 日志与链路追踪
- 日志:采集训练、推理服务日志,集中存储,任务报错快速检索定位。
- 链路追踪:OTel(OpenTelemetry),追踪一个请求从网关、负载均衡到推理引擎全链路耗时,定位瓶颈。 对于Agent、RAG这类多组件串联的大模型应用,链路追踪在AI Infra里越来越重要。
3. 告警体系
配置分级告警。
- P0紧急告警:推理服务宕机、显存溢出、集群节点离线,立刻通知运维。
- P1一般告警:GPU利用率持续过低、队列堆积,工作时间处理。
- P2观测指标:性能缓慢变化,长期观测,不需要紧急告警。
4. 故障处理
- AI集群常见故障:节点宕机、GPU硬件故障、网卡异常、磁盘损坏。
- 基础设施需要自动化能力:检测故障节点,自动驱逐上面的任务,调度到正常节点。
- 训练任务依靠checkpoint恢复;推理服务自动摘除故障实例。
八、AI Infra选型与优化
1. 三种部署形态
企业搭建AI Infra,有三种路线可选:
- 公有云:直接租用云厂商GPU集群。上手快,不用维护硬件,按需付费;长期大规模训练成本偏高。适合初创团队、实验场景。
- 私有化自建机房:采购服务器、搭建集群。一次性投入高,长期大规模训练成本更低;需要专业运维团队维护硬件。适合大厂、有私有化需求企业。
- 混合云:核心推理服务私有化部署,临时大规模训练任务使用公有云弹性算力。兼顾成本与数据安全,是很多中型团队选择。
2. 成本优化思路
AI算力成本极高,AI Infra设计很大一部分就是控成本:
- 任务混部,提升GPU利用率,避免大量卡空闲。
- 模型量化、蒸馏,降低推理显存需求,单卡承载更多并发。
- 按需弹性扩缩容,闲置时释放算力。
- 合理选择硬件,训练用高规格卡,推理选用性价比推理卡,不盲目统一采购高端训练卡跑推理。
3. 团队建设建议
搭建AI Infra,需要几类角色配合。
- AI平台工程师:搭建调度、模型管理、训练推理平台。
- 运维工程师:硬件、网络、存储维护。
- 算法工程师:使用平台提交训练、微调任务,反馈平台痛点。
- 后端工程师:负责推理网关、API服务开发。
小团队不需要一开始搭建全套复杂平台,可以从Ray+MLflow起步,最小化搭建基础AI Infra,随业务增长迭代完善,不要一步到位追求大而全。
九、总结
AI Infra是大模型时代的底层基石,很多人在做模型开发的时候容易忽略它,但它直接决定模型训练速度、线上服务稳定性与Token成本。AI Infra不是简单的GPU服务器堆砌,而是软硬件一体化平台,覆盖模型全生命周期。
硬件提供算力上限,调度系统负责资源分配,训练侧支撑模型迭代,推理侧支撑业务对外服务,可观测体系保障稳定运行。不同业务场景,AI Infra的选型方案完全不同:大规模预训练、SFT微调、线上推理,各自的硬件、网络、引擎选型都有差异。搭建AI Infra不要追求一步到位。可以从小规模集群起步,优先保证环境管理、任务调度、基础监控,随着业务规模增长再逐步升级高速网络、并行存储等重型组件。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号