#WorkBuddy# 8,080 个文件里揪出 760 处变更:目录同步的"快"与"对",我实测了三种策略
原创
#WorkBuddy# 8,080 个文件里揪出 760 处变更:目录同步的"快"与"对",我实测了三种策略
原创
用户12784192
发布于 2026-09-29 07:57:41
发布于 2026-09-29 07:57:41
作者所处行业与岗位:信息技术服务业 · 数据运维工程师(日常工作涉及多版本数据集的比对、校验与增量备份)
同步软件说"已是最新",你真的敢信吗?我把这个问题做成了一次可复现的实测:造两个版本的数据目录,注入 760 处已知变更,然后让三种比对策略去"找不同",看谁既快又对。
结论先说:最快的那一个错得最离谱(误报 4,486 个),而"看起来笨"的两级过滤反而是唯一和真值完全一致的方案。
一、测试怎么造的
项 | 值 |
|---|---|
基准目录 v1 | 8,000 个文件(6 个业务子目录、40 层分桶、6 种扩展名) |
对照目录 v2 | 8,080 个文件,合计 175.3 MB |
注入变更 | 修改 400、新增 160、删除 80、移动/重命名 120 → 共 760 处 |
额外干扰 | 另有 600 个内容未变的文件被改写了时间戳(模拟同步工具/拷贝操作对元数据的扰动) |
机器 | Windows,6 核 |
变更清单在生成时就记进真值表,最后拿它与每种策略的输出去对——没有真值,任何"比对工具"的结论都不可信。
二、三种策略,三种代价
A 全量 SHA256:遍历所有文件,逐个算哈希再比。最稳,但要读完 350 MB(两个版本各 175 MB)。
B 只看属性:只比 (文件大小, 修改时间),不读内容。理论上快到极致——代价是它无法区分"内容真的变了"和"只是元数据被动过"。
C 两级过滤 + 移动识别:先用属性把绝大多数文件快速排除,只对"大小相同、时间不同"的可疑项落盘算哈希;再用内容哈希把"删除项"和"新增项"配对,识别出移动/重命名。
三、实测数据:快不等于对
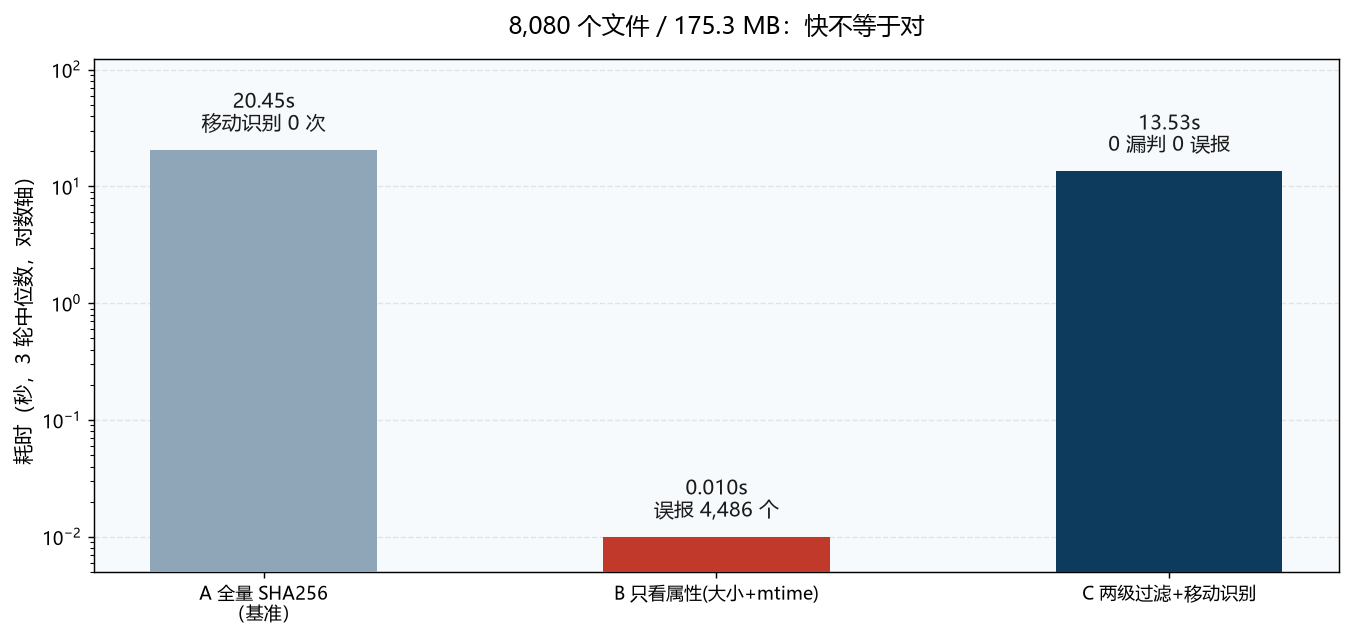
策略 | 耗时(3轮中位数) | 吞吐 | 结果 |
|---|---|---|---|
A 全量 SHA256 | 20.45 s | 17.1 MB/s | 准确,但移动被判成"删+增" |
B 只看属性 | 0.010 s | — | 误报 4,486 个"已修改" |
C 两级+移动识别 | 13.53 s | 25.9 MB/s | 0 漏判 0 误报,与真值完全一致 |
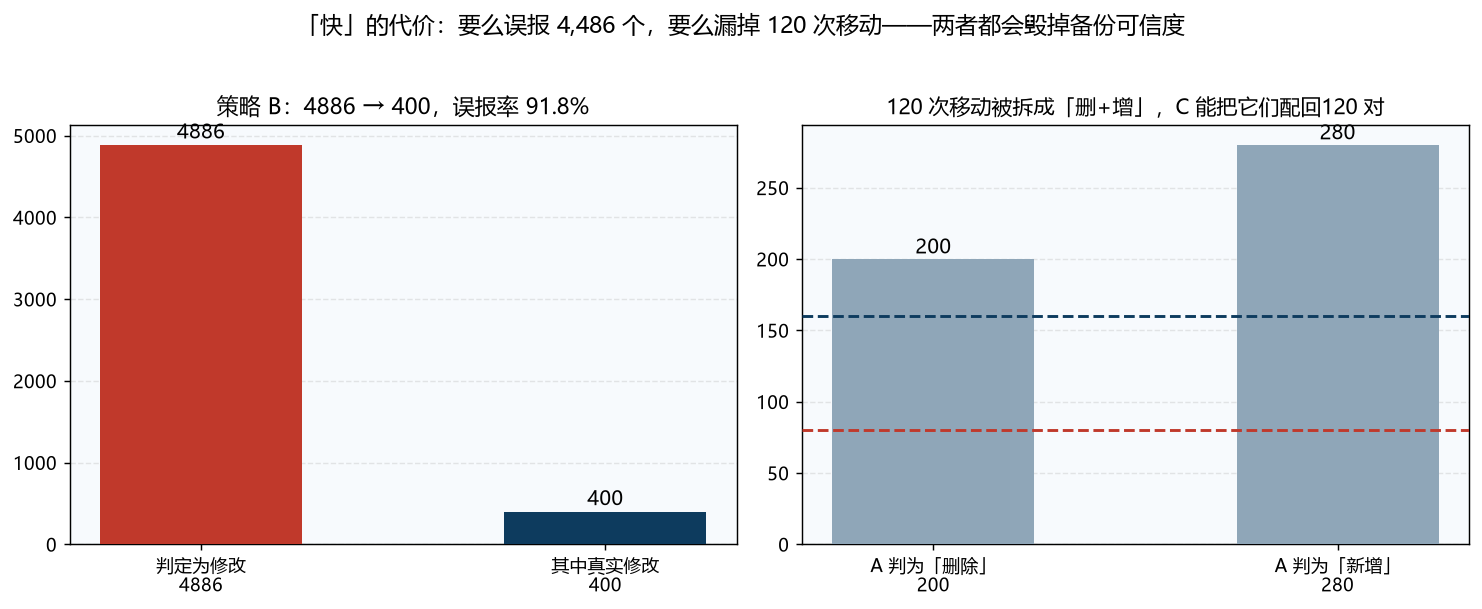
B 比 A 快 2000 倍——但这个"快"是假的:它把 4,886 个文件报成"已修改",而真正被修改的只有 400 个,误报率 91.8%。如果你按它的结果做增量同步,等于每次都要重传近 5,000 个根本没变的文件;反过来,如果依赖它判断"要不要告警",你会被彻底淹没。
四、同一份数据,四种口径
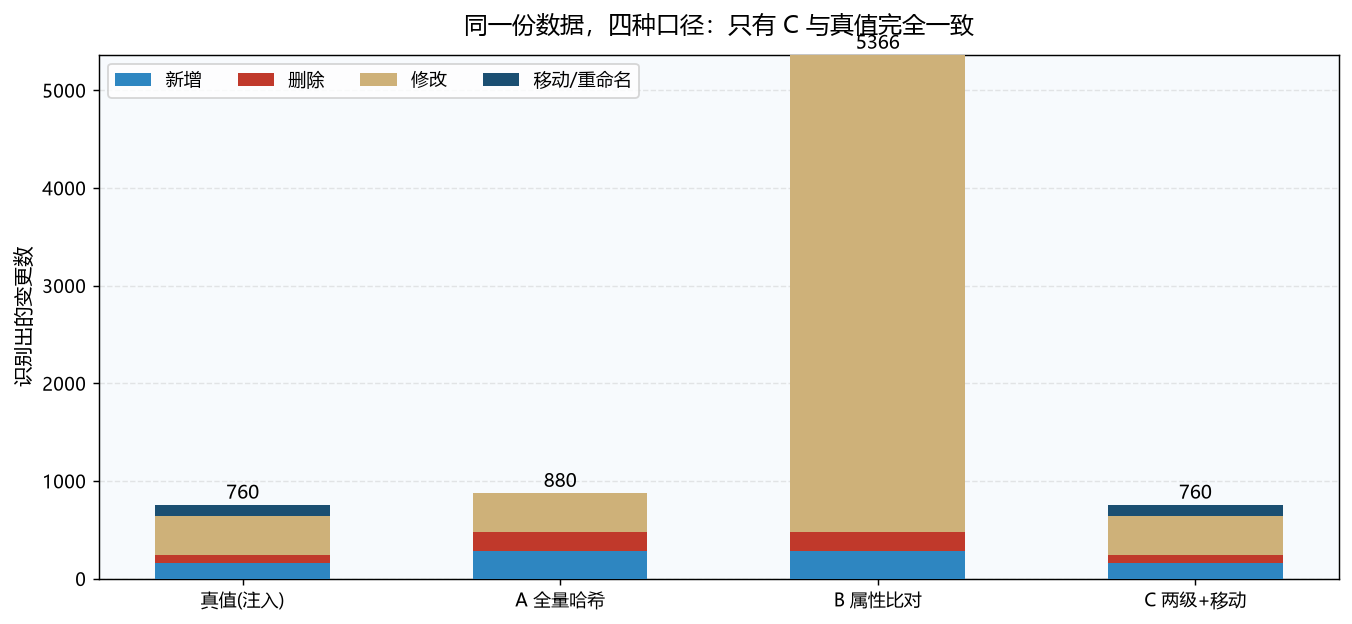
这张图是整件事的核心。真值(注入)是 760 处:
- A 全量哈希报出 880 处。多出来的 120 是从哪来的?——它把每次移动都拆成了"删一个 + 增一个",所以 80 删除 → 200、160 新增 → 280。内容层面它没说谎,但它丢掉了"这两个是同一个文件"这个信息。
- B 属性比对报出 5,366 处,其中 4,886 个是误报。
- C 两级+移动识别报出 760 处,且分布完全对得上:新增 160 / 删除 80 / 修改 400 / 移动 120。
五、两个真实的坑
坑一:时间戳靠不住,尤其跨设备。
我造数据时是"重新写入"v2 的——结果第一批测试里 8,000 个文件全部被判为已修改,因为重写文件的 mtime 天然是新的。后来改成模拟 rsync -p / cp -p 保留时间戳,结果才回到真实:剩下 4,486 个误报,来自我注入的 600 个元数据扰动,以及 mtime 纳秒精度在跨设备复制时的漂移。
这个坑说明一件事:只要备份链路里出现过一次"拷贝工具没保留时间戳",基于 mtime 的判断就会全面崩掉,而这恰恰是 B 策略的全部依据。
坑二:把"移动"当成"删+增",你的备份会自己膨胀。
移动 120 个文件,在 A 的视角里是"删了 200、增了 280"。对同步工具来说,这意味着120 份数据被当作新文件重新传输;对磁盘配额来说,这意味着归档目录会越来越胖。识别移动并不难——删除项和新增项内容哈希相同,就是同一次移动,只是几乎没人做这一步。
六、核心代码:两级过滤 + 移动配对
import hashlib, os

def sha256(p, blk=1 << 20):
    h = hashlib.sha256()
    with open(p, "rb") as f:
        while (b := f.read(blk)):
            h.update(b)
    return h.hexdigest()


def diff_dirs(RA, RB, a, b):
    """a/b: {相对路径: (大小, mtime_ns)};两级过滤,可疑项才落盘哈希"""
    added, deleted, modified, suspect = [], [], [], []

    for rel in sorted(set(a) | set(b)):
        if rel in a and rel not in b:
            deleted.append(rel)
        elif rel in b and rel not in a:
            added.append(rel)
        elif a[rel][0] != b[rel][0]:
            modified.append(rel)                 # 大小变了,无需读内容
        elif a[rel][1] != b[rel][1]:
            suspect.append(rel)                  # 大小同/时间变 -> 才需要哈希

    for rel in suspect:                          # 只对可疑项读盘
        if sha256(os.path.join(RA, rel)) != sha256(os.path.join(RB, rel)):
            modified.append(rel)

    # 用内容哈希把「删除项」与「新增项」配对,还原移动/重命名
    by_hash = {}
    for rel in deleted:
        by_hash.setdefault(sha256(os.path.join(RA, rel)), []).append(rel)

    moved, real_added = [], []
    for rel in added:
        h = sha256(os.path.join(RB, rel))
        if by_hash.get(h):
            moved.append((by_hash[h].pop(0), rel))
        else:
            real_added.append(rel)

    return {"added": real_added, "deleted": [x for v in by_hash.values() for x in v],
            "modified": modified, "moved": moved,
"suspect_hashed": len(suspect)}关键只有两处:suspect 列表让读盘量从"全部文件"降到"可能变了的文件";by_hash 配对让"删+增"重新变成"移动"。
七、沉淀成可复用的提示词
我有两个版本的目录(或同一个目录的两个时间点快照),需要一份可信的差异报告。 请按三步做:①只读元数据(大小、mtime),把"大小不同"直接判为修改,把"大小相同但时间不同"列为可疑项; ②只对可疑项计算 SHA256 落盘比对,不要全量读盘;③把删除集与新增集按内容哈希配对,识别出移动/重命名; ④最后断言:本次判定为"修改"的文件,必须逐个经哈希确认,并在报告里给出"可疑项数 / 实际修改数 / 误报率"。 输出三样东西:一张耗时表、一份变更构成清单、一句结论——哪些文件真的需要重新同步。
第 ④ 条是整个流程的价值所在:它把"我可能报错了"变成一个必须交代的数字。
小结
维度 | A 全量哈希 | B 只看属性 | C 两级+移动 |
|---|---|---|---|
耗时 | 20.45 s | 0.010 s | 13.53 s |
漏判 | 0 | 0 | 0 |
误报 | 0 | 4,486 | 0 |
移动识别 | ✗(拆成删+增) | ✗ | ✓ 120/120 |
读盘量 | 350 MB | 0 | 仅可疑项 |
真正可信的比对,不是最快的那条路,也不是最笨的那条路,而是先快速排除、再精确验证、最后把"移动"还原出来的那条路。20 秒和 13 秒的差别,远小于"报错 4,486 个"和"一个都没报错"的差别。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号