#WorkBuddy# 实战二:数据流水线中断 11 天后如何补齐复盘——断点恢复+口径交叉验证,附 4 个新坑
原创
#WorkBuddy# 实战二:数据流水线中断 11 天后如何补齐复盘——断点恢复+口径交叉验证,附 4 个新坑
原创
来者何人
发布于 2026-09-28 21:05:35
发布于 2026-09-28 21:05:35
#WorkBuddy# 实战二:数据流水线中断 11 天后如何补齐复盘——断点恢复 + 口径交叉验证,附 4 个新坑
上一篇《#WorkBuddy# 实战:一句话搭起每日数据复盘流水线》讲了怎么把一条全市场数据扫描流水线跑起来。这篇讲一个更真实的场景:流水线跑挂了 11 天,怎么补。
一、事故现场:数据在,报告没了
9/17 那天,流水线其实完成了大半工作:采集脚本已运行完毕,全市场快照数据已落盘。但在"生成报告"这一步之前,会话意外中断——之后 9/18 到 9/25,缺口一天天滚大,直到 9/28 恢复运行。
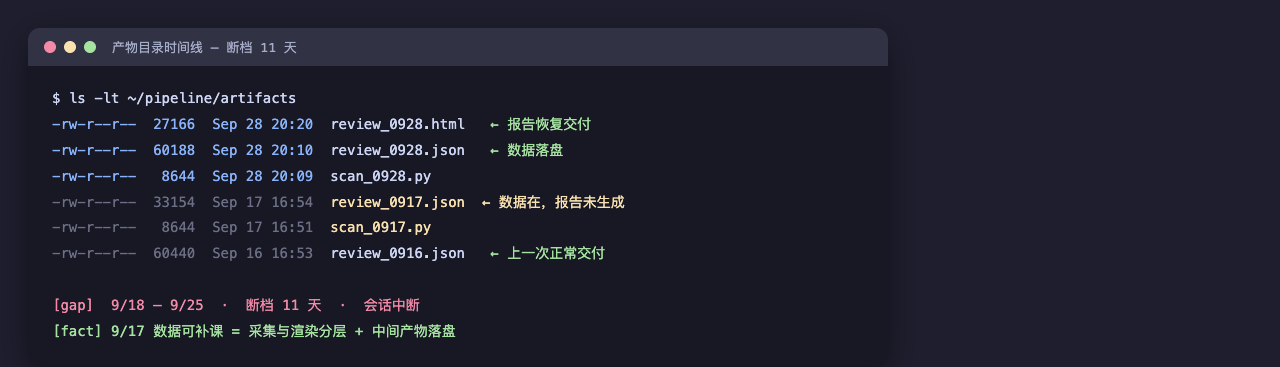
断档11天的产物时间线
事后看产物目录,时间线一目了然:
- 9/16 16:53
review_0916.json✅ 报告已交付 - 9/17 16:54
review_0917.json⚠️ 数据落盘了,但报告永远没生成 - (9/18 – 9/25:断档 11 天)
- 9/28 20:10
review_0928.json✅ 恢复运行
能补课的前提是当初的一条设计铁律:
先落盘,后渲染。 中间产物(JSON)一旦写到磁盘,报告任何时候都能重新生成;反过来,只存在会话内存里的中间状态,会话一死就全没了。9/17 的数据救回来了,不是因为运气,是因为采集和渲染是两个独立阶段。
二、恢复运行后新踩的 4 个坑
坑 1:分钟数据的 time 字段是四位字符串
上游接口的分钟线 time 字段长这样:"0930"——四位字符串,不是日期对象,也不是带冒号的时间串。如果按上一次的假设去"按日期格式切片",切出来全是垃圾字符。外部数据的字段格式变了要第一时间打印样本确认,而不是沿用上次的假设。
坑 2:全量快照的字段全是字符串
全市场快照接口返回 dict{code: row},row 里每个字段——价格、涨跌幅、上限价——全是字符串。不做类型清洗就排序/筛选,会触发 Python 的字典序比较:
"9" > "10"          # True —— 字符串比较,静默出错
float("9") > float("10")   # False —— 清洗后正确
这类 bug 最阴险的地方是不报任何异常,只是安静地给你错的数据。防御做法是入口处统一过一遍清洗函数:
def to_f(v):
    try:
        return float(str(v).replace(",", ""))
    except Exception:
        return None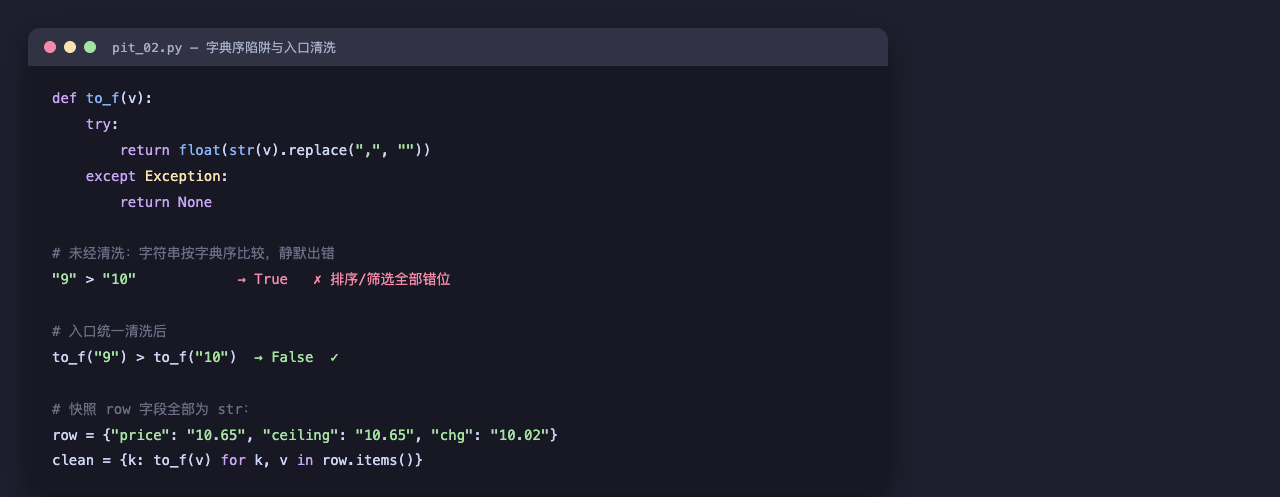
字符串字典序陷阱
坑 3:管道分隔表格的列号是隐性契约
第三方数据工具输出管道分隔的表格,资金流数据在第 12、13 列,于是用了 awk -F'|' '$12/$13' 硬编码取列。隐患在于:上游哪天在中间插一列,所有列号悄悄错位——不会报错,只会持续给你错位的数据。防御做法:启动时先解析表头,按列名定位列号,把"隐性契约"变成显式校验。
坑 4:媒体口径 ≠ 你的口径,差异是信息不是错误
数据补齐后做交叉验证,发现自算结果和几个第三方平台的数字对不上:
指标 | 自算 | 第三方平台 | 差异来源 |
|---|---|---|---|
上涨/下跌家数 | 894 / 4544 | ≈896 / 4500+ | 样本集范围不同(是否含部分特殊样本) |
触限家数 | 35 | 57 | 统计时点不同(盘中快照 vs 收盘定格)+ 计数规则差异 |
连续触限延续率 | 30.8% | 23.08% | 是否计入"全天零成交"的特殊样本 |
三个排查顺序,值得写进任何数据团队的口径文档:
- 先对样本集范围——你的全集是 5554 个样本,对方可能天然剔除了一部分;
- 再对统计时点——盘中快照和收盘定格,在极端分布的日子里差异会被放大数倍;
- 最后对特殊样本规则——零成交样本计不计入,对"延续率"这类比率指标影响巨大:分母差 4 个样本,比率差 7.7 个百分点。
交叉验证的目的不是"对数字",是对口径。 把差异原因写下来,下次再对不上时 30 秒定位是口径问题还是流水线 bug,而不是翻两小时代码怀疑人生。
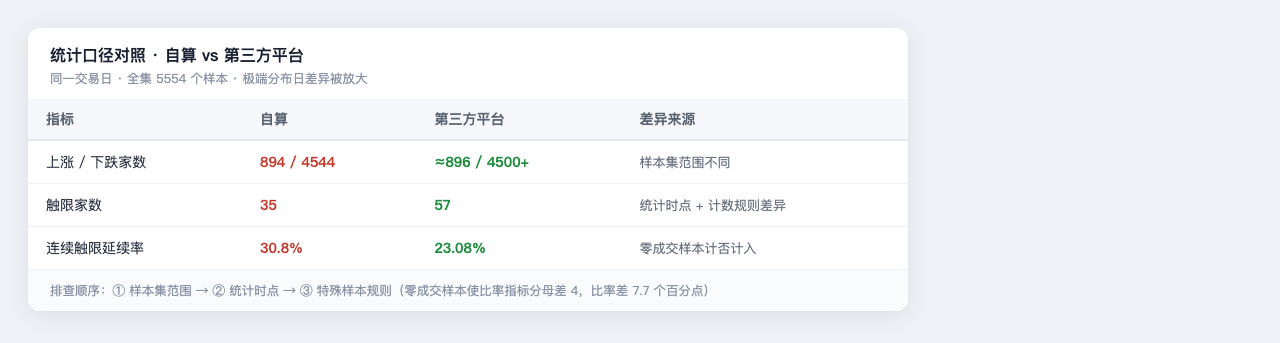
统计口径对照表
三、工程启示
- 三层分离:采集脚本、中间数据(JSON)、最终报告各自独立成产物,任何一层都能单独重跑——这是 11 天断档只损失报告、不损失数据的根本原因;
- 入口清洗:所有外部输入先过类型清洗,别信"上游说好了是数字";
- 显式解析:解析表格先读表头,不硬编码列号;
- 口径优先:与第三方数据比对,先对齐口径,再比对数值。
这四条单看都不难,但每一条都是真实事故换来的。下一篇打算讲这条流水线在极端分布日的表现:35 vs 60 的极端不对称样本下,哪些统计指标会失真。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号