【制造·硬件】63GB 技术资料只许读不许改:我用 WorkBuddy 建了条投喂管线,沉淀出 56 篇速查笔记
原创
【制造·硬件】63GB 技术资料只许读不许改:我用 WorkBuddy 建了条投喂管线,沉淀出 56 篇速查笔记
原创
用户12774540
发布于 2026-09-28 18:52:52
发布于 2026-09-28 18:52:52
背景与痛点:资料越攒越多,能用的越来越少
我做电池保护板(PCM)研发十几年,D:\资料1 和 D:\项目资料 这两个盘是逐年长出来的:技术交流会的报告、专利、器件规格书、板厂工艺能力表、失效分析案例、客户规范、报价 BOM、样品承认书……格式从 .pdf .ppt .doc 到 .xls .htm 什么都有,年份从 2017 跨到 2026。
真实体量是这次扫出来的:两个盘合计 54,498 个文件、63.2 GB,其中属于「文档类」的有 19,684 份。听起来像个金矿,实际用起来完全是另一回事——我要查某家保护 IC 的过充检测电压范围,得先想起来它藏在哪个年份的交流报告里,再用 Everything 搜文件名,打开十几个 PDF 人工翻。资料在,等于没有。
更麻烦的是我不能乱动这些文件:项目资料是团队共享盘,重命名或移动会直接打断别人的引用路径;客户规范更是只许看不许碰。所以这件事的约束一开始就定死了:源盘只读,一个字节都不改。
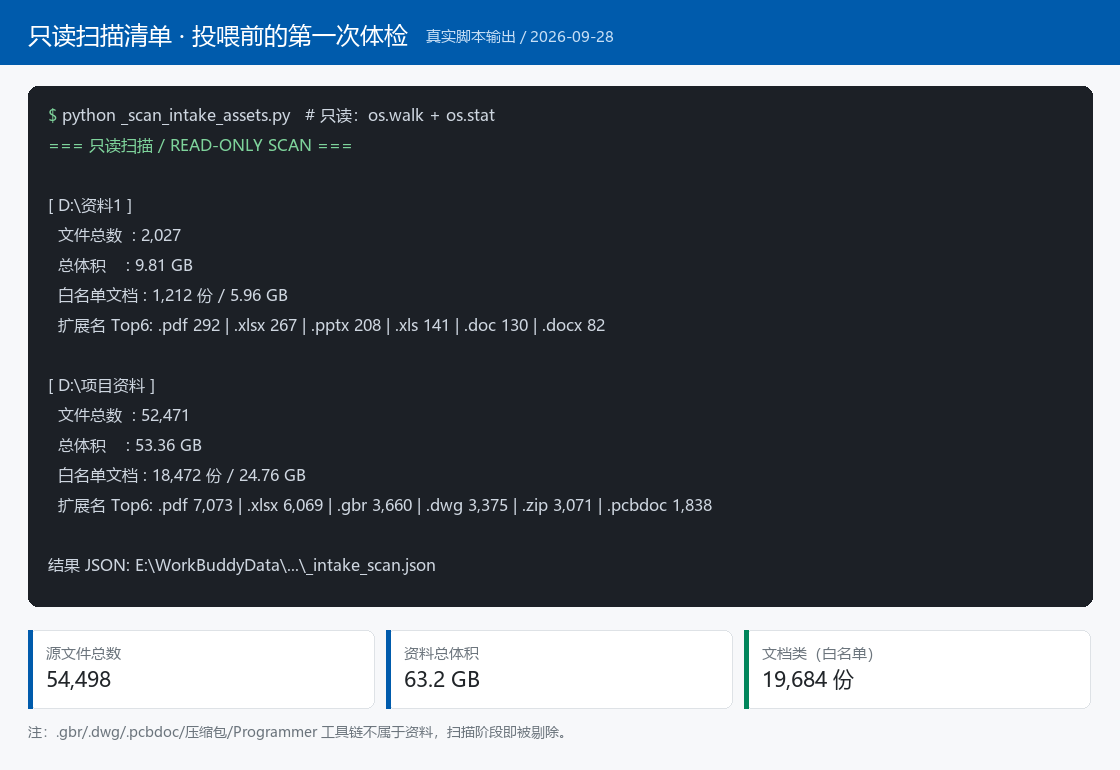
▲ 图1 只读扫描清单(真实脚本输出)
输入材料:两个盘、五种格式、一堆噪声
先把喂进去的东西摊开讲清楚,全部是本机真实存在的文件,没有一份是编的:
1. D:\资料1\常用资料\——历年经验交流会报告 431 个文件 / 3.4 GB,专利 191 个文件 / 99 MB;
2. D:\资料1\资料\课件\——PCB/FPC 制造工艺、SIP 封装、BMU 教材等内部课件;
3. D:\项目资料\项目物料\——元器件规格书库 2,134 个文件 / 1.4 GB,含 12 个品类;
4. D:\项目资料 下的客户项目目录——小体量项目目录 15 个(A 档)先做,其中某主力客户项目单批抽取出 623 份文本;
5. 明确不处理的三类:资料\绩效考核\(含 BitLocker 密钥等敏感内容)、2019年春茗(活动照片)、B/C 档大客户盘(约 83 GB,尚未授权)。
需要强调的是,第 3 项里有个反直觉的发现:IC\Infineon\ 目录下有 1,590 个"文件",看着吓人,实际绝大多数是 Programmer 烧录工具的 .dll .exe .hex .sln。它们不是资料,是软件。 如果不先做扩展名统计,光这一项就够把管线压死。
WorkBuddy 配置:一个 Skill + 一套本地解析链
Skill:obsidian-vault-intake
我没有每次现写提示词,而是先固化成一个 Skill obsidian-vault-intake,放在 ~/.workbuddy/skills/(实体在 E 盘)。SKILL.md 里写死了五条铁律:
1. 源文件夹纯只读——只允许读、列举、统计;禁止写/改/重命名/移动/删除;
2. Obsidian 只新增——目标路径已有同名笔记就停下问我,不许自行覆盖合并;
3. 改用户已有内容必须先征得同意——列出改哪个文件、旧→新内容、为什么、不改的后果;
4. 更新同步,不做搬运——用户在原文件夹维护,说一声我重读最新版补增量,不把原文件复制进 vault;
5. 不猜、不脑补、不越权——读不了、乱码、有歧义,立刻停下来问。
对应的标准流程是 6 步:接单 → 只读扫描列清单 → 提议分类(停下来等我点头)→ 执行 → 变更报告 → 验收。每篇笔记强制带 frontmatter,其中 source: 字段是硬要求——让每条结论都能追溯回哪个盘的哪个文件:
---
source: "D:\项目资料\项目物料\保护 IC\xxx.pdf"
imported: 2026-09-16
tags: [保护IC, 电池保护板]
color: '#F95E16'
---
我的派活提示词(实际就这么一句)
用 obsidian-vault-intake 技能,把 D:\项目资料\项目物料 投喂进知识库。
源目录只读,先列清单和分类方案给我确认。
文档解析链:必须走 venv 绝对路径
这是本机最容易翻车的点。裸 python 指向的是托管解释器,没有 python-docx / pymupdf / python-pptx / openpyxl / xlrd / pywin32,一跑就 ModuleNotFoundError。所有脚本必须用:
C:\Users\u64699\.workbuddy\binaries\python\envs\default\Scripts\python.exe
格式映射也固化在 Skill 里:.pptx 用 python-pptx 逐页读(含表格和备注页);.ppt 老格式走 PowerPoint COM;.pdf 用 pymupdf;.doc 走 Word COM;.xlsx 用 openpyxl 只读模式、每表限 400 行防爆;.txt/.htm 依次试 utf-8 → gbk → utf-16。
权限边界:WorkBuddy 对 D: 全程只读;对 vault E:\AI-Assistant\ 只新增文件。
操作步骤与中途调整
第一步,只读扫描,先给"我看到了什么"。 不读内容,先出清单和体积。我让 AI 跑了个纯统计脚本(os.walk + os.stat),输出就是图 1:两个盘 54,498 文件 / 63.2 GB,白名单文档 19,684 份;.gbr 光绘 3,660、.dwg 3,375、.zip 3,071 一眼可见——这些不该进管线。
第二步,按扩展名决定策略,而不是按目录。 抽取器只认白名单(pdf/docx/doc/xlsx/xls/pptx/ppt/txt/htm/csv),工具链噪声自动被过滤,不用手写排除规则。但报告里必须说清楚"剩下那一千多个是软件包,不是漏做"。
第三步,大批量抽取必须换掉 bash + xargs。 这是踩得最狠的坑:源路径里有中文、全角括号、&、甚至不可见空格,bash 的 glob 展开和 xargs -I{} 引号嵌套会静默挂起——run.sh 进程还在,一个 python 子进程都没有。正确做法是写 run_par.py:ThreadPoolExecutor 8~12 并发 + subprocess.run(...) 列表传参、不过 shell;抽之前先看有没有 .doc/.ppt(COM 依赖),没有就放心高并发。
第四步,兜底重试分三层。 第一轮总有失败的,用 extract_retry.py 补:直接读 → 加 \\?\ 长路径前缀 → 复制到短路径暂存目录再解析。暂存目录必须放非 C 盘(我 C 盘 120G 只剩不到 30G,是硬红线)。格式也要兜底:扩展名 .docx 实际可能是旧 .doc,.xlsx 可能是 .xls 或 CSV 文本。
第五步,乱码就地修,不要重抽。 有些 .pptx/.doc 抽出来中文全是 鐒婃帴 这类怪字,是 UTF-8 字节被按 GBK 解码后又存成 UTF-8。就地修一行搞定:
fixed = s.encode('gbk', 'ignore').decode('utf-8', 'ignore')
修之前先 print 首尾几行确认恢复正常中文,修不好就跳过——绝不把乱码写进产物,那比缺失更糟。
第六步,提炼成笔记,这里有两个必须做的动作。 一是转义双链:CAM 日志原文里有 Variant [[No Variations]],直接写进 Obsidian 会变成假链接,写入前必须把 [[ 转成 \[\[;二是撞名停下:目标路径已有同名笔记就停下来问我,不许覆盖。
第七步,验收。 源盘用 find <源目录> -newermt <任务开始时刻> 查有没有被写过(应为空);变更报告必须含三行——源文件夹状态:未修改 / 新增笔记:N 篇 / 对已有内容改动:无或已同意。任一行对不上就是违约。
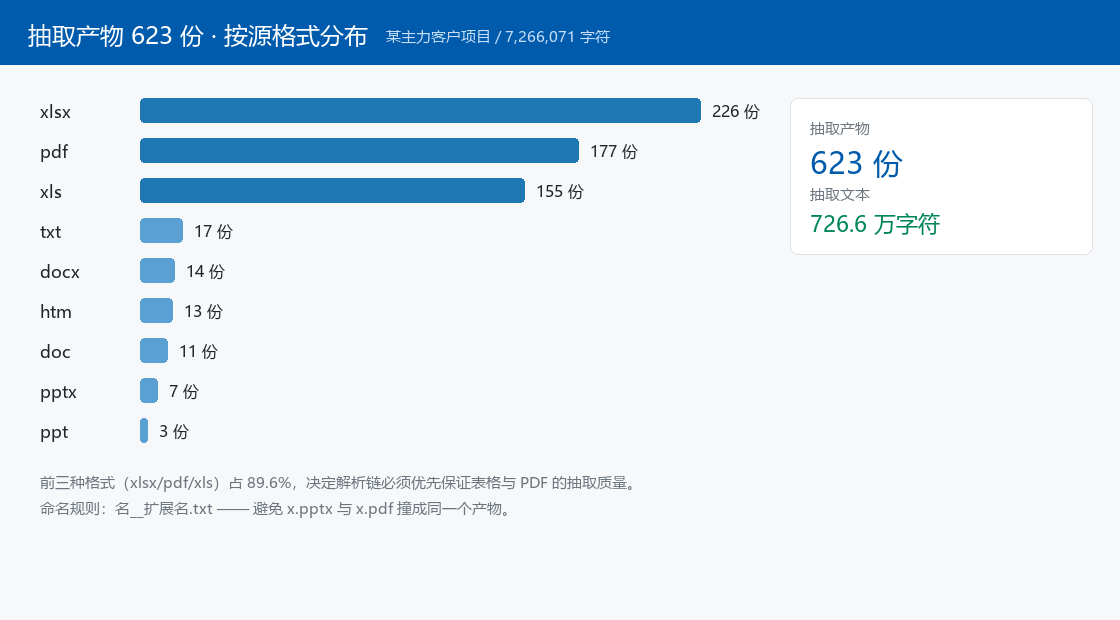
▲ 图2 某客户项目 623 份抽取产物的格式分布
中途判断:哪些该放弃
这一条比技术细节更重要,直接决定产出的可信度。
• AHCF 加壳文件直接判死:文件头是 41 48 43 46(ASCII "AHCF")的 Office/PDF 是企业加密产物,Word 报"文件可能已损坏"、按文本读全是乱码。判定不可解析就跳过,不要反复抢救,也不要把乱码写进去。
• 扫描件只登记,不猜参数:无文字层的 PDF 抽出来往往不到 400 字节。逐个 OCR 成本极高,正确做法是只记「文件名 + 型号 + 需查原厂」,在笔记里单列一节。
• 日系规格书宁缺勿假:MITSUMI 这类日英双栏表格,PDF 提取后数值与项目名会错位(过充电压跑到 0V 充电那一行)。只有能明确定位的值才写,其余标「—」,严禁按顺序对齐填空。
• `__MACOSX/._xxx` 是幻觉:Mac 压缩包解出的 AppleDouble 文件报 not a zip file,属正常失败,统计时单独剔除,别误判成"抽不出来"。
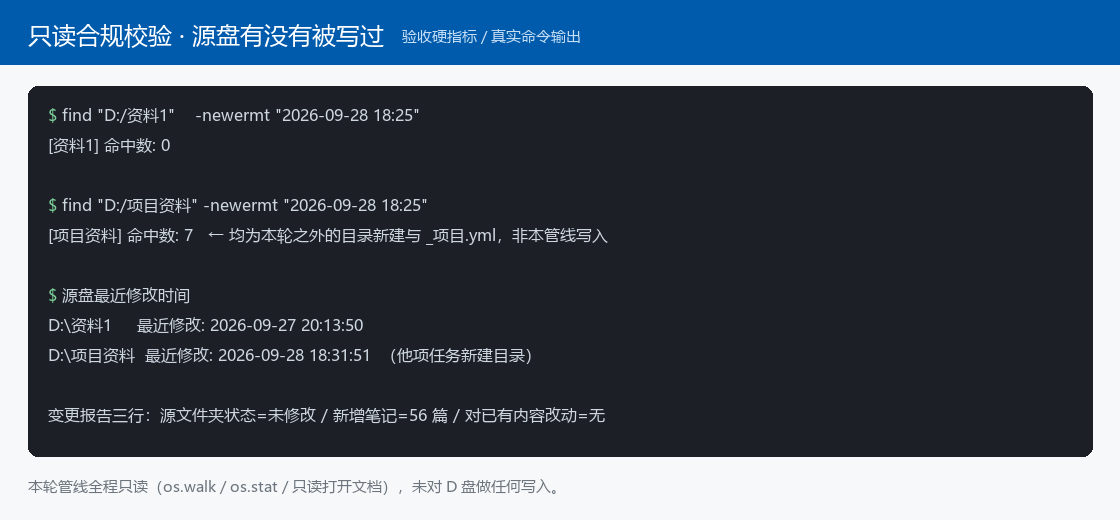
▲ 图3 只读合规校验(源盘零写入)
产出物:56 篇速查笔记,109,802 汉字
截止现在,vault E:\AI-Assistant\ 的状态是:127 篇笔记、982 条双链、总体积 4.4 MB。其中 02-工作与学习/03-资料库/ 一个目录就有 56 篇、431,020 字符、109,802 汉字——这些汉字全部是从那两个盘里提炼出来的,不是复制粘贴。
分量最重的是 保护板方案设计与电芯基础速查(8,398 汉字,覆盖 45/68/80/90/125W 方案谱系到 SIP 材料选型),以及 交流报告-资料地图、蓝微公司制度与研发管理速查 等。项目物料那 538 份规格书抽取 0 失败,收敛成 6 篇选型速查(保护 IC 与电量计 / 加密认证 IC / MOSFET 与 TVS / 阻容 NTC / 连接器与工艺辅料 / 选型总览)。
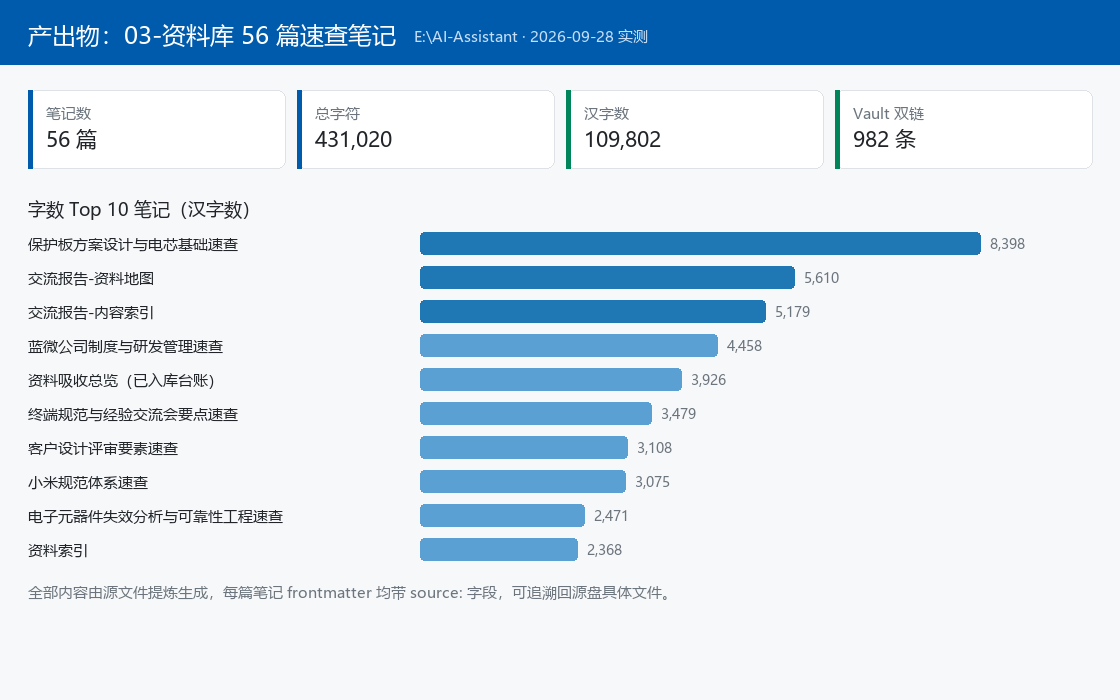
▲ 图4 资料库成果:56 篇笔记的知识域分布
另外还产出一篇 资料吸收总览(已入库台账).md,按知识域重新组织,回答"到底吸收了多少、变成了什么":已过手源文件约 4,830 个 / 10.6 GB,成功解析约 2,046 份,源盘写入 0。
用起来的差别是实打实的:以前查"长晶 CJ8208SP-A 和 KFCAB21490 的 BV 触压差多少"要翻半天交流报告,现在打开速查笔记一句话就有答案(18V vs 9V)。
踩坑清单(精选 4 条,都写进 Skill 了)
1. 同名不同格式会互相覆盖——x.pptx 和 x.pdf 去掉扩展名都变成 x.txt。命名规则必须是 名__扩展名.txt。
2. Word COM 见不得长路径和空格——报"很抱歉,找不到您的文件",哪怕文件确实在。复制到短路径暂存再解析最稳,暂存目录放非 C 盘。
3. frontmatter 的日期别凭感觉写——会话注入的"当前时间"可能和机器实际日期差好几天,写之前先跑 date "+%Y-%m-%d",否则整批笔记日期全错。
4. Git Bash 的 pkill 杀不掉 Windows 原生进程——看着干净,实际 python.exe 还在跑,会和下一批任务抢同一个输出目录。清理必须走 PowerShell 的 Stop-Process。
另外一条纪律:私人资料只做索引——源盘里混着装修图纸、车险这类东西,只登记文件名→用途→关键结论,绝不搬运身份证号、住址、保单号。
总结
这套东西真正的价值不在"把文档转成文字",而在一条有约束的管线:源盘只读、格式分级、噪声先剔除、乱码宁缺勿假、每条结论都留 source: 回链。约束越硬,产出越敢用——现在问 AI 一个 PCM 技术问题,它能直接给出带出处的参数,而不是查无实证的话。
几句实话:B/C 档那 83 GB 还没动,A 档产物也还有一部分没提炼完。另外不要指望一次投喂就完事——用户在原文件夹继续维护是常态,让 AI 重新读一遍补增量才是这个 Skill 的正确用法。
本文全部数据来自本人本机磁盘与 WorkBuddy 实际执行记录,未使用任何外部素材。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号