#WorkBuddy# 300 份学员台账,我用一条"先校验再入账"的流水线整理完(教育培训场景完整案例)
原创
#WorkBuddy# 300 份学员台账,我用一条"先校验再入账"的流水线整理完(教育培训场景完整案例)
原创
用户12784192
发布于 2026-09-28 15:32:01
发布于 2026-09-28 15:32:01
行业与岗位:教育培训机构 教务岗(数据为脚本合成的脱敏样例,固定随机种子,不含任何真实机构与个人信息)
每到结课季,教务岗最头疼的不是统计,而是台账本身不干净。这次我用 WorkBuddy 把"整理学员台账"从一件手工活,做成了一条先校验、再入账、最后出报告的流水线:300 行台账跑到可交付,用时 0.61 秒,并且留下了一份能逐条核对的问题清单。
一、输入材料
一份从业务系统导出的学员台账,9 个字段:
字段 | 说明 |
|---|---|
学员编号 | 业务主键,理论上唯一 |
姓名 / 班级 | 分班统计维度 |
报名日期 | 期次划分依据 |
总课时 / 已消课时 | 课时消耗进度 |
作业均分 | 教学质量参考 |
出勤率 | 续报风险预警 |
联系电话 | 家校沟通 |
规模与体积:300 行 × 9 列,21.8 KB。为了确保案例可复现,我用脚本按固定种子合成了这份台账,并注入 6 类真实台账里最常见的脏数据(重复编号、姓名缺失、课时逻辑冲突、出勤率越界、电话格式非法、作业分缺失)。
二、WorkBuddy 配置
项 | 配置 |
|---|---|
运行环境 | Windows + 本地 Python 3.13(WorkBuddy 内置运行时) |
依赖 |
|
数据源 |
|
产出目录 | 清洗后台账、待核对名单、统计报告、4 张配图 |
关键约定 | 凡是会被"剔除"的行,必须先落盘到待核对表,再参与统计 |
最后一条是整个流程的护栏:任何被剔除的数据都不能只存在于内存里,否则一旦统计口径被质疑,就再也说不清少算了谁。
三、操作步骤
第 1 步:读取并锁定字段类型。 编号和电话必须按字符串读,否则 EDU0007 会被吃掉前导零、手机号会被转成科学计数法。
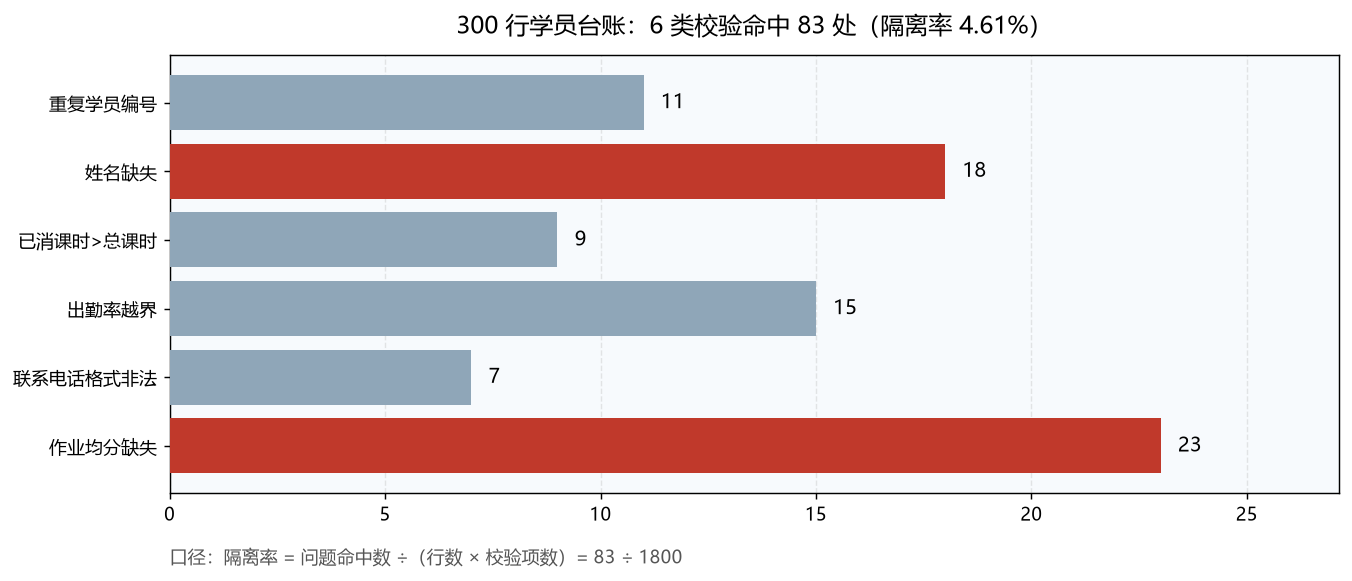
第 2 步:跑 6 类校验并分类处置。 每一类问题都对应一个明确的处置动作,而不是笼统地"删掉脏数据":
校验项 | 命中 | 处置方式 |
|---|---|---|
重复学员编号 | 11 处 | 保留首条,其余转待核对表 |
姓名缺失 | 18 处 | 转待核对表(需补录) |
已消课时 > 总课时 | 9 处 | 标记异常,人工确认后修正 |
出勤率越界 | 15 处 | 置为缺失,不参与均值 |
联系电话格式非法 | 7 处 | 转待核对表 |
作业均分缺失 | 23 处 | 置为缺失,不参与均值 |
第 3 步:执行"行数守恒"断言。 这是我认为最值得抄走的一步——清洗后行数 + 待核对行数必须等于原始行数,不相等就直接中断:
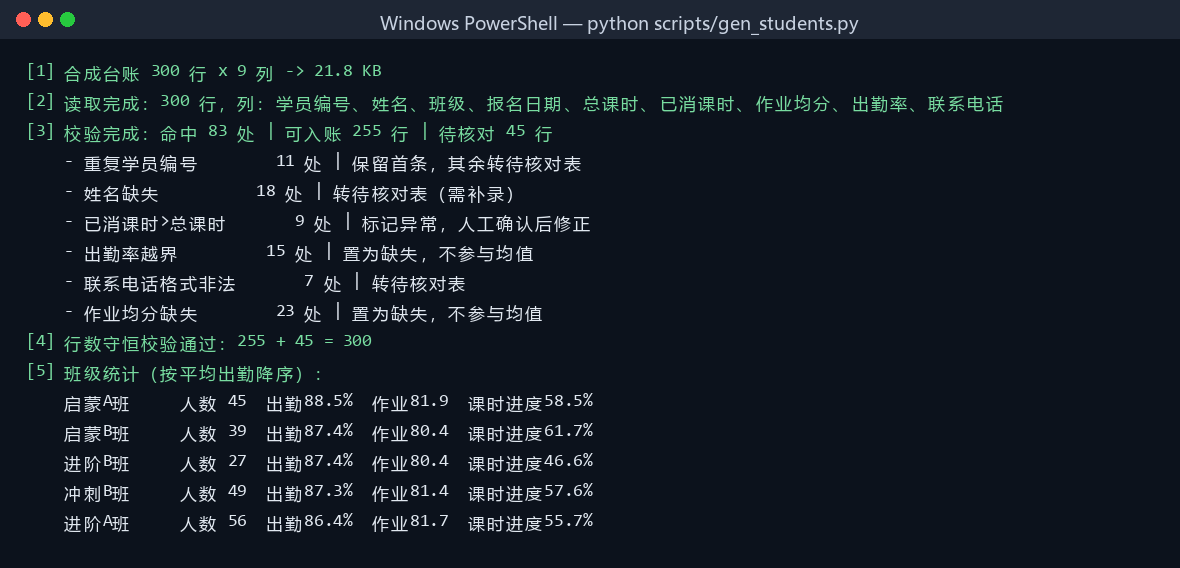
运行输出(节选):
[4] 行数守恒校验通过:255 + 45 = 300
第 4 步:按班级做横向统计。 人数、平均出勤率、平均作业分、课时消耗进度四个指标一次算完。
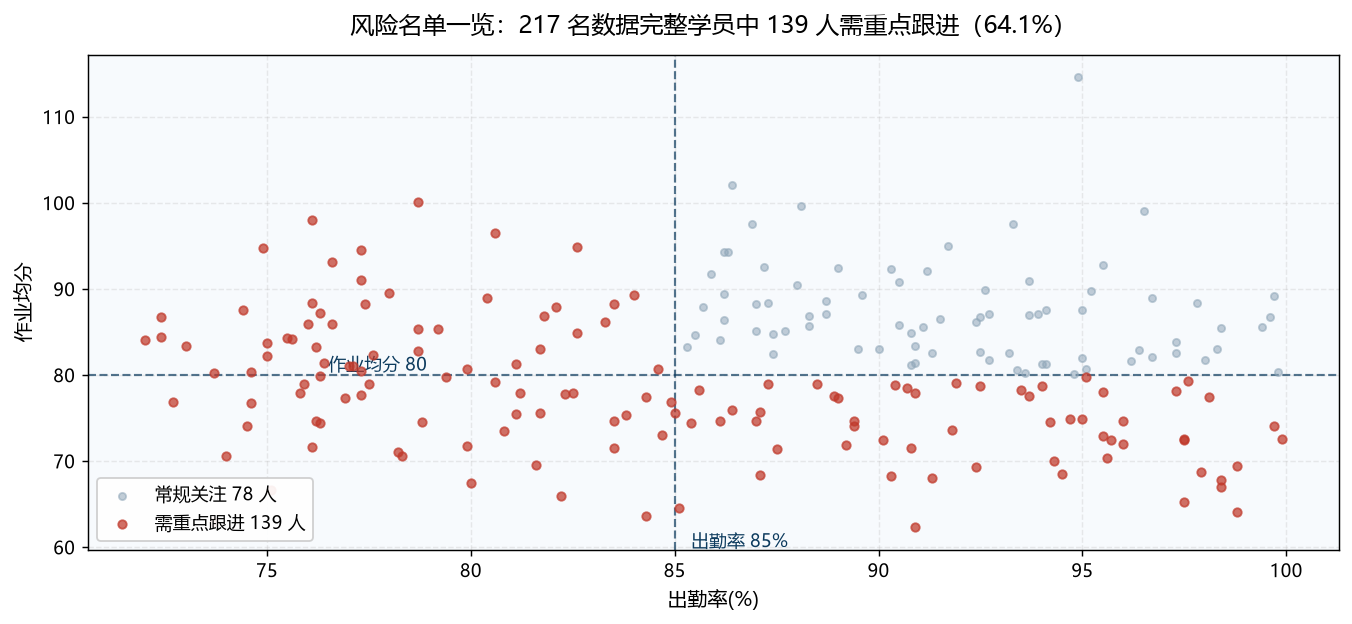
第 5 步:挑出需要重点跟进的人。 出勤率 <85% 或作业均分 <80 的名单单独列出,供教务跟进续报沟通。
第 6 步:落盘。 清洗后台账、待核对名单、统计报告三份文件同时输出,任何一份都能独立支撑复核。
下面是本地真实运行的过程输出(可直接对照每一步的分析结果):
四、产出物
产出 | 内容 |
|---|---|
| 255 行可入账数据,问题行已剔除 |
| 45 行需人工补录/确认的数据,含问题类型 |
统计报告 | 6 个班级四项指标 + 风险名单 |
配图 ×4 | 校验命中分布、班级对比、风险散点、运行过程 |
统计结果(清洗后可入账 255 人口径):平均出勤率 87.0%,平均作业分 81.3 分;作业均分低于 80 的 101 人,出勤率低于 85% 的 89 人。其中两项数据都完整的 217 人里,任一项不达标的共 139 人(64.1%),这就是教务需要重点跟进的名单。
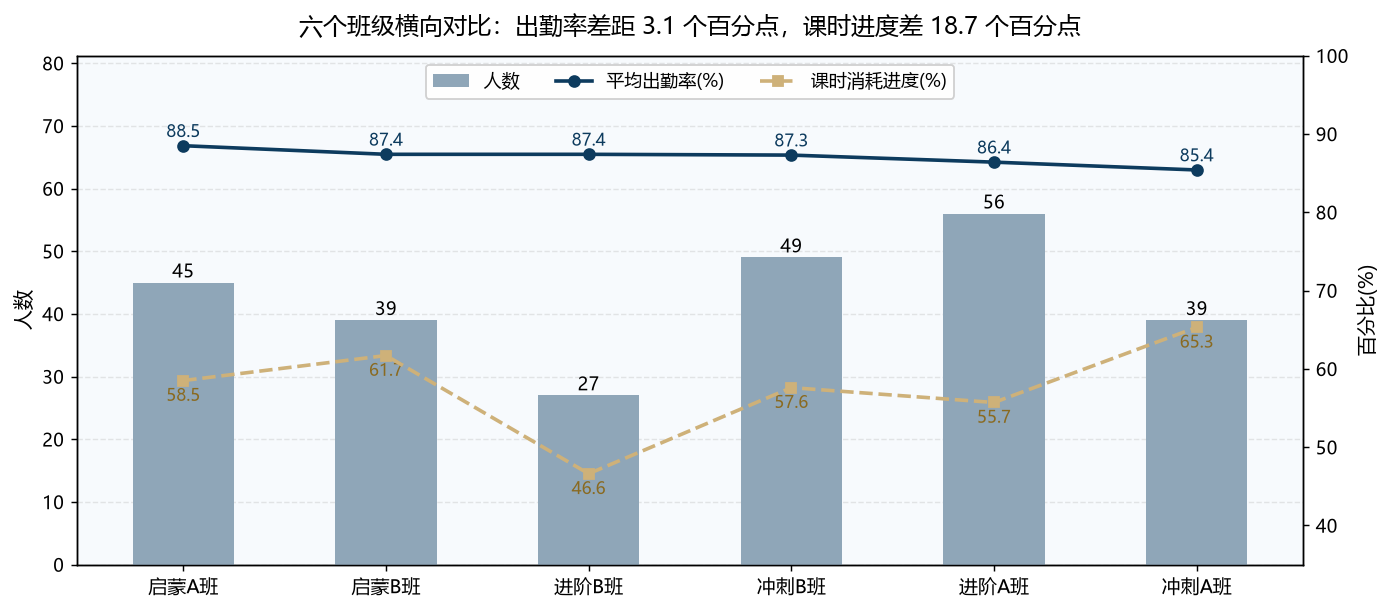
一个有意思的发现:六个班级的平均出勤率差距只有 3.1 个百分点(85.4%–88.5%),但课时消耗进度差了 18.7 个百分点(46.6%–65.3%)。也就是说,出勤看不出问题的班级,课时进度可能已经明显落后——这正是续报风险更值得盯的指标。
五、三处真实的坑
坑一:注入 12 处问题,只检出 11 处。
第一反应是脚本漏了。实际原因是:随机选中的两行恰好撞到了同一个编号,duplicated 只把"第二条及以后"算作重复。这提醒我——"注入数"从来不是校验标准,"行数守恒"才是。
坑二:出勤率越界值会把均值带偏。
台账里出现了 112.5、150.0 这样的出勤率。如果不先置为缺失,班级平均出勤率会被直接拉高,而这种偏移在最后的报告里看不出来。凡是"物理上不可能"的值,必须先剔除再统计。
坑三:问题数 83 处,但隔离行数只有 45 行。
因为一行可能同时踩中多个校验项(比如既姓名缺失又电话非法)。若按"各类命中相加"去推隔离行数,就会算出 83 这个错数字。按行去重、按项计数,两个口径必须分开记录。
六、沉淀成可复用的提示词
我有一份 N 行的学员台账(xlsx),字段是:编号、姓名、班级、报名日期、总课时、已消课时、作业均分、出勤率、电话。 请按四步处理:①编号和电话按字符串读,防止前导零丢失;②跑 6 类校验(重复编号 / 姓名缺失 / 已消课时>总课时 / 出勤率越界 / 电话格式非法 / 作业均分缺失),每类都给出处置动作; ③断言"清洗后行数 + 待核对行数 = 原始行数",不相等就中断并告诉我差在哪;④被剔除的行必须落盘成待核对表,不能只留在内存。 最后给我:一份可入账台账、一份待核对名单、一张班级对比表,以及一句结论。
小结
维度 | 手工整理 | 这条流水线 |
|---|---|---|
300 行全量校验 | 逐行肉眼核对,易漏 | 0.61 s,6 类问题一次跑完 |
脏数据处置 | 随手删掉,事后说不清 | 分类处置 + 待核对表留痕 |
口径可信度 | 无法自证 | 行数守恒断言自动把关 |
交付物 | 一张表 | 可入账台账 + 待核对名单 + 报告 + 4 张图 |
这次最大的体会是:整理数据的价值不在"算得快",而在每一步都能被别人复核。所以我把最高优先级给了两条断言——行数守恒,以及"被剔除的数据必须落盘"。它们在整个流程里没有增加任何计算量,却让结论从"我觉得没问题"变成"可以核对"。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号