#WorkBuddy# 120 万行日志揪出"起爆点":我把线上排查做成一条带一致性校验的流水线
原创
#WorkBuddy# 120 万行日志揪出"起爆点":我把线上排查做成一条带一致性校验的流水线
原创
用户12784192
发布于 2026-09-28 15:19:23
发布于 2026-09-28 15:19:23
线上出了故障,第一反应是 grep。可当日志文件长到 120.6 MB、120 万行时,grep 只能告诉你"这里有 6961 条错误",它不会告诉你故障是从哪一分钟开始爆的、爆在哪个接口上、属于哪一类异常。这篇文章记录一次完整的实测:用 WorkBuddy 把一次性排查动作沉淀成一条可复用的诊断流水线,从 120 万行里跑出可以指认起爆点的结论,全流程端到端 6 秒。
一、手工排查的四个断点
我先把"人肉排查"的真实流程拆开看,它断在哪:
手工动作 | 断点 | |
|---|---|---|
1 |
| 只给总数,不分时间、不分接口 |
2 |
| 看开头 100 行,大概率看不到真正的爆发时刻 |
3 | 发现错误集中在某接口 | 靠肉眼回翻,无法给出"起爆分钟" |
4 | 复述结论给同事 | 结论不可复现,下次故障还得从头来一遍 |
四个断点的共同根因只有一句话:检索和诊断被混在一起做了。检索负责"把可疑行捞出来",诊断负责"把可疑行变成结论",这是两件事。
二、把流水线设计成四段
设计原则是"每一段都能单独验证",因为排查工具如果自己出错,比没有工具更危险。
- 合成期:用固定随机种子生成 120 万行网关日志,覆盖 08:00–14:00 共 360 分钟,并注入一个真实故障窗口(第 41–47 分钟,订单/库存链路超时)。
- 检索期:四种策略并行实现同一件事——找出所有
ERROR/WARN行,并提取接口、耗时、状态码。 - 诊断期:分钟级聚合成 5xx 曲线,自动定位"起爆分钟"与"峰值分钟",统计 Top 慢接口与异常类型分布。
- 校验期:断言四种策略命中数必须完全一致,不一致直接中断——宁可报错,也不给出一份可疑的报告。
三、实测数据:四种策略的真实差距
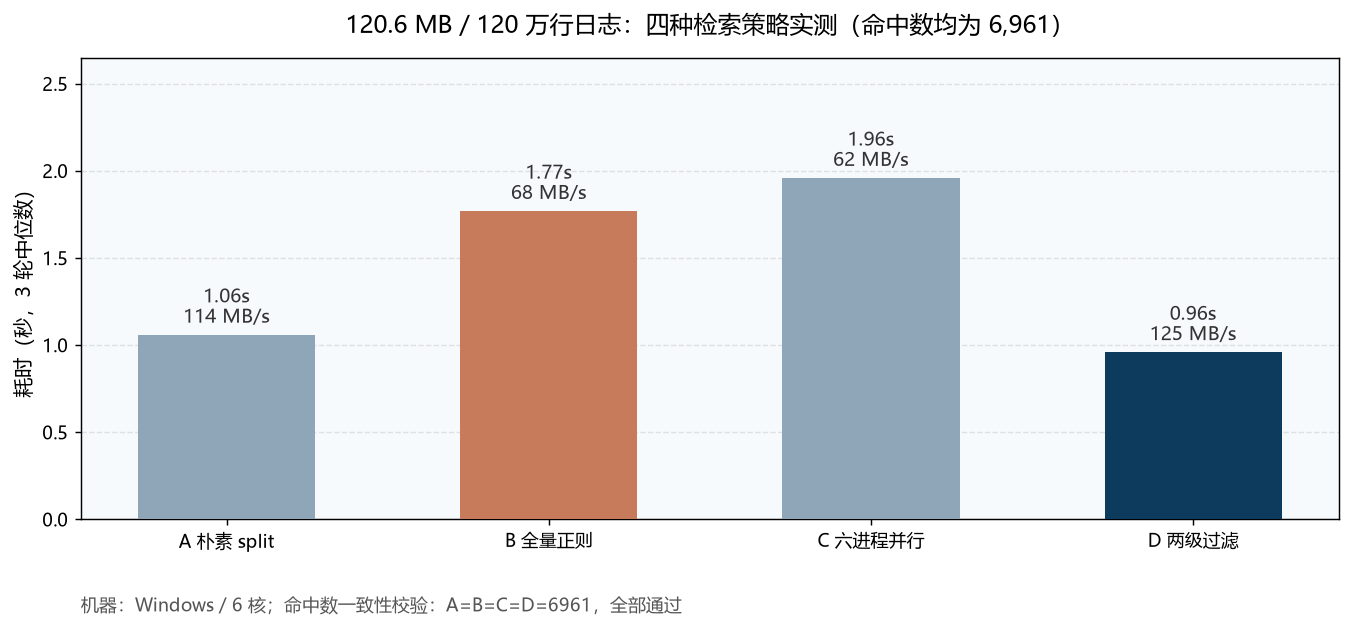
这是我最想分享的一组数字。图里四种策略做的是同一件工作(解析出级别、接口、耗时、状态码),命中数全部一致,可比性成立。
策略 | 中位数耗时 | 吞吐 | 相对基线 | 备注 |
|---|---|---|---|---|
A 朴素 | 1.06 s | 114 MB/s | 1.00× | 基线,最容易写对 |
B 预编译正则全量解析 | 1.77 s | 68 MB/s | 0.60× | 比朴素写法更慢 |
C 六进程字节分片并行 | 1.96 s | 62 MB/s | 0.54× | 进程启动开销吃掉收益 |
D 两级过滤(字节粗筛+行级精解析) | 0.96 s | 125 MB/s | 1.10× | 本场景最优 |
结论有两条,都不太符合直觉:
第一,"换成正则"不等于更快。 全量正则把每一行都送进正则引擎做 7 个分组的捕获,而朴素 split 只在分隔符上切一刀。在 120 MB 这个量级,瓶颈是解码与对象创建,不是匹配算法,所以正则的额外开销成了净负担。
第二,多进程不是银弹。 6 核并行反而比单进程慢——每次任务的进程启动、分片边界对齐、结果回传都是固定成本,而单文件顺序读在系统缓存里本来就很快。并行只有在"单文件解析远超进程启动开销"(比如几百 MB 以上,或每行要做重计算)时才划算。
真正赢的是策略 D:先用字节级 find 粗筛出可疑行,只把命中的 6961 行送进完整解析。省掉的是 119 万次无谓的正则调用。
四、诊断期:从 120 万行到一条能指认起爆点的曲线
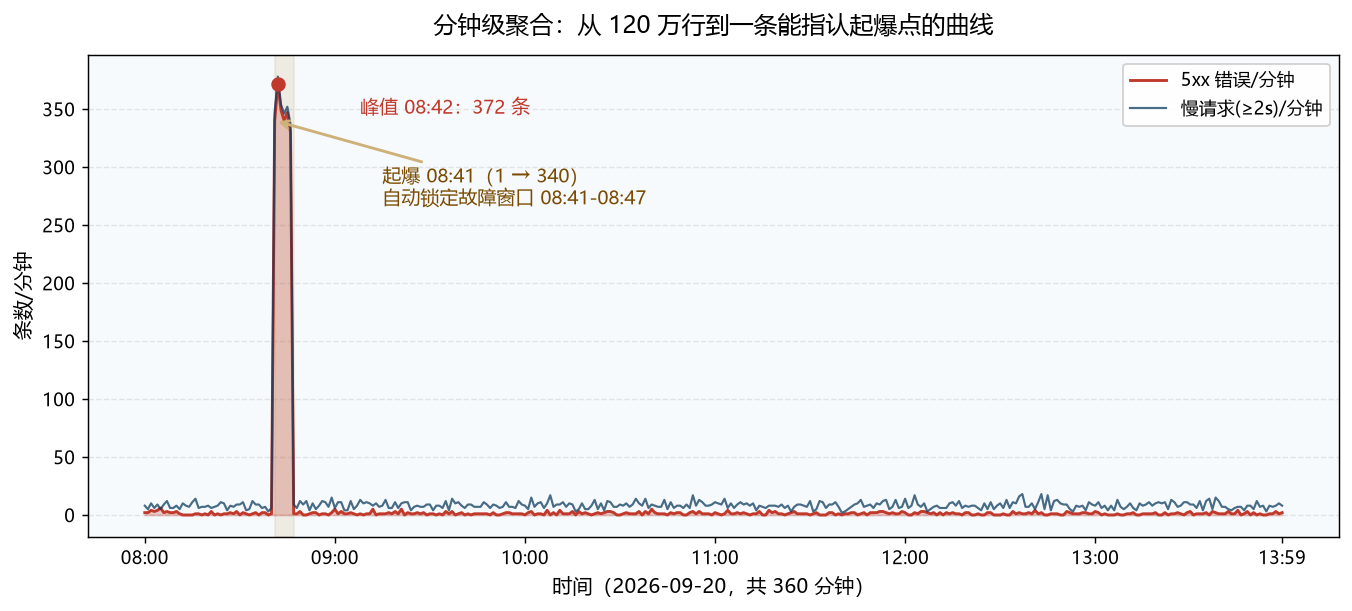
诊断期耗时 2.81 秒,结论直接可读:
流水线给出的结论是:
- 基线错误率 2 条/分钟,08:41 那一分钟直接跳到 340 条,自动锁定起爆分钟
08:41; - 峰值出现在 08:42,372 条,随后 08:47 回落到 1 条,故障窗口被还原为
08:41–08:47; - 慢请求(≥2s)与 5xx 曲线同步抬升,说明这不是偶发报错,而是同一段依赖超时引发的级联。
- 慢接口 Top3:
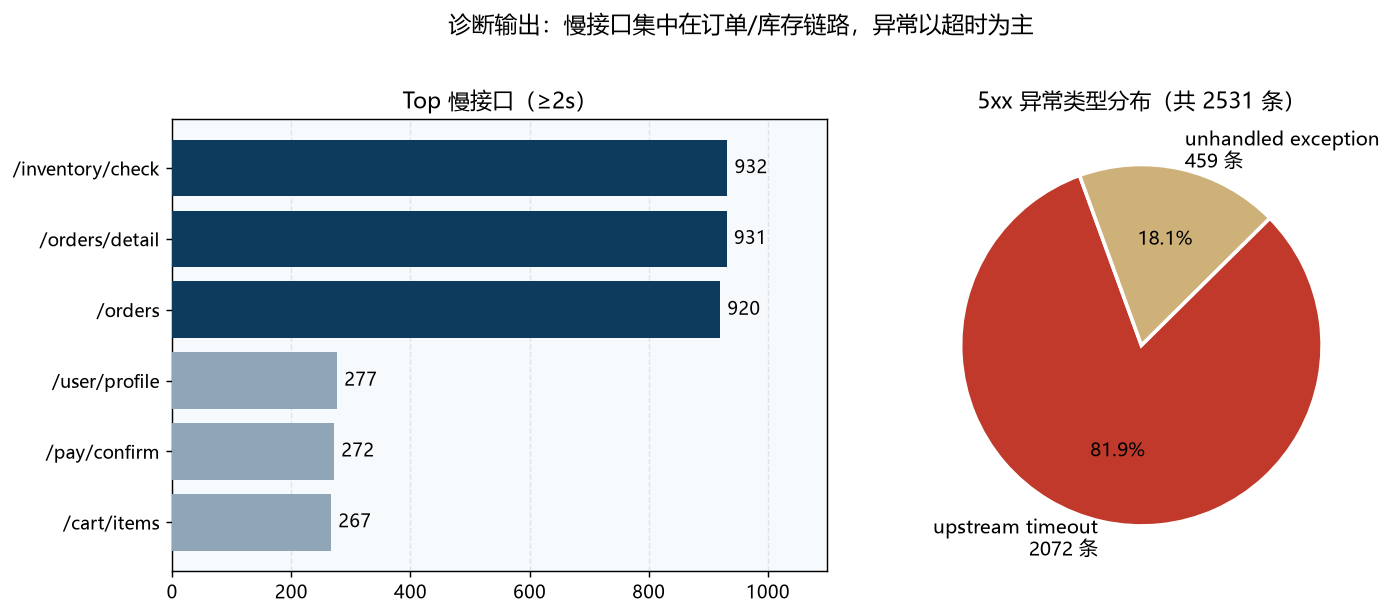
/api/v1/inventory/check(932)、/api/v1/orders/detail(931)、/api/v1/orders(920),三者数量级接近且远高于第四名(277),指向同一条链路; - 5xx 共 2531 条,其中 81.9% 是
upstream timeout(2072 条),异常类型高度收敛。
把这三张图放在一起,根因指向就很清楚了:库存接口超时拖着订单链路一起挂,而不是订单服务自身出错。
五、两处真实的坑
坑一:正则命中数突然变成 0,而朴素写法命中 6961。
原因是分块扫描时,每一块的起点不在行首,而 ^ 默认只锚定整段文本的开头——只有块首那一行有机会被匹配,其余全部漏掉。加上 re.MULTILINE 后立即恢复一致。这个 bug 没有任何报错,只有"数字对不上"这一个信号。
坑二:**%-5s** 右填充把正则写崩了。
日志里的级别字段是 %-5s 格式化的,ERROR 后面是一个空格,WARN 后面是两个空格。正则写成 \| (ERROR|WARN) \| 时,INFO、WARN 行全部漏匹配,ERROR 行正常——部分正确比全错更难查。
这两处坑最终都由第 4 段"一致性校验"抓住。如果我当时只保留一种策略,这两个 bug 会一路带进结论里。
六、核心代码
import re
from collections import Counter

LINE_RE = re.compile(
    r"^(?P<ts>\S+ \S+) \| (?P<lvl>\w+)\s+\| (?P<svc>[\w-]+) \| GET (?P<path>\S+) \| "
    r"uid=(?P<uid>\d+) \| (?P<rt>\d+)ms \| (?P<code>\d{3}) \| (?P<msg>.*)$")
# 关键:分块扫描必须 MULTILINE,否则 ^ 只锚定块首,命中数会静默归零
LINE_RE_M = re.compile(LINE_RE.pattern, re.M)


def scan_two_stage(path, chunk=8 << 20):
    """两级过滤:字节粗筛定位可疑行,只对命中行做完整解析"""
    keys = (b"| ERROR", b"| WARN")
    hit, slow = 0, Counter()
    with open(path, "rb") as f:
        tail = b""
        while True:
            blk = f.read(chunk)
            if not blk:
                break
            data = tail + blk
            nl = data.rfind(b"\n")          # 保证不在行中间切断
            if nl == -1:
                tail = data
                continue
            body, tail = data[:nl], data[nl + 1:]
            pos = 0
            while pos < len(body):
                cand = [i for i in (body.find(k, pos) for k in keys) if i >= 0]
                if not cand:
                    break
                i = min(cand)
                ls, le = body.rfind(b"\n", 0, i) + 1, body.find(b"\n", i)
                m = LINE_RE.match(body[ls:le if le != -1 else len(body)].decode("utf-8", "replace"))
                if m:
                    hit += 1
                    if int(m.group("rt")) >= 2000:
                        slow[m.group("path")] += 1
                pos = (le + 1) if le != -1 else len(body)
    return hit, slow


def diagnose(series_counter):
    """自动定位起爆点:连续 2 分钟错误数 ≥ 基线 10 倍"""
    mins = sorted(series_counter)
    base = series_counter[mins[0]]
    for i, m in enumerate(mins[:-1]):
        if series_counter[m] >= max(10, base * 10) and series_counter[mins[i + 1]] >= max(10, base * 10):
            return m
    return max(series_counter, key=series_counter.get)
七、沉淀成 WorkBuddy 的可复用提示词
流水线跑通后,我把它固化成一个提示词模板,下次换日志文件直接复用:
我有一个 N MB / N 万行的日志文件,格式为「时间 | 级别 | 服务 | GET 路径 | uid | 耗时ms | 状态码 | 消息」。 请分四段处理:①按字节分片读,不要一次性载入内存;②用两级过滤(字节粗筛 + 行级正则)找出所有 ERROR/WARN 行; ③做分钟级聚合,输出 5xx 曲线、慢请求曲线,并自动判定起爆分钟(连续 2 分钟 ≥ 基线 10 倍)与峰值分钟; ④断言"命中数"在至少两种实现下必须一致,不一致就中断并告诉我差在哪里。 最后只给我三样东西:一张耗时对比表、一张分钟级曲线、一句根因结论。
这个模板的价值在于第 ④ 条:它把"我可能查错了"变成了一个会自动爆炸的断言。
小结
维度 | 手工排查 | 流水线 |
|---|---|---|
120 万行得出总数 | 数十秒,靠命令 | 0.96 s |
定位起爆分钟 | 靠肉眼回翻,常失败 | 自动输出 |
给出根因方向 | 依赖个人经验 | 异常 81.9% 收敛于 upstream timeout |
结论可复现 | 否 | 是(固定种子 + 一致性断言) |
端到端 | 分钟级到小时级 | 6 s(含合成数据时间另计) |
这次实测最大的收获不是"快了 10%",而是那张一致性校验断言——它在没人盯着的时候,先后抓出了两个不会报错的静默 bug。排查工具的第一优先级不是快,而是可信。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号