我用workbuddy做了自己的第一个小程序:Spoon词表#WorkBuddy#
原创
我用workbuddy做了自己的第一个小程序:Spoon词表#WorkBuddy#
原创
用户12780425
修改于 2026-09-22 16:06:12
修改于 2026-09-22 16:06:12
一个真实的教学工具项目,从需求到上线全程由 AI Agent 协作完成。本文不吹能力,只讲做成了什么、怎么做的、踩了哪些坑——尤其是那些文档里不会写、但会让你卡住两小时的细节。
一、缘起:一个很朴素的需求
我手上有五科 DSE 的词汇表(生物、化学、科学、物理、数学),散在 PDF 和 Word 里。学生背单词全靠纸质名单,老师想知道全班掌握情况只能靠提问。
需求拆开来其实就四条:
- 用我自己的词库——不接受"App 内置什么就只能背什么";
- 学生打开就能用——电脑双击一个 HTML,手机扫一个小程序码,不要账号、不要装 App;
- 老师能看到全班数据——哪几个词错得最多;
- 成本趋近于零——没有预算买服务器和数据库。
同时有个硬约束:老师自己要能改词库。如果每次加个词都要我改代码、重新部署,这个项目就废了。
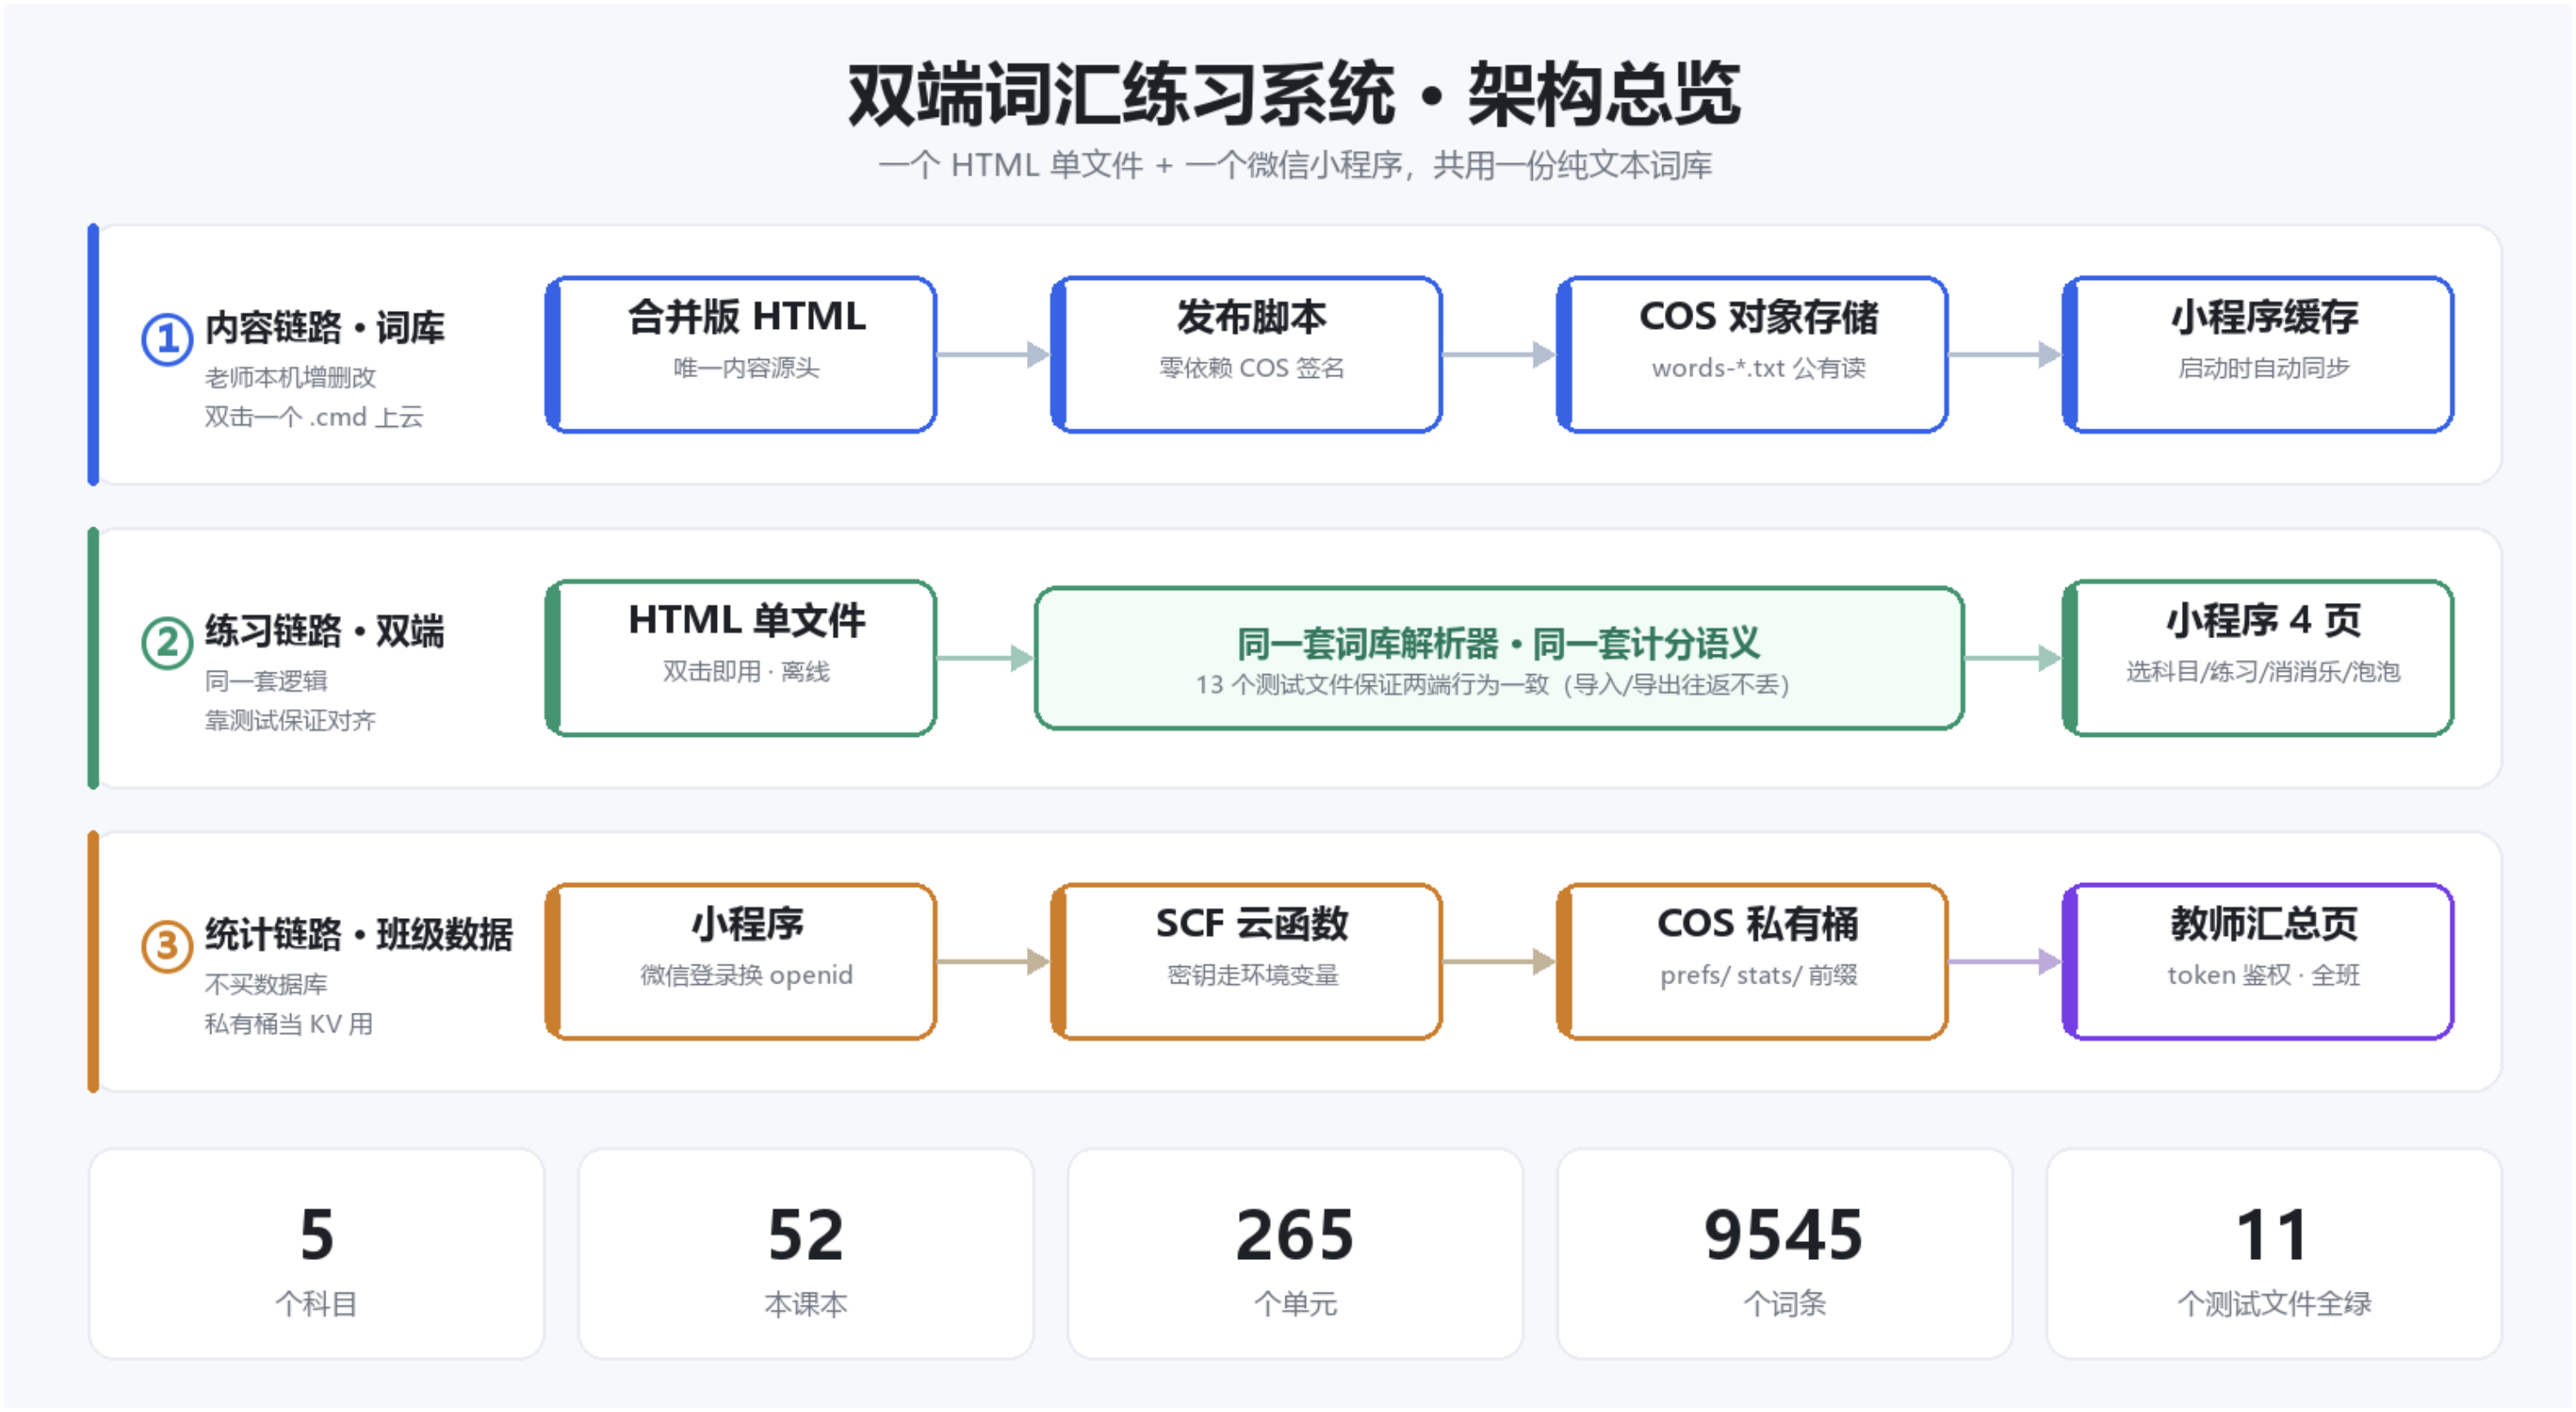
最后的结果:一个 504KB 的 HTML 单文件(双击即用)+ 一个微信小程序(四个页面)+ 一个云函数后端,五科共 52 本课本 / 265 个单元 / 9545 个词条全部打通。
二、功能清单:具体做了什么
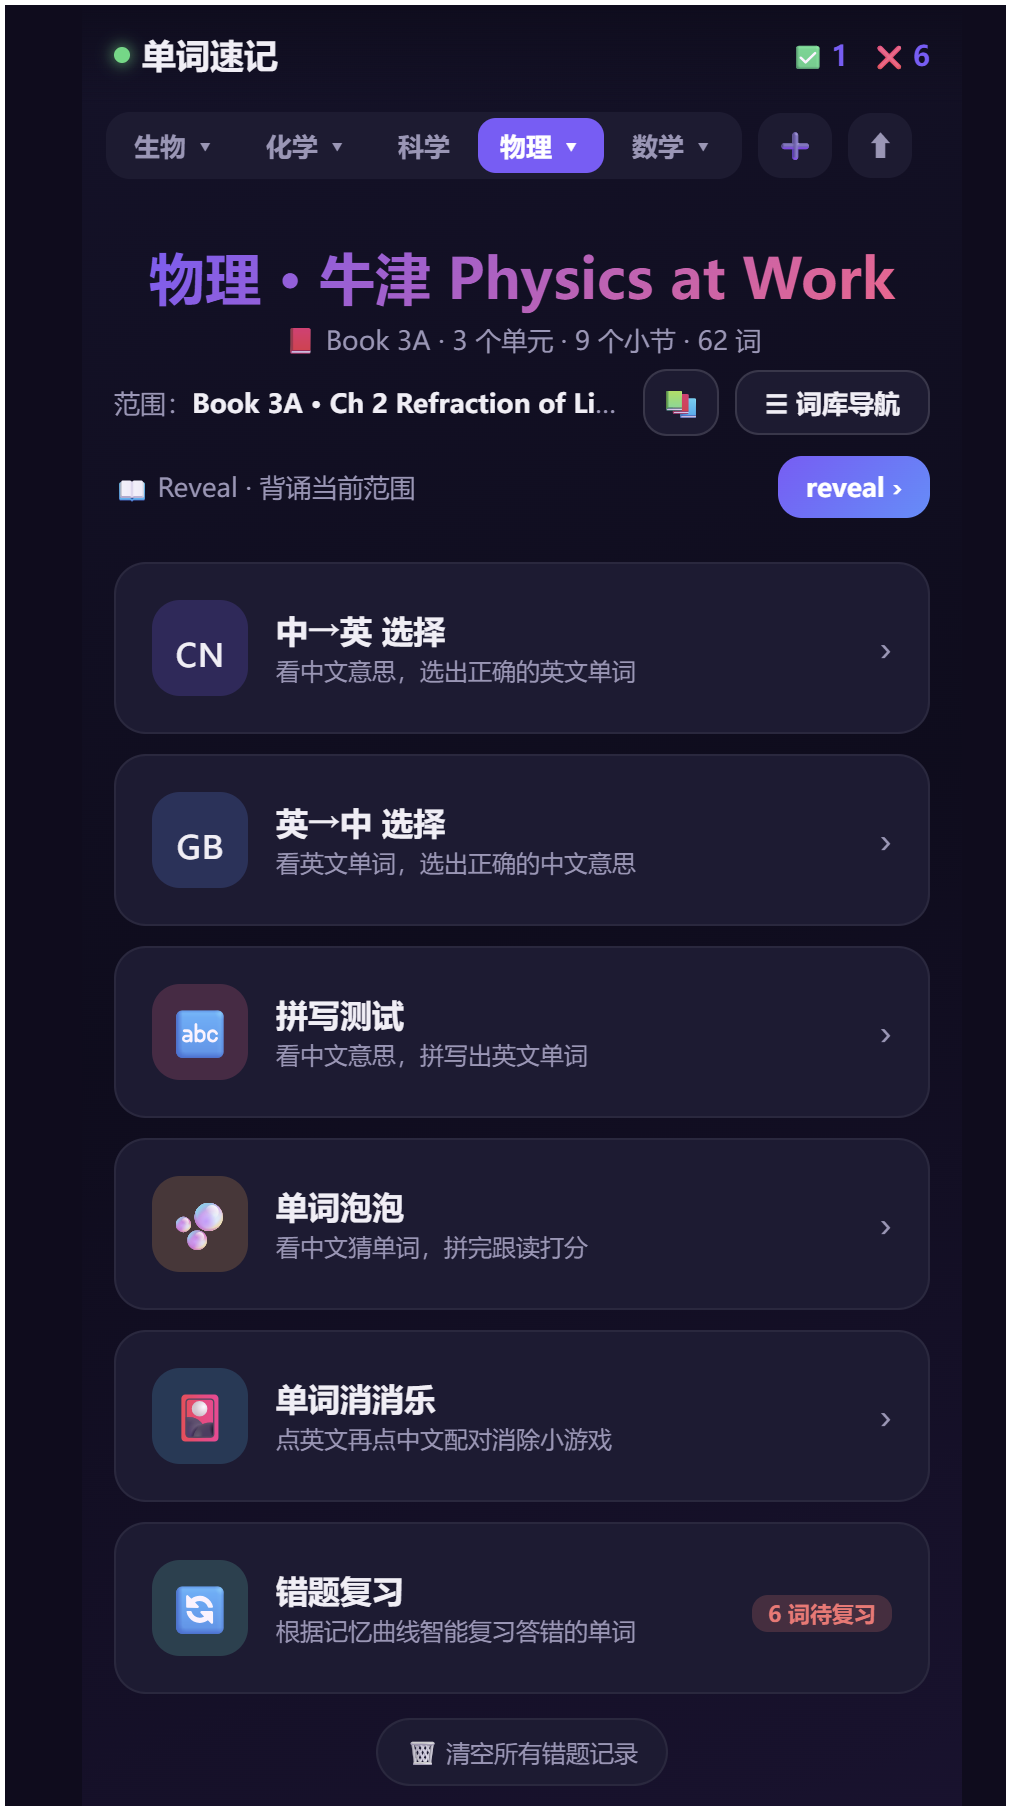
练习端(HTML 与小程序功能对齐)
模块 | 说明 |
|---|---|
英译汉 | 看英文选中文,四选一 |
汉译英 | 看中文选英文,四选一 |
拼写 | 按 QWERTY 虚拟键盘逐字母拼写,按键带剩余次数限制 |
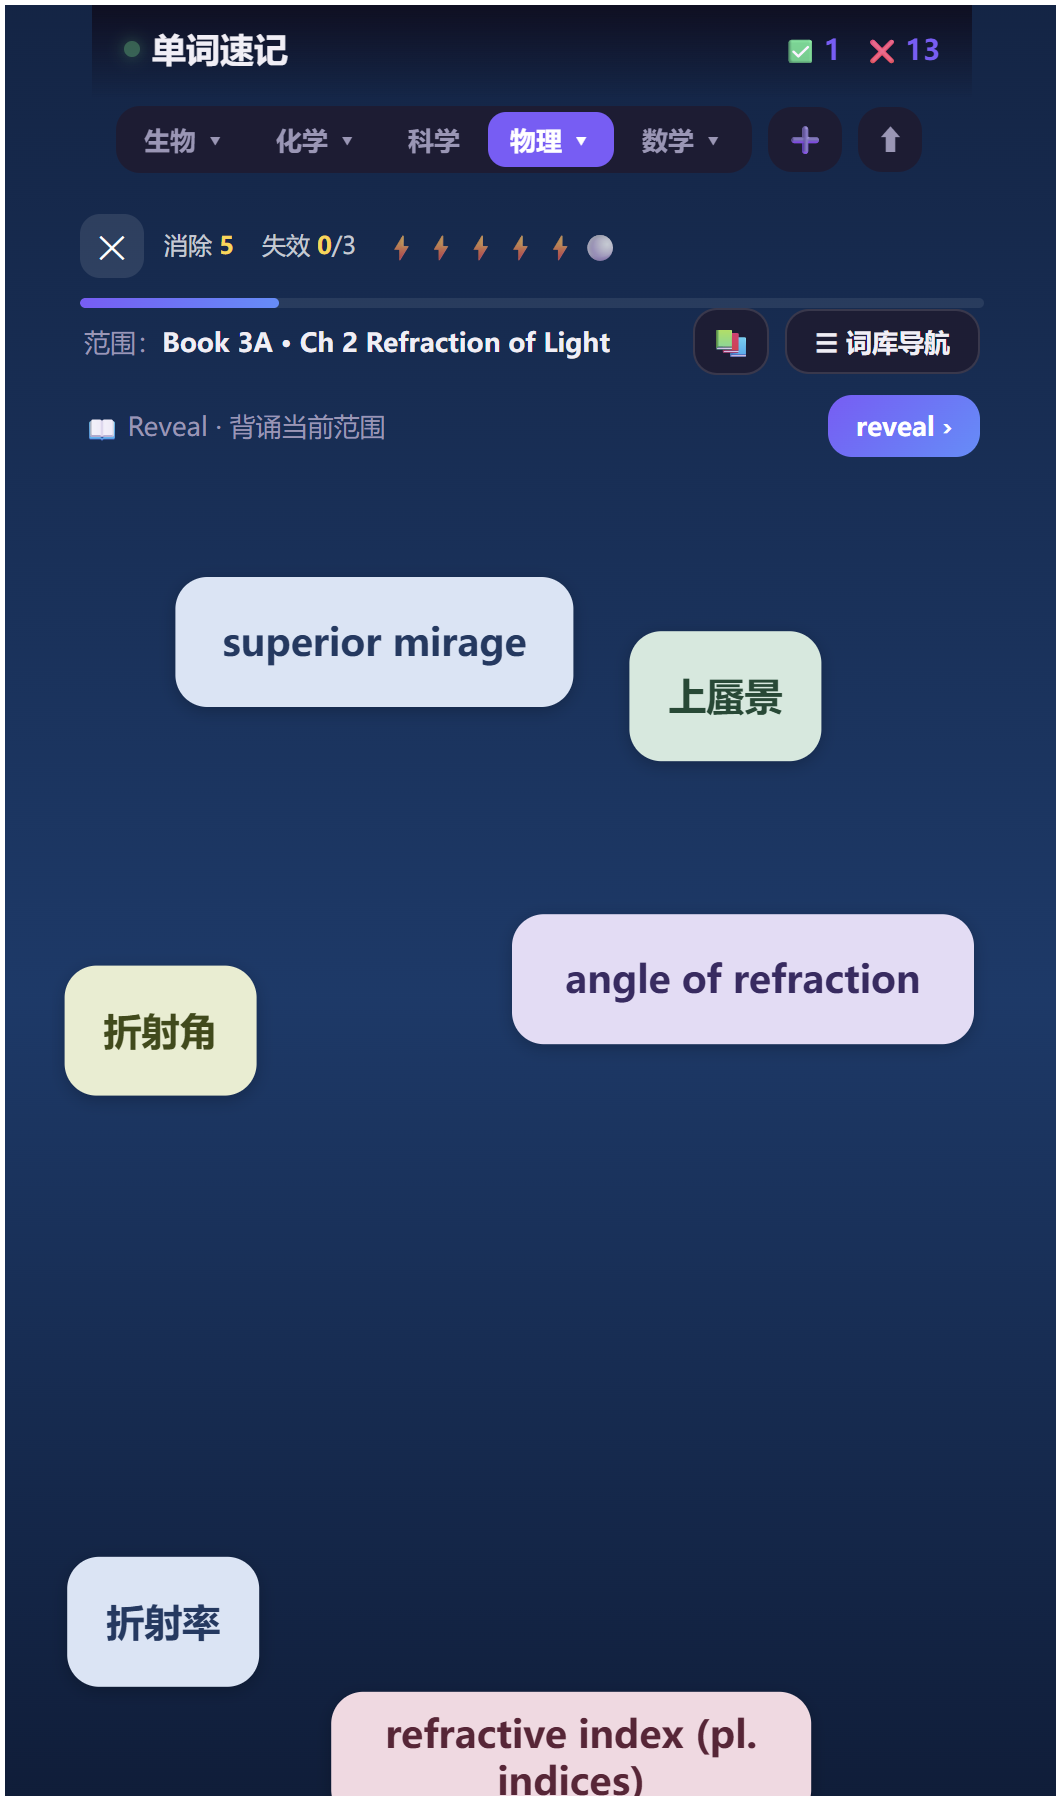
消消乐 | 英文-中文配对消除,统计犹豫率(点了又取消) |
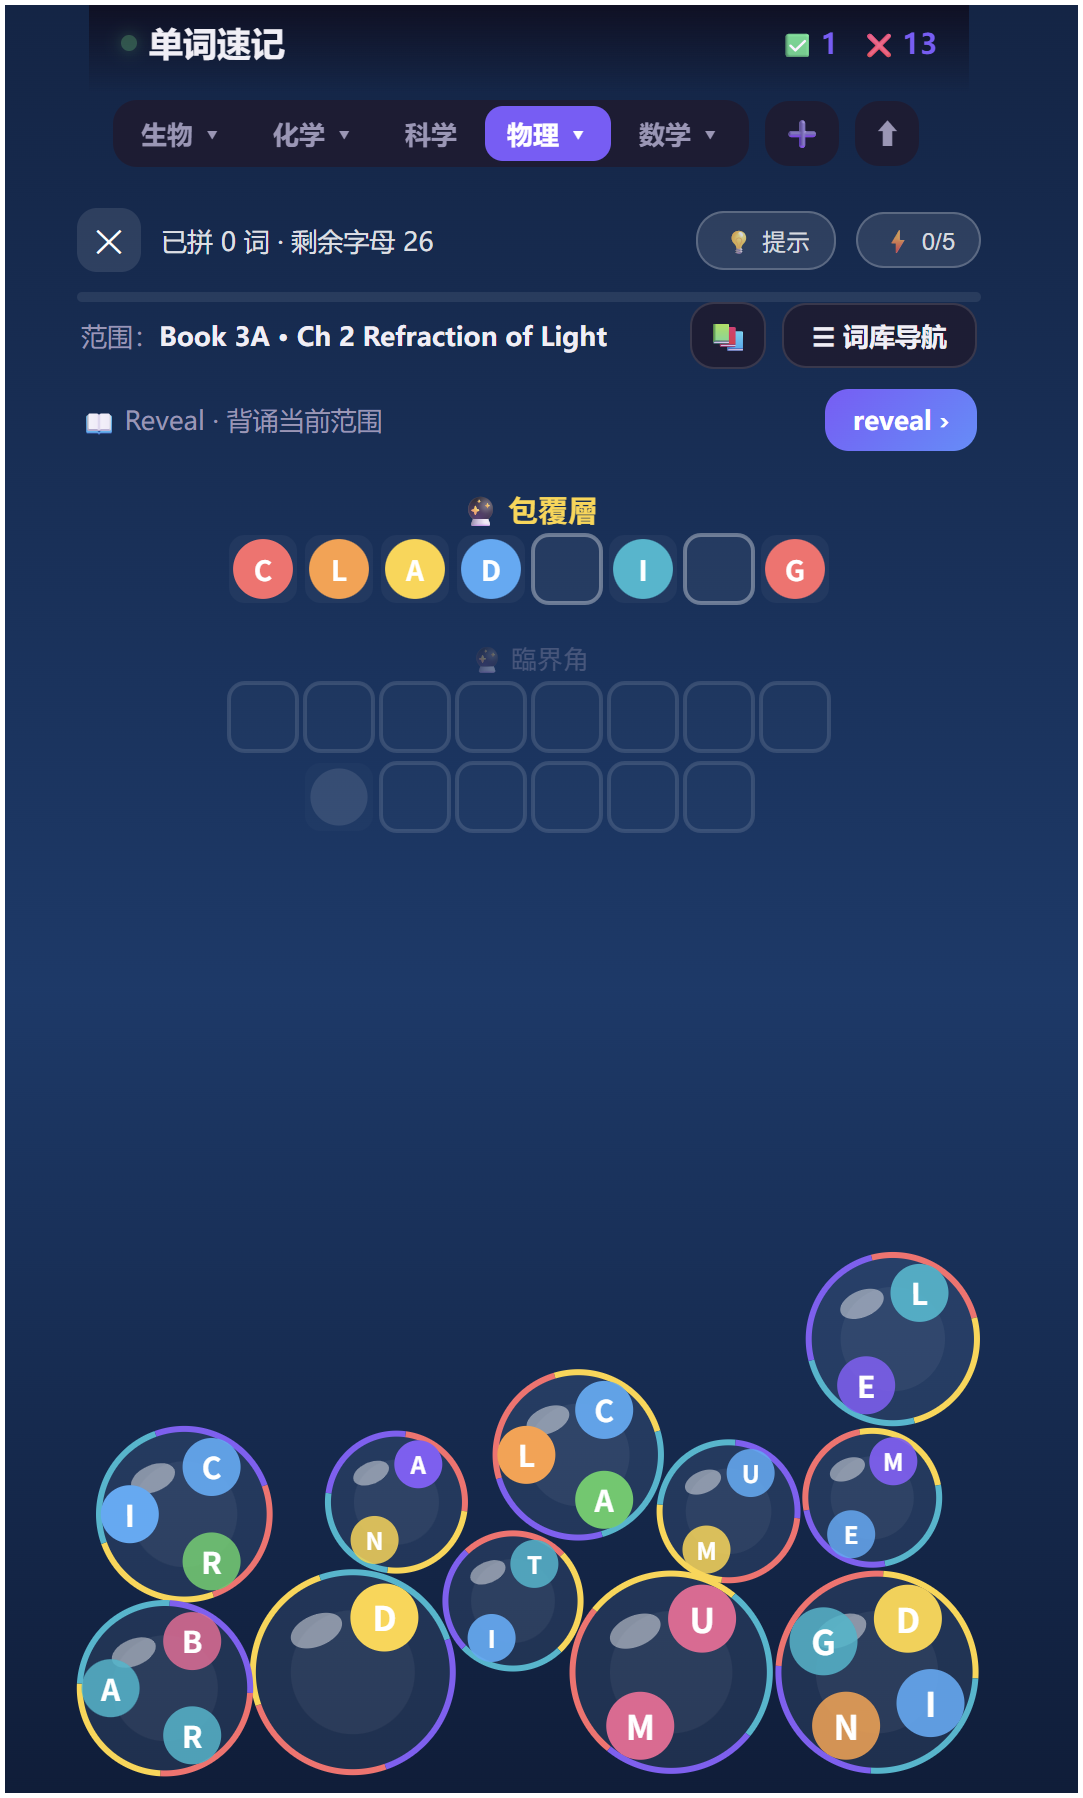
单词泡泡 | Canvas 打泡泡游戏,只对词尾两个字母做判定 |
Reveal | 背诵模式:只看英文,点一下揭开中文,词表可行内增删改 |
结算统计(五种游戏统一)
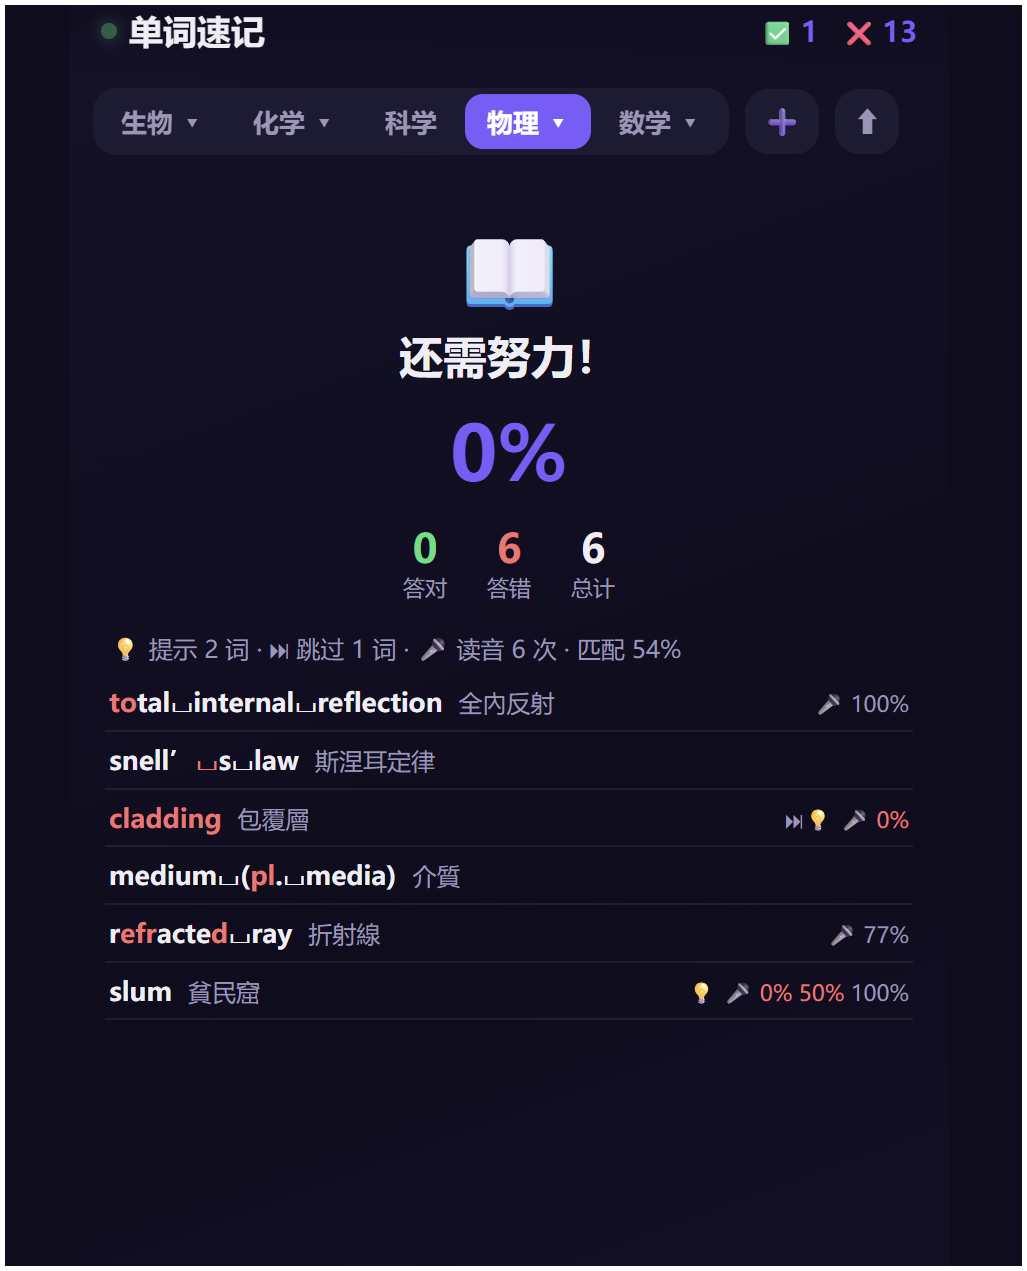
每次练习退出时给出一份本次练习的完整报告,而不是只丢一个分数:
- 正确率、练习的全部单词(对的黑色、错的按判定粒度标红)
- 提示使用次数、跳过次数
- 逐次读音匹配率(语音跟读每次尝试都记,低于 70% 标红)
标红粒度的设计原则是只标真正判错的字符:
- 拼写模式:只标输错位置的那个字母;
- 单词泡泡:只对词尾两个字母做判定,错了一整词算错,但标红只标那两个字母;
- 四选一模式:整词标红(因为不存在"哪个字母错"的概念)。
实际效果(一次拼写练习的真实结算):
管理端(老师视角)
能力 | 实现方式 |
|---|---|
加/减课本 | HTML 里的「➕ / 🗑」按钮,改的是本机 localStorage |
重命名课本 | 同上 |
编辑词条 | Reveal 界面行内 ✏️ / 🗑 / ➕,改完可导出 .txt |
一键发布 | 双击 发布词库.cmd,词库上云,小程序下次启动自动同步 |
全程统计 | 独立教师页输入口令,拉全班汇总 |
三、整体架构:三条链路
几个关键决策
为什么用 HTML 当"数据库"? 因为老师会用的工具只有浏览器。把词库放在一个能双击打开的 HTML 里,她就能自己改;放在数据库里,她必须等我。数据源头选在"用户能直接编辑"的地方,是这个项目最重要的一个决定。
为什么用对象存储而不是数据库? 词库是"整份替换"的只读数据,天然适合对象存储。CDN + 公有读,小程序端 downloadFile 拿到的就是最新版,没有任何查询需求。省掉了数据库的钱和运维,也省掉了"表结构迁移"这类麻烦。
为什么发布脚本零依赖? 老师双击的是 .cmd,环境里没有 npm install 这一步。所以 COS 上传是手写 XML API 签名实现的——只用 Node 内置的 crypto / https。
四、关键实现
4.1 词库格式:一份纯文本,两端消费
词库不是 JSON,是一种类 Markdown 的纯文本,因为它要同时满足"人能读能改"和"程序能解析":
规则很简单,但有三条必须守住:
- 词条行必须含分隔符(
,/,/ Tab)。少一个逗号,这行就变成"死词条"——不报错,但永远练不到。这是最难排查的一类问题。 ##下面直接写词,归入「(本節導言)」;空小节往返不丢。- 前端 HTML 和老版本
const UNITS结构要能互认,避免升级时词库丢失。
两端必须用同一套解析器。这里我没靠"小心一点",而是写了一个 quiz-text-test:同一份文本,两端解析结果必须完全一致(导入→导出→再导入,结果不变)。测试通过才算对齐。
4.2 发布链路:零依赖手写 COS XML 签名
腾讯云 COS 的 PutObject 签名算法不复杂,手写一遍就能省掉整个 SDK 依赖。核心就三步:
三个容易翻车的点:
k=v列表里键必须小写并按字典序排序,值用encodeURIComponent,但空格要还原成+;- 只有
x-cos-*头需要进签名,普通头(Content-Length、Content-Type)不签更省事; - 签名有效期自己定(这里 10 分钟),时间戳偏移会让请求直接 403。
密钥全部走配置,tools/cos.config.json 不进版本库——这类文件一旦截图或提交,等于把桶送人。
4.3 小程序侧:拉取最新词库
小程序启动时并发拉取各科词库文件,落地到本地缓存后并入科目列表。
这里有一个几乎每个人都会踩一次的坑:wx.downloadFile 的合法域名配置必须带 https:// 前缀。少写协议头,域名校验直接不通过——而报错信息并不会明确告诉你是前缀的问题。
4.4 结算统计:把"一次练习"建模成一个会话对象
统计的难点不是计算,而是语义统一。比如"跳过"到底算不算错?
最后定下来的规则是:
- 「下一题」跳过 = 计入错词表、不参与连击;
- 答错 = 计入错词表、重置连击。
两端的行为必须一致,否则同一份数据在 HTML 和小程序里得出的正确率不一样。
数据结构上,一次练习维护一个 sessWords:
speakSims 用数组而不是取 max,是产品的硬要求:学生读三次、只对一次,和读一次就对,不该得同样的反馈。所以每次尝试都记、都展示,低于 70% 标红。
4.5 拼写键盘:剩余次数决定键的状态
键盘是 QWERTY 26 键 + 底部空格 + 删除键。关键设计是 spellPool 二维数组:每个字符按它在单词里出现的次数分配"可点次数",次数用完变灰、点不动,而不是报错。
这样学生不会"因为按错键"被扣分,只有拼错字母才算错——符合学习场景,而不是打字考试。
4.6 班级统计:不买数据库,用私有 COS 桶当 KV
数据量很小(每个学生每个科目一条记录),为此开一个云数据库不划算。做法是:同一个 COS 桶,另开一个私有读的对象前缀当 KV 用。
云函数里只用环境变量存密钥,代码里不落任何凭据:
教师端要口令才给汇总,学生端只能读写自己的 openid 文件。
五、踩坑记录(建议收藏这一节)
这部分是我认为本文最有价值的内容。每一条都是真实卡过的。
1)SCF 函数 URL 在 Chrome 报 ERR_INVALID_RESPONSE,curl 却正常
现象:浏览器打开函数 URL 直接失败,curl 同样的地址返回 200。
原因:云函数的"参数兼容模式"网关会自动补一个 Content-Type 头,而函数代码里又自己设了一个,于是响应里出现重复的 Content-Type。curl 容忍这种不合规响应,Chrome 严格拒绝。
解法:删掉函数代码里手动设的 Content-Type(交给网关补),重新打包上传。
排查这类问题的经验:当浏览器报错而 curl 正常时,先怀疑响应头不合规,而不是网络、VPN。
2)函数 URL 主机名抄错一个字符
函数 URL 形如 https://<appid>-<随机串>.ap-guangzhou.tencentscf.com。我把随机串里的一个字符抄错了(74jdyq5yp 抄成 74jygxi5yp),表现为"部署成功但访问不通",排查了很久。
教训:URL、AppID、桶名这类标识符,永远复制不要手打。
3)jsdom 测试里 const 声明的变量不挂到 window
在 jsdom 里跑页面脚本时,顶层 const xxx = ... 不会变成 window.xxx(只有 var 和函数声明会)。所以测试里不能写 window.state 断言。
解法:断言改走 DOM 结构,或者读函数源码字符串(fn.toString())做静态断言。
4)逐词统计数据"永远是空的":快照 vs 引用
现象:结算页里泡泡模式的读音匹配率永远是空数组。
原因:泡泡的逐词记录是在"拼完这个词"的那一刻快照生成的,但读音校验发生在那之后。快照时 speakSims 还不存在,于是存进去一个新建的空数组;之后读音回调往 pot.speakSims 推数据,推的是另一个数组。结算读的还是那个空数组。
解法:在生成记录之前先把数组落到对象上,两边存同一个引用。而拼写模式因为是同一个活对象引用,从来没出过问题——这类 bug 只在"一部分路径共享引用、另一部分不共享"时出现,最难发现。
5)一个后代选择器把整词染红
CSS 里写了:
本意是"错的词标红",但它盖住了我在字母级加的标红规则,效果变成整词红色。而需求是"只标错的那个字母"。
解法:加一个更高优先级的覆盖规则,把字母级标红的作用域保护起来:
HTML 端也有同款坑(.rw.bad .rw-en)。同一个错误在两个技术栈各犯一次——说明问题不在框架,在"命名粒度没有对齐设计意图"。
6)WXML 里空格渲染成隐形空白
拼写键盘的空格键,直接输出 {{item.val}} 会渲染成一片什么都没有的空白,看起来像 bug。
解法:显式替换成可见符号:
7)bash 里内嵌反引号会被吃掉
写内联脚本统计词库时,反引号(模板字符串 / 正则里的反引号)被 shell 抢先解释,报 unexpected EOF while looking for matching。
解法:复杂脚本写成文件再执行,不要内联。这条后来成了整个项目的通用做法——所有 HTML 改造都写成独立的补丁脚本。
8).cmd 必须纯 ASCII + CRLF
Windows 批处理对编码很敏感。文件里带中文、或用 LF 换行,双击就报莫名其妙的错。
解法:.cmd 文件强制 纯 ASCII + CRLF,中文提示语只放在被调用的 Node 脚本里输出。
9)文件编辑"报告成功但没落地"
在对 500KB 单文件 HTML 做批量字符串手术时,遇到过编辑工具返回成功、但内容实际没变的情况。
解法:每次编辑后立刻用 grep 验证关键标记是否存在。这个习惯救过我好几次——否则会带着"以为改了"的状态往下走,最后表现成一个很难定位的功能缺失。
10)改 A 不改 B:同一逻辑存在两份代码
消消乐的核心逻辑保存在两个地方(HTML 内嵌一份、小程序独立一份),改了一处忘了另一处,表现是"电脑上正常、手机上不对"。
解法:凡是两端都要用的逻辑,用同一个测试文件覆盖两端,改完同时跑;测试不过就不算改完。
六、我是怎么和 WorkBuddy 协作的
这个项目的特殊之处:主体是一个 504KB 的 HTML 单文件,加上小程序四个页面、二十多个工具脚本、十几个测试文件。手改这种规模的文件是不现实的,所以整个改造过程是围绕"让 AI 安全地改大文件"来设计的。
1)补丁脚本驱动,而不是直接改文件
每次功能改造都写成一个独立的补丁脚本(tools/xxx.js),它必须满足:
- 幂等:重复执行结果不变(靠标记检测,改过就跳过);
- 先备份:改之前自动生成带时间戳的
.bak-*; - 自检:改完用
new Function()把内嵌 JS 跑一遍语法检查,不通过就回滚。
这样每次改造都是"可复现、可回退、可审计"的,而不是一堆不可追溯的手工修改。
这条经验值得推广:让 AI 改大文件时,不要让它直接输出"新文件",而是让它写一个幂等的迁移脚本。文件太大时,全文重写有概率引入静默错误;而补丁脚本的每一步都是可以验证的。
2)让 AI 自己写"裁判"
我在这个项目里累计写了 11 个测试文件、约 3300 行断言代码,覆盖:
- 词库解析的双端一致性(导入导出往返不丢)
- 拼写键盘的每一条交互(点第几次变灰、删除键状态)
- 结算统计的每条数值(正确率、犹豫率、逐次读音匹配率)
- HTML 静态检查(关键标记是否存在、旧代码是否已彻底移除)
关键点:测试是让 AI 写的,但验收标准是我定的。 需求一旦变成断言,"改了没有"就不再是主观判断。我后面几轮改动,都是先让测试红、改完看着变绿。
3)一次把需求说完整
最省积分(也最省时间)的方式,是一次性把完整规则讲清楚,而不是"先改一半看看"。例如标红规则,我最终是这么给的:
单词泡泡只统计最后两个字母,输入一次就算错误,这个单词的其余字母都是黑色;单词拼写同样逻辑,但错误的定义是:连续两次输入某个字母都错、或者使用了提示字母才算错,只输错一次不算;两个游戏都要输出每次读音的匹配率,每一次都要输出,低于 70% 标红。
这段话包含 4 条独立规则,一次说完,两端一次改到位。如果拆成四轮,光上下文重建就要多做四次。
4)跨会话记忆
项目跨了十几天、几十轮对话。把"词库格式约定""发布流程""已知的坑"这些沉淀到项目记忆里,新会话起来不用重新解释背景——这对长周期项目是决定性的。
5)警惕"AI 说改完了"
我遇到过至少两次"AI 报告修改成功、实际文件没变"。所以流程里固定了一条:改完必须用 grep 验证标记落地,必须跑测试,必须两端都核一遍。信任,但要验证。
七、结果
指标 | 数值 |
|---|---|
词库规模 | 5 科 / 52 本课本 / 265 单元 / 9545 词条 |
HTML 单文件 | 504 KB(含全部词库与逻辑,零外部依赖) |
小程序 | 4 个页面(选科目 / 练习 / 消消乐 / 泡泡) |
工具脚本 | 20+ 个(合并、发布、上架、补丁、校验) |
测试代码 | 11 个文件 / 3300+ 行 / 全部通过 |
服务器成本 | 对象存储 + 云函数按量,实际接近 0 |
老师改词库的成本 | 双击一个 .cmd |
回归测试最终结果:
八、小结
回头看,这个项目能跑起来,靠的不是"AI 能写代码",而是三件事:
- 数据源头放在使用者手里。词库放在老师能双击打开的 HTML 里,整个系统的维护成本就降下来了。
- 把需求变成断言。11 个测试文件不是炫技,是让"改对了没有"这件事变得可判定——这是 AI 协作能持续下去的前提。
- 改造动作脚本化。幂等 + 备份 + 自检的补丁脚本,让大文件改造从"危险操作"变成"可回滚的常规操作"。
如果你也在做"轻量、离线优先、用户自己能维护"的工具,欢迎交流。踩坑清单里如果有哪条正好卡住你,那这篇文章的目的就达到了。
本文使用 WorkBuddy 完成需求梳理、代码实现与测试编写。项目全程真实落地,相关数据可在本地复现。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号