IMA × WorkBuddy 组合打法:知识库 + 桌面工作台协同
原创
IMA × WorkBuddy 组合打法:知识库 + 桌面工作台协同
原创
华东子
发布于 2026-09-17 14:03:03
发布于 2026-09-17 14:03:03
一、背景与挑战
写东西的人都有一个共同的痛:知识散落一地。微信里收藏的文章、浏览器存的书签、本地一堆叫不出名字的 docx、聊天记录里某次灵光一现的碎片——等真要写篇技术文或周报时,这些东西一个都找不着,得从头再搜一遍。我管这叫"有资料、没记忆"。另一端,桌面 AI 工作台(比如 WorkBuddy)很能干活:你丢一句"整理这个乱文件夹并出分析报告",它自己归类、清洗、画图、导出,成品递你手上。但它有个短板——没记忆。每次新任务,背景都得你重新喂一遍,昨天刚梳理好的项目规范,今天它又不记得了。
问题很清楚:一边是"有记忆、不会干"的知识库,一边是"会干、没记忆"的执行台。把这两件事串起来,才是个人知识工作流的闭环。本文讲的就是我这两个月实际在用的串法。
二、解决方案概述
一句话:IMA 管"脑"(长期记忆),WorkBuddy 管"手"(桌面执行)。
- IMA 是知识管家。它的核心价值不是"存文件",而是把你的资料变成可检索、可对话的知识库。你往里丢微信文章、文档、录音,它按主题归并,之后直接用自然语言问它"上次那个 OCR 最佳实践是哪篇",它能带着出处把原文段落拎出来。它的记忆四模块(Soul / User / Memory / Agent)让 Agent 越用越懂你。
- WorkBuddy 是桌面工作台。它跑的是"感知 → 规划 → 执行 → 交付"的 Agent 闭环:读你授权的工作目录、调多 Agent 团队、生成文档/PPT/代码,直接把活干完,不是只给建议。
两者关系像"资料室管理员"和"项目经理":IMA 把资料归档成可查的资产,WorkBuddy 拿着这些资产去产出成品。
声明:本文记录的是 2026 年 5 月 28 日原生集成上线之前的过渡期桥接方案——把 IMA 里相关笔记导出为本地 .md,放进 WorkBuddy 的工作目录,再用 @ 引用喂给 WorkBuddy 当上下文。如今 WorkBuddy 已将 ima 知识库原生内置到「资料库」入口,通过微信扫码 OAuth 授权即可直接调用知识库内容,产物也可一键回传 ima;4.24.1 及以上版本无需再安装第三方连接器,ima MCP 连接器亦可直接使用。文中保留"导出 .md + @ 引用"这一实际做法的记录,不夸大"自动打通"。
三、技术实现:组合流程与配置要点
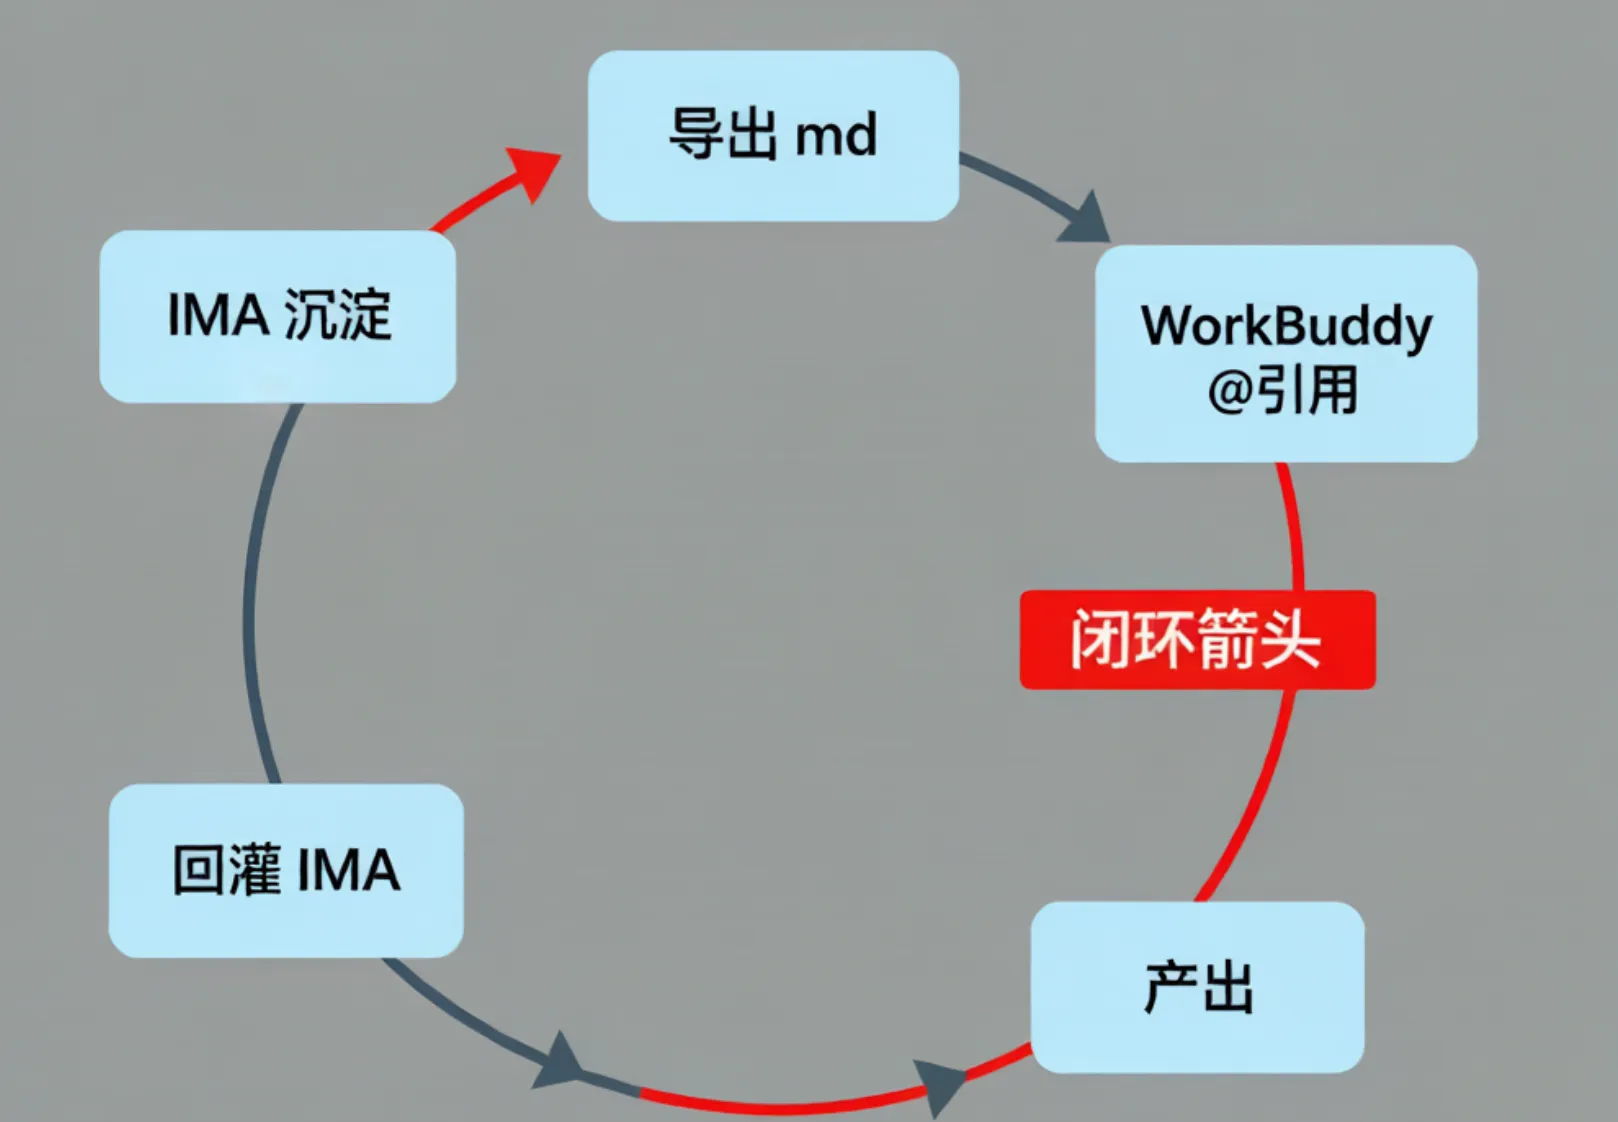
3.1 闭环流程(本人工作流实测)
以下流程为原生集成上线前的桥接方案,现已可用原生「资料库」入口替代;步骤本身的逻辑仍具参考价值。
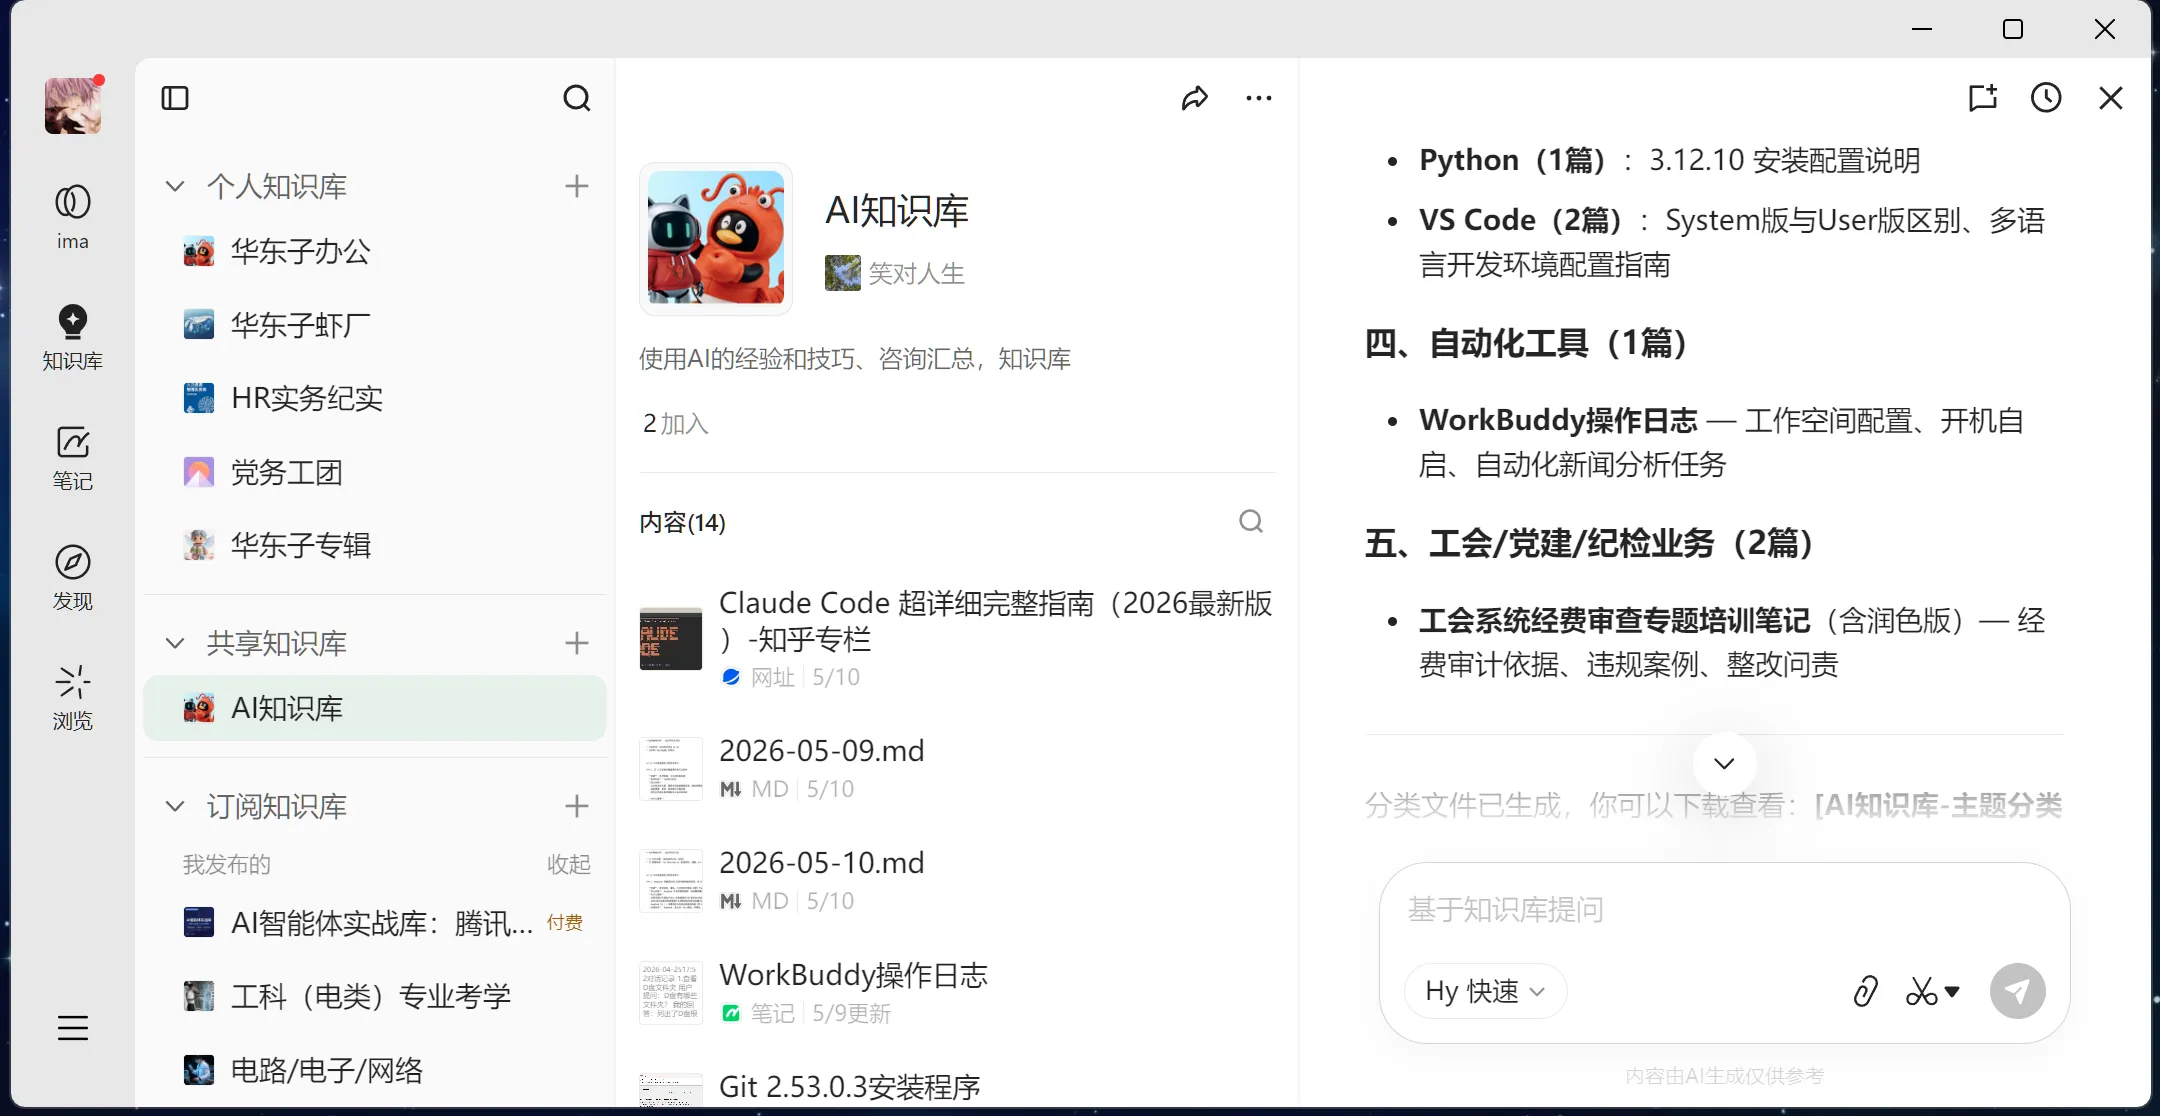
- 沉淀:在 IMA 按项目建知识库文件夹(我分了"养虾 / 资管 / 党建"三库),日常微信文章、文档、录音纪要一键存入。
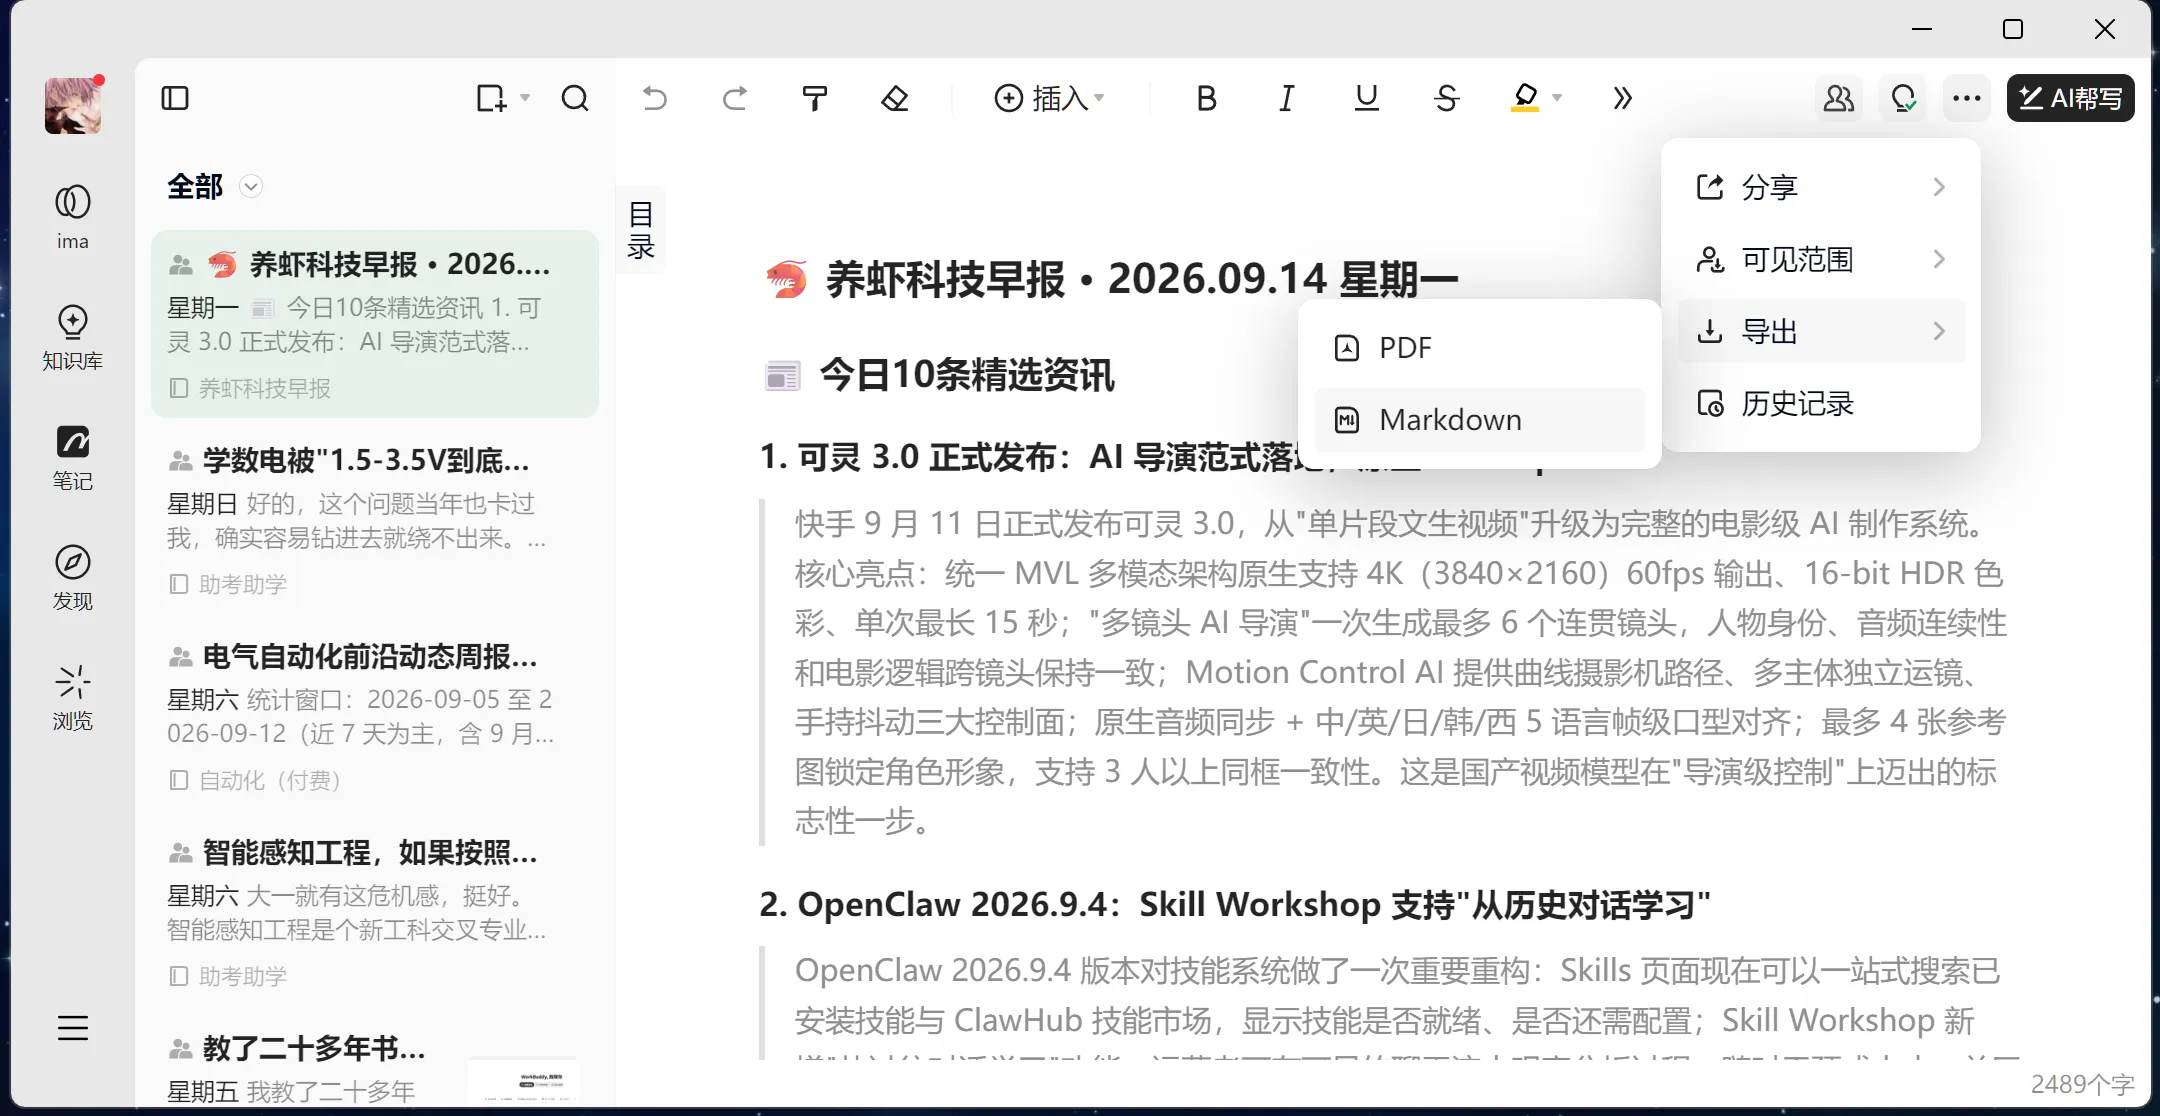
- 导出:写某篇内容前,从 IMA 把相关笔记导出为
.md文件(或复制正文),放到 WorkBuddy 的工作目录d:\WorkBuddy\下。
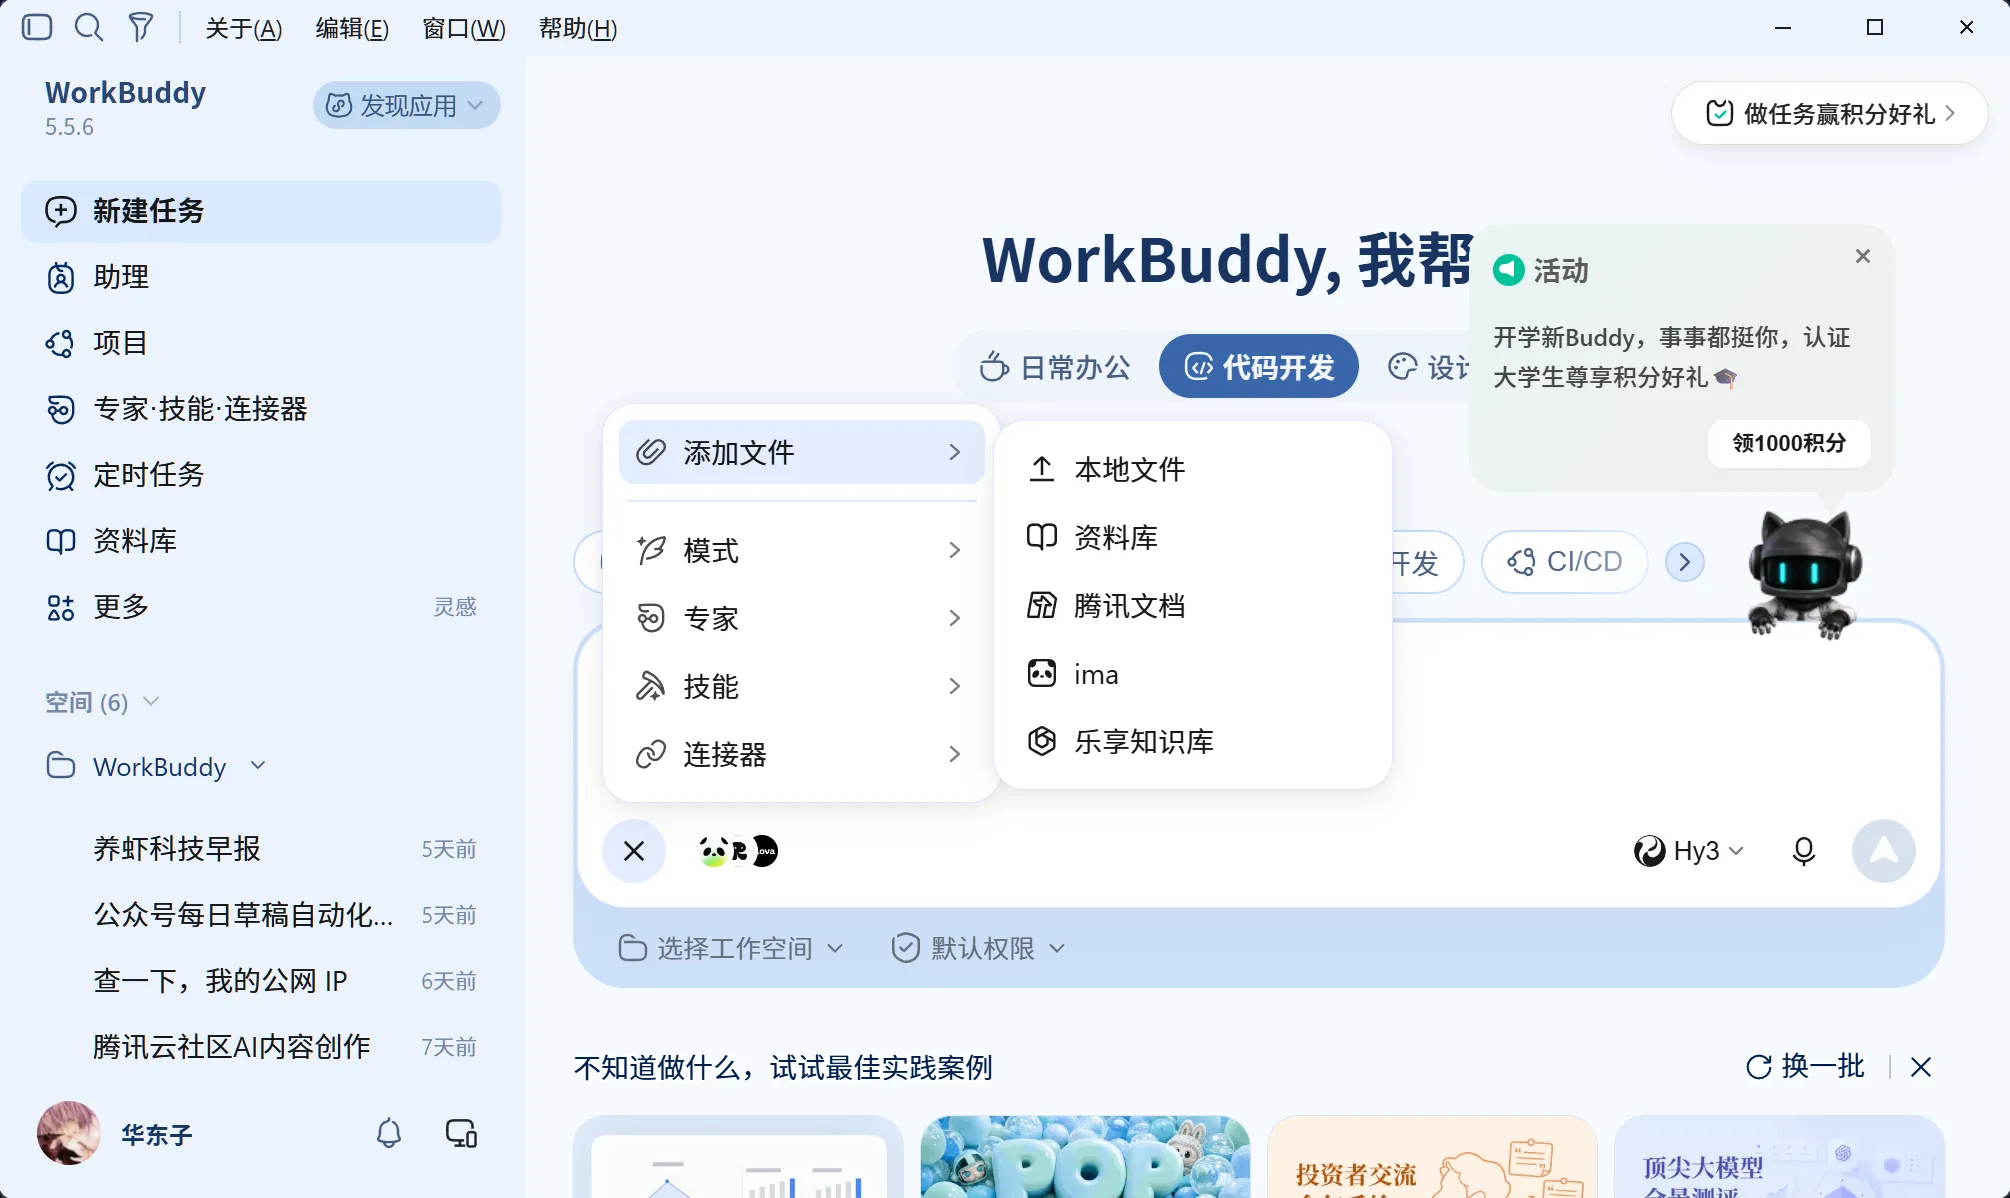
- 引用:在 WorkBuddy 对话里用
@文件路径或者点+号,把导出的笔记挂为上下文。AI 拿到的是"去哪读"的地址,能随时重读最新版。
- 执行:WorkBuddy 读取上下文,按指令撰写或编程,输出 Markdown / Word / 代码。
- 回灌:成稿里的精华输入"记入笔记"存回 IMA,闭环完成。
3.2 三个配置要点
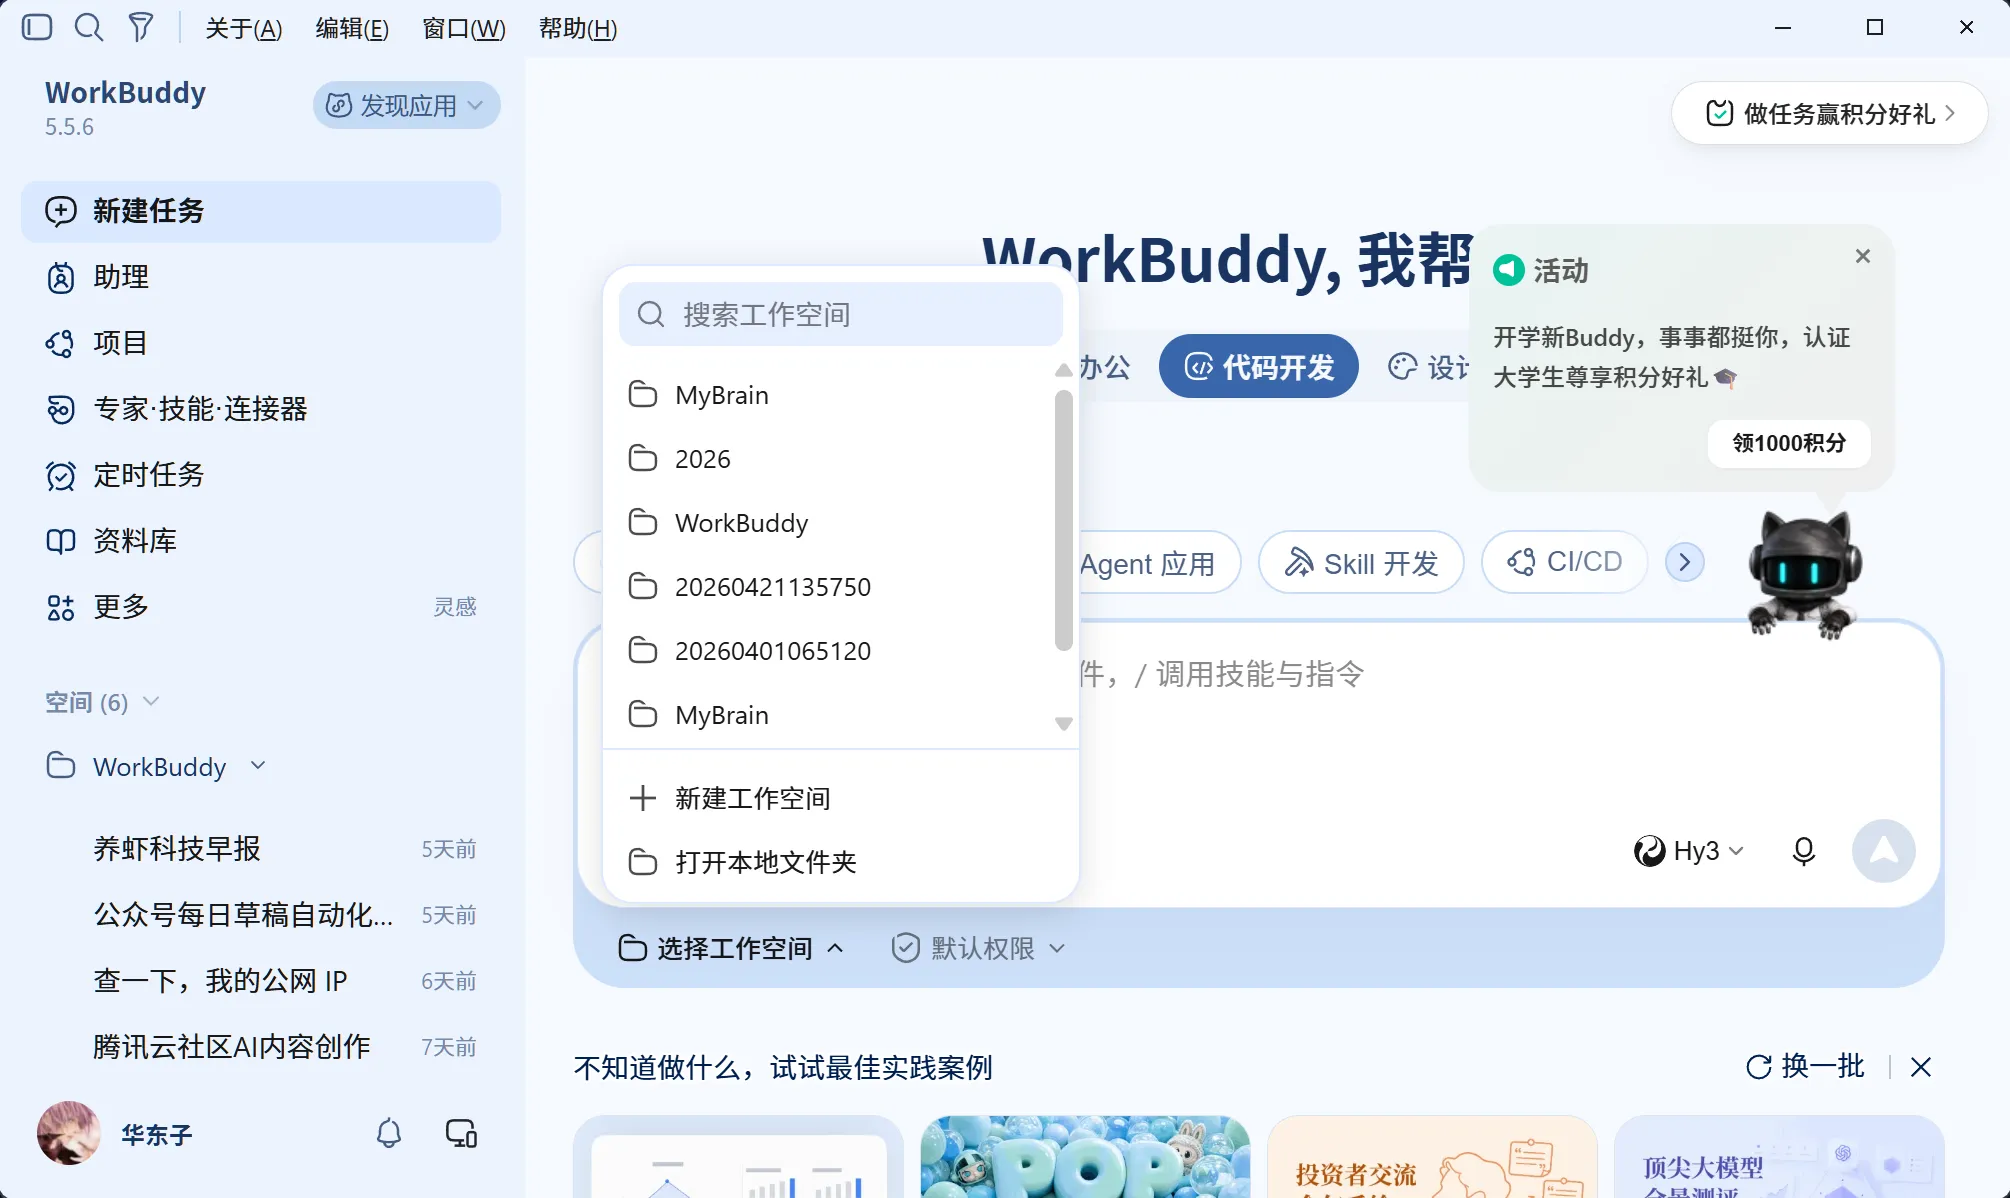
- 工作目录授权:WorkBuddy 只读写你明确授权的工作目录。把 IMA 导出的 .md 统一放一个约定子目录(如
留存/),别散落桌面,方便@引用。
- 格式统一 .md:我踩过坑——一开始直接把 IMA 笔记截图喂给 WorkBuddy,OCR 错漏多;改成导出纯文本
.md后,准确率明显提升。PDF 也能读,但 .md 最稳。 - 闭环纪律:只沉淀不回灌,知识库会 stale;只执行不沉淀,每次从零。写→存这一步不能省。
四、实践效果(本人工作流实测)
以下均为我自己的节奏对比,非行业基准,仅供参考:
- 养虾系列文章:把 IMA 里 300+ 条养虾笔记当上下文,WorkBuddy 一小时出初稿;以前从零翻记录、拼素材,往往要大半天。差距不在"写得多快",在于"不用先找半天资料"。
- 资管周报:IMA 存了历史周报,WorkBuddy 拉取生成新周报框架,从手写半小时压到几分钟,人只改口径。
- 规范类文档:把团队规范 .md 用
@引用,WorkBuddy 照着出同类文档,避免每次复制粘贴大段背景。
我的判断:这套组合的最大收益不是"单次更快",而是知识资产可复利——你今天沉淀的,明天直接被复用。但也要说清楚边界:它替代不了你的判断,框架能生成,观点和核实还得你自己来。
五、经验总结(含踩坑)
- 闭环优先于工具:没有"写→存"回灌,知识库就是死档案;没有"存→用"引用,工作台每次裸奔。两边必须转起来。
- 导出格式定 .md:截图/OCR 路径错漏多,纯文本最稳。
- 脱敏再进库:客户名、合同号、内部数据,进 IMA 前先打码。知识库是长期资产,泄露成本很高。
- 踩坑实录:曾试图让 WorkBuddy 直接"读取 IMA 网页",当时授权链路尚未开放,属阶段性限制;老老实实走"导出 md + @引用"反而最顺畅。后续官方原生集成已解决该问题,文件桥接仅在无直连场景下作为备选。工具没直连时,文件桥接比硬连更可靠。
六、常见问题 FAQ
Q1:两产品能一键互通吗?目前支持官方原生直连:WorkBuddy 已将 ima 知识库内置到「资料库」入口,扫码 OAuth 授权即可直接调用,4.24.1+ 无需第三方连接器,ima MCP 连接器亦可直接使用。桥接法(IMA 导出 .md → 进 WorkBuddy 工作目录 → @ 引用)作为备选保留。
Q2:知识放 IMA 还是 WorkBuddy?不冲突。IMA 管长期记忆(沉淀、检索、对话),WorkBuddy 管任务执行(读、写、生成)。一个"脑"一个"手",分工明确。
Q3:本地文件安全吗?WorkBuddy 只读写你授权的工作目录,敏感操作(删文件、跑命令)会请求确认,遵循最小权限。把 IMA 导出的脱敏 .md 放工作目录即可,别放含密钥的原始文件。
Q4:这套适合谁?内容创作者、分析师、需要"知识 → 产出"闭环的岗位最划算;纯一次性任务(写个便签)没必要走全套。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号