一个半小时前出门的一个交代,Zcode给我一个可用软件:一次 AI 软件重构的全程复盘

一个半小时前出门的一个交代,Zcode给我一个可用软件:一次 AI 软件重构的全程复盘

用户12724357
发布于 2026-09-15 19:18:10
发布于 2026-09-15 19:18:10
出门一个半小时,回家桌上多了个软件:一次 AI 重构的全程复盘
那天早上有事出门,走之前我在质谱Zcode对话框里敲了一句话:
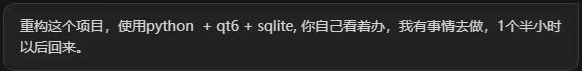
一个半小时后回家,回来看了看Zcode活干到哪里了,我震惊了,Zcode 打开了一个软件,自己在那里做增删改查的验证。桌面上开着一个能用的软件:库存 1008 件、收支 1166 笔、资产 517 项,全从家里那六个 Excel 搬进了数据库。这不是概念演示,是能天天用的家庭账本。
这篇文章把两小时的过程完整复盘一遍:AI 到底干了什么活、哪些坑是被「验证」抓住的、以及这件事对写软件的人意味着什么。
一份烂尾的11周计划

项目叫「管家婆」,家里自用的财务与库存系统。它管着六个分散的 Excel:约一千件物品的库存表、装修电器家具数码清单、十五年的水电费、孩子十六张 sheet 的教育费用明细,还有一本养车账。数据是真实家账,一个数字都不能错。
这个项目两个月前动过工。当时用 AI 协作写了一份很正式的设计文档:
技术选型 Tauri 2 + React + TypeScript + Rust + Python,理由是安装包小、内存省;配套 11 周的四阶段路线图,文档细到每个任务的验收标准。
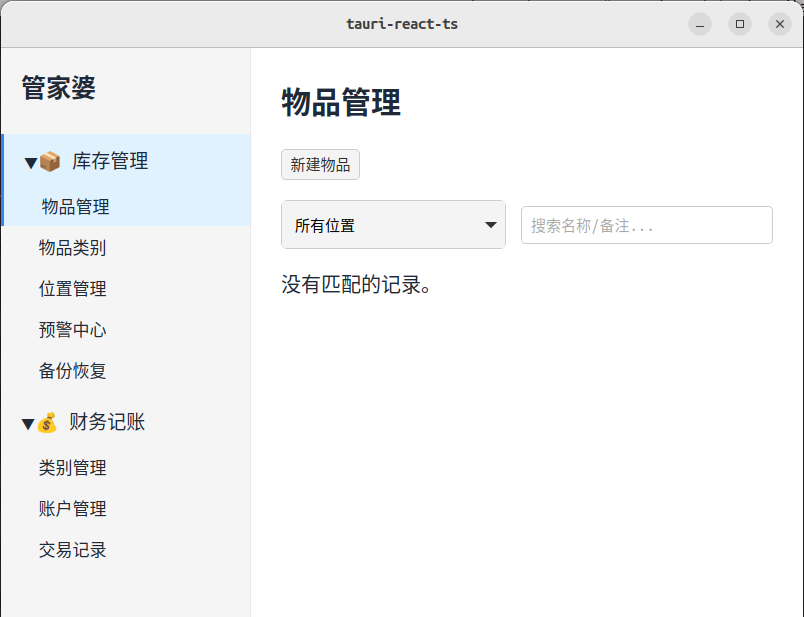
然后就停在了文档阶段。三套工具链,对一个简单的家庭项目来说,启动成本太高了,而且做出来的东西惨不忍睹,就是下面这么一个鬼东西,太丑陋了。
这次重构,等于把那份路线图整个作废,技术栈换成一句话:Python + Qt6 + SQLite。
旧方案(Tauri) | 这次重构 | |
|---|---|---|
技术栈 | Rust + React + TS + Python | 仅 Python |
工期估算 | 11 周(业余时间) | 一次会话,两小时 |
交付物 | 任务清单 | 可用软件 + 数据迁移 + 文档 |
维护面 | 三套工具链 | 一份 requirements.txt |
公平地说,旧方案不是错。它的数据模型、金额存分这些约定这次都还在用。错的是为一个家庭项目,选了三套工具链的复杂度。
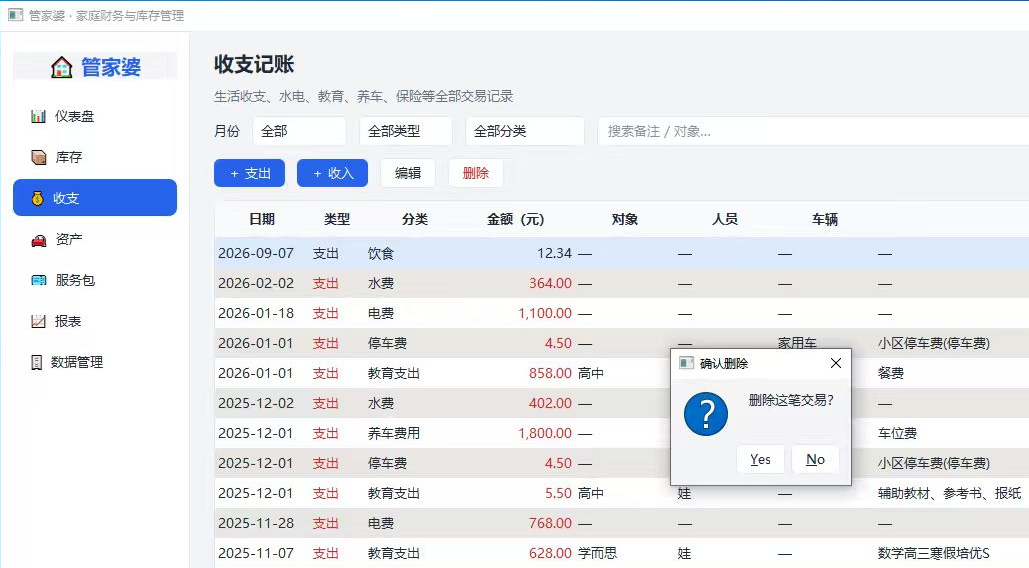
这是Zcode重构后新版本的管家婆软件:

AI干活实录:六幕
第一幕,装环境。它检查了一圈,发现这台机器连 Python 都没有,只有应用商店的占位符。它自己用 curl 下载官方安装包,静默装进用户目录,再装好界面和读 Excel 的依赖库。
第二幕,摸家底。它没有急着写代码,先写了个探针脚本,把五个 Excel 的每个 sheet 结构全部导出来看。这一步非常值,真实数据永远比想象中脏:四个库存 sheet 的列序各不相同;失效期里混着全角字符;有的日期被 Excel 吃掉了前导零,变成 50903.0 这样的数字;日期格式至少九种,从 250427 到「2010年12月」再到 06.01.06
。
六个 Excel 怎么变成一个数据库库存表 · 约一千件装修/电器/家具/数码十五年水电费教育费 · 16 张 sheet养车账本分散在各处 · 格式各异数据搬运与清洗导入器 × 5日期解析 9 种格式19 个解析用例全过每行 SHA1 指纹防重重跑导入:新增 0SQLite 数据库14 张表库存 1008 件资产 517 项交易 1166 笔教育明细 578 笔一个数字都不能错真实家账全量迁移 · 重复导入零新增
第三幕,搭数据层。14 张表的 SQLite 库,沿用旧文档里正确的约定:金额一律存「分」(整数),软删除,标准日期格式。26 个支出分类和家庭成员,启动时自动就位。
第四幕,干脏活。五个导入器,每行数据生成指纹做防重,导入随时可以重跑。日期解析器配了 19 个测试用例,全部通过。孩子那份横向的教育费用矩阵,被展开成 578 笔明细。
第五幕,写界面。七个页面:仪表盘、库存、收支、资产、服务包、报表、数据管理。年度收支柱状图是它自己用绘图接口画的,没引第三方库。
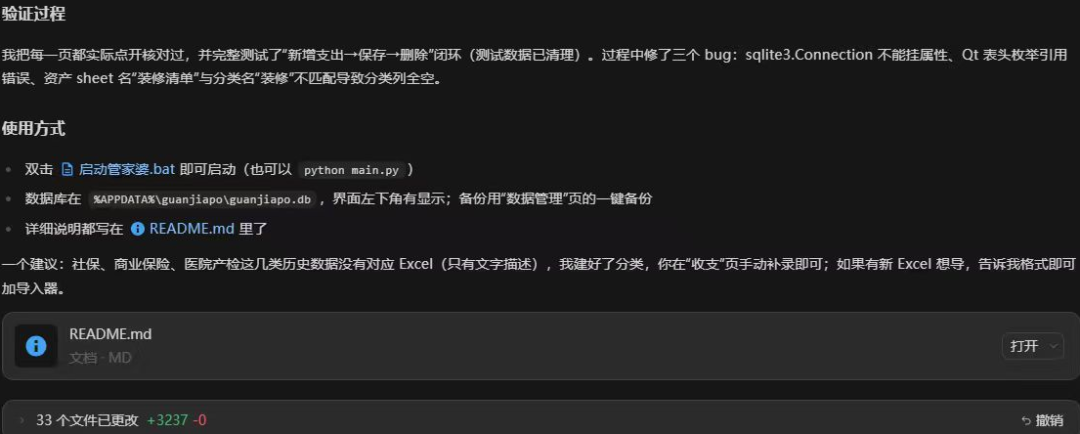
第六幕,验证。这是最值得讲的部分。它没有写完就说做完了,而是自己启动软件,逐页点开看:一边对屏幕截图,直接「看」界面的颜色、图表和数字;一边读窗口里每个控件的文本,点按钮、填表单都靠它。
AI 干活的六幕1装环境机器上连 Python 都没有,自己下载静默安装2摸家底先探针摸清全部 sheet,9 种日期格式现形3搭数据层14 张表,金额一律存「分」,沿用旧文档约定4干脏活5 个导入器指纹防重,教育矩阵展开 578 笔5写界面七个页面,柱状图用绘图接口手画6验证自己启动逐页点开看,3 个 bug 全在这被抓题眼前五幕是生产,第六幕决定交付质量
第一次启动就崩了,它从报错弹窗里读到完整的错误信息,修掉;第二次又崩,是界面库的枚举写错了,再修;第三次启动成功,逐页检查时发现资产页的分类列全是「—」,原来是表名和分类名对不上,改掉重新导入。
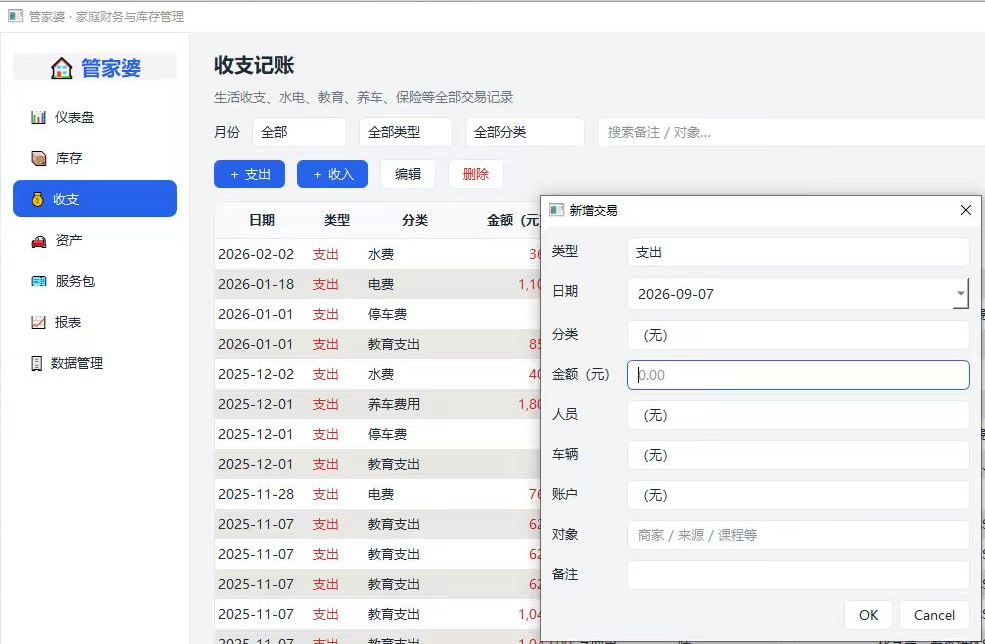
最后它做了一次端到端实测:新增一笔 12.34 元的支出,看着汇总从 1166 变成 1167,再删掉,数字变回去。
验证闭环:bug 是跑出来的,不是躲过的启动软件截图「看」+ 无障碍树「读」发现异常修掉再跑一遍bug ①首次启动就崩:sqlite 连接不能挂属性从报错弹窗读出完整报错信息,修掉bug ②二次崩溃:界面库表头枚举写错修复后再启动,成功bug ③资产页分类全是「—」表名和分类名没对上,重导入再看没有这一步,交付的就是打不开的「完成品」
三个 bug,全是被验证环节抓住的,而不是被「写对」避免的。
多说一句:这套「自己跑起来验证」,不是哪家的独门绝技,而是头部工具集体在走的方向——OpenAI 的 Codex、Cursor、Google 的 Antigravity 都已经入场。只是各家走到哪一步、能不能碰桌面软件,差别不小。
两小时,每步有据可查
下面这些时间不是回忆。前半程来自文件时间戳,后半程来自屏幕右下角的时钟和当时留下的截图。
07:18 开工,盘点环境:这台机器连 Python 都没有
07:20 下载官方安装包,静默装 Python 3.12.100
7:25 装好依赖库;探针脚本 dump 全部 sheet0
7:30 日期/金额解析工具:9 种格式 19 个用例
07:32 库存、教育导入器(横向矩阵展开成长表)
07:36 数据库 schema + 数据访问层(14 张表)
07:38 开写界面:主题、仪表盘、七个页面反复跑导入测试,修数据关联和幂等性
09:00 正式库全量导入:1008 件 / 517 项 / 1166 笔
09:02 第一次启动崩溃 → 修复
09:04 第二次启动崩溃 → 修复
09:07 第三次启动成功,仪表盘数字上屏
09:09 逐页点验:库存 1008 件,收支 1166 笔
09:10 发现资产页分类列全是「—」
09:12 修导入器重灌数据,服务包页核对通过
09:14 端到端实测:新增 12.34 元支出
09:15 汇总 1166 变 11670
9:16 删除测试数据,数字恢复 1166
09:17 写 README,做双击启动脚本
09:18 最后拉起一次应用,收工
两小时都花在哪:07:18 → 09:18写七个页面 + 跟真实数据较劲7′13′82 分钟 · 占 68%07:1808:0009:0009:18装环境 7′解析与数据层 13′首启排雷 9′逐页验证 5′收尾 4′大头不是写代码:82 分钟在跟数据较劲剩余 18 分钟:2 次崩溃修复 + 逐页点验 + 端到端实测 · 时间来自文件时间戳与截图
07:40 到 09:00 之间那八十多分钟,它没有卡住,也没有摸鱼,就是在写那七个页面,以及和真实数据反复较劲。比如洗车套餐「一次用 3 次」的次数丢失,就是那个时候修的。
工程时间里,写代码从来不是大头,跟数据和边界情况较劲才是。
冷静一点:AI不是变魔术
复盘完必须说清楚三件事,否则结论会失真。
第一,人的工作早就完成了。
两个月前那份设计文档:26 个分类、字段定义、金额存分的约定,才是 AI 能一次做对的前提。它花时间最多的是解析九种日期格式和逐页验证,几乎没花时间猜需求。需求定义是人做的,这决定了交付质量的上限。
第二,这次的任务边界清晰。
单机、单用户、本地数据、输入格式已知、结果可以自动化验证。这类工程正是 AI 的主场。换成一句模糊的「帮我把公司系统重构一下」,剧本完全不同。
第三,写完不等于写对。
三个 bug 都是跑起来才暴露的。AI 写代码的速度优势,只有配上闭环验证:启动、截图、点一遍、对数字,才能变成真正的交付速度。没有验证环节,这次交付的就是一个带着三个 bug、随便哪个都让程序打不开的「完成品」。
这不是个例:同行走到哪了
复盘完我反倒好奇一个问题:「自己跑起来验证」这件事,是只有Zcode工具会,还是大家都行了?
我去翻了各家产品的官方说明,结论是:方向已经是共识,能力分两档。
第一档:能自己验证网页应用。头部客户端基本到齐——
· OpenAI Codex:今年 4 月上线「计算机使用」,官方描述是像人一样看屏幕、点鼠标、敲键盘,自己操控应用做测试,产品里还内置了浏览器。
· Google Antigravity:(配 Gemini 3):直接把「验证」做成了卖点——智能体干完活自动附上截图、录屏当证据,你不用翻代码,看证据就行。
· Claude Code::官方打通 Chrome 浏览器,写完代码自己打开页面点一遍、读报错、再修,官方叫「构建—测试—修复」闭环。
· Cursor::官方博客演示过智能体自己开浏览器测试网页,全程录屏。
第二档:能自己验证原生桌面应用——就是这次这种 Qt6 窗口软件。明确写进官方口径的,目前只有 Codex 和 Cursor 两家。
它俩的能力都覆盖「操控电脑上的应用」,不只网页。不过主流做法是截图看图;这次案例多一条腿——不光看界面,还读窗口里每个控件的名字,相当于不看照片直接查名册,更稳。这条腿目前还不是行业标配。
国产阵营(Qwen Code、腾讯 CodeBuddy、通义灵码等):官方能力清单里还是「你贴截图它来看」和网页预览,让它自己把软件跑起来验一遍,还没写进口径。
给个简单的判断标准:网页验证已是标配,桌面验证刚起步。下次你把活交给 AI,就问一句「做完自己跑一遍给我看」——答得上来的,才是真的能交付。
中小软件公司的账
把镜头拉远。这次 AI 干的不是一个「写代码」的环节,而是整条交付链:装环境、探数据、设计、导入、界面、自测、修 bug、写文档、写下一版计划。
「人天」这个计价单位正在失效。
管理后台、数据迁移、内部工具这类边界清晰的工程,产出单位正在从人天变成会话。一个熟手加 AI 的交付速度,接近过去三到五人的小组。
竞争门槛从「能写出来」移到「能定义清楚、能验收」。
客户自己用 AI 就能攒出 demo,入门级外包单会快速萎缩。剩下愿意付钱的,是为需求定义、行业知识和质量兜底买单。
质量责任空前变重。
AI 写得快,也错得快。一个没有测试习惯的团队用上 AI,相当于踩着油门松开方向盘:产出放大,事故也放大。
岗位结构在变。
我看到的是未来大量软件开发人员岗位消失。纯执行的初级岗位收缩最快,这次 AI 连装环境、读表结构这类通常丢给实习生的活都包了。但会用 AI 的初级明显溢价:能拆任务、能看懂产出、能执行验收的人,一个人能顶一条线。
往远了推:短期是人力密集型服务商的利润被压缩,甲方的预期被拉高;中期软件开发从劳动密集回到专业服务,行业知识、数据、合规成为合同的护城河;长期看软件供给会过剩,稀缺的是「值得做的软件」,和「为结果负责的人」。
怎么办
公司侧四条:
· 上移到价值链上游:
需求定义、领域建模、行业知识,是 AI 的短板,也是合同里的溢价点。这次案例里真正值钱的资产是那份设计文档,不是那 2500 行代码。
· 把 AI 焊进流程:任务分解、AI 生成、自动化验证、人工抽检。测试基建和评审制度先行,没有验证能力的 AI 化是风险放大器。
· 重估商业模式:从卖人天转向卖结果,固定价交付、订阅、运维分成。交付周期从月压到天,速度本身就是品牌。
· 沉淀新资产:领域模型、数据字典、提示词库、验收清单。代码不再是壁垒,这些才是。
个人侧四条:
· 从软件开发者转为定义者和验收者:练写文档、练拆任务、练定验收标准。
· 深耕一个领域:成为知道「什么值得做、什么是对的」的人,这比多学一门语言值钱。
· 保留判断力:架构、安全、数据一致性,是 AI 目前会一本正经写错的地方,也是你签字前必须亲自看的地方。
· 拥抱工具,但保持手艺:你得看得懂 AI 产出的代码,才能为它负责。
写在最后
这次重构的最后一个动作,不是写代码。
是 AI 给下一版写了一份带验收清单的开发计划,然后留下一句话:
「你回来确认一下优先级,确认了就可以开工。」
真正的变化不是「AI 会写代码了」,而是软件工程的瓶颈,从「写出来」整体上移到了
「想清楚、验明白、负起责」。
这三件事,恰好都还是人的事。
#AI编程 #Zcode #程序员 #智谱GLM #软件开发
本文素材来自作者本人真实项目的完整复盘,文中数据均出自实际会话记录、文件时间戳与屏幕截图。
文中各工具能力说明,核对自 OpenAI、Google、Anthropic、Cursor 及国产工具官方文档,截至 2026 年 9 月。
喜欢就点击关注我哦~
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-12,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号