Hermes Agent :5个省Token机制帮你省掉90%费用

Hermes Agent :5个省Token机制帮你省掉90%费用
用户12724357
发布于 2026-09-15 18:42:03
发布于 2026-09-15 18:42:03
我们使用的AI大模型服务有一种"记笔记"的能力——第一轮对话时,它会把系统提示词和前面的对话"记住",后面每轮对话只告诉它"新增了什么"。这叫上下文缓存,费用只有重新读一遍的十分之一。
但如果某一步操作让 AI "忘记"了之前的笔记,就要从头再读一遍,账单就暴涨了。
这篇文章,用 MiniMax-M2.7 实测,盘点 Hermes Agent 里 5 个省 Token 的机制,以及什么操作会让它们悄悄失效。
一、Prompt 缓存:最大头的省钱项
节省潜力:~90%
这是最关键的一个。
当你用 MiniMax-M2.7、Claude 系列、Qwen 等支持缓存的模型时,Hermes 会在每轮对话开头插入一个看不见的"书签"——技术上叫 cache_control breakpoint。
书签前面的内容,模型只需要读一次,后面的对话继续往里填。每次新增一轮对话,费用只算新增部分。
MiniMax 官方定价:
· 正常读取:1× 计价
· 缓存命中(读已记住的部分):0.1× 计价(0.03/M 输入,原价 0.30/M)
也就是说,缓存命中一次,省 90%。
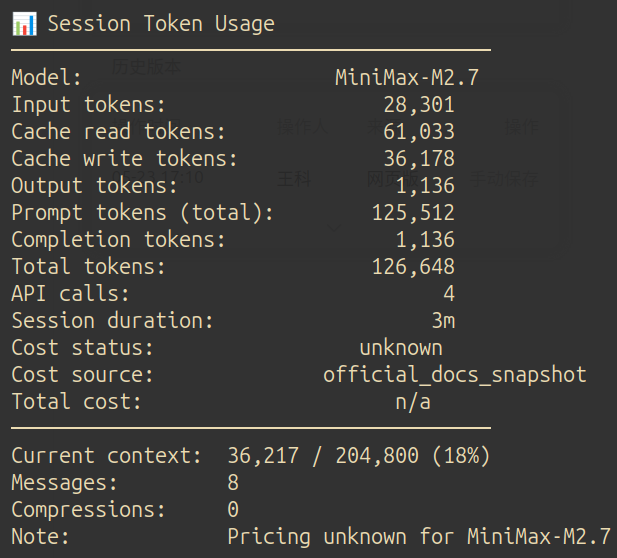
怎么验证缓存有没有命中?
在 Hermes 会话里输入:
/usage会显示:
1.input_tokens:这轮实际读了多少字
2.cache_read_tokens:从缓存里直接拿了多少
如果 cache_read 接近 0、input 持续很高,说明缓存没命中,一直在全额付费。
Prompt 缓存工作原理 第一轮 读全部内容 第二轮 只读新增 📖 书签(缓存断点) 缓存命中 已记住的部分 费用 = 0.1× 新增对话 正常计价 MiniMax 定价:缓存 0.1× vs 正常 1×,省 90% 输入 /usage 查看 cache_read_tokens 有多少
二、自动上下文压缩:对话太长时的救星
触发条件:context 超过 50% 阈值(可配置)
对话几十轮后,上下文越来越长,每轮都要读大量历史记录。Hermes 有一个上下文压缩引擎(ContextCompressor),会自动做这件事情:
当对话长度超过 context 窗口的 50% 时,用一个辅助模型把中间轮次"合并成摘要",保留关键信息,删掉冗余细节。
这类似于:一本很长的书,让人先读一遍,把每章内容缩写成一段话,后面的人只看摘要 + 最后几章,比重读全书省大量时间。
默认参数可以更激进
在 config.yaml 里可以调:
compression: enabled: true 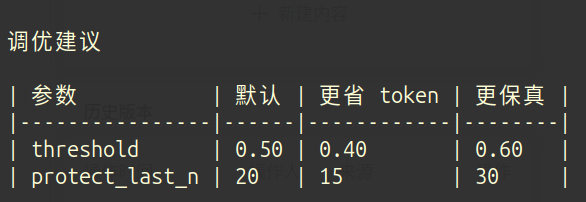
阈值越低,压缩越积极,费用越省,但中间信息保留越少。
注意:压缩触发时会调用辅助模型做摘要,辅助模型本身的费用是额外支出,但通常远低于被压缩省下的主模型费用。
三、System Prompt 缓存:Session 内的"免重读"
除了对话历史,Hermes 还会把系统提示词(skills 列表、工具描述、用户记忆等)缓存起来,整个 Session 只构建一次。
这避免了每轮都重新拼接完整的系统上下文。
但有几个操作会强制清除这个缓存,导致下轮全量重建:
1. 动态加载 skill:/skill xxx
2. 重新加载 MCP 工具:/reload-mcp
3. 切换模型或 Provider
其中最常被忽略的是第一条——每次动态加载 skill,当前 Session 的 system prompt 缓存就失效一次。
四、Skills 快照缓存:加速冷启动
每次 Hermes 启动时,要读取所有 skill 的 SKILL.md 文件来构建系统提示词。
Hermes 把 skill 文件列表(名称、大小、修改时间)缓存在:
~/.hermes/.skills_prompt_snapshot.json当下次启动时,如果文件没变,直接用缓存的 manifest,跳过文件 IO。
这不是运行时的省钱机制,而是启动加速——但如果文件变了(比如安装了新 skill),缓存自动失效,这是正常行为。
五、工具输出修剪:减少中间"噪音"
当你让 AI 执行一个命令,命令的输出(比如一个目录里 500 个文件列表)会全部塞进下一轮对话。
上下文压缩引擎有一个预 pass:用正则裁剪掉冗余的工具输出细节,替换成一句占位符:
[Old tool output cleared to save context space]
只保留关键结构。这在执行了大量命令的长对话中效果最明显。
六、手动压缩:主动控制
不想等自动触发?可以手动:
/compress立即触发一次上下文压缩。这在长任务中途(比如写了一半代码、做到一半分析)主动触发,可以控制压缩时机。
七、最容易让缓存悄悄失效的习惯
排名 | 操作 | 后果 | 建议 |
|---|---|---|---|
🥇 | 频繁动态加载 skill/skill xxx | system prompt 缓存全量失效 | 改用 config.yaml 预加载技能,运行时不再动态加载 |
🥈 | Session 存活太久 | 对话积累几十轮后,context 压缩频繁触发 | 长任务中途用 /clear 新开 session,历史积累清零 |
🥉 | 切换 Provider/Model | 换模型后缓存策略重新评估,旧缓存不跨模型共享 | 保持同一模型跑完一个完整任务 |
正常行为:压缩阈值到达触发压缩,这不是失效,是正常的省 Token 机制在运作。用 /usage 查看是否压缩正在工作。
八、两个阈值,别搞混
很多文章把两个不同的阈值混为一谈,其实它们各管各的:
1.Agent 压缩阈值(可配):默认 50%,超过就触发 ContextCompressor 把中间对话压缩成摘要。
2.Gateway hygiene 阈值(固定 85%):这是最后一道安全网——当对话积累到 context 窗口的 85% 时,gateway 强制压缩,防止爆窗口。这个阈值写死在代码里,不建议改。
也就是说:你的 config 里改的 threshold(0.40~0.50 之间)是 Agent 那层,85% 是另一层守卫,各司其职。
两个阈值各司其职 40% 50% 85% 100% Agent 压缩阈值 可配置(建议40%) Gateway 85% 固定,写死在代码里 爆窗口前最后一道守卫
九、实操配置清单
把以下配置加到 config.yaml,立刻生效:
compression: enabled: true threshold: 0.40 # 从0.50降到0.40,更早压缩 protect_last_n: 15 # 从20降到15,中间多压一些 auxiliary: compression: timeout: 120 # 辅助模型超时(秒) prompt_caching: cache_ttl: 1h # 缓存保留1小时,长session中途暂停仍能命中调完后,不需要重启,新对话立即生效。
用这个命令检查当前压缩状态:
grep -i "compress\|summary" ~/.hermes/logs/agent.log | tail -20十、认识这三个参数就够了
参数 | 默认值 | 更省设置 | 说明 |
|---|---|---|---|
threshold | 0.50 | 0.40 | 超过 context 的 40% 就压缩 |
protect_last_n | 20 | 15 | 最近15条消息不压缩 |
cache_ttl | 5m | 1h | MiniMax 缓存保留时间 |
cache_ttl 设成 1 小时,费用是写入的 1.25 倍(5m 是 1×),但长会话中途暂停再继续时仍能命中缓存,更省。
如何一次性快速配置?直接粘贴文章内容给Hermes Agent, 叫它进行判断和优化。
— END —
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-05-23,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号