AI"画图"和大语言模型有关系吗?

AI"画图"和大语言模型有关系吗?
用户12439631
发布于 2026-09-15 12:57:05
发布于 2026-09-15 12:57:05

我最近在琢磨两个问题:
AI到底是怎么画图的
AI写文章和AI画图,这两个能力,有什么区别和联系

这是我找到的答案——
01
图像AI的两个核心能力
图像AI,拆解开是两个本领:
"看图":识别和理解图像
这条路从2012年2012年ImageNet竞赛冠军获得者设计的AlexNet开始,核心是CNN(卷积神经网络)。那时候AI学会了认猫、认狗、认红绿灯。后来Vision Transformer把Transformer架构引入视觉领域,再后来有了GPT-4V这样的多模态模型,能同时"看"和"说"。
"画图":生成图像
这条路从GAN(生成对抗网络)开始,但真正的爆发是2020年后的Diffusion扩散模型。DALL-E、Midjourney、Stable Diffusion,还有现在的GPT-Image-2,都是这条路上的产物。
02
AI画图的秘密:从噪点里"雕刻"
我觉得这个最有趣。
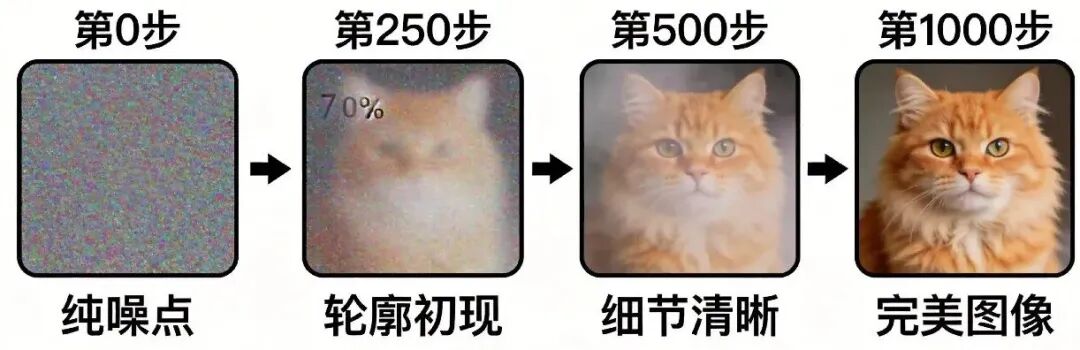
AI生成图像的过程大概是这样的:
[0%] 正在生成...(一团模糊)
[30%] 大致轮廓出现
[60%] 细节逐渐清晰
[100%] 完成图像
这个过程不是AI一次性画完的,而是在做一件事: 去噪 。
用雕刻打个比方:
米开朗基罗面前有一块原始大理石,什么都看不出来,就像电视机雪花屏。
他说:"我要雕刻大卫的像啦。"
然后:
第1刀:大致轮廓出来了
第10刀:能看出人形了
第100刀:面部细节出来了
第1000刀:完美的大卫像
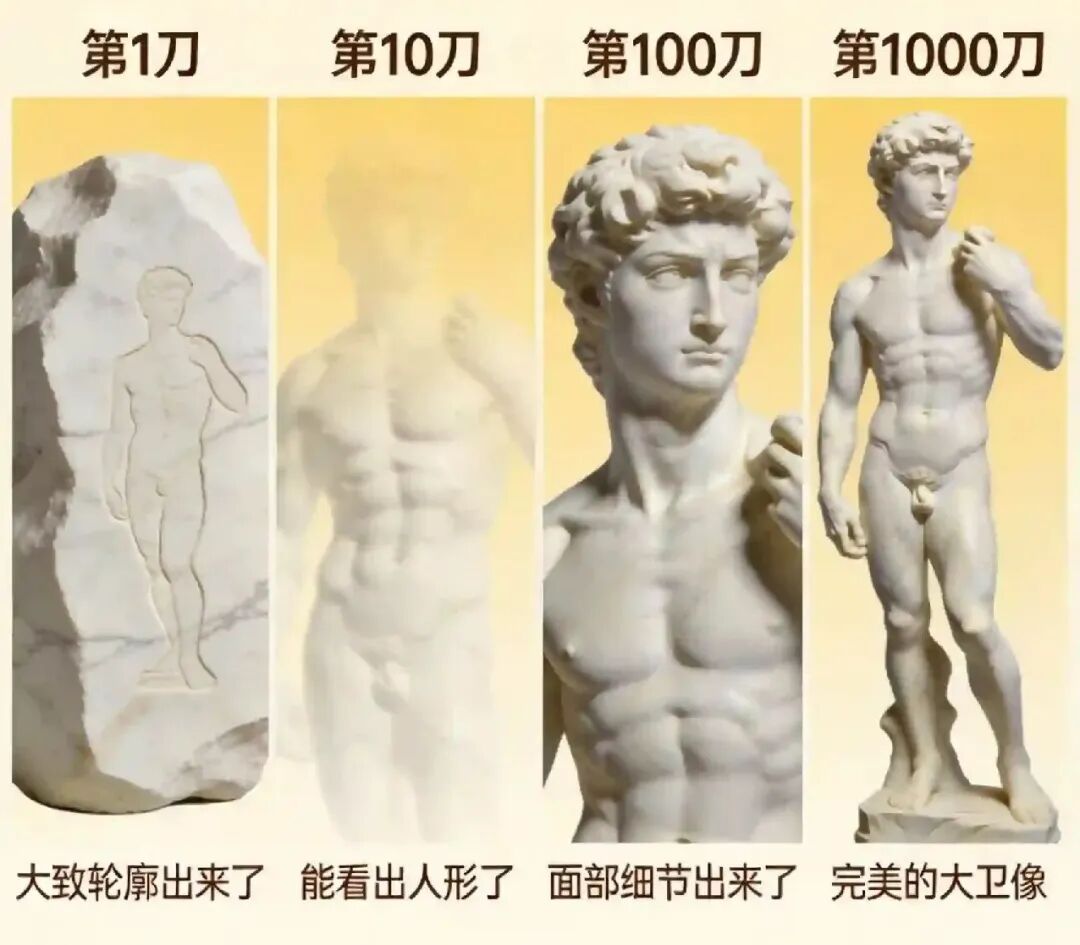
AI画图的过程叫做“去噪”,其实和米开朗基罗“雕刻”的过程差不多——
老米每刻一刀去掉一块“石屑”
AI每画一笔就去掉一些“噪点”
——把不需要的噪点凿掉,留下符合你描述的部分。
03
训练AI画图时,都训练了什么?
先进行“正向训练” :
拿一张清晰的猫图,一步步加噪点,直到变成纯噪点。AI记住了每一步怎么加的。
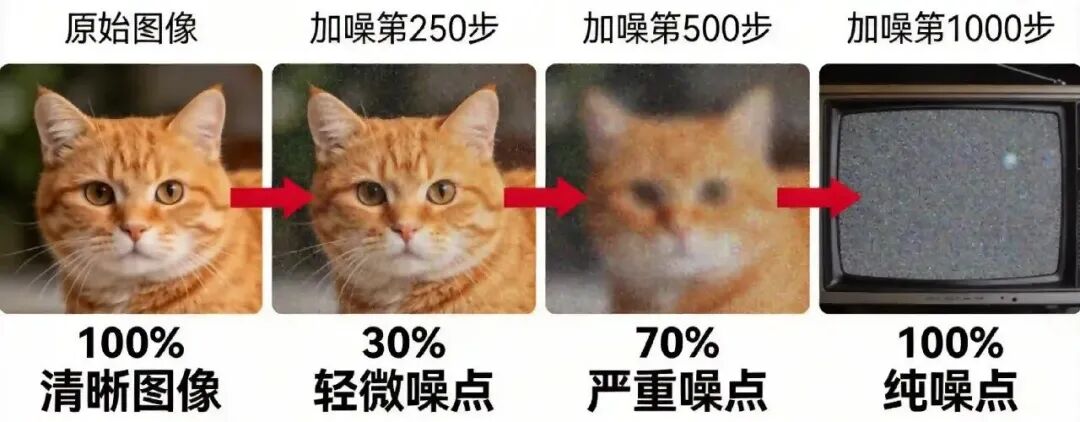
再进行“逆向训练” :
让AI反过来学习——给它任何程度的噪点图,它都知道怎么还原。
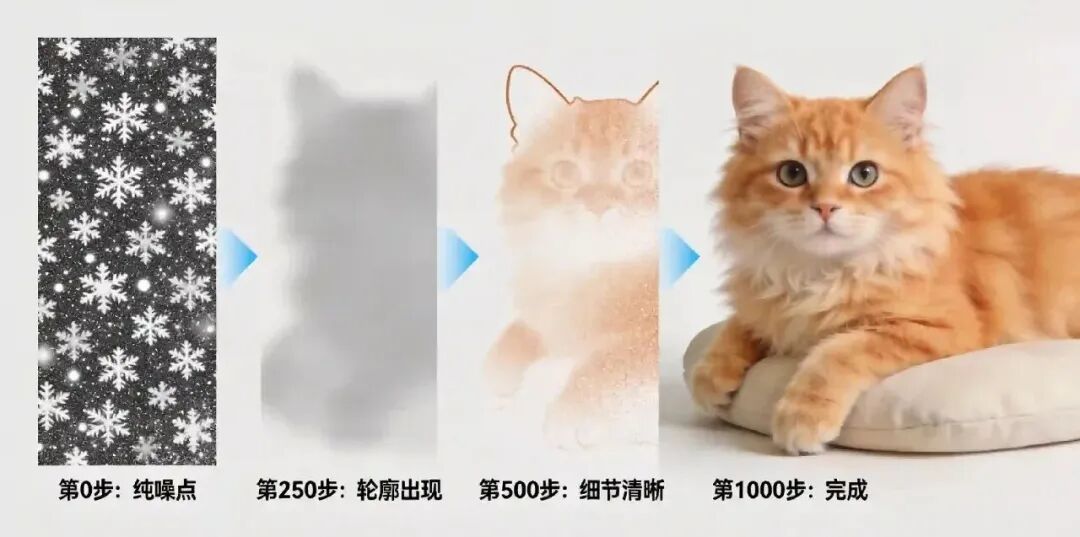
训练了几亿张图后,AI脑子里就有了"正常的图应该长什么样"的概念。
04
大语言模型促进了图像AI的发展
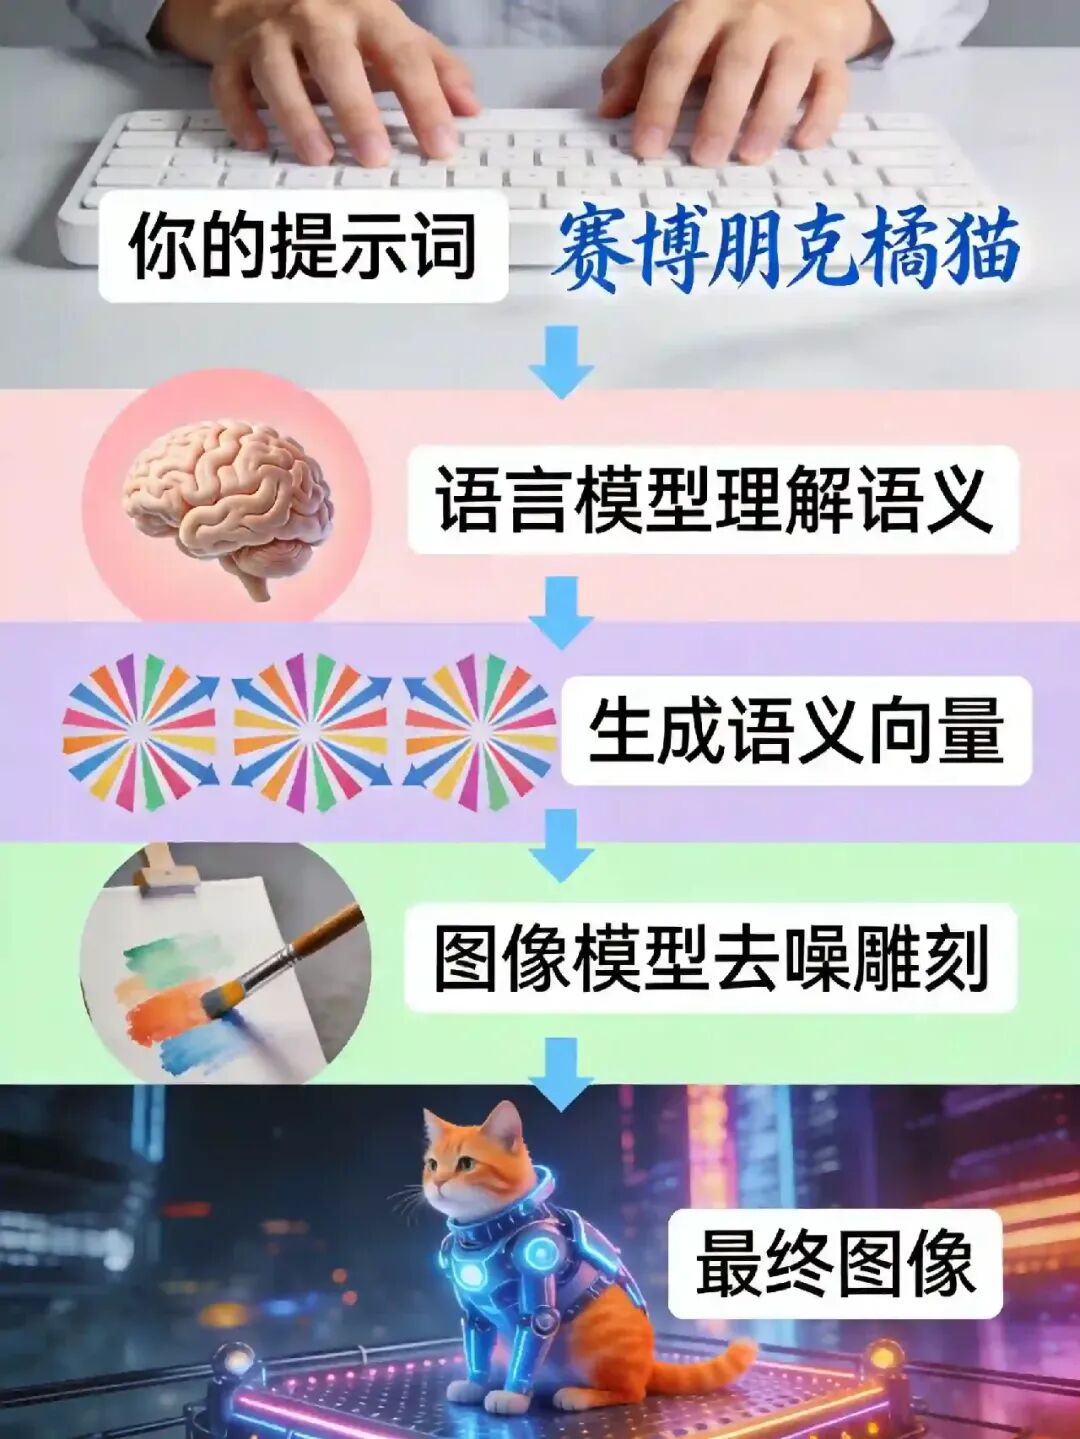
早期图像AI,你只能说"猫",它只能随机画。但现在,你能说:
"一只穿着宇航服的橘猫,站在月球上,背景是地球升起,赛博朋克风格,高细节,电影感光效"
然后它真能画出细节如此丰富的猫!
这背后的原因,就是大语言模型在帮忙翻译需求。使用的工具就是:
CLIP:语言和图像的桥梁
OpenAI在2021年搞了个突破性的东西叫CLIP,它同时训练一个语言编码器和一个图像编码器——
让它们学会:文字"猫"和图片"猫"在数学空间里应该很接近。
效果就是:仅仅用文字描述,AI就知道该往哪个方向"雕刻"。
05
为啥图像AI更强大了
原因不止两个:
- 算力爆炸。GPU算力提升,能训练更大更深的模型。
- 学习素材超多。互联网上几十亿张图片,AI看了个遍。
- 语言和图像模型融合发展(我理解就是多模态技术呗)。语言模型负责"理解",图像模型负责"画",两者配合。
而且,图像AI技术也在不断进化
最新发布的GPT-Image-2被称为"首个会思考的图像模型"
——它不是简单地把文字变成图,而是会"推理"想要什么。
这意味着图像AI也在从"工具"变成“数字员工”和"合作者"。
我觉得这真是很有趣——
在一块看不见的大理石上,AI正在按照我的描述,一刀一刀雕刻。每一刀都在去噪,每一刀都在接近我想要的样子。
从噪点到图像,从混沌到清晰……
本文所有配图均由AI生成。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-05-03,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号