一图读懂 | AI江湖的三层楼

我自学完OpenAI新发布的GPT-5.5之后,因为在AI界跑马圈地的大佬越来越多,节奏越来越快, 所以,干脆把芯片层、模型层、编程工具层、AI执行层——每个层面的大佬,都“仰慕”了一遍,并且画了个图(如有不妥,敬请大佬指正)。
下面开始AI江湖一文游(文末有详图)~
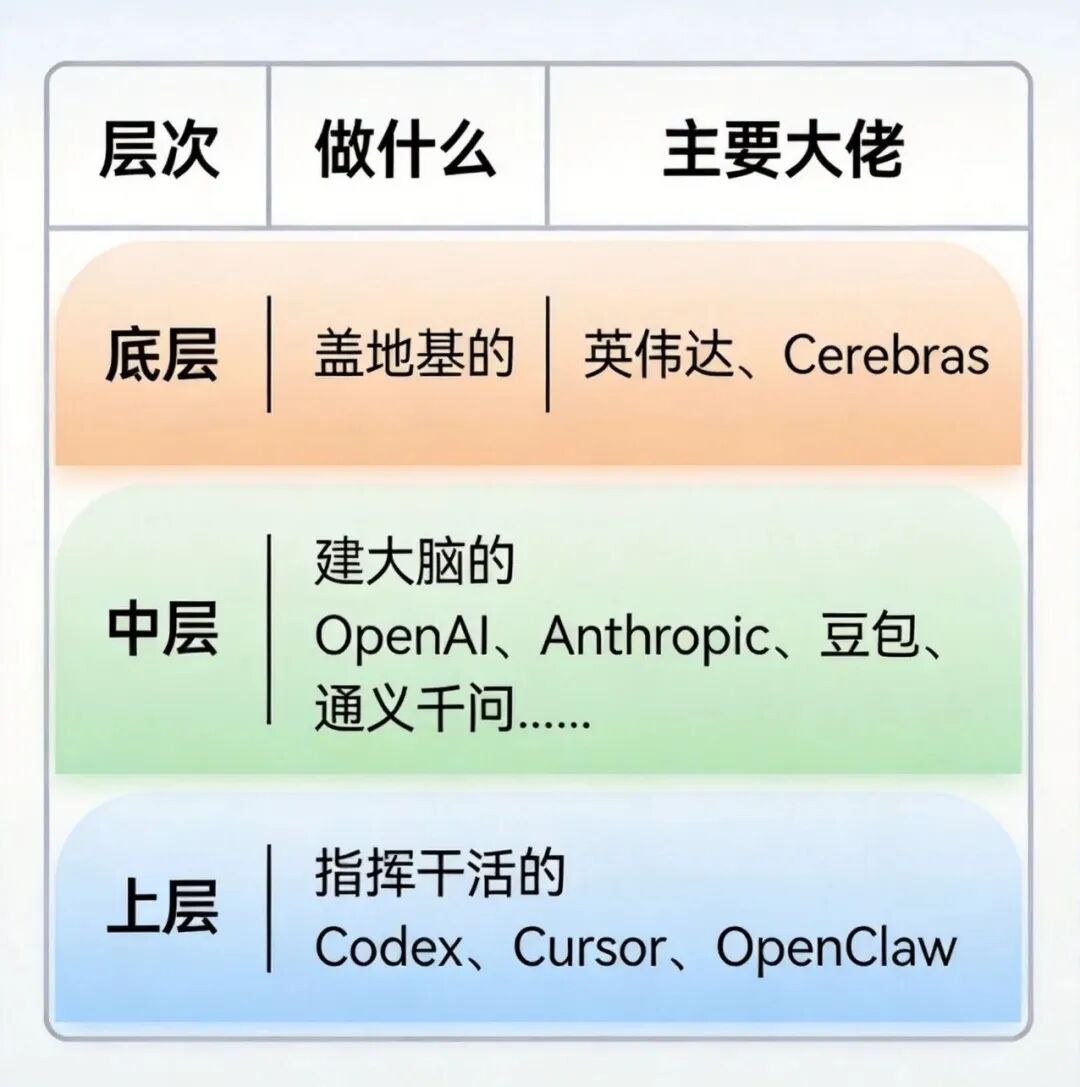
AI江湖,主要分三层,如表:
01

底层:英伟达是AI时代的“基础设施供应商”
这层最稳的玩家只有一个: 英伟达 。
很多人对英伟达的印象还停留在"游戏显卡公司"。这个印象已经过时很久了。现在的英伟达是 AI时代的基础设施供应商 ——你不用关心电从哪来,但你必须付费才能让机器运转。
GPT-5.5跑在哪上面?英伟达的GB200 NVL72系统。Claude跑在哪上面?Anthropic同样大量采购英伟达GPU。国内所有头部AI公司排队等货的,还是英伟达的芯片。
当然,底层也不只有英伟达。Google有自研TPU,AMD正在追赶,国内华为昇腾、寒武纪也在布局替代方案。但客观说,在高端AI训练芯片市场,英伟达的统治力目前还没有真正能被撼动的对手。
Cerebras:走不同路线的后起之秀
还有一家值得单独说:Cerebras
这家公司值得单独拿出来讲,因为它走的是和英伟达完全不同的路线。
英伟达是把很多块芯片拼在一起组成集群,Cerebras直接在整块晶圆上刻一颗芯片——它的WSE-3是目前全球规模最大的AI芯片,4万亿个晶体管,90万个计算核,面积是一块餐盘大小,是英伟达B200的五十多倍。
2026年 OpenAI签下了 Cerebras 超百亿美元的算力协议,它从"挑战英伟达的疯子"到"正式进入主流算力体系",转变速度比大多数人预想的快。
02
中层:全球大模型赛道格局
大模型这层,全球主要大佬大致分两派:闭源商用和开源生态。
中层(国外篇):全球四大模型,各有性格
OpenAI:依然定义天花板
GPT-5.5是它的最新版本,2026年4月23日发布。
一组数字说明OpenAI现在的体量:
- 估值约 8500亿美元
- 2025年年化收入突破200亿美元
- ChatGPT周活跃用户突破9亿
它不只是一个技术公司,它已经是全球最大的消费级AI入口。
Anthropic:最重视安全的玩家
Claude系列是Anthropic的核心产品。2026年3月发布Opus 4.7,在SWE-Bench Pro上短暂超越GPT-5.4,夺走了编程评测的榜首。随后GPT-5.5发布,又把它压了回去。
Anthropic有意思的地方不在于它有多强,而在于它的路线选择:它在模型安全、能力边界、价值观对齐上的投入,是所有大模型公司里最重的。(我作为它的早期用户,特有体会)它的创始人来自OpenAI,对AI风险有更深的警惕,这让Anthropic在企业级市场(尤其是金融、医疗、政府等高敏感场景)有独特的信任优势。
Google:被低估的巨头
Google在AI上的投入其实不输给任何人,但它的尴尬在于:技术很强,产品却总是差那么一口气。
Gemini系列这几年进步很大,Gemini 3.1 Pro在全球闭源商用模型里稳居前三,多模态能力(理解图片、视频、音频)是它的长项。但Google的问题是:有一个强大的对手叫OpenAI,有一个好用的入口叫ChatGPT,用户为什么要切换到Gemini?
这种困境,有点像当年的百度——技术不差,但护城河在被人侵蚀。
Meta:开源世界的搅局者
Llama系列是Meta开源出来的。这个策略很有意思:把模型开源,让全球开发者免费用,形成生态,然后从生态里获利。
某种程度上,Meta在做的是AI时代的Android——不靠卖模型赚钱,靠生态影响力构建壁垒。对中小企业和个人开发者来说,Llama是目前最具性价比的开源选项。
中层(中国篇):国产AI正在全面追赶
国内的大模型赛道,2026年最大的变化是: 不再是"追赶",而是开始有自己的生态位。
一个值得记住的数据:
根据OpenRouter平台数据(2026年3月),中国大模型Token调用量达到 4.19万亿, 首次超越美国的3.63万亿。全球调用量前五名里,国产模型占了三席。
字节跳动·豆包:DAU之王
豆包目前是国内用户量最大的AI应用,背靠字节跳动的流量生态(今日头条、抖音、飞书),在C端入口上有天然优势。它的策略很清楚: 不追求单模型能力最强,追求用的人最多。
阿里巴巴·通义千问:开源基建路径
通义千问(Qwen)是目前全球下载量最高的开源大模型。它的策略和字节相反: 不主攻C端,主攻B端基础设施。 通过开源建立开发者生态,再把企业级用户引向阿里云。
阿里的逻辑是:大模型是水电煤,我负责把水电煤建好、卖好就行。
月之暗面·Kimi:长文本的极致
Kimi的核心差异化是它的长上下文窗口——能一次性处理超长文本。这在法律文档分析、剧本审读、长篇报告整理等场景里有独特优势。2026年传出上市消息,说明它的商业化已经到了一定规模。
智谱AI·GLM:最老的国产玩家
智谱是国内最早一批做大模型的公司,2026年率先登陆资本市场,被称为"中国AI大模型第一股"。它的核心优势在于政府和企业市场,深耕了多年,有成熟的B端客户积累。
MiniMax:闷声发力的玩家
在字节、阿里、百度的声量夹击下,MiniMax的存在感相对低调,但它的用户调用量常年稳居国产前三。它的策略偏向B端和场景落地,比较务实。
腾讯·元宝:需要加速的玩家
腾讯的混元大模型在技术评测上跟头部国产模型差距不大,但它的尴尬和Google有点像:入口优势(微信、QQ)没有转化为AI产品优势。2026年混元3.0即将发布,能不能追上来,值得关注。
03
上层:AI开始真的在干活了
这层是2026年最值得关注的趋势所在。
过去,AI的能力止步于"输出"。它能给你写一份报告,但你得自己复制、粘贴、发出去。这最后一步的"动手",一直是AI无法跨越的鸿沟。
2026年,这个边界正在被打破。
编程工具:AI替代工程师的争议战场
这个赛道2026年最热闹,因为GPT-5.5发布让Codex的能力大幅提升,Claude Code紧追不舍,加上Cursor和GitHub Copilot,整个战场呈现出"四强争霸"的格局。
工具 | 背后公司 | 一句话定位 |
|---|---|---|
GitHub Copilot | 微软/GitHub | 企业级安全合规,市占率42% |
Cursor | Anysphere | AI Native IDE,估值290亿美元 |
Claude Code | Anthropic | 复杂工程任务专家,专业开发者首选 |
Codex | OpenAI | GPT-5.5加持,Terminal-Bench 82.7% |
一句话结论: AI编程工具的竞争,本质上是在回答同一个问题: AI能代替多少比例的工程任务? 现在大概是六成左右,剩下的四成还需要人类判断。
AI执行框架:把AI从屏幕里拉出来
这是最容易被忽略、但实际上最有变革潜力的一层。
大模型再强,它的输出终点是屏幕。而真实世界里,大量工作不是"生成内容",而是"执行流程"——把文档格式调对、发给对应的人、填进某个系统、按设定的时间启动。

OpenClaw 是这类工具里的代表。它的核心功能是:让AI真正操控一台电脑。控制浏览器读写网页、发送消息、创建文档、管理日历、按时间自动触发任务——这些大模型不会的事,它能做。
这个赛道上最值得关注的新玩家是 Hermes Agent (Nous Research出品,2026年2月发布)。它的核心差异化在于"越用越聪明"——持久记忆 + 自改进架构,每一次会话中学到的东西都会沉淀下来,随着使用时间增长能力持续进化。
两条路线各有优势:Hermes 适合个人用户长期培养一个"越来越懂你"的助手,OpenClaw 适合企业快速搭建自动化流程。
04
AI大佬全图
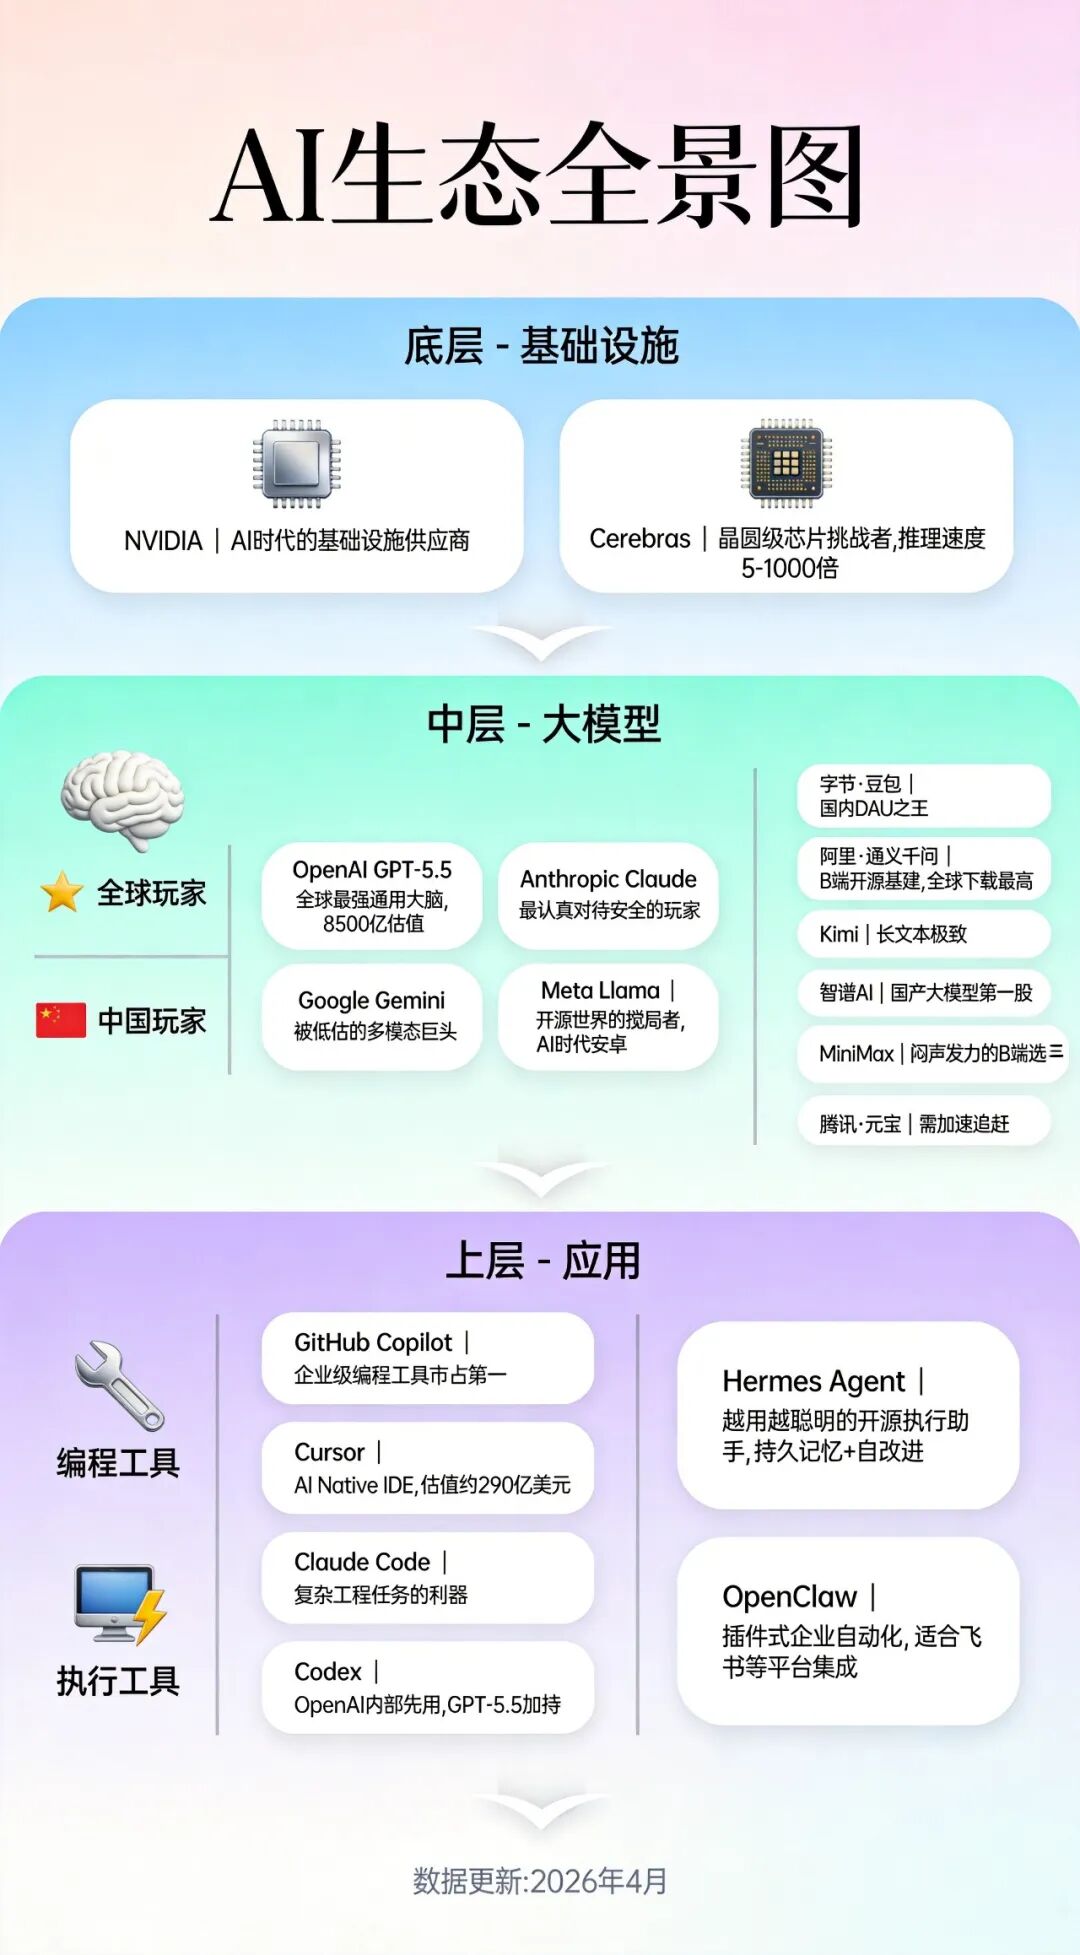
画完这张图,我最大的感受不是"AI太强了",而是AI的分工正在变得清晰。
盖地基的,建大脑的,写代码的,执行任务的——每一个角色都有自己的生态位,都有自己的竞争逻辑。
GPT-5.5是这个浪潮里最新的一个注脚,但它不是故事的全部。
故事还在展开,而且展开的速度,可能比大多数人想象的要快。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-04-24,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号