Evo 2:跨越生命三域的基因组建模与设计基础模型

Evo 2:跨越生命三域的基因组建模与设计基础模型

用户8140185
发布于 2026-09-15 10:32:53
发布于 2026-09-15 10:32:53
研究背景与核心问题
生命的全部信息都编码在DNA之中。尽管基因组测序、合成与编辑技术已深刻改变了生物学研究的面貌,我们对基因组所承载的复杂信息的理解仍然极为有限——大量基因组变异的功能效应难以预测,从头设计全新的生物系统更是充满挑战。
前代模型 Evo 1 已证明,在原核生物基因组序列上训练的语言模型能够对DNA、RNA和蛋白质功能进行建模。然而,真核生物基因组的规模与复杂程度远超原核生物,这对模型的数据量、上下文窗口和架构设计都提出了更高的要求。Evo 2 正是在此背景下应运而生,它是目前规模最大、覆盖最广的生物基础模型,旨在实现从分子到全基因组尺度、跨越生命三大域(细菌、古菌、真核生物)的统一建模。
模型架构与训练数据
两个版本,各有侧重
研究团队训练了两个规模的模型:参数量为70亿(7B)的版本在2.4万亿个token上完成训练,400亿(40B)的大模型则在9.3万亿个token上训练。对于下游任务,两者均有使用价值,但40B模型在多数基准测试中表现更优,同时计算开销也显著更高。
OpenGenome2:覆盖生命三域的训练语料库
训练数据集被命名为 OpenGenome2,来自经过精心去冗余处理的核苷酸序列,总计超过8.8万亿个碱基,涵盖细菌、古菌、真核生物和噬菌体四大类别。值得注意的是,出于生物安全考虑,感染真核宿主的病毒基因组序列被明确排除在训练集之外——实验也验证了这一排除的有效性:模型对真核病毒序列表现出极高的困惑度,意味着其对该类序列的建模能力刻意受限。
两阶段训练策略
训练分为两个阶段。第一阶段以8,192个token的短上下文窗口进行预训练,数据采样时对基因区域进行加权,优先让模型学习功能性遗传元件的表达模式。第二阶段为"中训练"(midtraining)阶段,分多步将上下文窗口逐步扩展至100万个token(即约100万碱基对),使模型能够捕捉基因组中跨越远距离的元素间关系,例如拓扑关联结构域(TAD)内的调控关系。这一设计哲学与自然语言领域大模型的最佳实践一脉相承。
StripedHyena 2:新一代混合架构
Evo 2 采用了专门设计的 StripedHyena 2 架构,这是一种卷积多混合体系结构,在注意力机制的基础上融合了三种不同的输入相关卷积算子(短程显式算子、中程正则化算子和长程隐式算子),分别负责建模不同尺度距离上的序列依赖关系。与标准Transformer基线相比,该架构在100万上下文长度下吞吐量提升高达3倍,同时相比前代 StripedHyena 1 进一步降低了损失。对于生信研究者而言,这意味着在有限算力下进行长基因组推理在实践上是可行的。
模型的长上下文能力通过一个"大海捞针"(needle-in-a-haystack)任务得到验证:将一段100bp的目标序列随机嵌入100万碱基对的随机DNA中,Evo 2 能够准确找回并预测该序列的值,表明其确实具备100万bp量级的有效上下文感知能力。
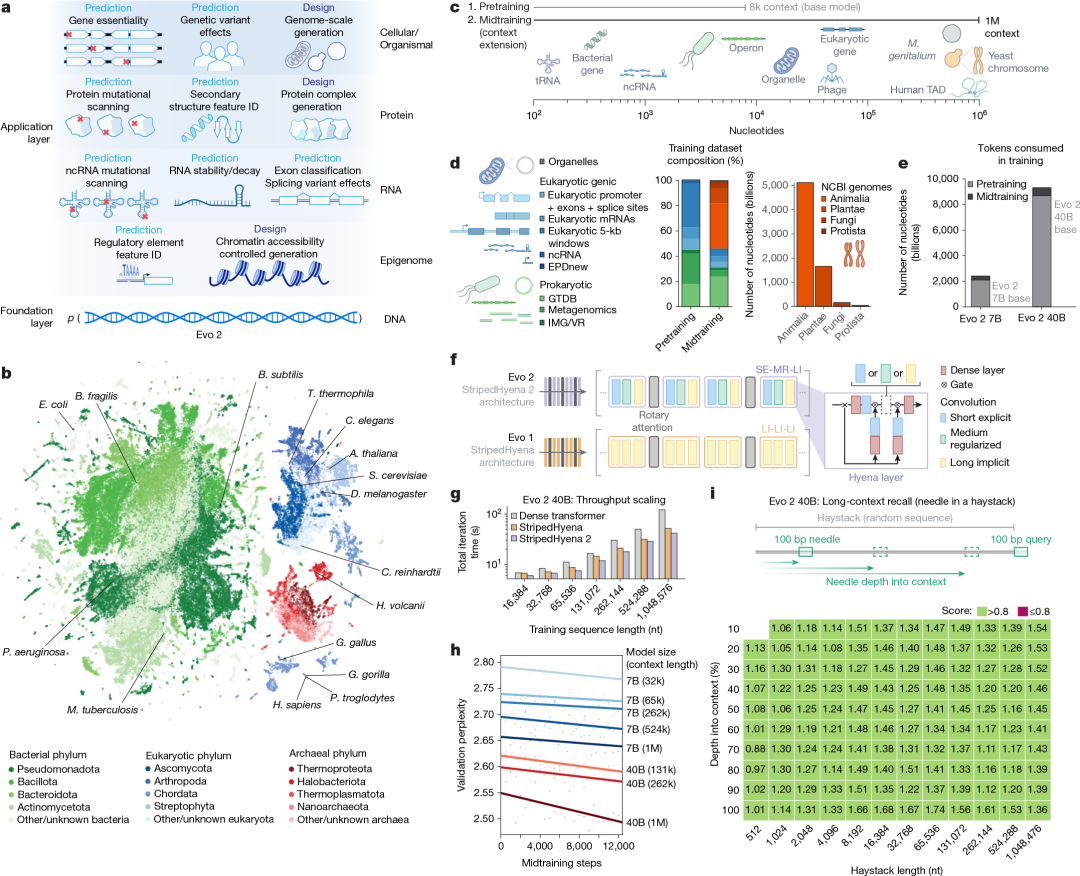
Fig. 1: Overview of model architecture, training procedure, datasets and evaluations for Evo 2.
进化约束的学习:从似然值到功能预测
基因组语言模型的核心能力之一,是利用在大规模进化数据上习得的序列似然值(likelihood)来进行零样本(zero-shot)变异效应预测,而无需针对具体任务进行微调。Evo 2 在这一方面展示了令人印象深刻的跨域泛化能力。
密码子与翻译起始信号的识别
研究者系统地在蛋白质编码基因的起始密码子附近引入单核苷酸突变,观察Evo 2对序列似然值的变化。结果表明,模型能够精确识别起始密码子的功能重要性,并呈现出与密码子三联体周期一致的三碱基节律——摆动位点的突变对似然值影响最小,这与已知的密码子简并性完全吻合。更值得关注的是,模型在不接受任何显式标注的情况下,自动学会了原核生物的Shine-Dalgarno序列和真核生物的Kozak序列所在的上游保守位置,表明其确实从进化数据中归纳出了翻译起始的普适原理。
跨20余个物种的突变敏感性分析
在覆盖20个原核物种和16个真核物种的分析中,不同类别的突变对似然值的影响与生物学已知的功能约束高度吻合:非同义突变、提前终止突变和移码突变引发的似然值变化远大于同义突变;tRNA和rRNA的缺失突变影响显著大于基因间区;40B模型对miRNA和snoRNA的突变则比7B模型更为敏感。此外,模型还自主学会了不同生物密码子的特殊遗传密码——包括支原体的密码子4(仅TAA和TAG为终止密码子)以及纤毛虫的密码子6(仅TGA为终止密码子)。
深度突变扫描(DMS)基准测试
通过与实验性深度突变扫描数据集的相关性分析,Evo 2的序列似然值在9个原核蛋白、6个真核蛋白以及7套rRNA/tRNA/核酶数据集上均表现出与实验适应度的显著相关性。在蛋白质DMS任务上,Evo 2 与 ProGen 等专用蛋白质语言模型具有可比性,在非编码RNA方面也与专用RNA模型竞争。需要指出的是,与专门为蛋白质设计的最优模型相比,Evo 2 仍有差距,且与蛋白质语言模型的规律类似,性能在最大模型尺度下趋于饱和甚至有所下降。
外显子识别的迁移学习潜力
Evo 2 的嵌入表示能否支持有监督的下游任务?研究者在 Evo 2 7B 的嵌入向量上训练了单核苷酸分辨率的外显子分类器,在8个完全未见物种上评估时,AUROC范围为0.91至0.99,全面超过基于Nucleotide Transformer和Evo 1嵌入的同类分类器,以及基于GC含量和PhyloP保守性得分的传统方法。在实践基准上,该分类器在全部测试物种上优于从头预测工具AUGUSTUS,并在大多数物种上超过SegmentNT(一个专门经过多物种标注数据训练的模型)。这对非模式生物基因组注释具有直接的应用价值。
人类变异效应预测:临床应用的核心验证
变异效应预测是基因组学中连接基础研究与临床应用的关键节点。既往的多物种DNA语言模型在真核生物变异预测上表现欠佳,往往大幅落后于利用多序列比对的物种专用模型。Evo 2 在这一方向上实现了显著突破。
在ClinVar数据集上的系统比较
研究者在ClinVar数据库的变异注释上,将Evo 2与一系列方法进行了对比,包括保守性度量(PhyloP)、无监督语言模型(ESM-1b、ESM-2)、专用剪接预测模型(SpliceAI、Pangolin)以及有监督变异效应预测模型(AlphaMissense、GPN-MSA、CADD)。
编码区SNV方面,Evo 2 40B和7B优于ESM-2等零样本方法,但略逊于ESM-1b、GPN-MSA和部分PhyloP变体。编码区非SNV(插入、缺失等)方面,两个Evo 2模型超过所有对比方法——尤其值得注意的是,AlphaMissense和GPN-MSA根本无法对非SNV变异进行评分,而Evo 2可以处理任意形式的序列变化。非编码区SNV方面,Evo 2 40B在无监督方法中排名第一,仅次于有监督模型。非编码区非SNV方面,Evo 2 40B在所有被测方法中性能最优。
BRCA1/BRCA2饱和突变组实验的深度验证
研究者还在两个具有临床意义的基因——BRCA1 和 BRCA2 的饱和突变实验数据集上进行了验证。Evo 2 在 BRCA1 编码区SNV上表现强劲,在非编码区SNV上超越所有对比模型,包括专用剪接预测工具。对于远离剪接位点的非编码变异,Evo 2 40B同样在所有被测模型中性能最佳——这一结果尤为重要,因为此类低保守性的调控区域变异正是当前计算工具最难处理的难点。在 BRCA2 数据集上,Evo 2 超越GPN-MSA等专用模型,在所有变异类型合并评估时位居第二,仅次于有监督模型CADD。
值得强调的是,Evo 2 从未接触过任何人类遗传变异数据或功能基因组学数据,上述成绩完全依赖于从多物种序列进化中自主学习的表示。
嵌入特征用于有监督分类的增益
以 BRCA1 变异分类为例,研究者展示了一条实用的迁移学习路径:从Evo 2 40B各层提取序列嵌入,系统评估不同层的特征质量后,选择最优层的嵌入训练一个简单的岭回归(ridge regression)分类器。最终该有监督模型在测试集上达到AUROC=0.95、AUPRC=0.88,显著优于Evo 2本身的零样本预测性能。这为生信研究者提供了一个清晰的思路:当任务特异性标注数据可用时,将Evo 2嵌入与轻量级监督模型结合,可以最大化预测性能。
模型可解释性:稀疏自编码器揭示生物学特征
针对"大型语言模型是黑箱"的常见批评,研究团队借鉴自然语言领域的机制可解释性(mechanistic interpretability)方法,在Evo 2的中间层表示上训练了批量TopK稀疏自编码器(Batch-TopK SAE),将模型内部表示分解为高维稀疏的潜在特征,并通过"对比特征搜索"方法将这些特征与已知的生物学概念关联。
SAE在来自多个完整真核和原核基因组共计10亿token的激活值上训练,选用第26层的模型表示作为输入。分析结果揭示了一系列令人信服的生物学对应关系:
模型学会了识别原噬菌体——特征f/19746 在大肠杆菌基因组中的已注释原噬菌体区域上激活,同时还在CRISPR阵列的间隔序列上激活,而这些间隔序列正是源自噬菌体DNA的整合片段。该特征甚至能识别出合成的、打乱顺序的间隔序列,暗示模型是通过理解"语义"来关联噬菌体序列,而非简单记忆。除此之外,模型还形成了与ORF、基因间区、tRNA、rRNA对应的离散特征,在蛋白质编码基因区域内还能区分α-螺旋和β-折叠的对应特征——这些蛋白质二级结构信息完全是从DNA序列中隐式学习的。
在人类基因组分析中,研究者识别出能特异性标记移码突变和提前终止突变的特征,以及与转录因子结合位点高度匹配的启动子区域特征。后者尤其令人惊叹:在人类启动子序列的随机采样中,Evo 2 无监督SAE特征与HOCOMOCO v12数据库中70%的启动子富集转录因子结合基序存在显著相似性(q<0.01),而专用的motif发现工具HOMER在同等条件下仅能召回35%。
外显子/内含子边界的区分同样清晰,且这些在灵长类等模式生物上训练的特征能够迁移到猛犸象基因组片段上,表明习得的特征具备跨物种泛化能力。研究团队已开放SAE模型权重和可视化工具,研究者可以直接用于基因组注释和特征探索。
基因组尺度序列生成能力
Evo 2 不仅是预测模型,也是生成模型。研究者系统评估了其在三个不同物种层次的序列生成能力。
线粒体基因组:以人类线粒体基因组的局部序列作为提示(prompt),Evo 2 7B和40B各生成了250余条16kb序列。MitoZ注释结果显示,生成序列中CDS、tRNA和rRNA的数量与天然人类线粒体高度一致,序列语法保持正确,密码子使用频率与天然线粒体基因组吻合,且未复制提示序列中已包含的tRNA。AlphaFold 3对生成蛋白序列的结构预测也发现了与天然线粒体蛋白复合物相似的多聚体结构。
原核基因组:以支原体(M. genitalium,约580kb,一种常用的最小化基因组模型)的10.5kb提示序列为起点,Evo 2生成了10条580kb长度的完整序列。经Prodigal注释后,约70%的基因具有显著的Pfam结构域匹配,远优于Evo 1的18%。生成蛋白质的长度分布和二级结构比例与天然支原体蛋白基本一致,部分蛋白质还通过AlphaFold 3结构预测证实了与天然蛋白的结构相似性。
真核基因组:以酿酒酵母(S. cerevisiae)第3号染色体的10.5kb序列为提示,生成20条约330kb的序列。注释结果显示,生成序列中包含具有内含子结构的基因、tRNA和启动子元件,四聚体核苷酸使用偏差(TUD)与天然酵母序列相关。40B模型在这一指标上优于7B模型。值得注意的是,生成序列中基因和tRNA的密度低于天然基因组,且不包含所有必需基因——这说明当前的基因组尺度生成在计算指标上已有显著进步,但距离功能性、可复制的合成基因组仍有相当距离。
推理时引导:设计染色质可及性模式
这是本文技术上最为亮眼的部分之一,也为生信研究者提供了一个重要的方法论范式。
研究团队将Evo 2的生成能力与Enformer和Borzoi(两个能够从DNA序列预测染色质可及性的序列到功能模型)结合,在推理阶段通过束搜索(beam search)引导序列生成。具体策略是:每次生成128bp的序列片段,随即用Enformer/Borzoi评分评估预测的DNase超敏感性是否符合目标峰型,只保留得分最高的若干候选序列继续延伸。这相当于将一个无监督语言模型与一个任务专用奖励函数动态结合,在无需重新训练的情况下实现精细的表观基因组条件设计。
研究者甚至利用这一系统,将窄峰代表"点"、宽峰代表"划"、无峰区域代表"空格",在表观基因组中以摩斯电码"写下"了"EVO2"、"LO"和"ARC"等信息。这些设计不仅在计算层面成立,研究者还通过将合成DNA定点整合至小鼠胚胎干细胞(mESC)基因组,并利用ATAC-seq进行实验验证,证实了设计染色质开放性峰型的可控性。进一步的实验在人HEK293T细胞和K562细胞中测试了31个设计序列,均验证了计算预测的准确性,且可实现细胞类型特异性可及性模式的差异化设计。
推理时计算量与设计质量之间存在对数线性关系——增大束宽(更多计算)持续改善设计质量,与自然语言生成领域的缩放规律完全一致。这一框架的潜力远不止于染色质可及性设计,可广泛迁移至需要精确打分函数的任何生物序列设计场景。
对生信研究者的实践建议
零样本变异效应预测:Evo 2 无需微调即可处理编码区和非编码区的SNV及非SNV变异,对于缺乏标注数据的稀有变异类型(如插入缺失)尤具优势,可作为ClinVar分析和饱和突变实验的有力补充工具。
嵌入特征的迁移学习:将Evo 2的层级嵌入作为输入特征,配合岭回归等轻量级监督模型,可在较小的标注数据集上实现接近甚至优于专用模型的性能,这一路径在BRCA1变异分类中已得到实证。
非模式生物基因组注释:在已训练的物种上学习的外显子/内含子分类特征能够有效迁移到未见物种,包括猛犸象这样的古基因组,为动植物遗传资源挖掘提供了新工具。
全开放获取:模型参数(7B和40B)、训练代码、推理代码和OpenGenome2数据集均已完全开放,可直接部署。
局限性与展望
Evo 2 在远端调控变异预测上仍落后于ChromBPNet等专门经可及性数据训练的模型,表明单纯的多物种进化信息对低保守性调控序列的覆盖还有待加强。基因组尺度生成序列的功能验证尚缺乏系统的实验数据,评估指标(Pfam覆盖率、结构相似性等)无法直接等同于生物学功能。此外,40B模型的推理资源需求对普通研究者仍是挑战。
尽管如此,Evo 2 代表了基因组语言建模领域迄今为止规模最大、泛化能力最强的尝试,其"一个模型、全域通用"的设计哲学为生物信息学、合成生物学和临床基因组学的交叉研究开辟了新的可能性空间。
小编的思考:相信不少同鞋已经在预印本读到过这篇文献了,随着AI一日千里的发展,不确定传统的审稿方法是不是还适用于某些快速发展的领域。或许未来,一些领域的审稿方式可能会发生效率的革命。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-03-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号