从 DeepSeek V4 Pro 到 Harness:不止于模型,一个Agent新范式的野心与布局
原创
从 DeepSeek V4 Pro 到 Harness:不止于模型,一个Agent新范式的野心与布局
原创
AGI-Eval评测社区
发布于 2026-08-25 13:50:37
发布于 2026-08-25 13:50:37
测了模型,装了插件,读了论文,发现事情要比想的复杂得多。
DeepSeek 发布将近两周,社区热度不减,各类插件演示与用例分享层出不穷,价格与推理性能的同步优化也得到了广泛验证。V4 Pro 在参数规模上维持 MoE 架构与 1.5 万亿总量、490 亿激活不变,Agent 基准测试的成倍跃升完全归因于重新后训练。
此次更新的亮点在于:
- DeepSeek 将 Agent 公式重定义为模型加工程层,模型负责推理,Harness 承载任务规划、执行调度与闭环管理,全栈自研且深度适配本土开发环境,操作轨迹留存便于调试,并以 MIT 协议开源,直接对标 Codex 与 Claude Code;
- 同时,99% 的缓存命中率大幅压缩重复计算成本,四档运行模式(含标准与 PTC 程序化模型)覆盖从日常交互到批量自动化的多级需求。
- 更深层的战略意图在于开源加插件化架构,将 Agent 能力基础设施化,使竞争重心从模型参数转向工具链与应用生态。
我们花了几天时间,把 Harness 装上了,装了几个插件,跑了几轮任务,读了那篇 88 页的论文。AGI-Eval 认为这套体系不仅是技术栈的补全,更在工程化层面重新定义了下一代 Agent 产品的评价基准。
一、V4 Pro 的真相:后训练驱动的能力跃迁
先说模型本身。
V4 Pro 发布时,最抓眼球的是跑分:DeepSWE 从预览版的 12.8 跳到 62.7,Terminal Bench 从 72.1 升到 87.9。涨幅确实大,但参数没变。
这说明一件事:后训练策略的迭代,比堆参数更管用。 同样的权重,通过调整训练方法,能让模型在真实任务里“更会干活”。这个结论本身不算新,但 V4 Pro 把这件事做到了一个可验证的强度。
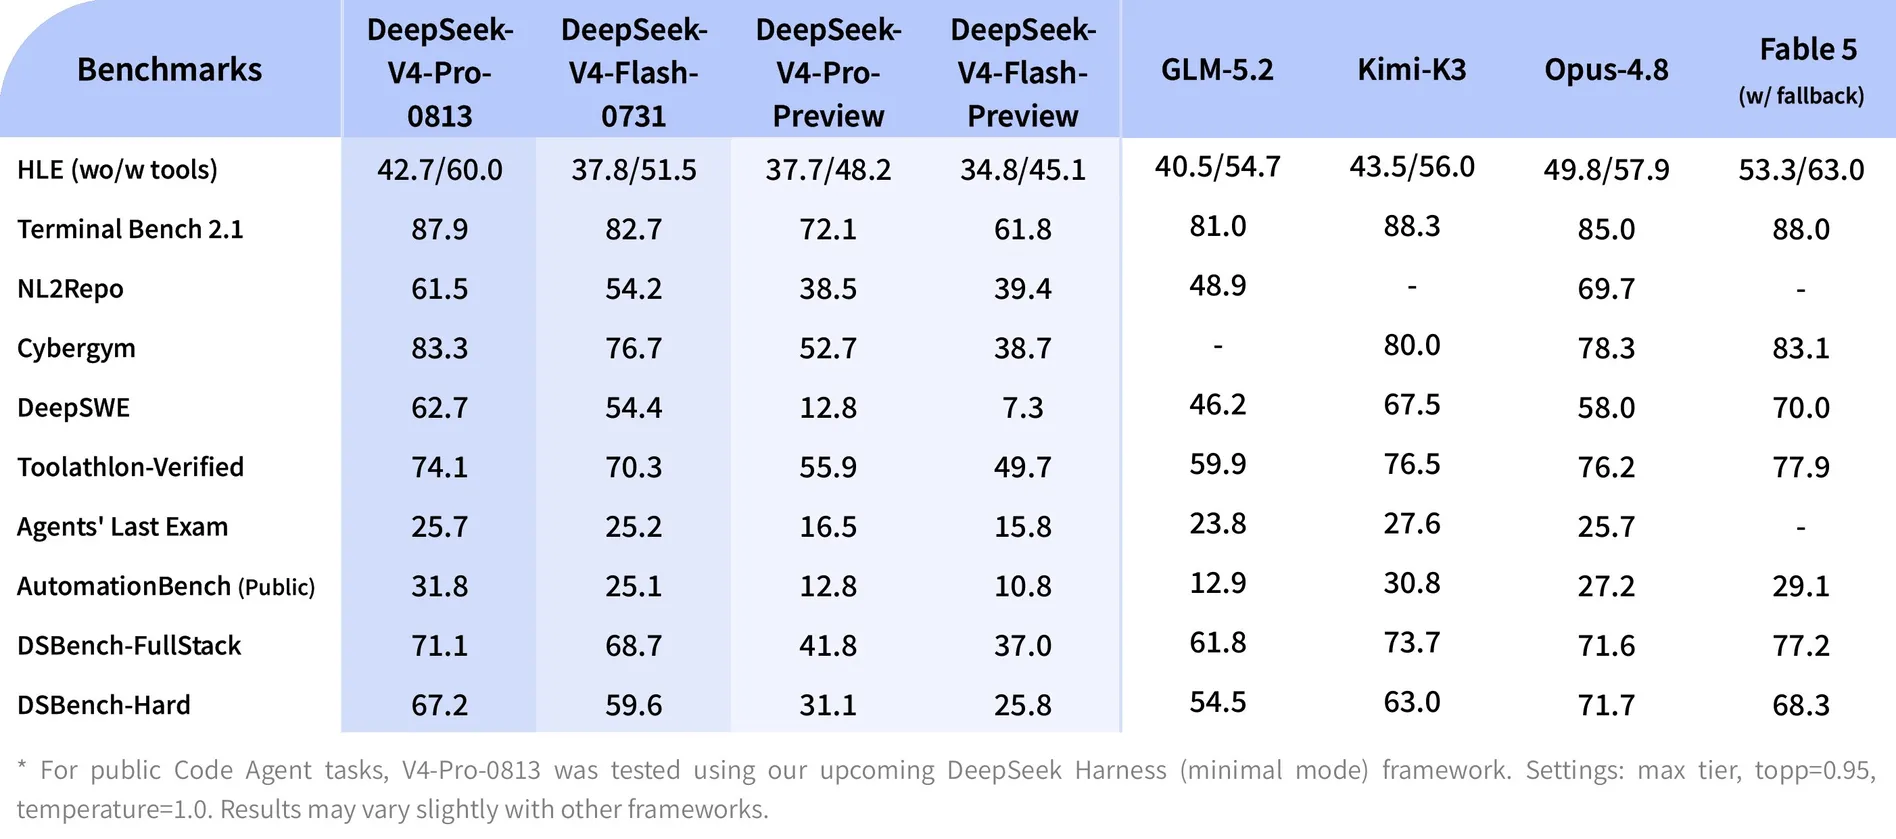
在软件工程 Agent 这个主攻方向上,DeepSWE 62.7 的成绩已经超过 Claude Opus 4.8(58.0),逼近 Kimi-K3(67.5)。多工具调用能力同样进步明显,Toolathlon-Verified 从预览版的 55.9 提升到 74.1,尽管与 Opus(76.2)、Fable(77.9)还有小幅差距。一组数据看下来,V4 Pro 的后训练红利在工程化任务上释放得比较充分,多维度均有跃升。
二、梁文锋说“不做 Agent”,为什么做了 Harness?
梁文锋此前说“不做 Agent 应用层”,一度让外界以为 DeepSeek 要放弃 Agent。但结合上面的公式细看这句话,他说的是不做应用,没说不做基础设施。Harness 恰恰就是基础设施层。
这个问题网上看了一圈,得到的答案大多绕圈子,我们的判断很简单:
不做 Agent 是商业模式,做 Harness 是战略布局。
DeepSeek 仍没有推出类似 Claude Code 的端到端产品,而是开源了 Harness(MIT 协议),把任务编排、执行调度和工具调用的规范与运行时交给开发者自己搭建。它不提供现成的 Agent 应用,但提供了让任何 Agent 应用都能跑起来的框架。
为什么这么做?原因只有一个:布局Agent生态,争夺 Agent 工作流的定义标准。
模型能力趋同之后,竞争会从“谁的模型更强”转向“谁的生态更厚”。Harness 就是 DeepSeek 的生态底座。如果 Claude Code 和 Codex 垄断了 Agent 的运行标准,那模型层再强,也只是别人生态里的组件。
所以“梁说不做”和“现在做了”之间,不矛盾。
三、Harness 到底是什么?
如果你去翻科普文章,能看到各种名词:工具层、沙箱、上下文管理、可观测性、状态机……像一张产品功能清单,你知道它们叫什么,但不知道它们怎么来的。
Harness 不是模型,也不是应用,而是夹在两者之间的工程层。官方定义是 model + harness = agent:模型负责思考推理,Harness 负责承接任务编排、工具调用、状态管理、沙箱隔离与可观测性。
这套框架不是设计出来的,是踩坑踩出来的。起点是一个几十行的 while 循环,终点是一套让 Agent 进入真实世界的工作制度。
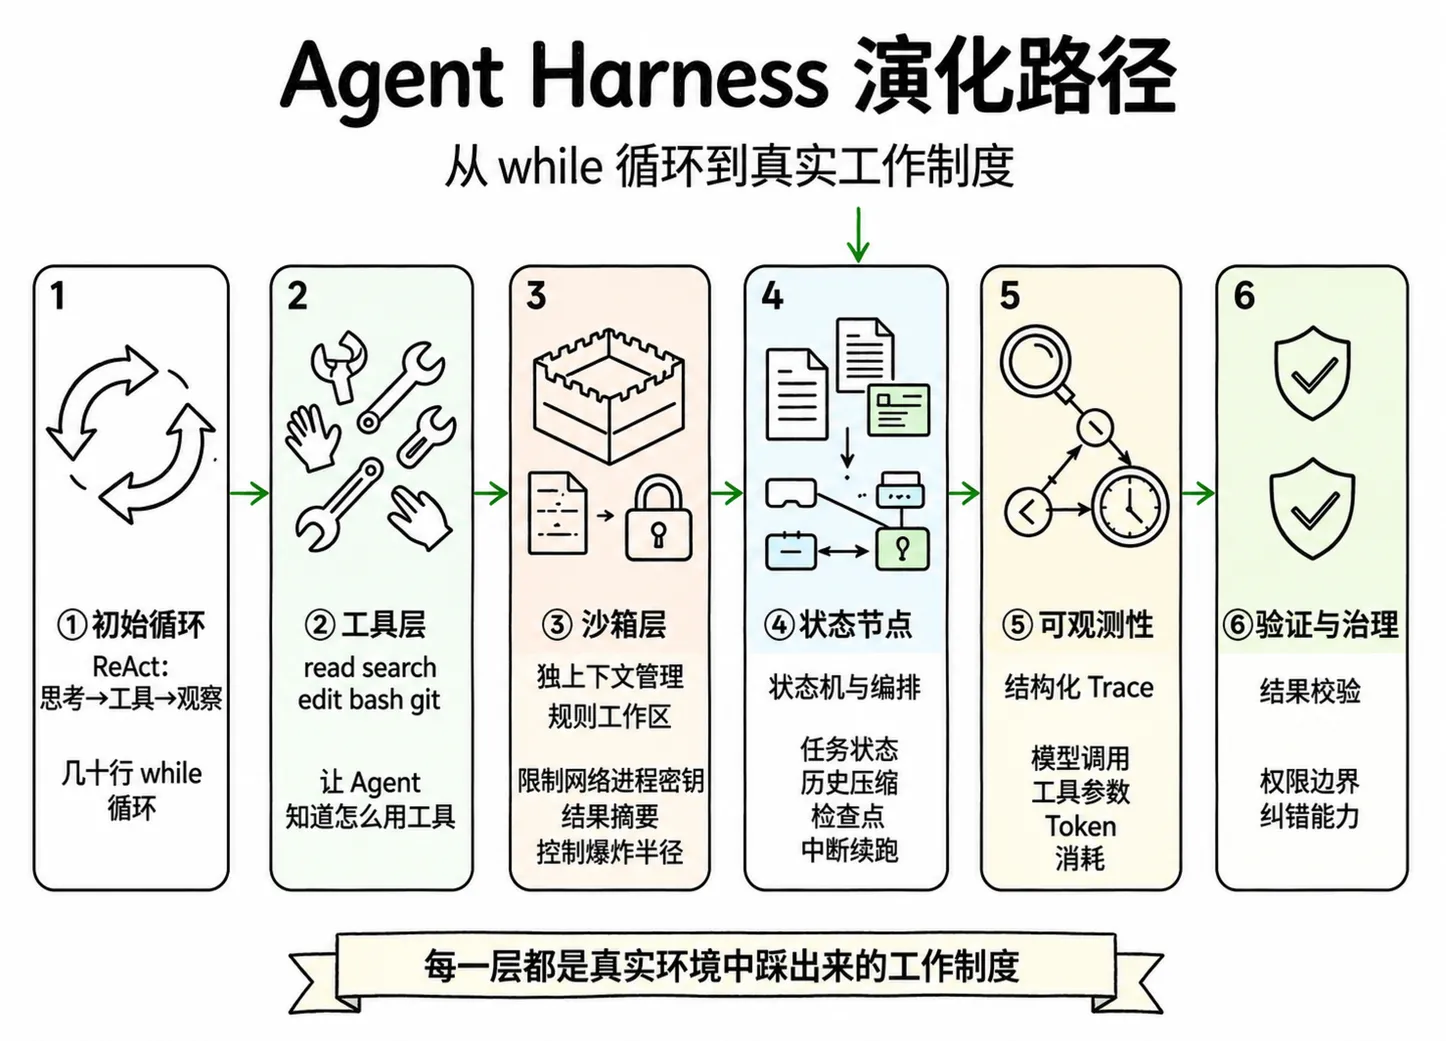
第一步:初始循环
Agent 最初只是一个 ReAct 循环——用户给个目标,模型调用工具,观察结果,再想下一步。几十行代码就能写完,玩具场景里跑得挺好。
第二步:工具层
让 Agent 改代码,它不会读文件、不会搜目录、不知道项目结构。于是装上 read、search、edit、bash、git。手多了又乱用,用错参数、乱填指令。工具层的职责就是定义清楚每个工具怎么用、参数怎么填。
第三步:沙箱层
工具用对之后麻烦更大:Agent 能删文件、装未知依赖、读环境变量、碰生产服务。越能干,你越不敢让它干。于是画了个圈,独立工作区、限制网络和进程、藏起密钥。沙箱不为变聪明,为控制犯错后的爆炸半径。
第四步:状态机与编排
任务拉长之后,中途回来规划断了、子任务失败不知道要不要继续、多 Agent 分不清先后。于是需要状态机,持久化任务状态、检查点、中断续跑,保证任何意外不丢进度。
第五步:可观测性
任务复杂了,你开始焦虑:Token 花在哪了?有没有反复调同一个错误命令?从哪一步走偏的?你需要结构化的 trace,每次调了什么模型、选了哪个工具、参数是什么、结果是什么、花了多少 Token。有了 trace,才能定位失败的真实原因。
第六步:验证与治理
能看见还不够。Agent 说测试通过了,你打开网页按钮没反应。你需要验证层,工具给行动力,验证给纠错力。更进一步,Agent 能读客户数据、能改代码,就得像管员工一样管它:能做什么、不能做什么、能访问哪些库。
Harness 的每一层,都是 Agent 在真实环境里犯过的错。它不负责制造聪明,它负责接住聪明产生的后果。
四、Harness 如何安装
确保本地已安装 Node.js 环境,并准备好 DeepSeek API Key。打开终端执行全局
安装:npm install -g @deepseek/ai-dsh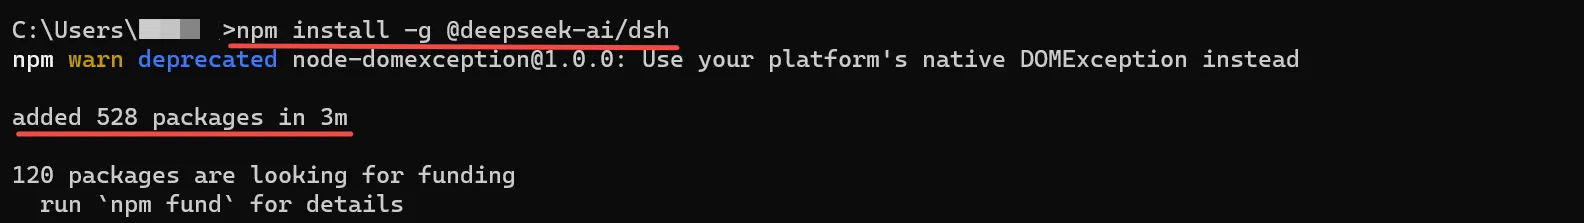
验证是否全局安装 dsh --version 出现 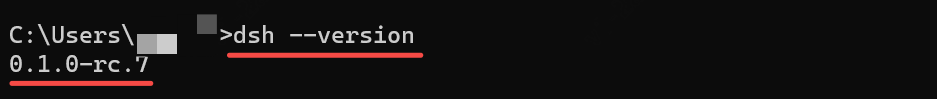
执行以下命令启动 Web 端 dsh --profile web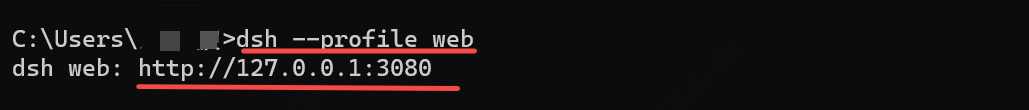
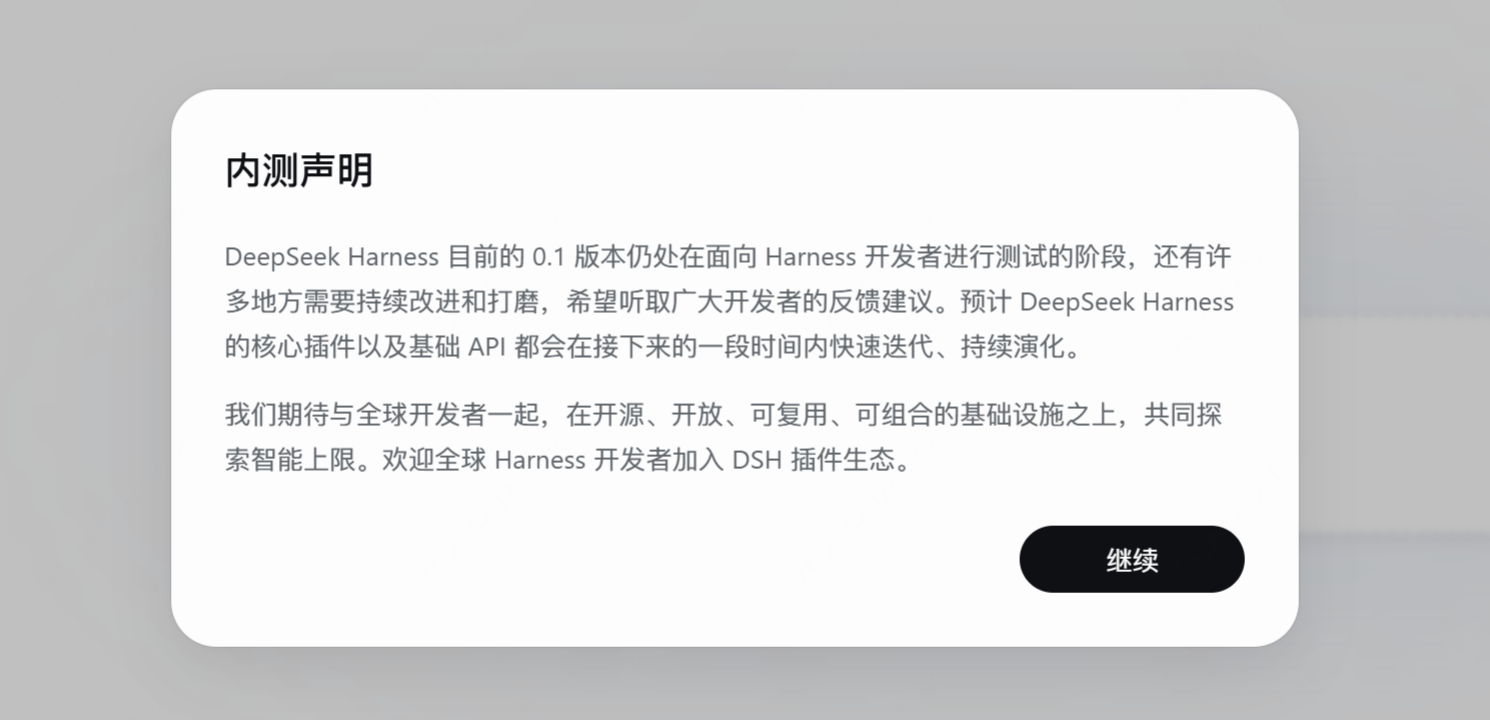
就会看到内测声明,点击继续就好。
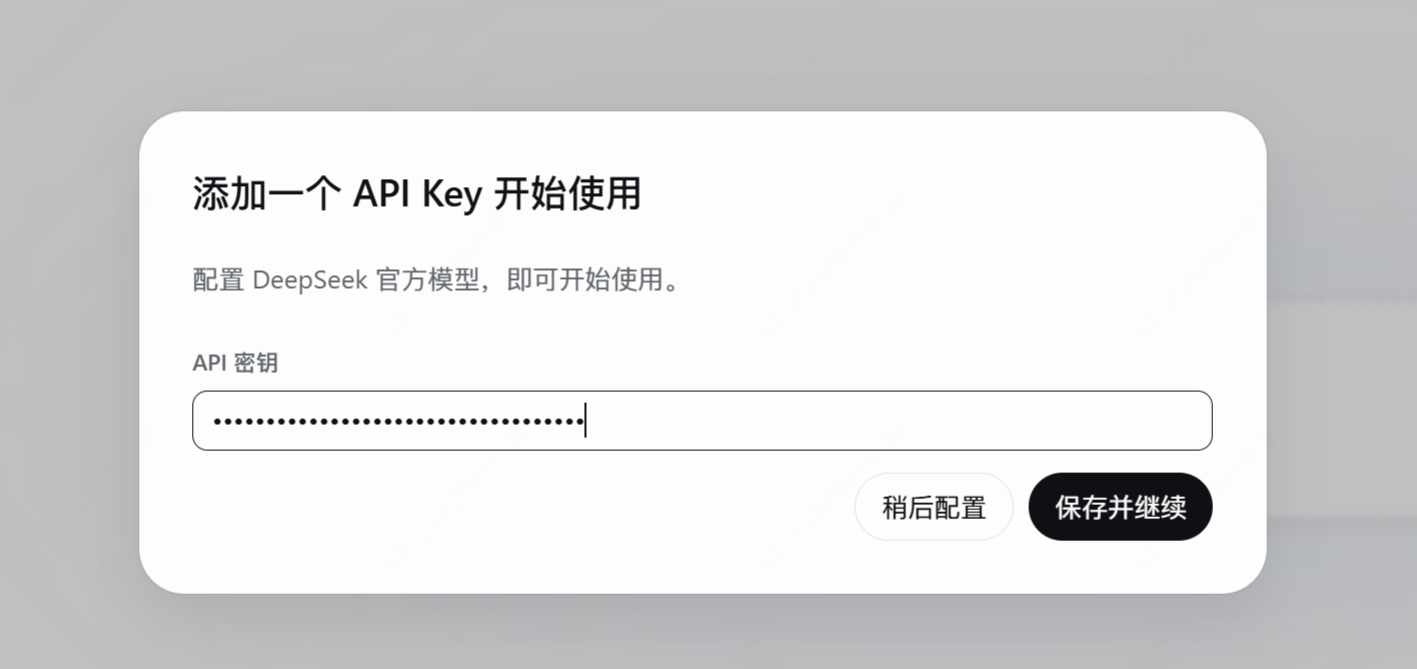
将提前准备好的API Key 输入,保存并继续。
就到了进入了DeepSeek Harness 的 web 端,初步完成,就开始测试吧。
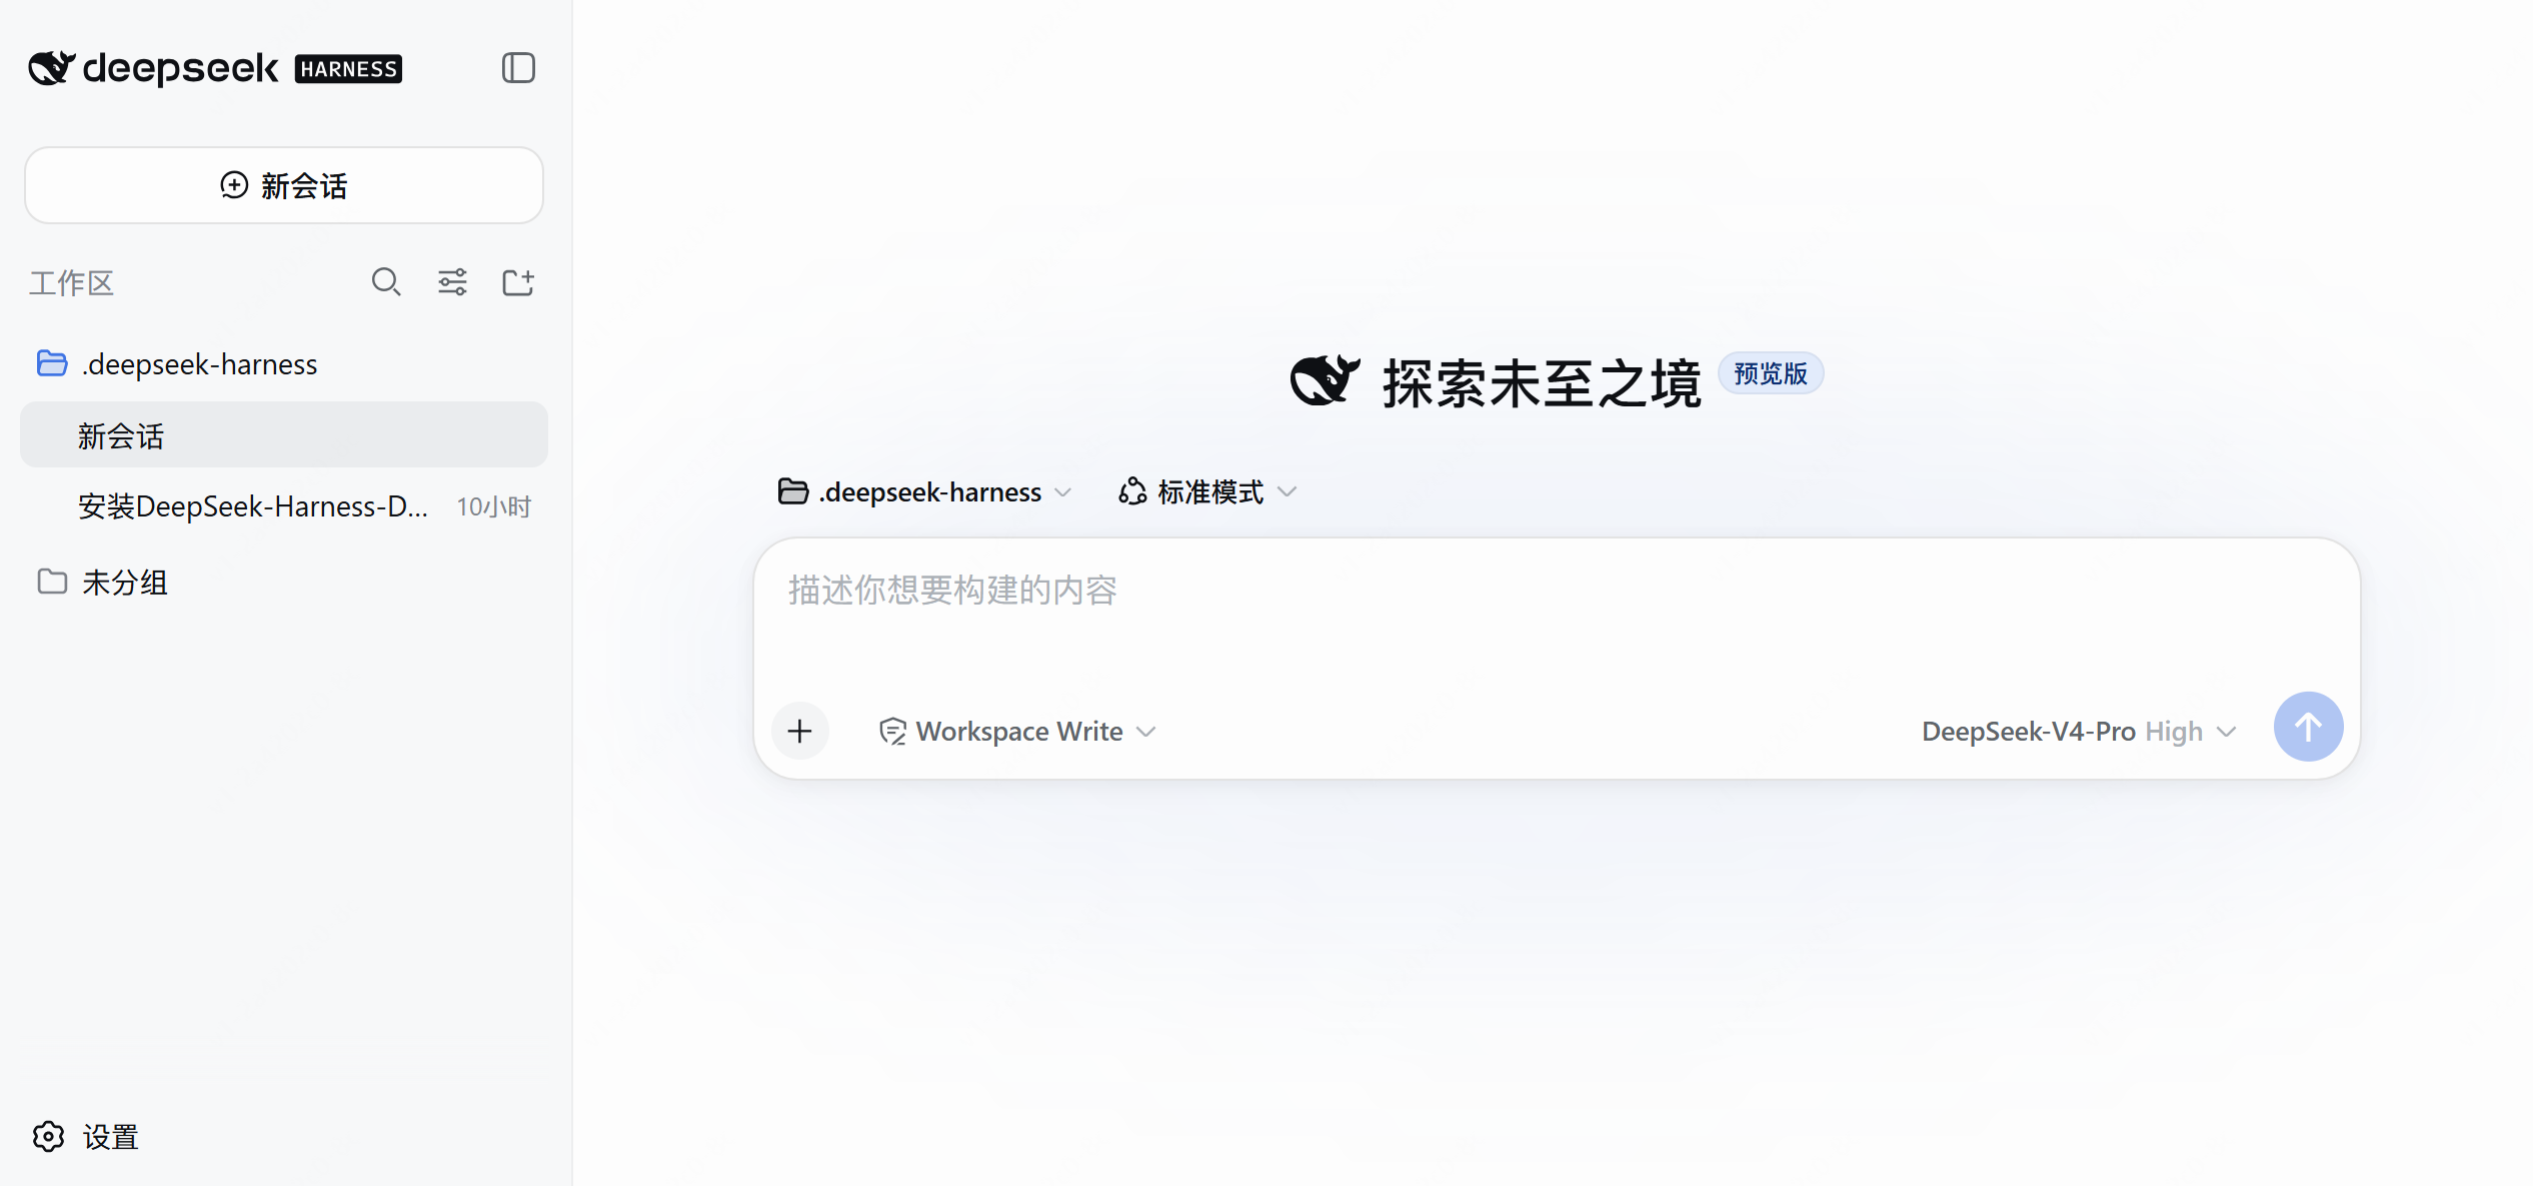
我们先来安装一下比较火的插件:
输入请安装一下这个插件anywhere-labs / deepseek-harness-desktop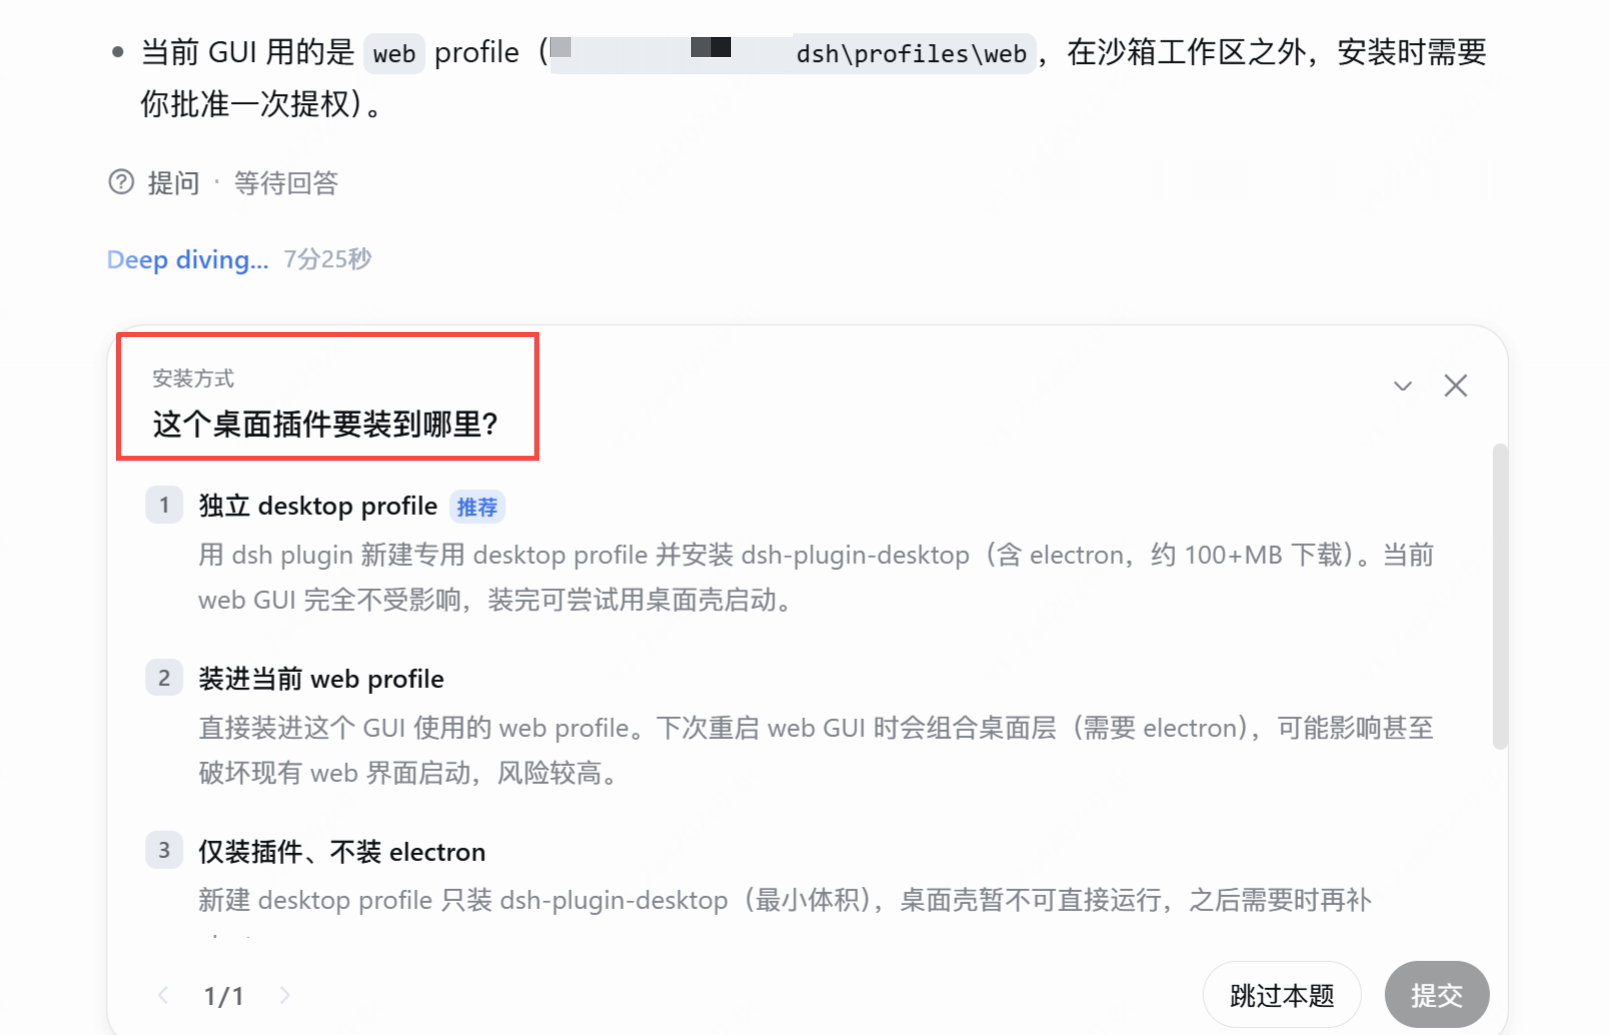
由于我还没有授权,还是在workplace write 模式下,所以遇到权限问题提示我要授权。
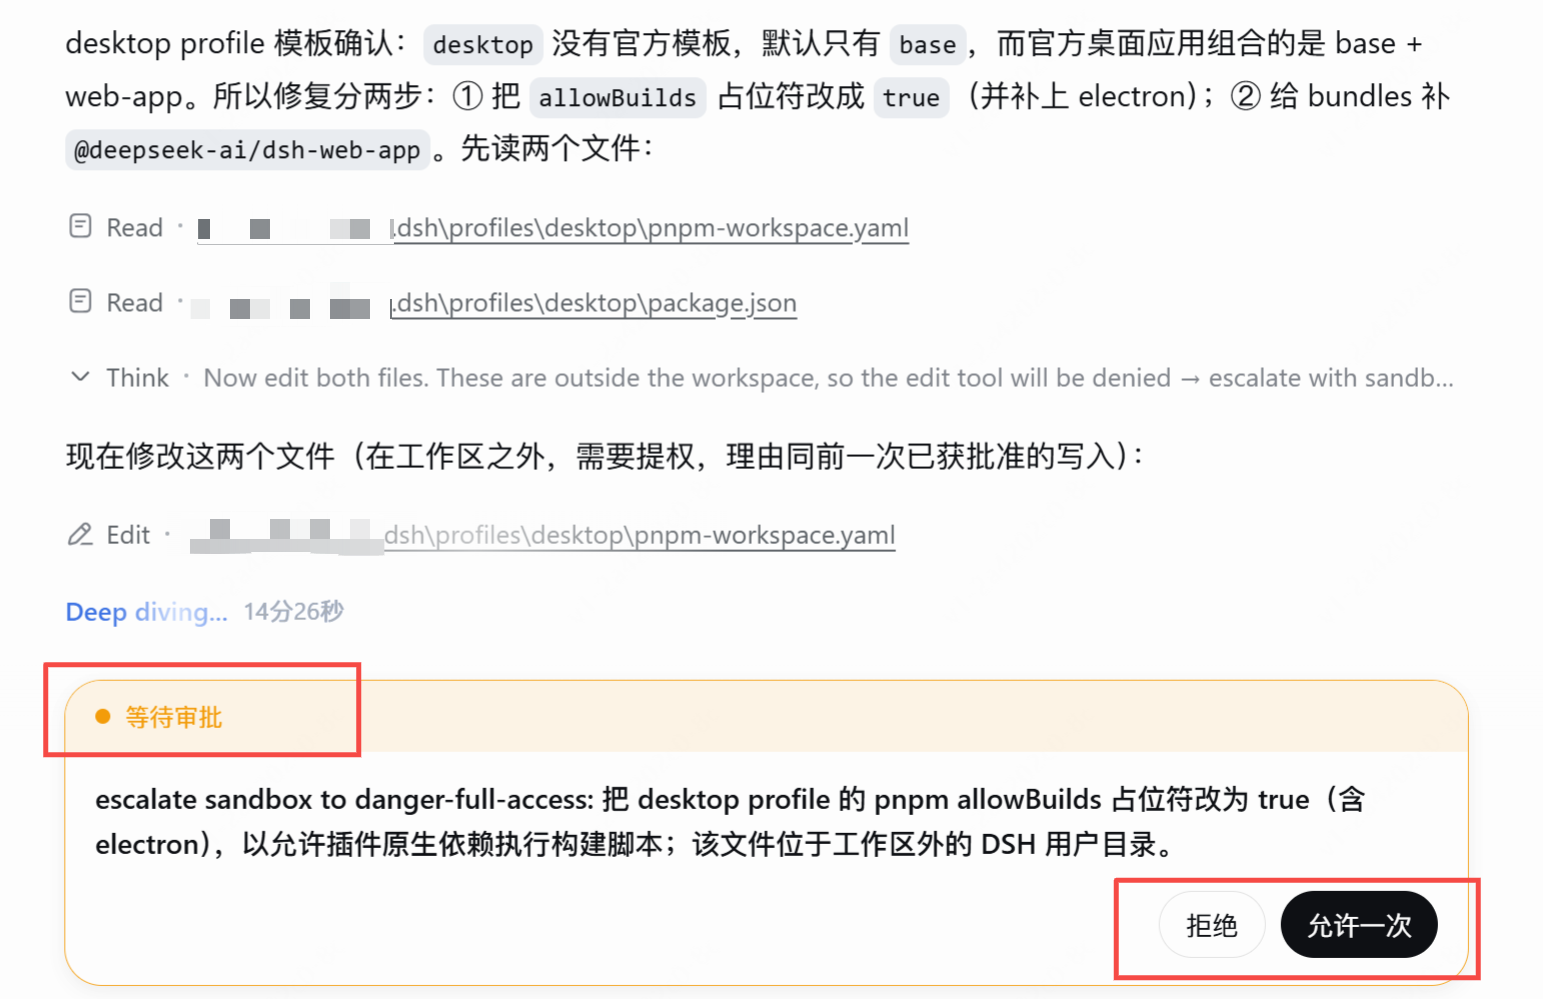
将模式切换为 full access,后面就不会提示了,继续安装。
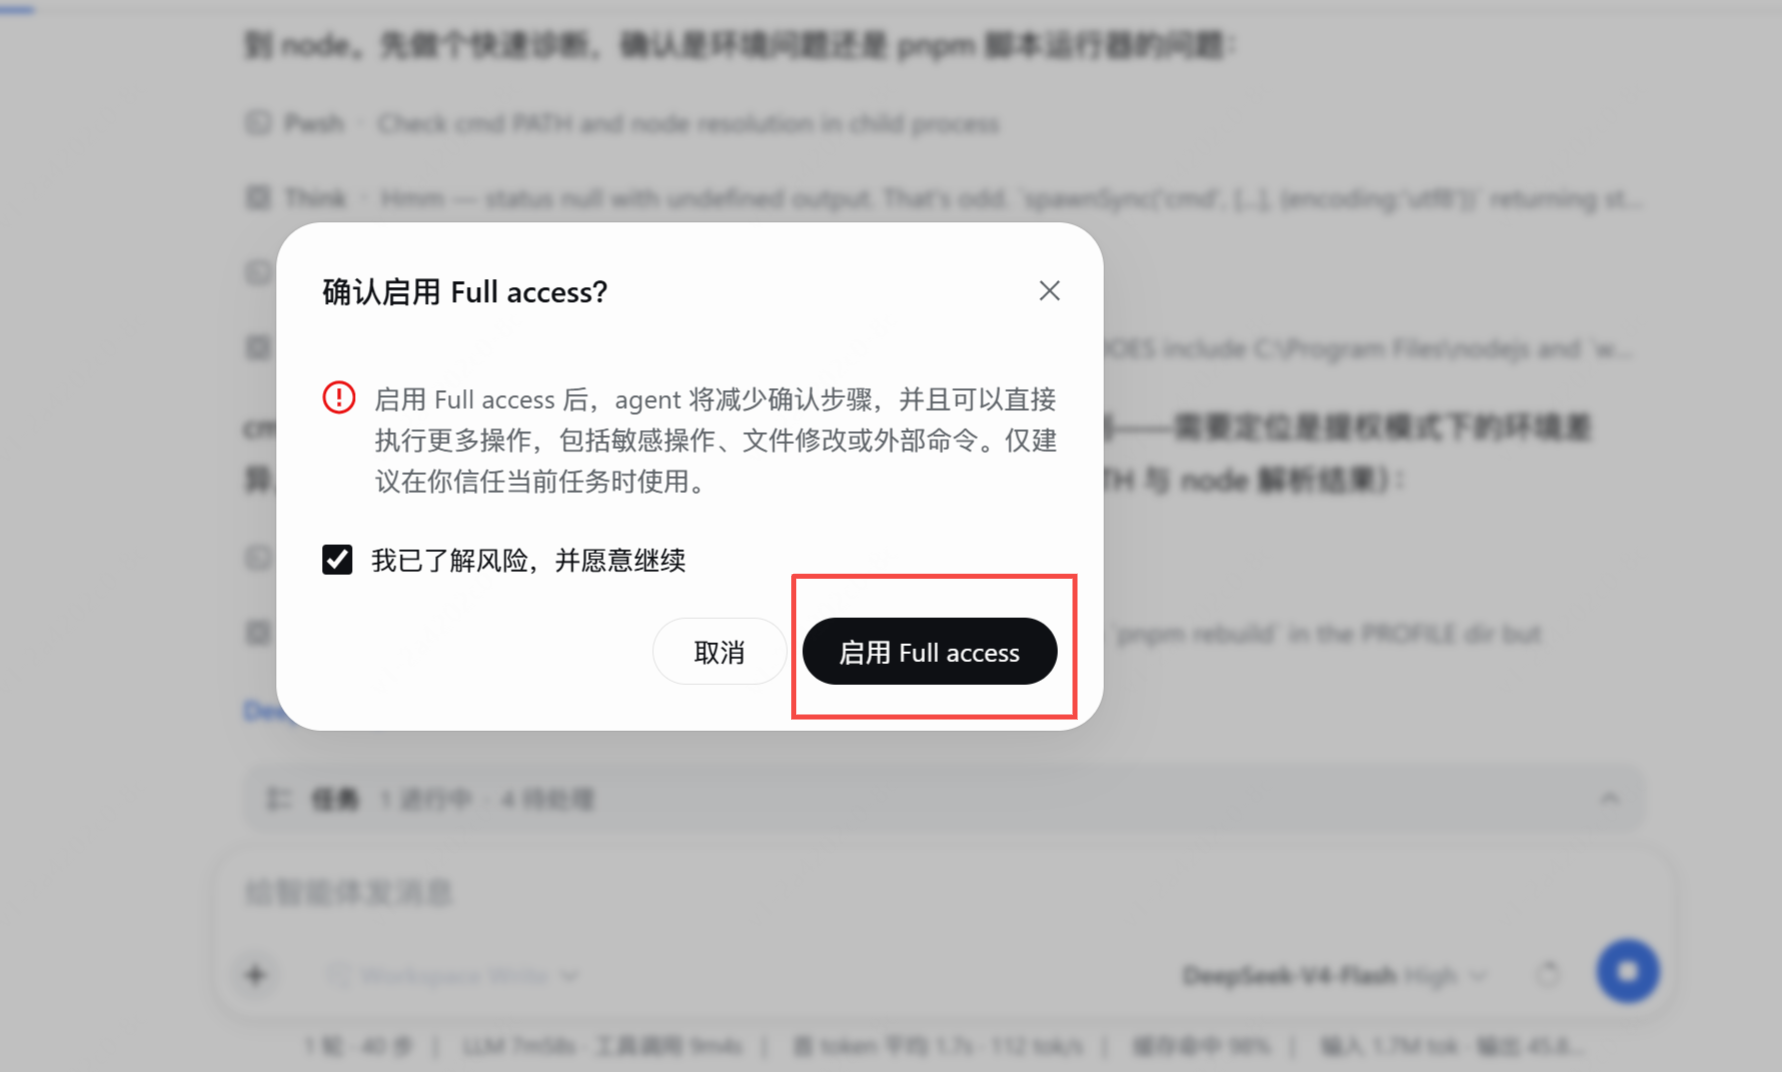
安装过程共执行 76 步,缓存命中率达 99%,Token 消耗得到有效控制。
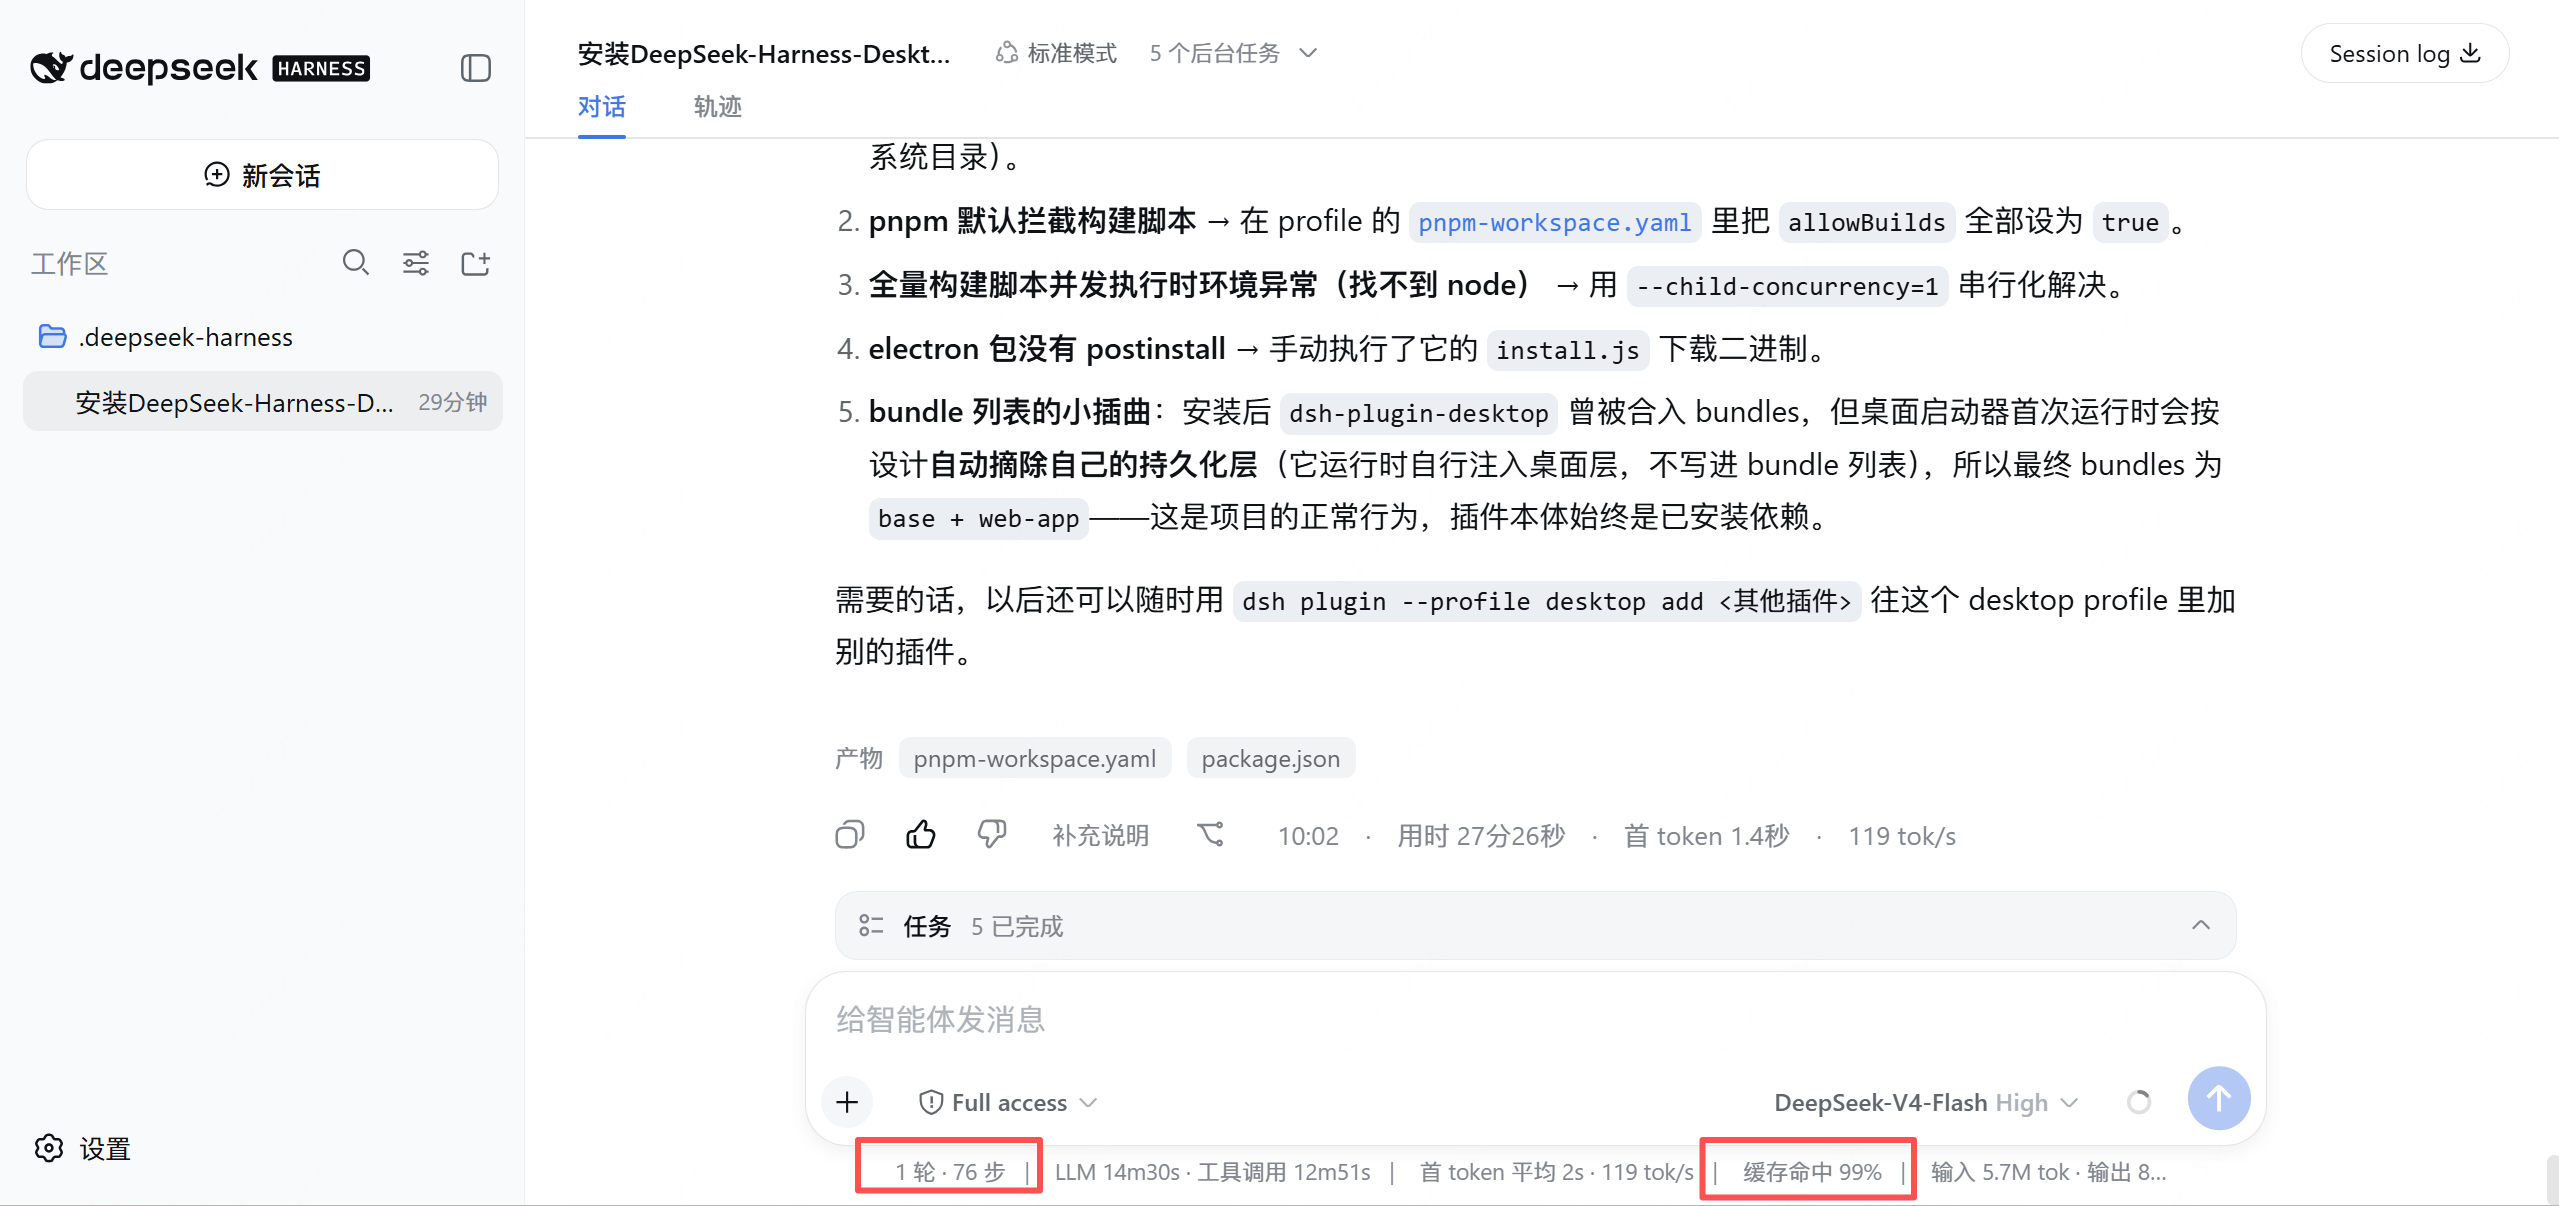
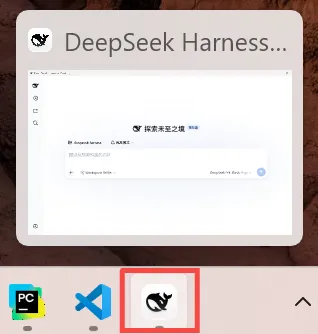
安装成功,可以直接打开桌面端了。
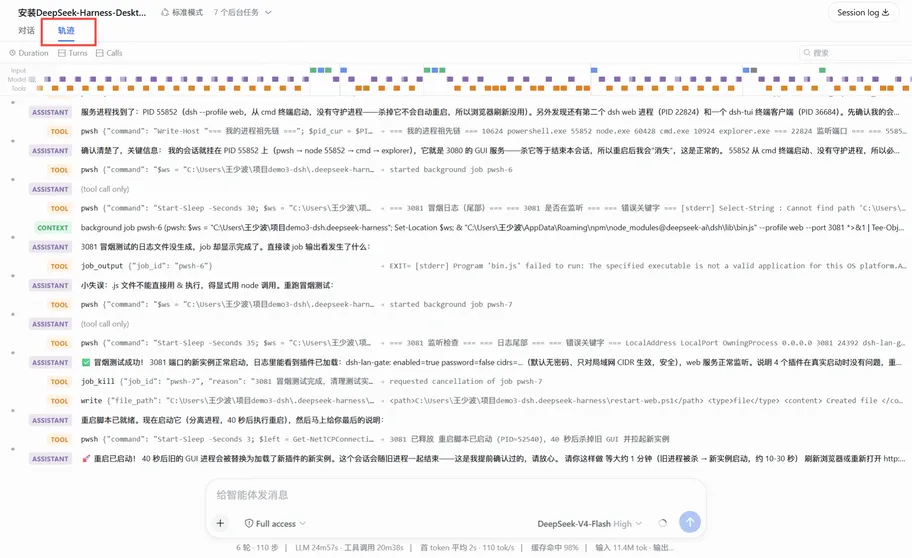
整个过程的每一步操作均可通过轨迹面板查看日志,便于开发者调试和回溯。
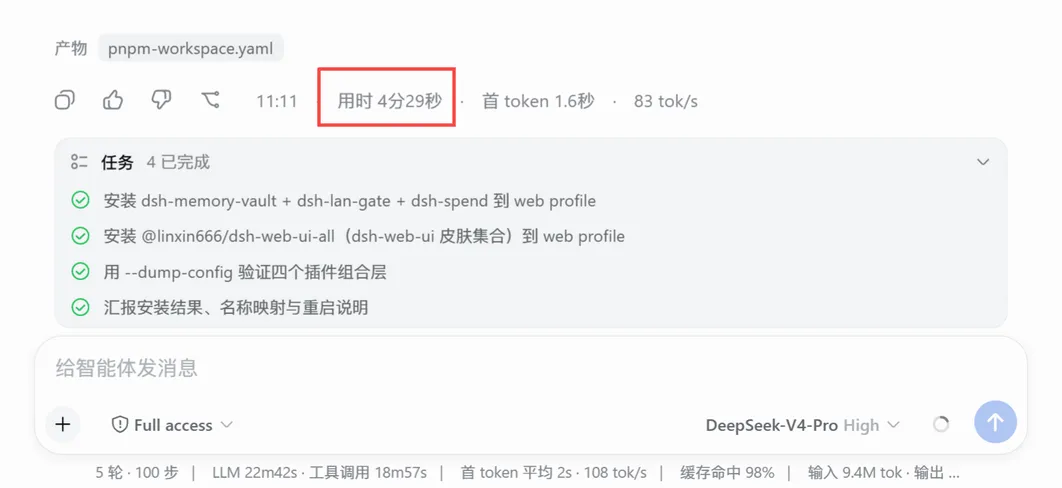
接下来我们又用DeepSeek V4 Pro 帮我们安装了其他插件:
dsh-web-ui、dsh-memory-vault、dsh-mobile-gate、tokentracker。Token 消耗速度超出预期。
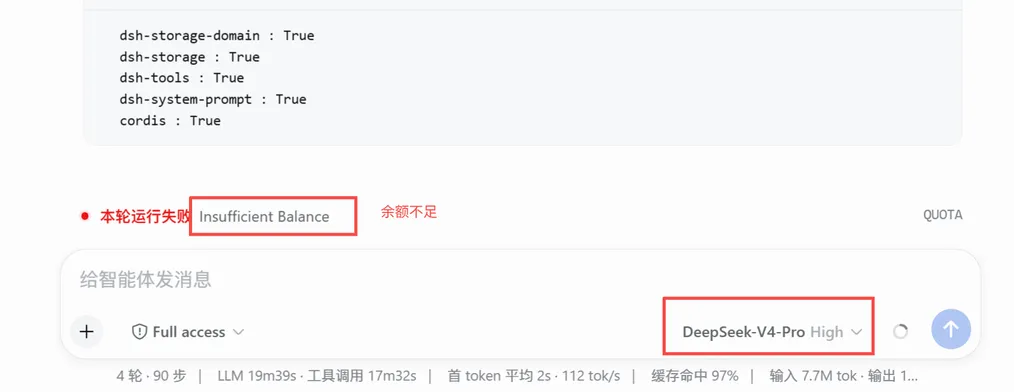
充值后续跑,速度明显提升。不到 5 分钟全部安装完成,且支持多插件并发安装。
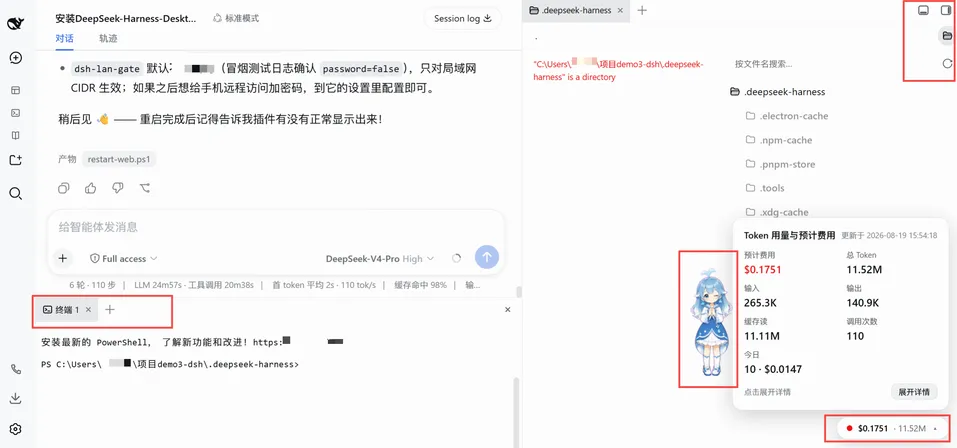
重启 Harness 后效果生效:侧边栏、终端栏、Token 数据看盘均已呈现。用户可以按需定制自己的 Agent 工作台,DIY 喜欢的插件组合。
五、实测——Harness 不只是壳
测试一:3D 游戏开发(标准模式)
Prompt:用 Three.js 开发一个 3D 第一人称射击游戏,单页面项目,打开浏览器直接能玩。第一人称视角,WASD 控制移动,鼠标控制瞄准和射击;场景中至少 3 个敌人自主巡逻,发现玩家后追击,被击中后消失;界面显示准星、血量和得分。
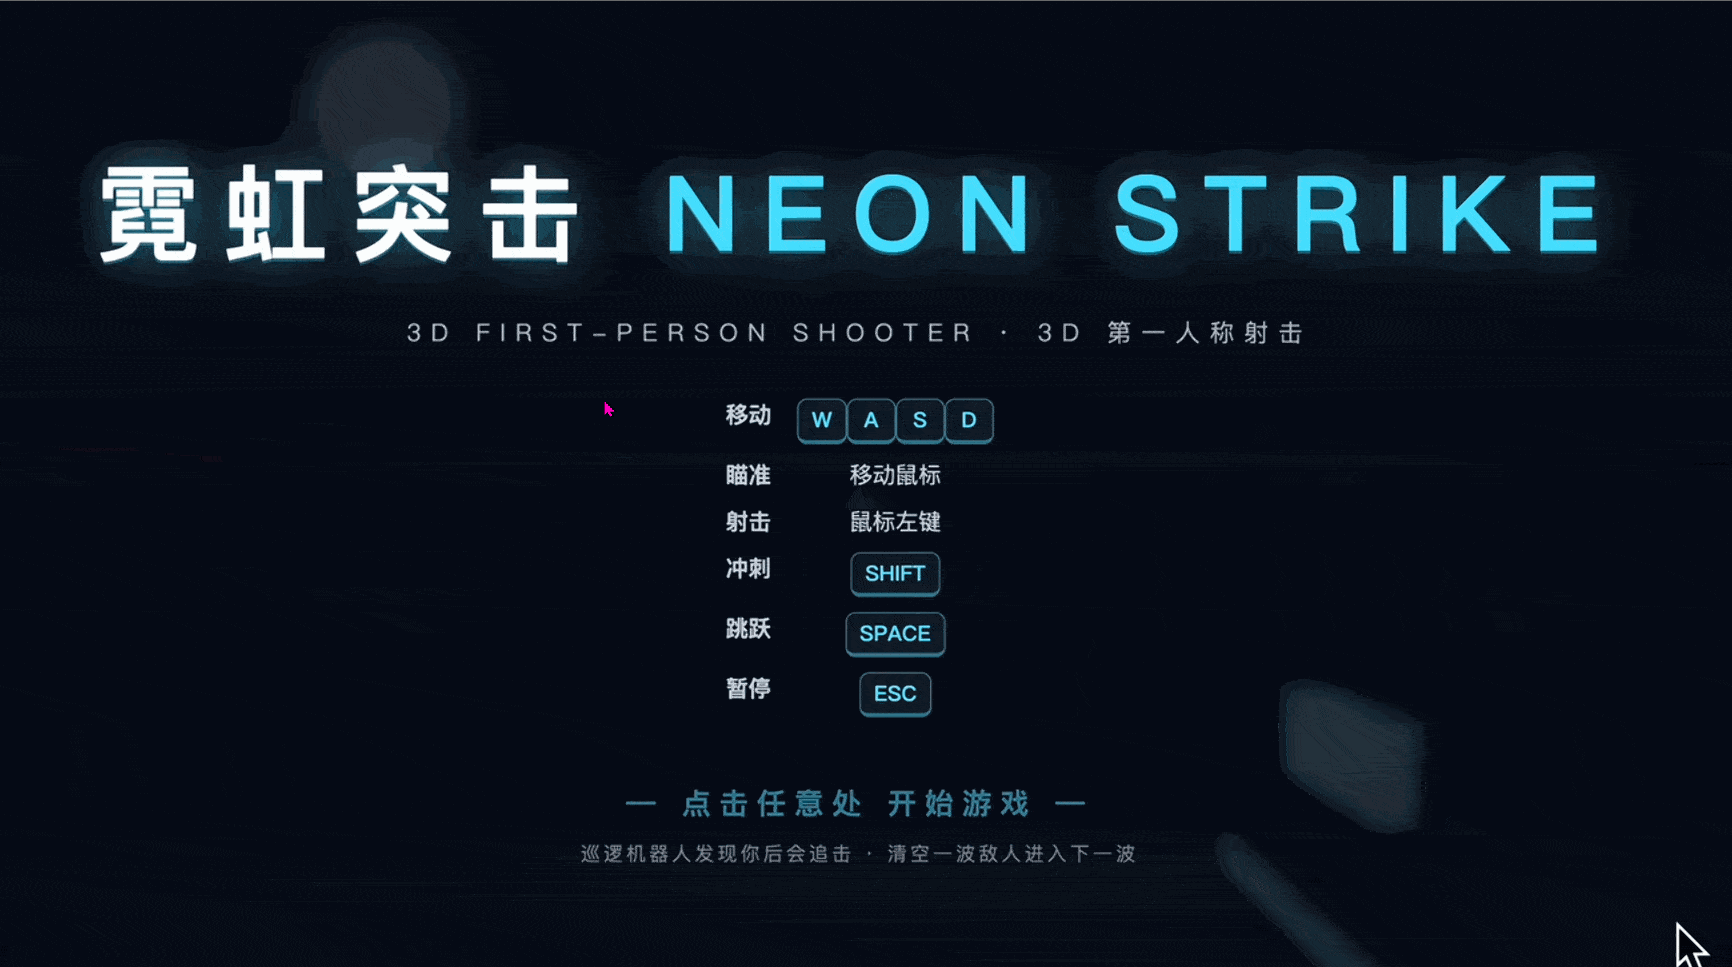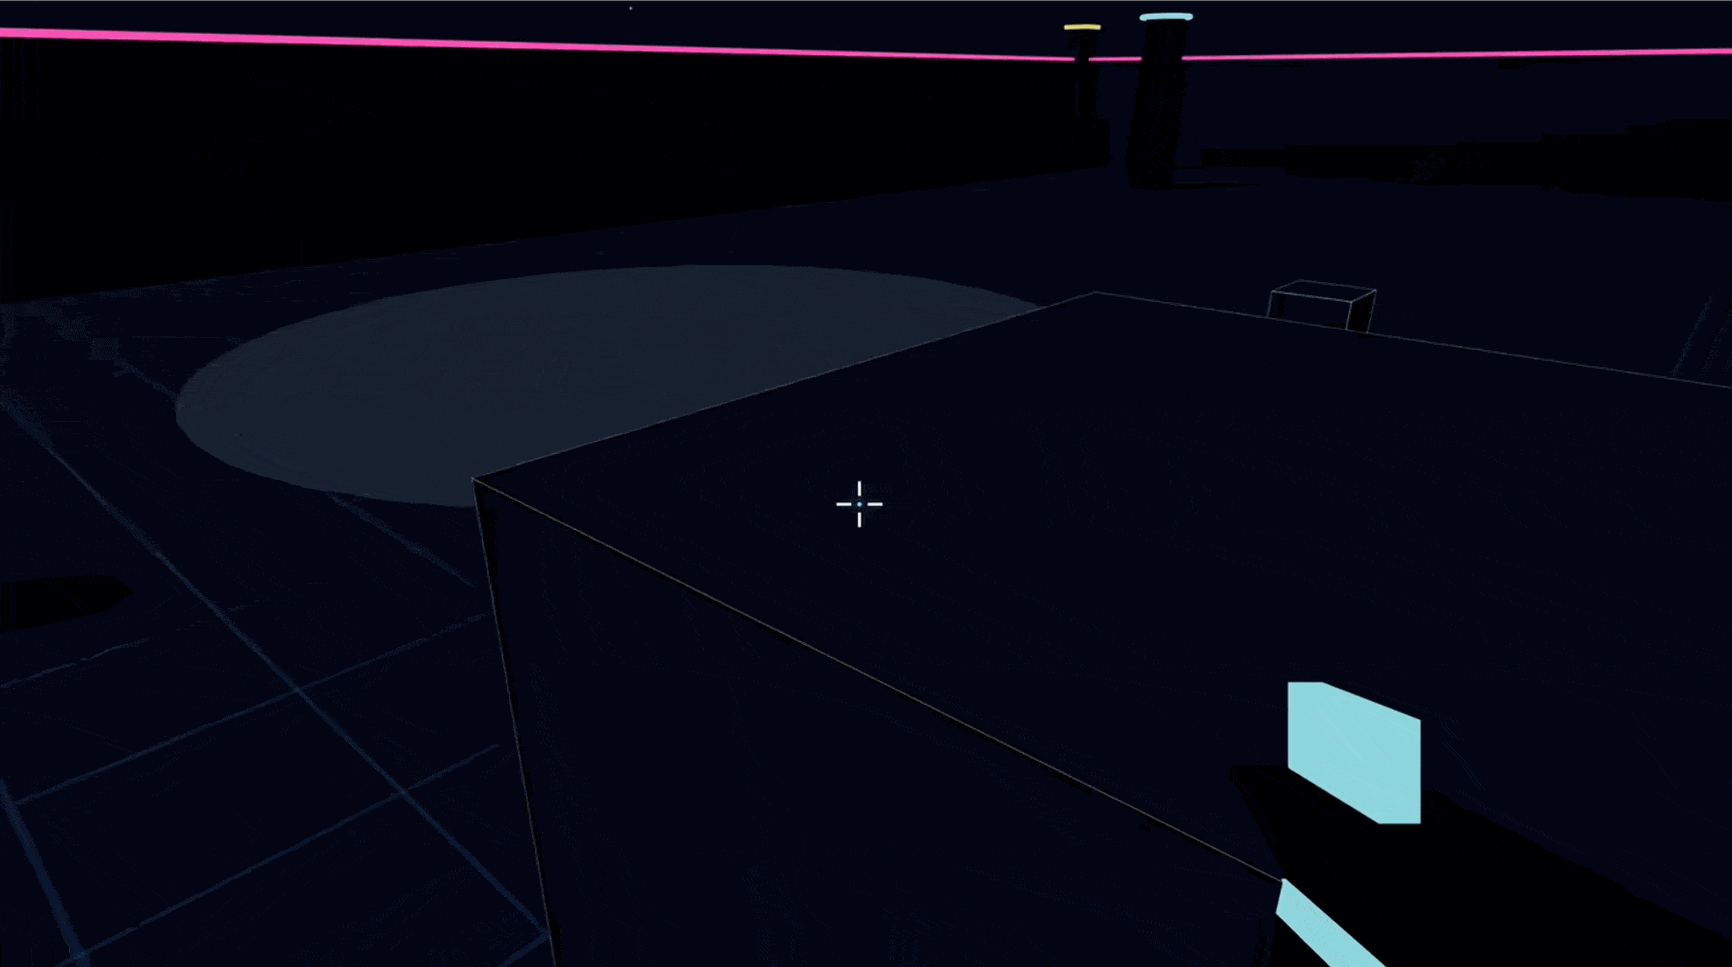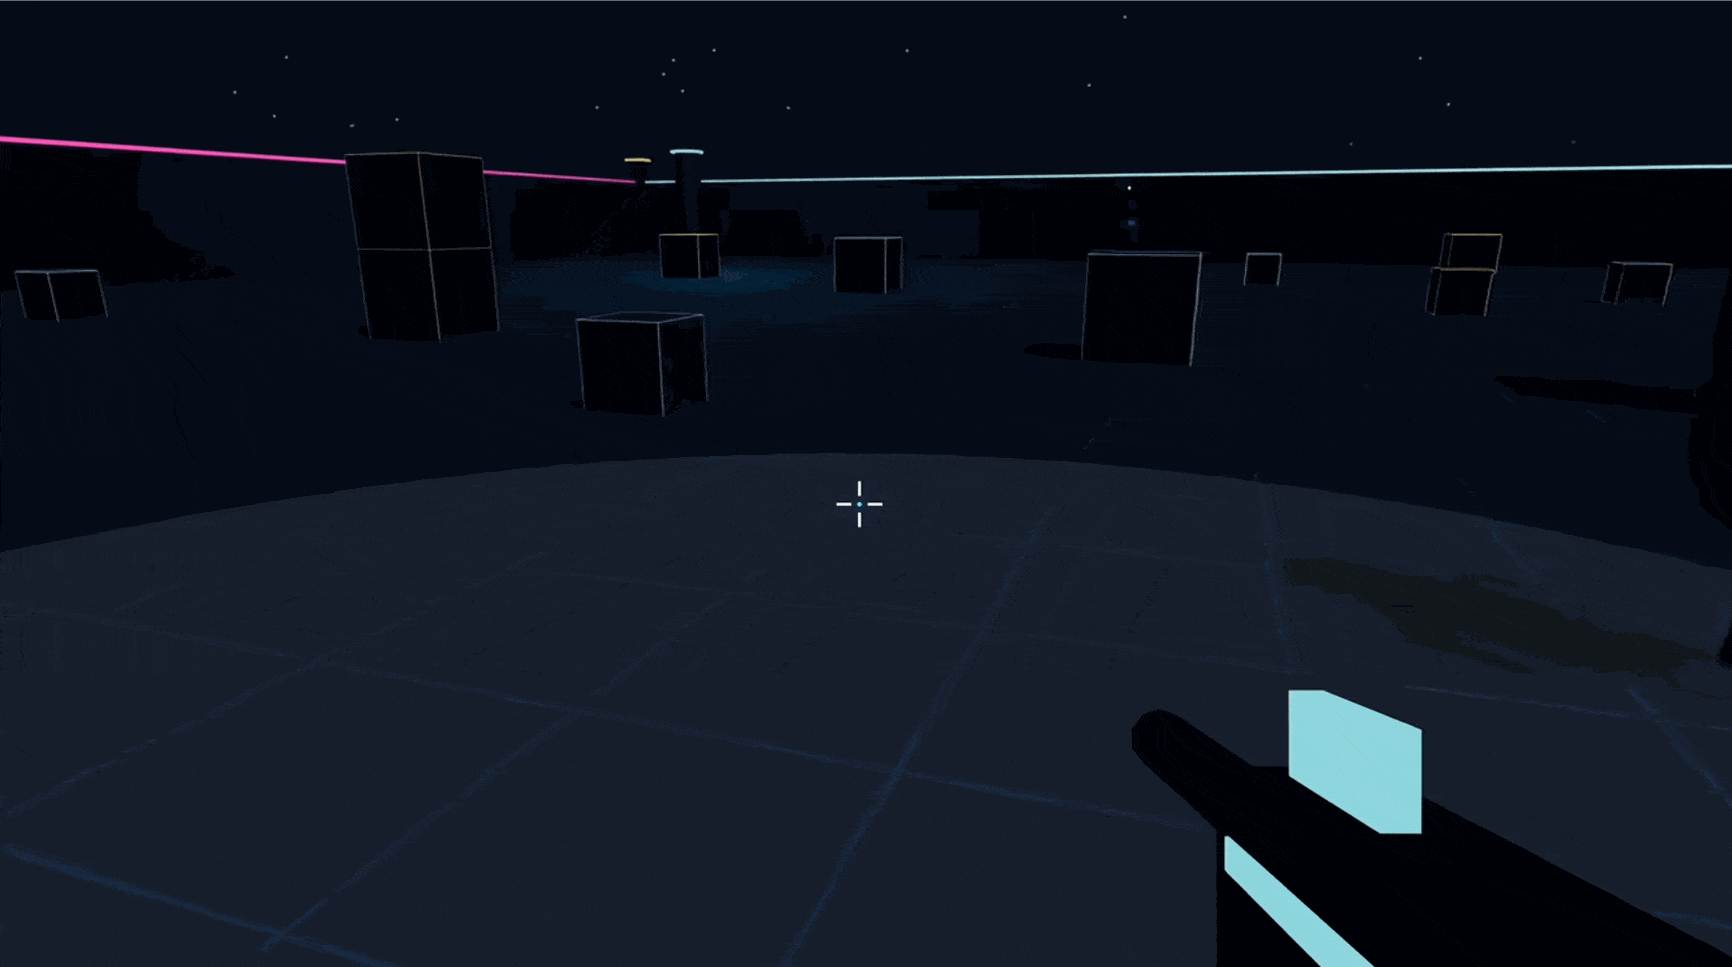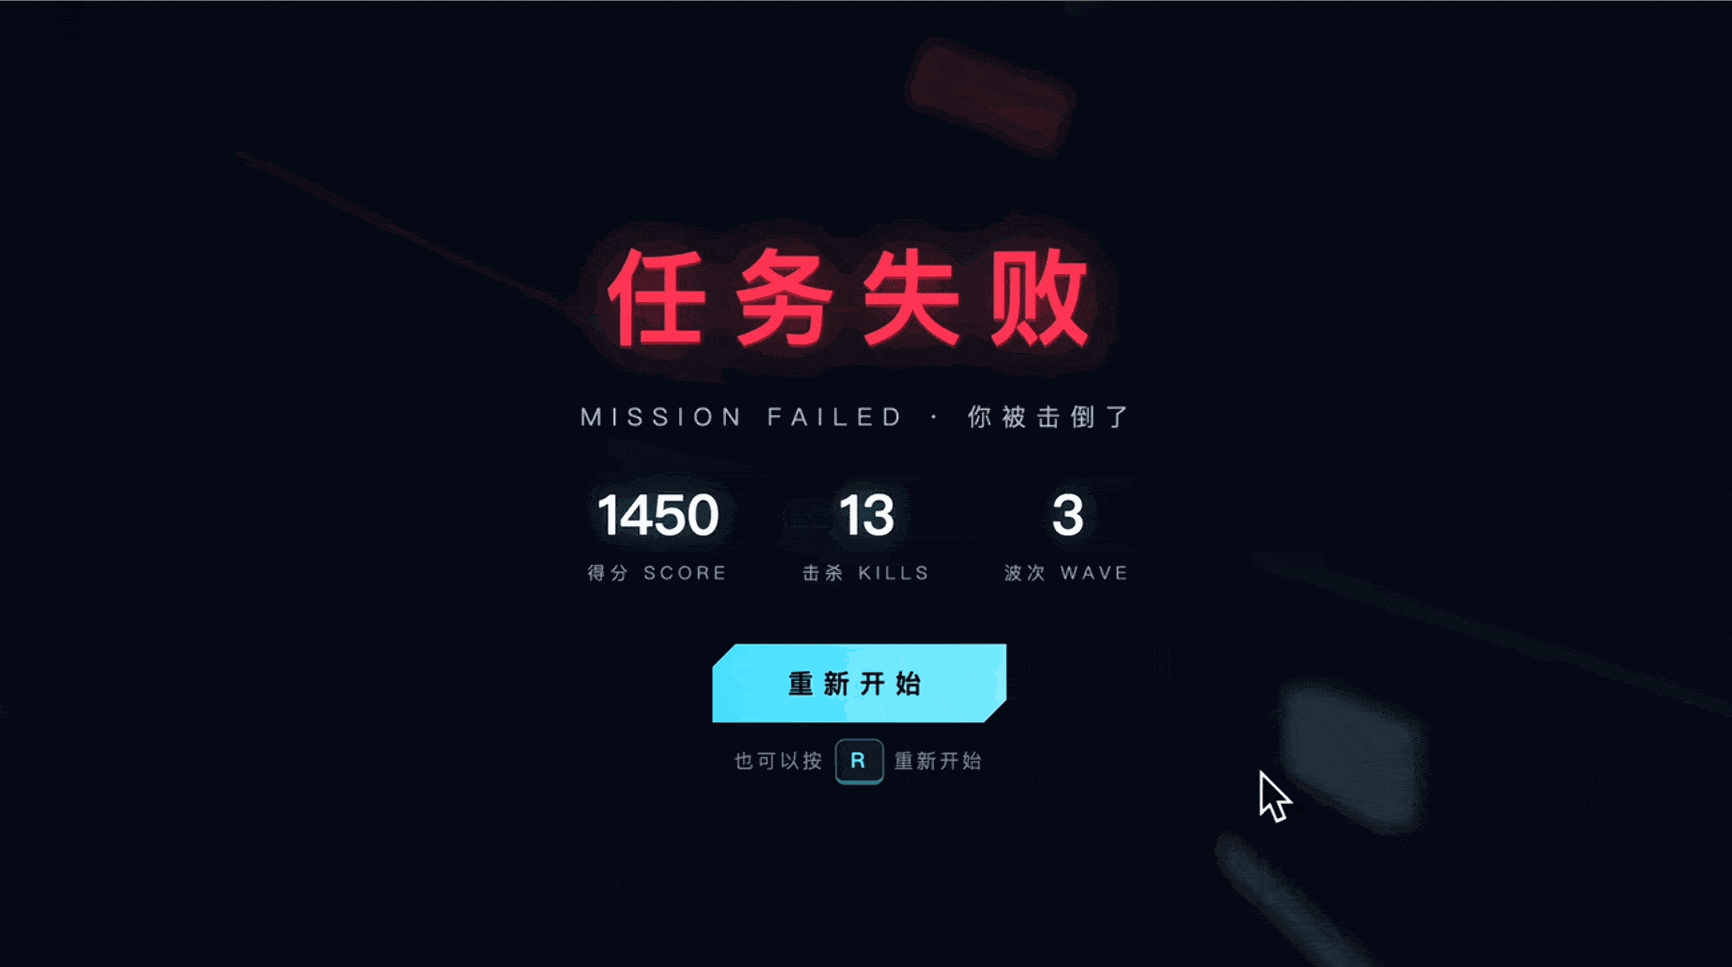
标准模式下 V4 Pro 初步完成的游戏可玩性,移动、射击、击杀流程完整。问题在于敌人无法射击,且追击会无故脱离。倒地视角是意外亮点。全程 50 步,AI 自检修复,合计耗时 33 分钟,输入 520 万 Token,输出 10.5 万 Token。
测试二:代码库分析(长上下文模式)
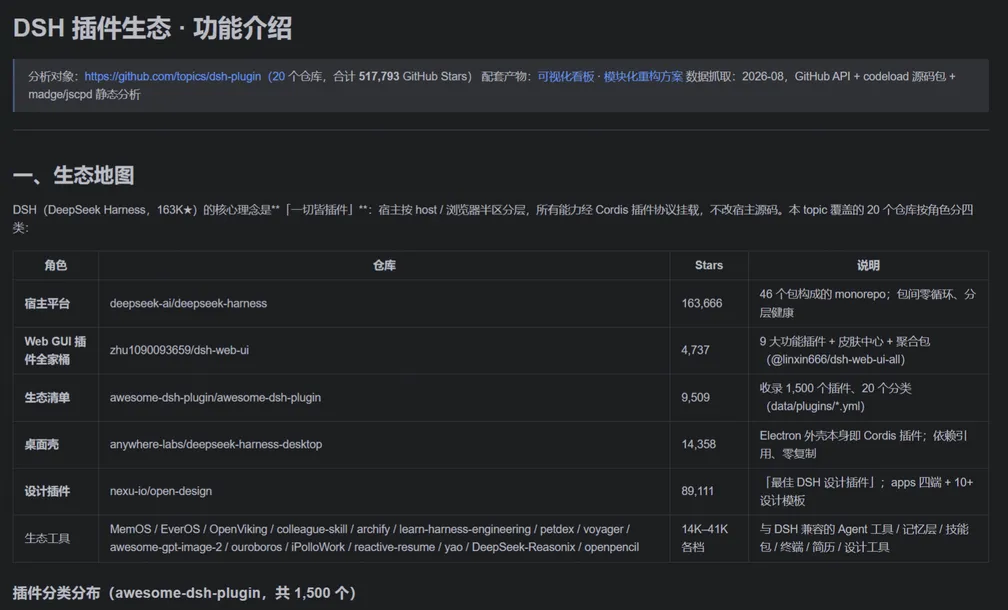
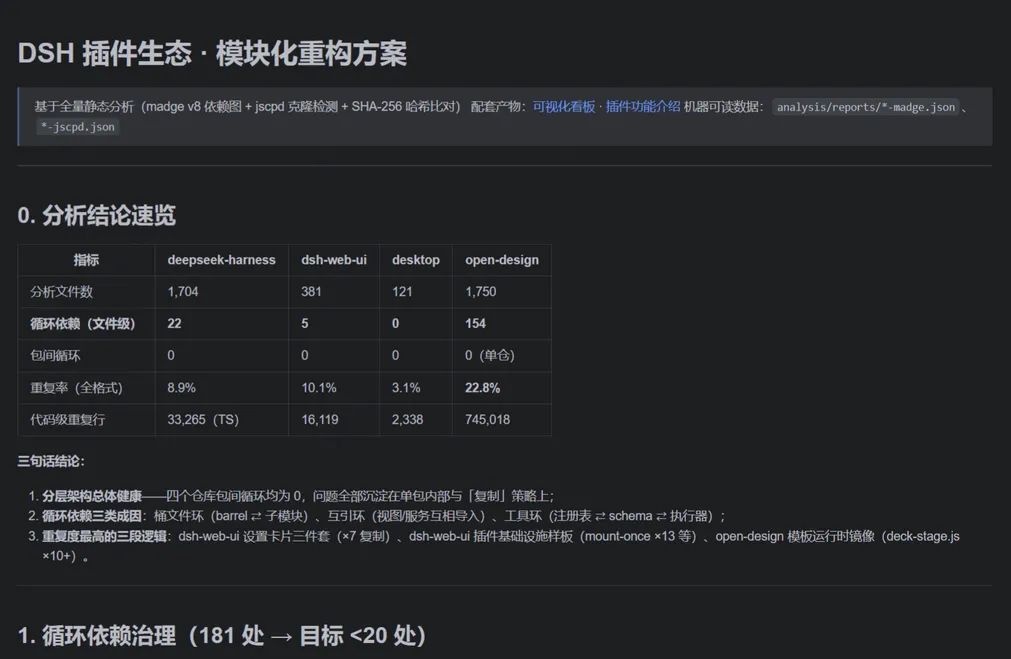
Prompt:分析 github.com/topics/dsh-plugin 项目架构,找出循环依赖,识别重复度最高的三段逻辑,输出可视化看板和插件功能介绍。
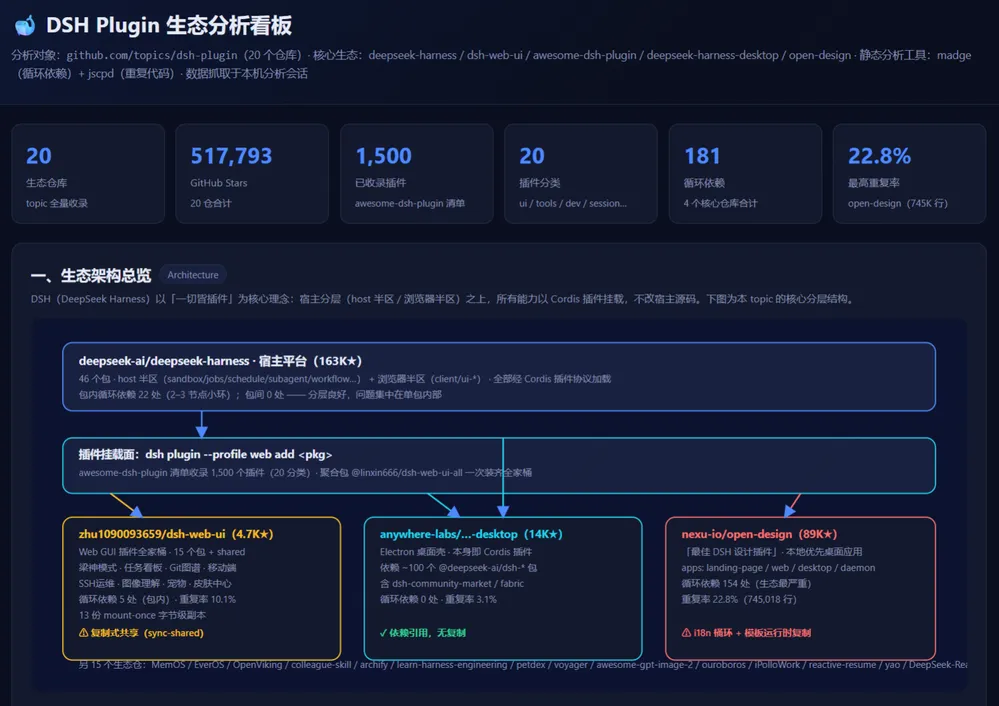
任务耗时 42 分钟,最终生成了一份可视化看板和两个 Markdown 文档。但效果只能说中规中矩:看板呈现明显的 AI 生成风格,数据存在错误,文档内容仅停留在信息整理层面,缺乏架构层面的深入洞察。对于长上下文分析这类任务,Harness 目前的表现与专用工具相比仍有差距。
小结
Harness 在标准模式下的 Coding 任务已经展现了可用性,全程自主操作检验修复。但长上下文处理、复杂分析任务仍是短板。它不是一个开箱即用的成品,而是需要开发者根据具体场景调试和优化的工具框架。
六、Cordis——88页论文开启“自演化”智能体时代
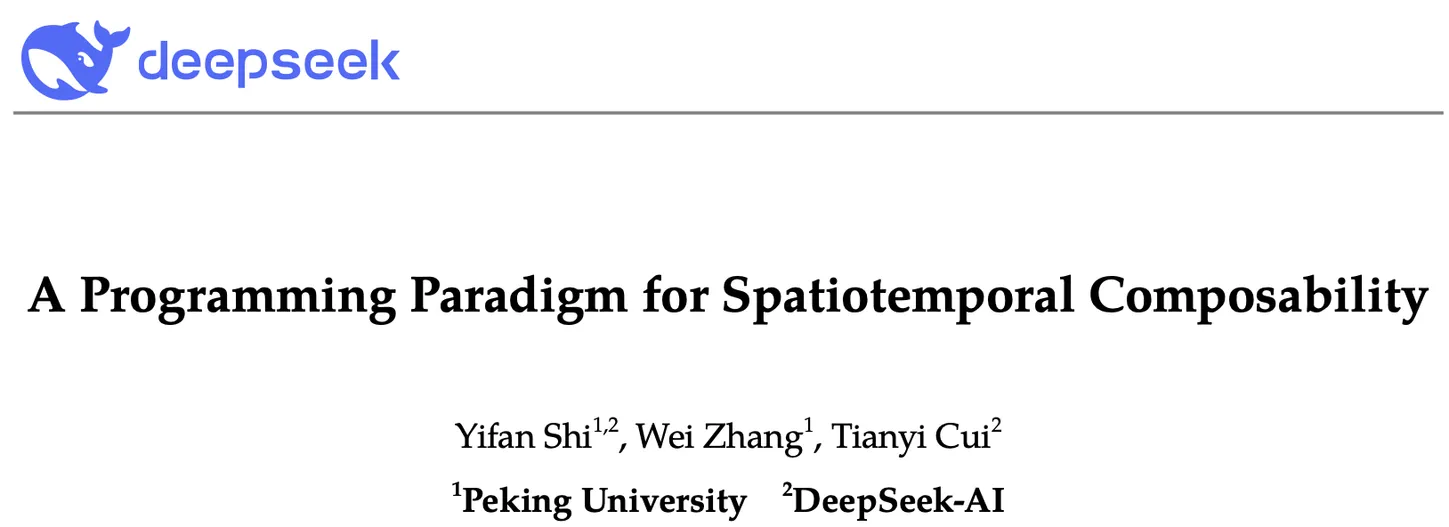
V4 Pro 和 Harness 发布的同时,DeepSeek 放出了一篇 88 页的论文:《A Programming Paradigm for Spatiotemporal Composability》。
解释了为什么DeepSeek 的 Harness 为什么这么好用?如果你没时间读全文,记住这几句就行:
Cordis 内核只负责插件的加载、卸载和依赖关系,不承载 Agent 的具体能力。传统插件系统的问题是:卸载插件必须重启。VSCode 装个插件要重载窗口,这就是时间维度的耦合。插件的副作用没有被完整追踪和撤销。
Cordis 解决了两件事:
- 时间可组合性:一个组件被移除时,它对系统产生的所有副作用都能被撤销。实现方式是“可逆效应”——每次状态修改都记录逆操作,卸载时反向执行。
- 空间可组合性:组件之间的依赖关系能动态管理。实现方式是“反应式余效应”——组件声明自己需要什么,运行时自动协调,无需人工指定加载顺序。
整个Cordis的内核本身,是为了让Agent在运行过程中不断的给自己开发、安装卸载插件,从而形成某种意义的自演化。这篇论文的核心贡献是:为“热拔插插件”提供了形式化的数学基础。 它把效应(effect)和余效应(coeffect)从类型理论提升到了运行时机制,证明了在复杂系统中,插件可以随时装上、随时卸下,而系统状态保持完整。Cordis 已经在 Koishi 聊天机器人框架上跑了四年,承载超过 4000 个社区插件。Harness 是 Cordis 在 Agent 领域的一次规模化验证。
论文结尾展望了一个方向:AI 智能体持续生成和替换自己的组件,几乎不需要人工介入。在这个场景下,组件频繁更替、依赖拓扑持续变动,Cordis 的时空可组合性恰好提供了理论基础——这篇论文不只是解释 Harness 为什么好用,它在为 Agent 系统的“自我进化”能力铺路。
- paper: https://github.com/cordiverse/paper/blob/main/paper.pdf
七、总结
DeepSeek Harness 的创新在于 Agent 插件机制与工程架构层面,但在长上下文理解与复杂编程任务的生成质量上仍有提升空间。V4 Pro 验证了后训练驱动能力跃升的可行性,Harness 证明了框架工程是释放模型潜力的必要条件,Cordis 论文则为这套架构提供了形式化保障,三者共同指向一个趋势:Agent 竞赛正从“谁的模型更聪明”转向“谁定义了 Agent 如何进入真实世界”。客观来说,Harness 目前还远称不上成熟:界面初始为空,使用门槛高,插件质量良莠不齐,安全风险需自行判断,它更像一个组装车间而非开箱即用的成品。但其通过 MIT 协议、不断增长的插件生态、Cordis 内核的理论支撑、“一切皆插件”的架构设计,指向的不是又一个 Copilot,而是一套开发者可自由定制的 Agent 运行时。
AGI-Eval 会持续跟进评测,也建议大家亲自上手跑一跑,看它适不适合你的场景。评论区聊聊体验,期待 DeepSeek 后续打磨。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号