想让LLM多想几轮,又不想显存爆炸?MELT 把循环 Transformer 的 KV 缓存解耦了

想让LLM多想几轮,又不想显存爆炸?MELT 把循环 Transformer 的 KV 缓存解耦了
唐国梁Tommy
发布于 2026-06-25 21:43:18
发布于 2026-06-25 21:43:18
一个被忽略的代价
过去两年,让大模型"会思考"的主流路径是 Chain-of-Thought:模型在给答案前先把推理过程一段段地"说出来"。它有效,但也有清晰的代价——输出越长,延迟越高,KV 缓存越大。
于是另一条路慢慢走出来:潜在推理(latent reasoning)。代表性的做法是 looped transformer——同一摞 Transformer 层反复对隐状态做迭代,让模型在不吐出中间 token 的前提下,多想几轮再出口。最近的 Ouro / LoopLM 已经把这条路跑通到 SOTA 级别,证明循环到位的小模型可以打平甚至超过参数量近两倍的标准模型。
听起来很美。但深入看一眼内存,事情就没那么轻巧。
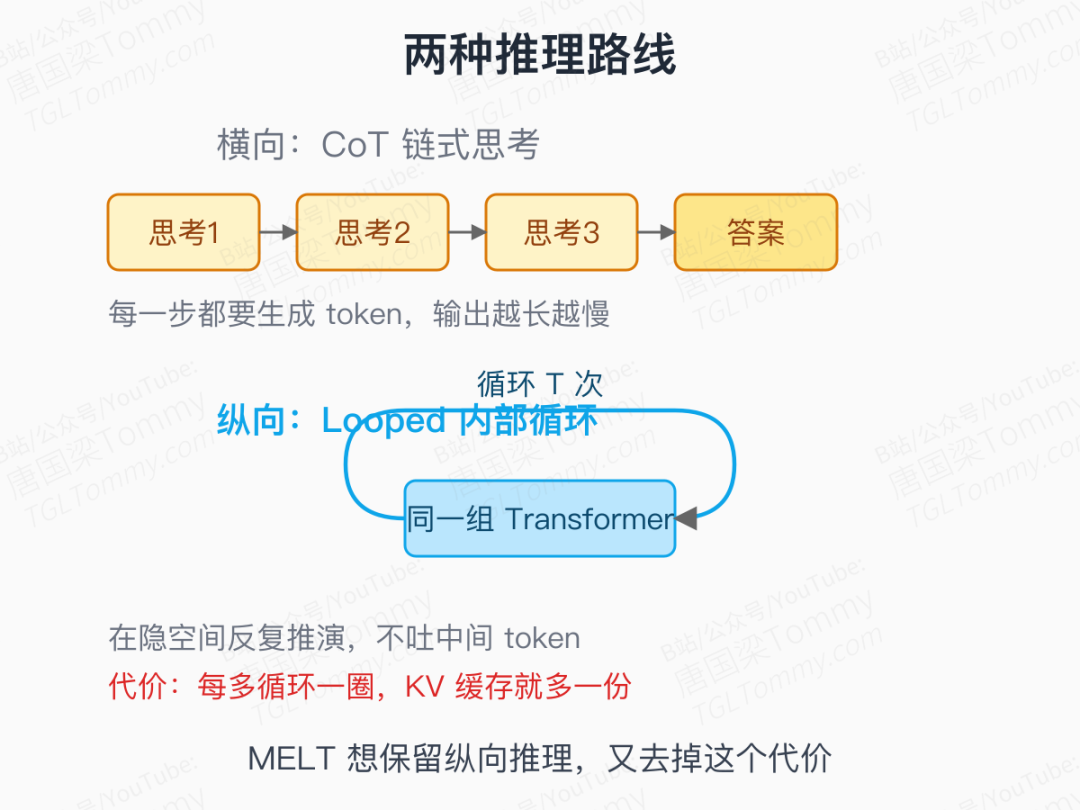
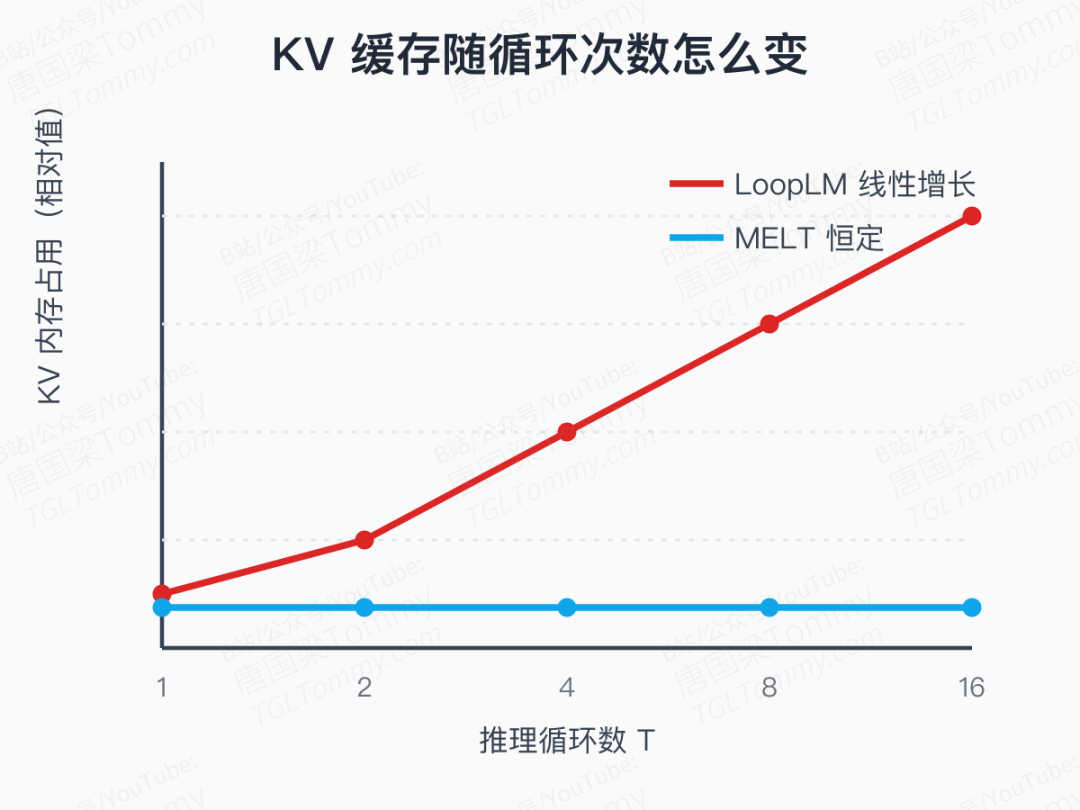
每多循环一圈,模型就会为每一层、每一个 token 多生成一份 Key/Value。原始 LoopLM 把这些 KV 全部保留下来——总缓存大小是 层数 × 序列长度 × 循环次数。循环深度从 1 涨到 8,KV 缓存就跟着涨 8 倍。一旦你想做长上下文 + 多轮推理,显存就开始劝退。
简单说:循环 Transformer 用"垂直深度"换"水平输出长度",但缓存这一块没换出来,反而绑得更紧了。
MELT 的核心一招
这篇论文提出的方法叫 MELT(Memory-Efficient Looped Transformer)。一句话概括它做了什么:
把"每圈追加一份新 KV",换成"始终维护一份 KV,每圈用门控覆写它"。
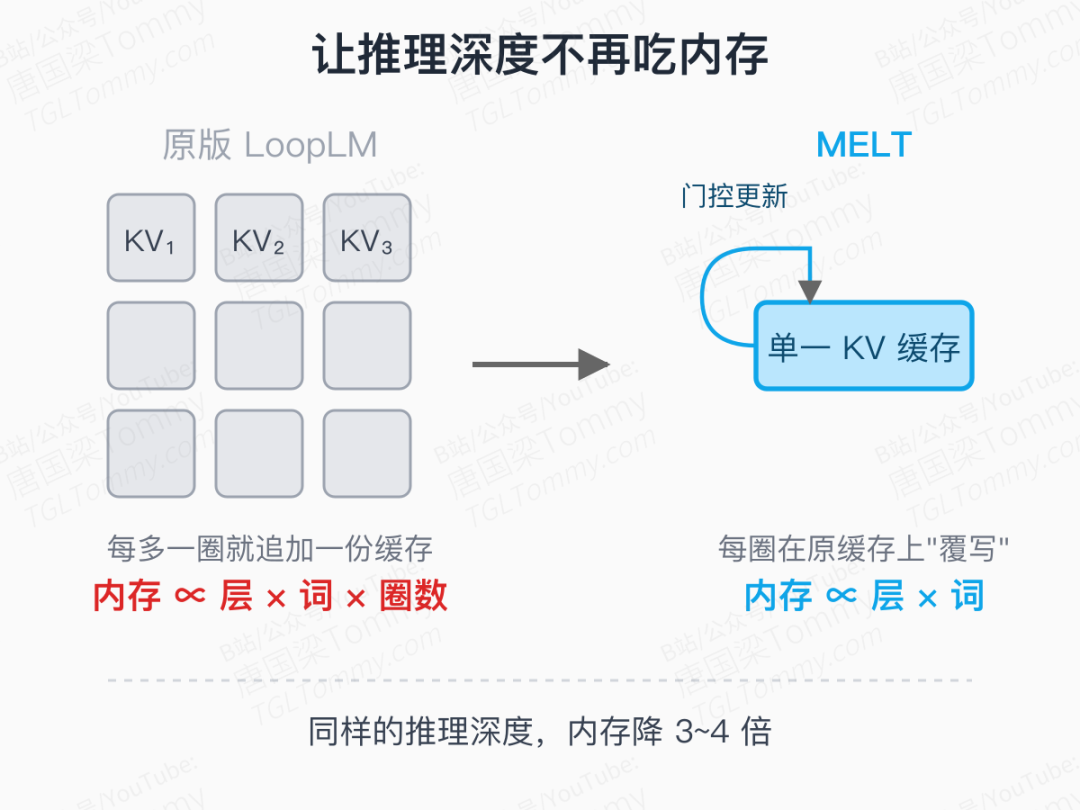
也就是说,每一层只有一份 KV 缓存,每个 token 在循环里反复迭代时,新算出来的 K、V 不再写到缓存的新行里,而是和原行做一次门控融合,落回原位置。整套缓存的总量从 O(N × L × T) 直接降到 O(N × L)——和一个普通 Transformer 一样不依赖循环深度。
这不只是"少存一点"。它把一个看上去耦合的两个量——算多深 和 占多大显存——彻底解开了。你可以放心地把循环数往上加,而不必担心 KV 缓存炸掉。
为什么要门控,而不是直接覆盖
一个直接的问题:既然要把"多圈"压成"一圈",为什么不能简单点——取平均?取最后一圈?做个 EMA?
作者把这些朴素方案都试了一遍,结果如下图:
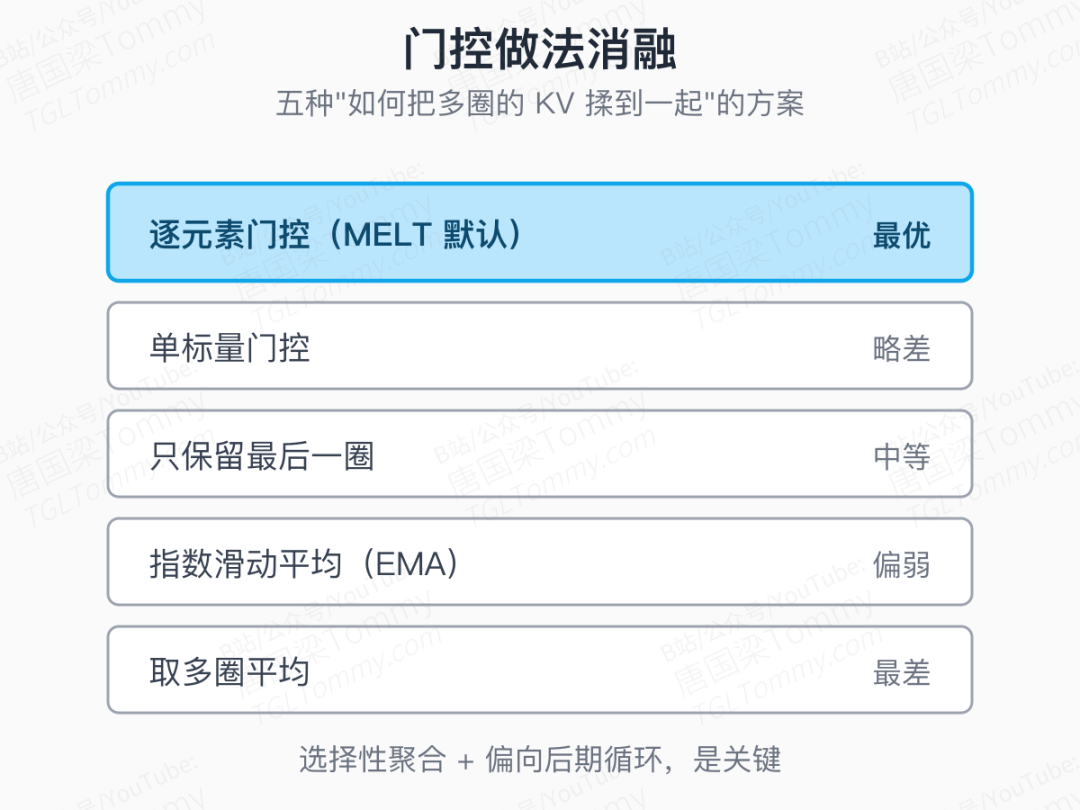
四种"不带额外参数"的方案里,只保留最后一圈 表现最好;但仍然显著低于带学习参数的逐元素门控方案。换句话说:
- • 信息聚合方式 不能太机械,硬平均会冲掉重点;
- • 但也 不能完全靠后期循环,前几轮的中间表征仍然有价值;
- • 真正能学到"哪些维度要留下来、哪些维度可以让位"的门控,是逐元素的、随 token 变化的。
具体到结构上,MELT 在每一层维护一个潜在状态 h,它由门控负责更新;K 和 V 都是从 h 经过线性投影得到的。
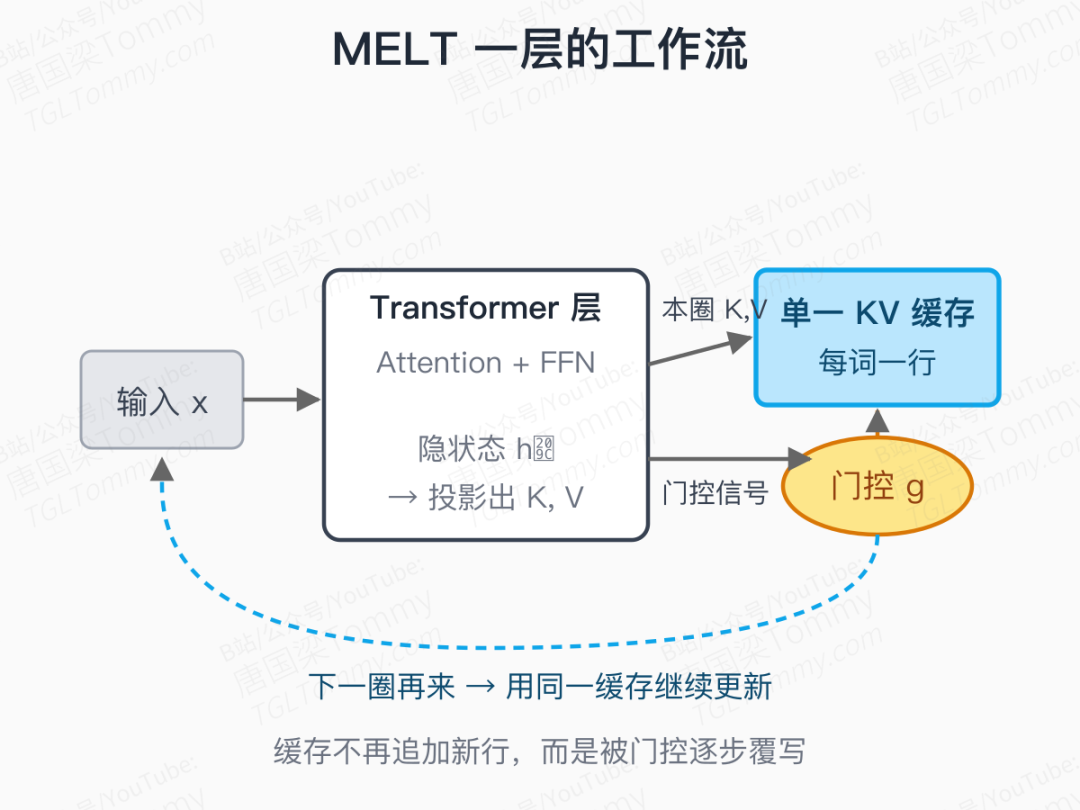
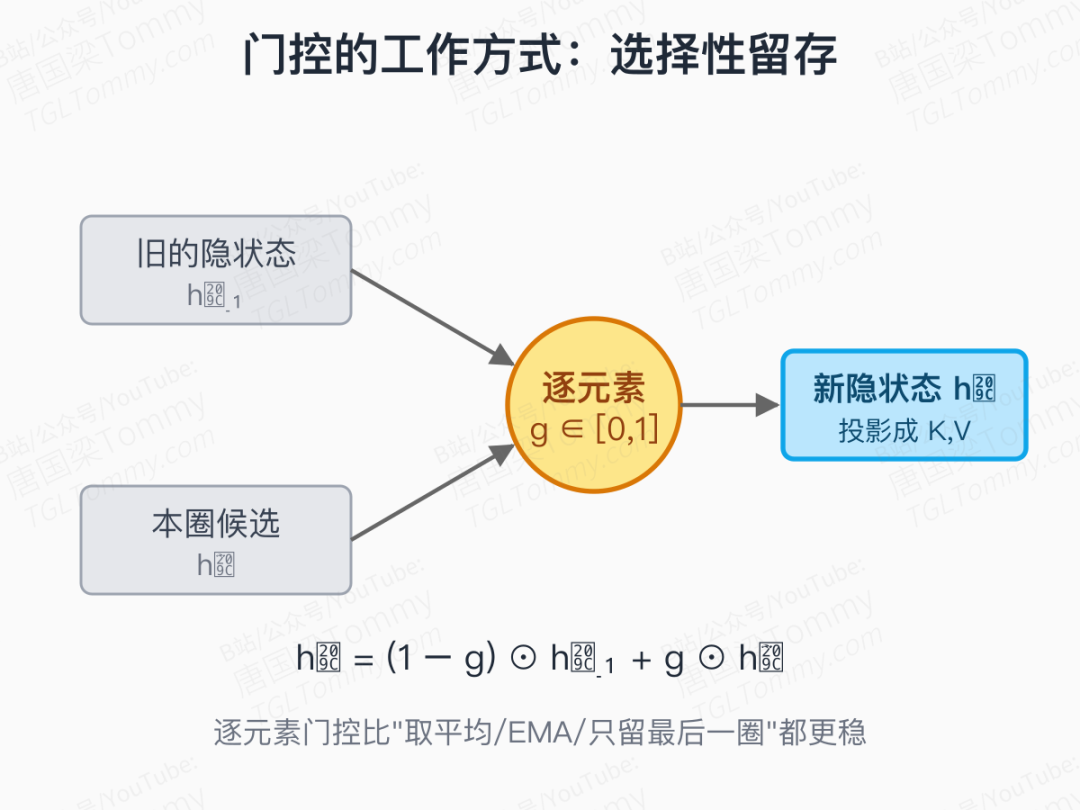
公式上是 hₜ = (1 − g) ⊙ hₜ₋₁ + g ⊙ h̃ₜ,g 是一个长度等于隐维度的向量,逐元素决定"旧表征保留多少、本圈候选融入多少"。一个看似很轻的改动,把循环架构的内存特性整个改变了。
一个值得说明的设计:作者特意没让 K、V 直接复用上一圈的输出,而是让 K、V 通过 W_K、W_V 从 h 投影出来。这是为了保留"查询—键"的对齐关系,使注意力本身仍按 Transformer 习惯的方式工作,只是它注意的 KV 是被"门控压缩"过的。
把训练这件事掰开来
故事如果到这里就结束了,那 MELT 听上去过于优雅。真正困难的部分是:它没办法像普通 Transformer 那样并行训练。
原因不复杂:MELT 里每个 token 的 KV 缓存依赖前一个 token 的完整 forward。所以 token-by-token 走完整循环,理论上最准确,但慢得离谱;如果绕开最后一圈、退回到经典并行训练,又会和推理时的动态对不上。
作者给出的折中方案叫 chunk-wise training:把序列切成等长块,块内并行、块间顺序。
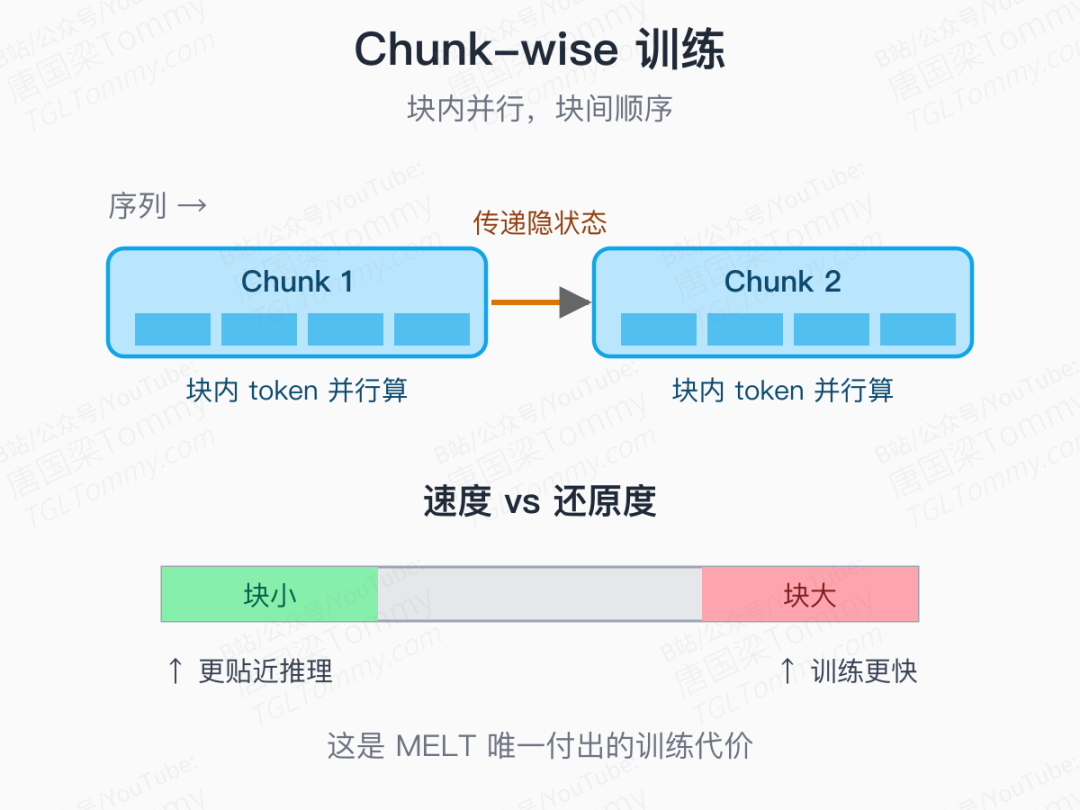
块大小变成了一个旋钮:
- • 块小一些,越贴近推理时的串行特性,但训练吞吐降下来;
- • 块大一些,训练快,但和推理动态偏离更多。
这是 MELT 唯一一个"我们要付出的代价"——为了把内存解耦出来,训练需要付一笔效率税。
用 LoopLM 启动,平滑迁移过去
另外一个细节:作者并不是从头训练一个 MELT,而是用预训练好的 Ouro-1.4B-Thinking 做初始化,再走两阶段微调过去。这样既省算力,又能继承循环模型已经学到的"会思考"的能力。
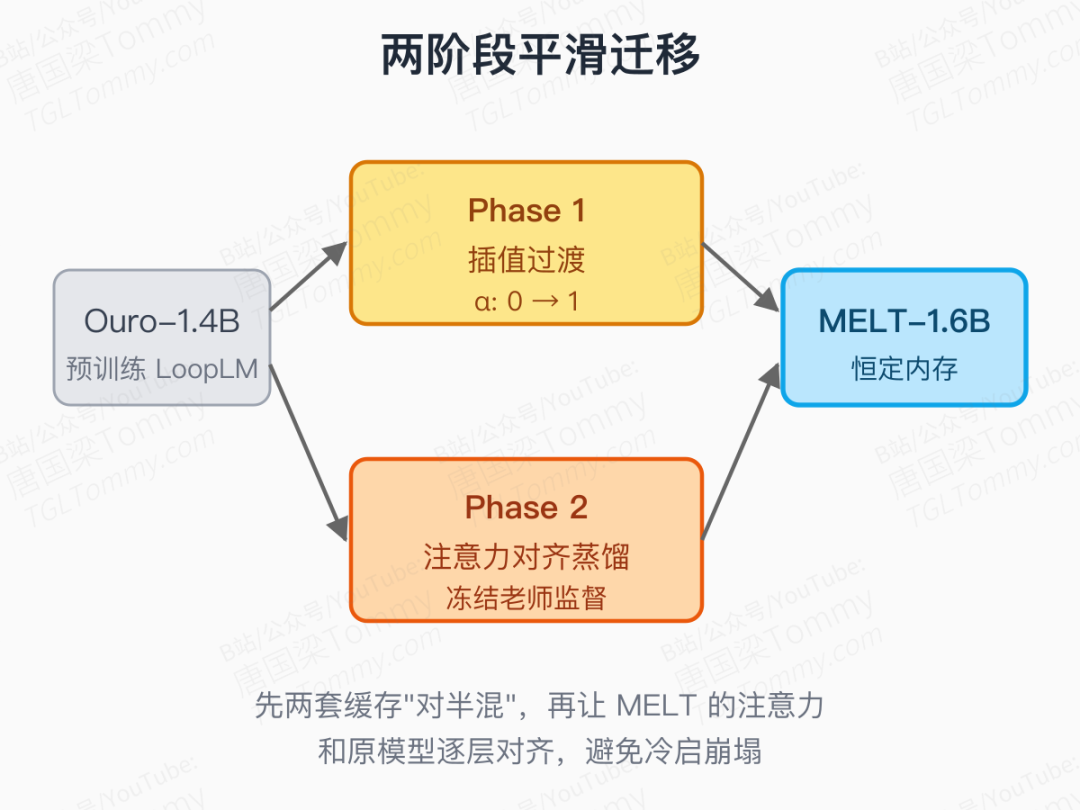
- • Phase 1:插值过渡。同时跑 LoopLM 老路径和 MELT 新路径,用一个系数 α 把两套 KV 缓存线性混合。α 从 0 开始,慢慢升到 1。模型相当于在"老规矩"和"新规矩"之间一点点滑过去,避免冷启动直接崩。
- • Phase 2:注意力对齐蒸馏。冻结 LoopLM 作为老师,让 MELT 的每一层注意力分布去对齐老师的对应层。它解决的是另一个问题:哪怕参数装得很好、推理动态也对了,注意力本身可能漂移到一个奇怪的位置,必须有显式约束把它拽回来。
整套训练只用了 8 张 H100、跑了 130 小时(约 1040 GPU 小时)就完成了。对一篇架构改造论文来说,这是个相当克制的预算。
结果到底怎么样
直接看数学推理基准的平均成绩:
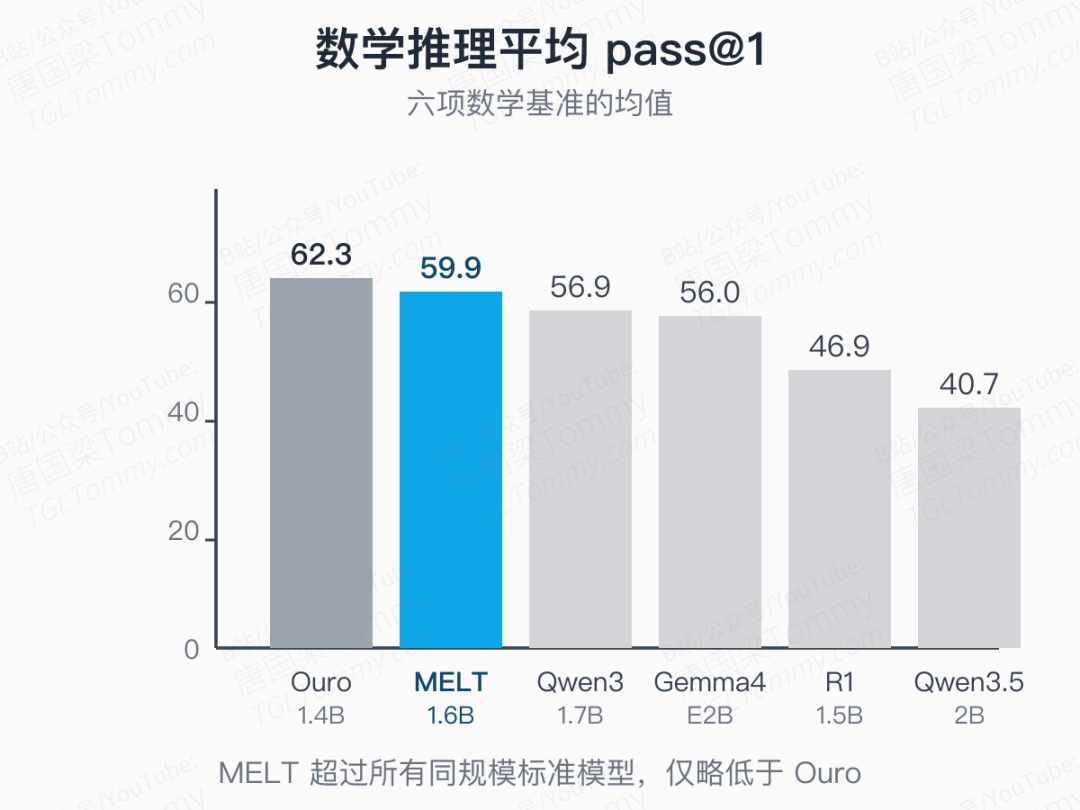
六项数学基准(AIME24/25/26、AMC23、MATH-500、OlympiadBench)的平均 pass@1:
模型 | 平均 pass@1 |
|---|---|
Ouro-1.4B Thinking | 62.3 |
MELT-1.6B | 59.9 |
Qwen3-1.7B | 56.9 |
Gemma4-E2B | 56.0 |
DeepSeek-R1 1.5B | 46.9 |
Qwen3.5-2B | 40.7 |
几个能读出的事:
- 1. MELT 系统性地超过同规模标准 Transformer——把 Qwen3-1.7B、Gemma4-E2B、Qwen3.5-2B、DeepSeek-R1 1.5B 全部压在身下;
- 2. 相对原版 Ouro,MELT 略低一点点(62.3 → 59.9),这是预料中的——Ouro 用满了 per-loop KV,理应有些优势;
- 3. 但 HumanEval 上 MELT 反超 Ouro(81.7 vs 76.8),说明"压缩 KV"未必处处吃亏,有些任务反而受益于一个干净紧凑的隐状态。
把内存维度叠上去看,MELT 的位置就清楚了:
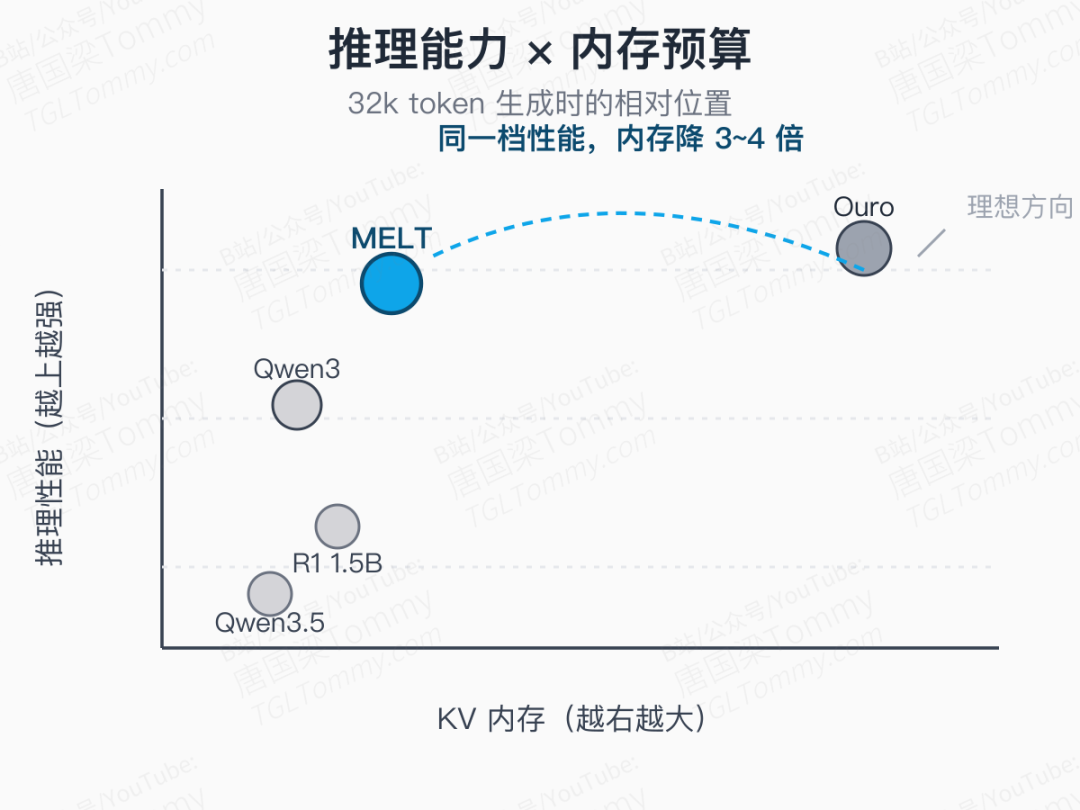
按 vLLM 实测,生成 32k token 时:
- • Ouro 的 KV 缓存最大,比 Qwen 系列高出约 20 GB;
- • MELT 把 KV 缓存压回到接近 Qwen 的水平,仅比 Qwen 多约 2.5 GB(差距主要来自 Qwen 用了 MQA,MELT 暂时还没结合);
- • 相比 Ouro,MELT 的 KV 缓存降低 3 ~ 4 倍。
这就是论文真正的卖点——第一个在同等内存预算下,性能超过标准 Transformer 的循环架构。
还没解决的事
作者很坦诚地把局限写在了第五节:
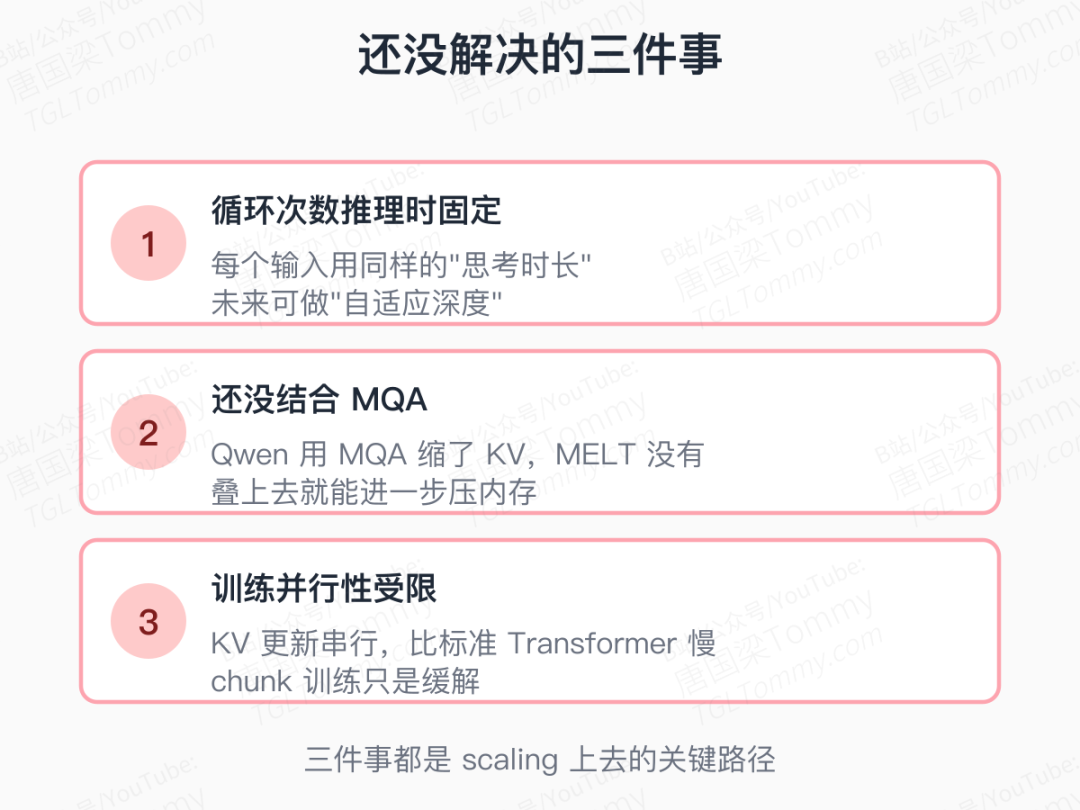
- • 推理时循环次数仍然是固定值,所有输入用同样的"思考时长",浪费明显;
- • 还没和 MQA / GQA 组合,留着进一步压内存的空间;
- • 训练仍然受 KV 串行依赖拖累,chunk 训练只是缓解,没有彻底解决。
第一项尤其值得关注。MELT 的"常数内存潜状态"正好为 自适应深度 留好了接口——理论上可以让模型自己决定一个简单输入循环 2 次、复杂输入循环 12 次。这是从"会想"到"想得恰到好处"的关键一步,也是循环架构相对 CoT 还没兑现的最大红利。
一点延伸思考
MELT 的意义可能比表面上要大。
第一,它把循环 Transformer 这条原本受限于显存的路重新打开了。在此之前,Looped LM 的"想得越深越聪明"和大模型的"上下文越长越实用"是直接打架的——你不能既循环 16 次又跑 32k 上下文。MELT 把这个矛盾拆掉了。
第二,它说明 KV 缓存这件事还没被压榨干净。我们已经看到 MQA、GQA、State Space 替代品,但 "用一份带门控的可写缓存代替不断追加的只读历史" 仍然是个少有人走的方向。MELT 在 latent reasoning 上的成功,提示了类似思路也许能迁移到普通生成的长上下文场景。
第三,它和当下"用更长思考换更强能力"的潮流是一致的。但与 CoT 把思考过程变成 token 流不同,MELT 把思考留在向量里,并且保证这个过程不会让显存暴涨。从工程角度,这才更接近一个可以放进生产环境的"推理时 scaling"路径。
如果说 Ouro 证明了 looped transformer 能跑通,那 MELT 大概是把它从研究演示往产品端推进了一大步——让"想得更深"这件事,不再以内存为代价。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-05-16,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号