这个框架让大模型省下50%内存,合并专家不如直接删掉?

这个框架让大模型省下50%内存,合并专家不如直接删掉?
用户11563501
发布于 2026-06-23 10:42:45
发布于 2026-06-23 10:42:45
稀疏混合专家模型(SMoE)就像一个有数百个专家的咨询公司。每次处理问题,只需要几个专家出马,但所有专家的办公室都得租着,工资都得照付。虽然计算成本可控,但内存开销却居高不下。
Cerebras Research提出了REAP (Router-weighted Expert Activation Pruning) 框架,通过专家剪枝和合并技术来压缩SMoE模型,声称能够让模型"瘦身"的同时保持性能。比如Qwen3-Coder-30B经过REAP处理后变成25B,体积减少了约17%。省出来的显存可以用更高精度的量化,或者支持更长的上下文窗口。它的思路也好理解:既然有些专家经常闲着,那就把他们暂时"裁掉"。但这里有个有趣的发现——直接删除专家比合并专家效果更好。
REAP框架示意图
为什么合并专家会出问题?
传统思路是把相似的专家合并成一个,听起来很合理。但REAP团队发现了一个关键问题:专家合并会导致"功能子空间塌陷"。所谓“功能子空间坍塌”是指MoE层中的多个专家学习到占用激活空间中重叠或高度相似区域的现象。
说人话就是,路由器原本能根据不同输入灵活调配专家,合并后这种灵活性就没了。就像把几个不同领域的顾问强行合并成一个人,表面上节省了人力,但处理复杂问题的能力大打折扣。
REAP怎么做剪枝?
REAP的创新在于它的判断标准:不只看专家被用了多少次,还要看路由器对它们的"信任度"和激活强度。系统会实时评估每个专家的贡献度,把那些对当前任务帮助最小的专家从内存中移除。
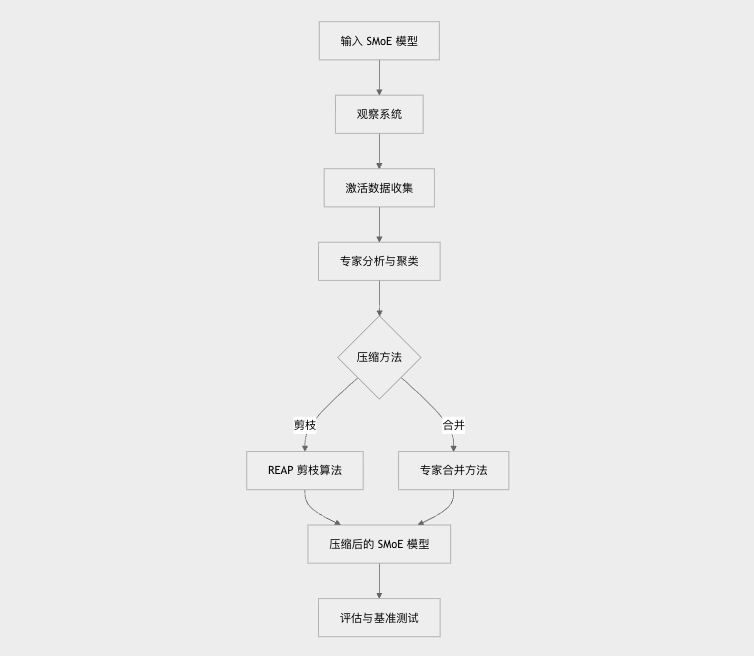
这个判断过程涉及"路由器门值"和"专家激活范数"。前者是系统对专家有用程度的评分,后者是专家工作时的活跃度。说白了就是看谁最没用。
支持哪些模型?
REAP支持全面的 SMoE 架构:
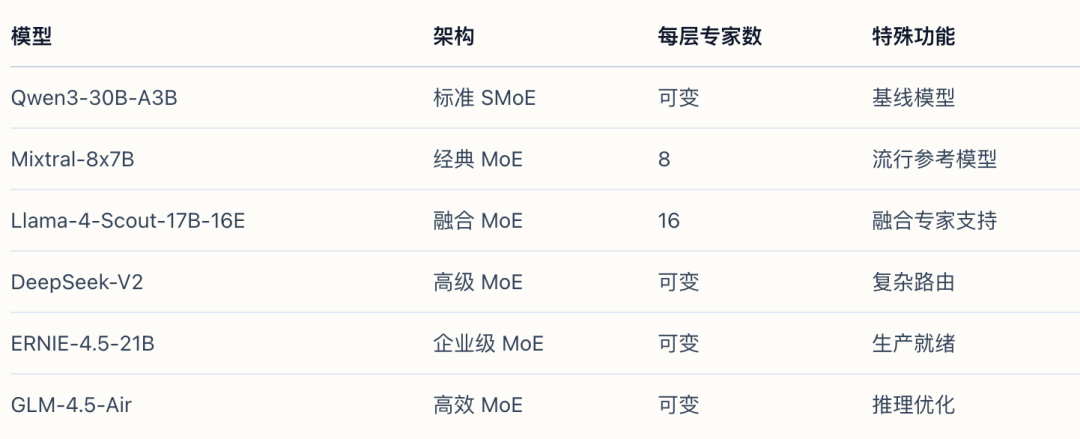
每种模型的专家数量和架构都不同,但REAP都能处理。这得益于其模块化设计——观察者系统负责收集数据,聚类算法分析专家相似性,剪枝模块执行删除操作。
实际效果如何?
数据很亮眼:在保持99%模型性能的前提下,内存占用能减少50%。在编程、数学推理和创意写作任务上表现尤其突出。
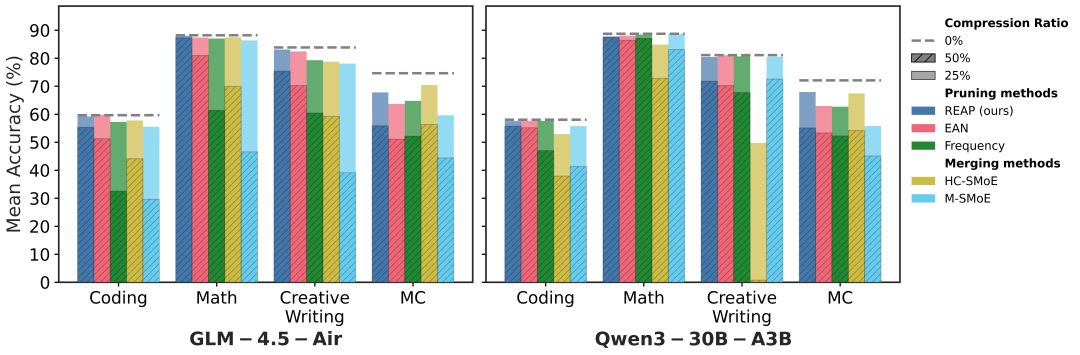
性能对比图
这对那些买不起顶配服务器的公司意义重大。原本需要几百GB内存才能跑的模型,现在用一半内存就够了。团队还在HuggingFace上提供了预训练的压缩版本,比如Qwen3-Coder-REAP-246B-A35B-FP8,可以直接下载使用。
不过,社区对其结果也有不同声音,有人选了两个能在RTX 5090上完整跑起来的模型做对比:
- 标准版:Unsloth的Qwen3-Coder-30B-A3B-Instruct,用UD-Q6_K_XL量化
- REAP版:bartowski的Qwen3-Coder-REAP-25B-A3B,用Q8_0量化
测试工具用的是aider polyglot基准,每个模型跑3轮,每轮225个测试案例。
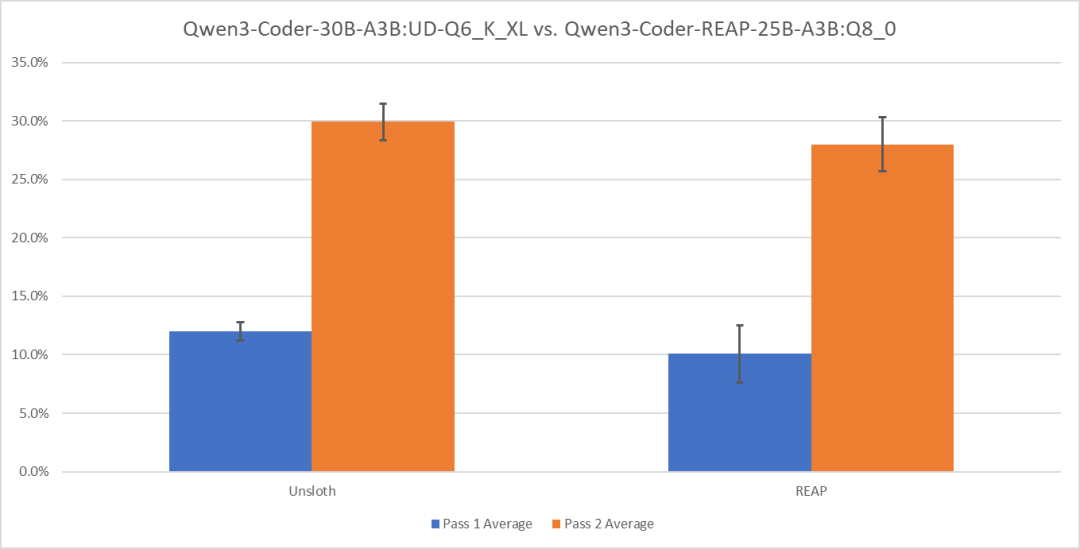
测试结果对比图
结果有点打脸:
指标 | Unsloth标准版 | REAP版 |
|---|---|---|
第一轮通过率 | 12.0% | 10.1% |
第一轮标准差 | 0.77% | 2.45% |
第二轮通过率 | 29.9% | 28.0% |
第二轮标准差 | 1.56% | 2.31% |
两个模型的平均表现基本打平,差异在统计误差范围内。更有意思的是,REAP版本虽然用了更高精度的Q8量化,但结果波动性反而更大。当然,需要指出的是,不同量化版本本身对于比较来讲会有一定的不可比性。
动态调整的智慧
REAP最聪明的地方在于动态评估。今天用不上的专家,明天可能就是关键角色。系统不会一刀切地删除某些专家,而是根据具体任务实时调整专家组合。
这有些印证了机器学习里的"彩票假说"。大部分神经网络确实有冗余,关键是找到那个"中奖"的子网络。但REAP更进一步,它不是静态地找最优子网络,而是动态地适应不同任务需求。
还有哪些问题?
框架已经开源,支持PyTorch和JAX平台。团队下一步要研究跨任务专家共享——让专家们身兼数职,进一步榨取价值。
但有个问题值得思考:频繁的专家调度会不会带来额外的计算开销?毕竟,判断谁该走谁该留,本身也需要时间和计算资源。对于那些对延迟敏感的实时应用,这个trade-off需要仔细权衡。
另外,虽然50%的内存节省很诱人,但在极端压缩场景下,模型的泛化能力是否会受影响?这些都是实际部署时需要考虑的问题。
不过不管怎么说,REAP至少证明了一点:有时候做减法比做加法更有效。在资源有限的现实世界里,这种思路可能比追求更大更复杂的模型更有价值。
参考:https://zread.ai/CerebrasResearch/reap
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-11-16,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号