大语言模型对齐技术 - RLHF训练方法

大语言模型对齐技术 - RLHF训练方法
mixlab跨学科社区
发布于 2026-03-24 20:38:09
发布于 2026-03-24 20:38:09
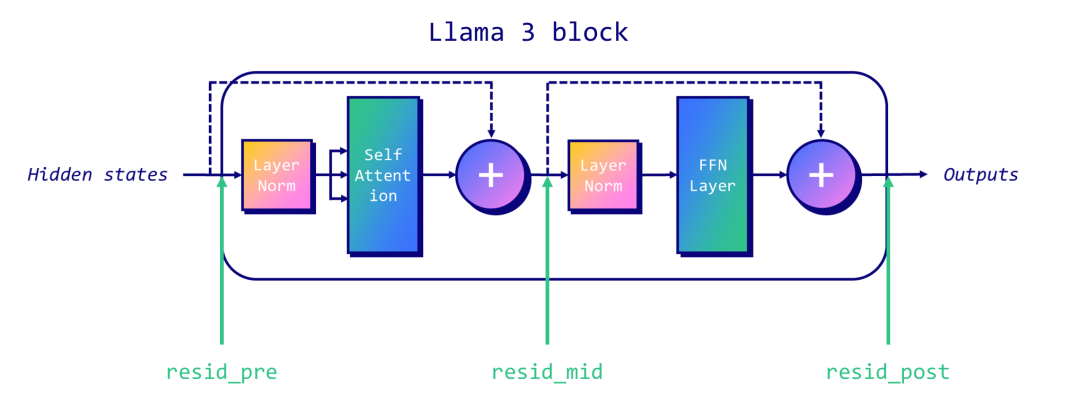
"abliteration"技术,通过识别LLM中的"拒绝方向"并正交化权重,解除模型审查机制。实验显示该方法会降低模型性能,但后续DPO微调可恢复表现,最终得到高性能无审查的8B模型NeuralDaredevil。
核心要点:
- 技术原理:对比有害/无害指令的残差流激活差异,定位"拒绝方向"(如Llama 3的审查机制)
- 关键操作:通过权重正交化永久消除该方向,使模型不再拒绝敏感请求
- 性能影响:直接应用会导致MMLU等指标下降(如Daredevil-8B分数降低)
- 修复方案:采用DPO偏好对齐微调(使用orpo-dpo-mix-40k数据集),恢复模型能力
- 伦理争议:暴露安全微调的脆弱性,需谨慎使用该技术
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-06-22,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号