Python编程作业二:组合数据类型

一、列表基本操作
对于列表all_list1=[1,'word',{'like':'pythom'},True,[1,2]],请按顺序完成如下操作: (1)得到该列表的倒数第2个元素 (2)使用切片同时得到该列表的第1、3、5个元素 (3)以逆序方式输出该列表的各元素,同时要求不得改变原始对象 (4)修改该列表的最后一个元素为[10,20] (5)为该列表增加一个新元素{7,8,9},并使它位于列表的最左侧 (6)删除该列表中的'word'字符串元素
(1)得到该列表的倒数第2个元素
all_list1=[1,'word',{'like':'python'},True,[1,2]]
print(all_list1[-2])

# True
(2)使用切片同时得到该列表的第1、3、5个元素
all_list1[::2]

# [1, {'like': 'python'}, [1, 2]]
(3)以逆序方式输出该列表的各元素,同时要求不得改变原始对象
all_list1[::-1]

# [[1, 2], True, {'like': 'python'}, 'word', 1]
(4)修改该列表的最后一个元素为[10,20]
all_list1[-1]=[10,20]
all_list1

# [1, 'word', {'like': 'python'}, True, [10, 20]]
(5)为该列表增加一个新元素{7,8,9},并使它位于列表的最左侧
all_list1.insert(0,{7,8,9})
all_list1

# [{7, 8, 9}, 1, 'word', {'like': 'python'}, True, [10, 20]]
(6)删除该列表中的'word'字符串元素
all_list1.remove('word')
all_list1

# [{7, 8, 9}, 1, {'like': 'python'}, True, [10, 20]]
二、字符串基本操作
要求对字符串s='love life,love Python'按顺序完成如下操作: (1)逆序输出该字符串 (2)统计字母o出现的次数 (3)判断该字符串中是否含有数字字符 (4)用'makes me'修改字符串中的逗号,使得修改后的内容变为:love life makes me love Python (5)将字符串s与其他字符串进行合并,使得合并后的新字符串为:'love life,love Python' is a slogan of Python learners. (6)提取字符串s中的单词,去掉重复的单词,并把不重复的单词放到一个列表中并输出该列表
(1)逆序输出该字符串
s='love life,love Python'
s[::-1]

# 'nohtyP evol,efil evol'
(2)统计字母o出现的次数
print(s.count("o"))

# 3
(3)判断该字符串中是否含有数字字符
# 法一:列表推导式
print(any(char.isdigit() for char in s))

#法二:for循环
has_digit = False
for char in s:
    if char.isdigit():
        has_digit = True
        break
print(has_digit)

# False
(4)用'makes me'修改字符串中的逗号,使得修改后的内容变为:love life makes me love Python
s.replace(',',' makes me ')

# 'love life makes me love Python'
(5)将字符串s与其他字符串进行合并,使得合并后的新字符串为:'love life,love Python' is a slogan of Python learners.
print("'" +s+ "'is a slogan of Python learners.")

# 'love life,love Python'is a slogan of Python learners.
(6)提取字符串s中的单词,去掉重复的单词,并把不重复的单词放到一个列表中并输出该列表
ls=s.replace(","," ").split()
list(set(ls))

# ['Python', 'life', 'love']
三、字典基本操作
按要求按顺序完成如下与字典相关的操作: (1)建立一个名为dt2的字典,该字典包含两个键值对,分别是:'k2':{'a','b'}和'k3':[1,3] (2)打印字典dt2的键值对,要求每行输出一个键值对 (3)得到dt2中所有的键并存放在列表list1中 (4)得到dt2中所有的值并存放在列表list2中 (5)得到dt2中所有的键值对并存放在列表list3中 (6)把dt2中的键值对'k3':[1,3]修改为'k3':[1,8] (7)得到dt2中键为'k6'的键值对所对应的值,没有该键值对的话就返回0 (8)删除键为'k3'的那个键值对
(1)建立一个名为dt2的字典,该字典包含两个键值对,分别是:'k2':{'a','b'}和'k3':[1,3]
dt2={'k2':{'a','b'},'k3':[1,3]}
dt2

# {'k2': {'a', 'b'}, 'k3': [1, 3]}
(2)打印字典dt2的键值对,要求每行输出一个键值对
for key in dt2:
    print("{}:{}".format(key,dt2[key]))

# k2:{'a', 'b'}
# k3:[1, 3]
(3)得到dt2中所有的键并存放在列表list1中
list1=list(dt2.keys())
list1

# ['k2', 'k3']
(4)得到dt2中所有的值并存放在列表list2中
list2=list(dt2.values())
list2

# [{'a', 'b'}, [1, 3]]
(5)得到dt2中所有的键值对并存放在列表list3中
list3=list(dt2.items())
list3

# [('k2', {'a', 'b'}), ('k3', [1, 3])]
(6)把dt2中的键值对'k3':[1,3]修改为'k3':[1,8]
dt2['k3']=[1,8]
dt2

# {'k2': {'a', 'b'}, 'k3': [1, 8]}
(7)得到dt2中键为'k6'的键值对所对应的值,没有该键值对的话就返回0
dt2.get('k6',0)

# 0
(8)删除键为'k3'的那个键值对
del dt2['k3']
dt2

# {'k2': {'a', 'b'}}
四、回文数判断
回文数是指一个数字从左边读和从右边读的结果一样,比如 12321。可以用如下数据进行测试:

while True:
    s=input("请输入一个数(输入q退出):")
    if s=="q":
        break
    elif s==s[::-1]:
        print("是回文数")
    else:
        print("不是回文数")
运行示例:
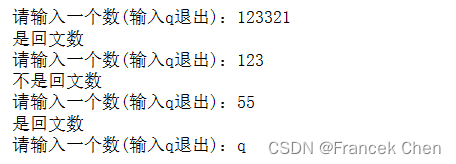
这段代码是一个无限循环,它会反复询问用户输入一个数,直到用户输入字母 "q" 以退出循环。在每次循环中,代码会调用 input() 函数来接受用户的输入,并将其赋值给变量 s。如果用户输入的是 "q",则程序会调用 break 语句跳出循环。如果用户输入的不是 "q",则代码会继续执行。 首先,程序会检查输入的字符串是否是回文数。这里使用了 Python 中的切片操作 s[::-1] 来翻转字符串 s,然后将其与原字符串 s 进行比较。如果两个字符串相等,则说明 s 是回文数,程序会输出 "是回文数"。如果输入的字符串不是回文数,则程序会输出 "不是回文数"。循环会一直执行,直到用户输入 "q" 以退出循环。
五、按职业统计就业人数
输入某班各个同学就业的职业名称,职业名称之间用空格分开(按回车键结束输入)。请统计各职业的就业人数,按数量由大到小的顺序输出。 例如输入: 护士 导游 老师 护士 老师 老师 销售 预期的输出: 老师:3 护士:2 导游:1 销售:1
names=input("请输入各位同学的就业职位名称,用空格分开:")
works=names.split()
d={}
for work in works:
    d[work]=d.get(work,0)+1        # for循环遍历works列表中的每个就业职位名称
ls=list(d.items())
ls.sort(key=lambda x:x[1],reverse=True)         # 按照频次从高到低进行排序
for each in ls:
    print("{}:{}".format(each[0],each[1]))
运行示例:
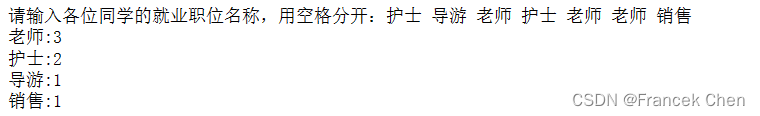
这段代码用于统计同学们的就业职位,并按照频次从高到低进行排序和输出。 首先,代码会通过 input() 函数提示用户输入各位同学的就业职位名称,并将输入的内容保存在变量 names 中。接下来,代码使用 split() 方法将输入的字符串按空格分割成一个列表,并将该列表保存在变量 works 中。这样,works 列表中的每个元素都是一个就业职位名称。然后,代码创建了一个空字典 d。接下来的 for 循环遍历 works 列表中的每个元素,即每个就业职位名称。 在循环中,代码使用 d.get(work, 0) 来获取字典 d 中指定就业职位名称 work 对应的值。如果该名称不存在于字典 d 中,则返回默认值 0。然后,代码将该值加 1,并将结果赋值回字典 d 中的相应位置,以进行计数。接下来,代码将字典 d 转换为包含键值对元组的列表 ls,并使用 sort() 方法对列表进行排序。排序是按照元组的第二个元素(即频次)进行降序排列的。最后,代码使用一个 for 循环遍历排序后的列表 ls,并使用 format() 方法将职位名称和频次格式化为字符串进行输出。 因此,代码的作用是统计并输出同学们就业职位的频次,按照频次从高到低进行排序和展示。
六、计算平均分
计算平均分。现有学生成绩放在ls列表中,如下面所示(该列表可以直接复制粘贴到开发环境中): ls=[["李涵剑","经济191",430],["赵康剑","会计191",541],["冯剑健","经济191",549],\ ["赵一一","机械191",301],["冯风琳","计算191",352],["王林林","经济191",577],\ ["赵一舒","计算191",516],["赵国健","会计191",553],["钱健华","计算191",412],\ ["冯风林","会计191",584],["赵蓝舒","英语191",361],["王琳琳","机械191",516],\ ["钱舒健","英语191",445],["钱康国","会计191",317],["冯健琳","会计191",512],\ ["李华国","英语191",344],["冯舒国","化工191",383]] 请根据班级统计每班的平均成绩。
法一:常规做法,不使用字典进行统计
ls=[["李涵剑","经济191",430],["赵康剑","会计191",541],["冯剑健","经济191",549],\
    ["赵一一","机械191",301],["冯风琳","计算191",352],["王林林","经济191",577],\
    ["赵一舒","计算191",516],["赵国健","会计191",553],["钱健华","计算191",412],\
    ["冯风林","会计191",584],["赵蓝舒","英语191",361],["王琳琳","机械191",516],\
    ["钱舒健","英语191",445],["钱康国","会计191",317],["冯健琳","会计191",512],\
    ["李华国","英语191",344],["冯舒国","化工191",383]]
# 先统计不同的班级
classes=[]
for person in ls:
    classes.append(person[1])
classes=list(set(classes))
print(classes)
results=[]        # results列表用于存储班级和相应的平均分
# 分班统计每班总分和每班人数
for cls in classes:
    total=0
    count=0
    for person in ls:
        if cls==person[1]:
            total+=person[2]
            count+=1
            avg=total/count
    results.append([cls,avg])
print(results)
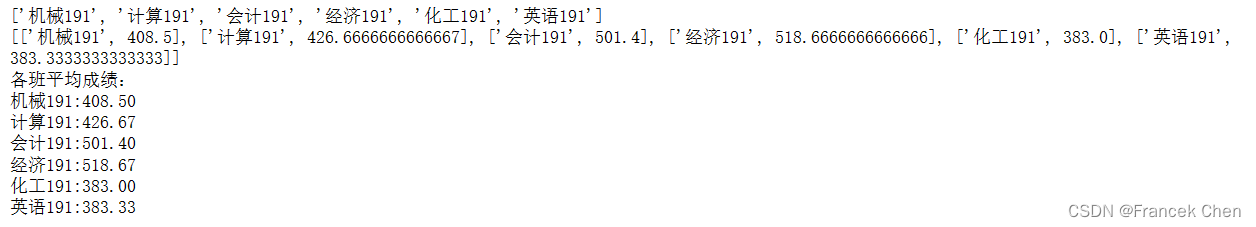
print("各班平均成绩:")
for result in results:
    print("{}:{:.2f}".format(result[0],result[1]))
运行示例:
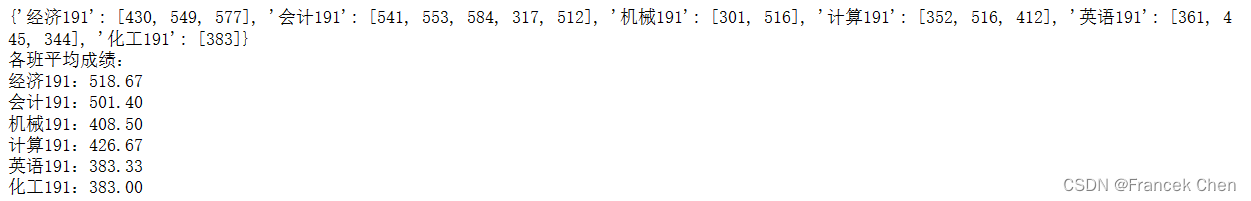
法二:类似于词频统计,利用字典的get方法进行统计更方便
ls=[["李涵剑","经济191",430],["赵康剑","会计191",541],["冯剑健","经济191",549],\
    ["赵一一","机械191",301],["冯风琳","计算191",352],["王林林","经济191",577],\
    ["赵一舒","计算191",516],["赵国健","会计191",553],["钱健华","计算191",412],\
    ["冯风林","会计191",584],["赵蓝舒","英语191",361],["王琳琳","机械191",516],\
    ["钱舒健","英语191",445],["钱康国","会计191",317],["冯健琳","会计191",512],\
    ["李华国","英语191",344],["冯舒国","化工191",383]]
# 字典d用班级作为字典的键,用班级中每个学生的成绩汇合成的列表作为字典的值
d={}
for person in ls:
    cls=person[1]
    score=person[2]
    d[cls]=d.get(cls,[])+[score]
print(d)
print("各班平均成绩:")
for cls in d:
    avg=sum(d[cls])/len(d[cls])
    print("{}:{:.2f}".format(cls,avg))
运行示例:
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2024-01-27,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号