大厂面试官最喜欢问的三道MySQL面试题,面试前一定要学会!

大厂面试官最喜欢问的三道MySQL面试题,面试前一定要学会!
小白的大数据之旅
发布于 2024-11-20 19:25:28
发布于 2024-11-20 19:25:28
嘿,各位面试官眼中的“潜力股”们,想要在众多求职者中脱颖而出,成为那个让HR眼前一亮的存在吗?那你可得好好补补MySQL的这些“硬通货”了!啥是回表操作?为啥有时候查询明明用了索引,却还是慢如蜗牛?联合索引、组合索引、复合索引,这些听起来就让人头疼的名词,你又能分得清吗?还有啊,什么时候该给数据库戴上“加速器”——索引,什么时候又得避免这个“累赘”?掌握了它们,你就能在面试中“闪闪发光”,成为那个让面试官眼前一亮的“宝藏候选人”!所以,赶紧学起来吧,别让这些“知识点”成为你面试路上的绊脚石!
什么是回表操作?
面试官提问背景:
面试官:在MySQL的优化过程中,索引扮演着至关重要的角色。而今天,我想和你聊聊一个与索引相关的常见概念——“回表操作”。了解并掌握这个概念,可以帮助你更深入地理解MySQL的查询执行机制,并进一步优化数据库性能。那么,现在请你解释一下,什么是回表操作?它为什么重要?并给出相关的代码案例来辅助说明。
面试题重点:
- 理解回表操作的概念及其重要性。
- 掌握减少回表操作的方法。
- 能够通过代码案例来辅助说明回表操作及其优化方法。
面试题内容:
解释回表操作:
回表操作,简单来说,就是MySQL在非主键索引(如普通索引)查询过程中,需要先通过索引找到对应的主键值,再根据这个主键值回到主键索引(也称聚簇索引)中去查找完整行数据的过程。这就好比我们在图书馆查找书籍,先通过目录找到书的编号,然后再根据编号去书架上找到书一样。
为什么重要:
回表操作的重要性在于,它会影响查询的性能。每次回表,都需要额外的主键索引查找操作,这无疑会增加查询的复杂度和时间。因此,在设计和优化数据库时,我们需要尽量减少回表操作,以提高查询效率。
如何减少回表操作:
覆盖索引:创建包含所有查询列的索引,使得查询可以直接通过索引返回结果,无需回表。 选择合适的索引:根据查询模式,选择能够最大化减少回表操作的索引。 优化查询语句:避免不必要的查询列,以减少回表的可能性。
代码示例
假设我们有一个用户表 users,结构如下:
CREATE TABLE users (
    user_id INT PRIMARY KEY,
    username VARCHAR(50),
    email VARCHAR(100),
    age INT,
    INDEX idx_email (email)  -- 创建一个普通索引
);
现在,我们执行以下查询:
SELECT user_id, username FROM users WHERE email = 'example@example.com';在这个查询中,MySQL首先通过 idx_email 索引找到符合条件的 email 值对应的 user_id,然后需要回表查找 username 列的数据。这就是一次回表操作。
为了优化这个查询,我们可以创建一个覆盖索引:
CREATE INDEX idx_email_username ON users (email, username);然后再次执行查询:
SELECT user_id, username FROM users WHERE email = 'example@example.com';这次,MySQL可以直接通过 idx_email_username 索引返回 user_id 和 username 列的数据,无需回表。
面试者如何回答:
当面试官问到这个问题时,面试者可以先简要解释回表操作的概念,然后强调它的重要性(影响查询性能)。接着,可以介绍一些减少回表操作的方法,如覆盖索引、选择合适的索引以及优化查询语句等。最后,通过具体的代码案例来辅助说明,让面试官更加直观地理解回表操作及其优化方法。
什么是联合索引,组合索引,复合索引?
面试官提问背景:
面试官:在MySQL数据库优化中,索引的使用是绕不开的话题。而在索引的众多类型中,联合索引(也被称为组合索引、复合索引)是一个非常实用的工具,它能帮助我们显著提升查询性能。今天,我想请你详细解释一下,什么是联合索引?它在MySQL中是如何工作的?以及,为什么我们要使用联合索引?同时,希望你能给出一个具体的代码案例,来加深我们对这个概念的理解。
面试题重点:
- 理解联合索引(组合索引、复合索引)的概念。
- 掌握MySQL中联合索引的工作原理和“最左前缀”原则。
- 了解联合索引的优点和使用场景。
- 能够通过代码案例来辅助说明联合索引的使用方法和效果。
面试题内容:
解释联合索引(组合索引、复合索引):
联合索引,组合索引,复合索引,其实说的都是一回事,它们都是指在一个表上创建包含多个列的索引。这样的索引在查询时,能够同时利用多个列的值来快速定位数据,从而显著提升查询性能。
MySQL中联合索引的工作原理:
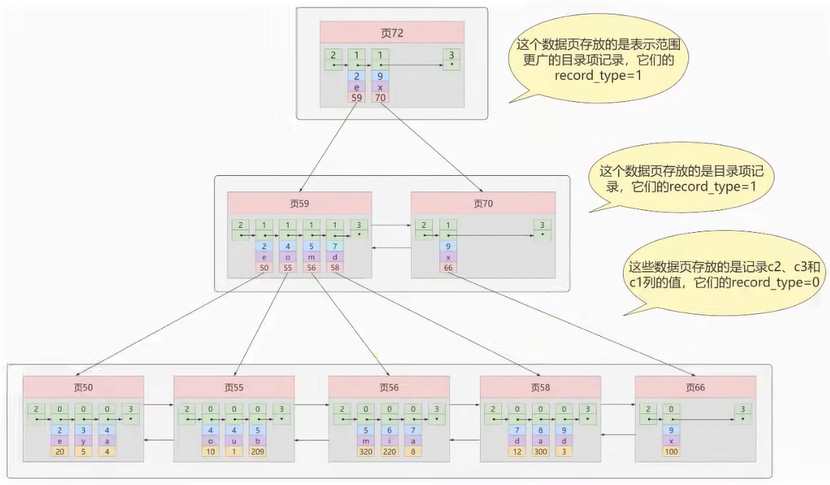
在MySQL中,联合索引的存储顺序是按照索引定义时的列顺序来的。当我们进行查询时,MySQL会按照索引的存储顺序,依次比较查询条件中的列值,来快速定位数据。需要注意的是,联合索引的使用是“最左前缀”原则,即查询条件必须包含索引最左边的列,才能利用到索引。
为什么使用联合索引:
- 提高查询性能:通过利用多个列的值来快速定位数据,联合索引能够显著提升查询性能。
- 减少索引数量:如果我们对多个列分别创建单列索引,那么查询时可能会使用到多个索引,但这会增加索引的维护成本。而联合索引则可以将多个列合并到一个索引中,从而减少索引数量。
- 优化排序和分组:在某些情况下,联合索引还可以帮助我们优化排序和分组操作。
代码案例:
假设我们有一个订单表 orders,结构如下:
CREATE TABLE orders (
    order_id INT PRIMARY KEY,
    user_id INT,
    product_id INT,
    order_date DATE,
    amount DECIMAL(10, 2),
    INDEX idx_user_product (user_id, product_id)  -- 创建一个联合索引
);
现在,我们执行以下查询:
SELECT * FROM orders WHERE user_id = 100 AND product_id = 200;在这个查询中,MySQL会利用 idx_user_product 联合索引来快速定位数据。因为查询条件 user_id = 100 AND product_id = 200 正好符合联合索引的“最左前缀”原则。
面试者如何回答:
当面试官问到这个问题时,面试者可以先简要解释联合索引(组合索引、复合索引)的概念,然后详细介绍MySQL中联合索引的工作原理,包括“最左前缀”原则等。接着,可以阐述联合索引的优点,如提高查询性能、减少索引数量、优化排序和分组等。最后,通过具体的代码案例来辅助说明联合索引的使用方法和效果。
在回答过程中,面试者可以结合实际的工作经验,分享一些在使用联合索引时遇到的常见问题和解决方案,以展示自己的实践能力和对MySQL索引机制的深入理解。
什么时候适合创建索引,什么时候不适合创建索引?
面试官提问背景:
面试官:在MySQL数据库优化中,索引的使用是至关重要的。索引能够显著提升查询性能,但也会带来一些额外的开销。因此,合理地创建索引是非常重要的。今天,我想请你详细谈谈,在哪些情况下适合创建索引,哪些情况下不适合创建索引?同时,希望你能结合具体的代码案例来说明你的观点。
面试题的重点:
理解索引的适用场景和限制条件。 能够根据具体的业务需求和数据库操作特点,合理地创建索引。 掌握如何避免创建不必要的索引,以减少数据库的开销。
面试题内容:
适合创建索引的情况:
- 查询频繁的列: 如果某个列在查询中经常被用作条件(如WHERE子句)、排序(如ORDER BY子句)或分组(如GROUP BY子句),那么应该为该列创建索引。
- 区分度高的列: 区分度是指某个列中不同值的数量与总记录数的比值。区分度越高的列,创建的索引效果越好。例如,用户ID通常具有较高的区分度。
- 多表连接时的连接列: 在JOIN操作中,连接条件中的列应该创建索引,以加速表之间的连接过程。
- 唯一性约束的列: 如果某个列需要保证数据的唯一性,那么应该为该列创建唯一索引。
代码案例
-- 为用户ID创建索引,用户ID在查询中经常被用作条件
CREATE INDEX idx_user_id ON users(user_id);

-- 为订单金额创建索引,订单金额在排序和分组中经常被使用
CREATE INDEX idx_order_amount ON orders(amount);

-- 为用户表和订单表的连接列创建索引
CREATE INDEX idx_user_orders_user_id ON orders(user_id);
CREATE INDEX idx_user_orders_user_id_on_users ON users(user_id);

-- 为邮箱地址创建唯一索引,保证邮箱地址的唯一性
CREATE UNIQUE INDEX idx_unique_email ON users(email);
不适合创建索引的情况:
- 更新频繁的列:如果某个列经常被更新,那么为该列创建索引会带来额外的开销,因为每次更新都需要维护索引。
- 低区分度的列:如果某个列中的值大多相同或相似,那么该列的区分度较低,创建索引的效果不明显。
- 文本列:对于长文本列,创建索引会占用大量的存储空间,并且查询性能提升有限。
- 频繁插入和删除的表:对于频繁进行插入和删除操作的表,索引的维护成本较高,可能会影响性能。
代码案例(反例)
-- 不建议为频繁更新的状态列创建索引
-- 假设status列经常从'pending'变为'completed'
-- CREATE INDEX idx_status ON orders(status);  -- 不推荐

-- 不建议为低区分度的性别列创建索引
-- 假设gender列只有两个值:'male'和'female'
-- CREATE INDEX idx_gender ON users(gender);  -- 不推荐

-- 不建议为长文本列创建索引
-- 假设description列存储了产品的详细描述
-- CREATE INDEX idx_description ON products(description);  -- 不推荐
面试官为什么问这个问题:
面试官希望了解面试者对MySQL索引机制的理解程度,以及在实际项目中如何合理地创建索引来优化数据库性能。通过这个问题,面试官可以评估面试者的数据库优化能力和实践经验。
面试者如何回答:
当面试官问到这个问题时,面试者可以先简要介绍索引的基本概念和作用,然后详细阐述适合创建索引和不适合创建索引的情况。在阐述过程中,可以结合具体的代码案例来说明自己的观点。同时,面试者还可以分享一些在实际项目中创建索引的经验和教训,以展示自己的实践能力和对数据库优化方面的深入理解。
在回答过程中,面试者应该注重逻辑性和条理性,确保自己的回答清晰明了、易于理解。同时,也要积极与面试官进行互动和交流,以展示自己的沟通能力和团队协作精神。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2024-11-20,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号