看了24届的形势,25届开始迷茫。。

看了24届的形势,25届开始迷茫。。

Python编程爱好者
发布于 2023-09-20 19:00:17
发布于 2023-09-20 19:00:17
Hi,大家好,我是Johngo~
今天和一个25届的学弟聊了好久,他应该是明年校招!
上来就是一顿输出,本科期间自学了机器学习,但是在学习过程中,逐渐的迷茫。。
听了他的经历,和我当初真是如出一辙,很多想法和遭遇都非常相似!
几个原因吧,也有可能也是大家面临的。
第一个,没有人引导,没有团体一起向前,也就是没有一个明确的整体思路;
第二个,单枪匹马,毫无章法!
所谓“一个人可以走的很快,但一般不会长久”,这种感觉一直围绕着他,导致现在的想法和动力方向越来越模糊。
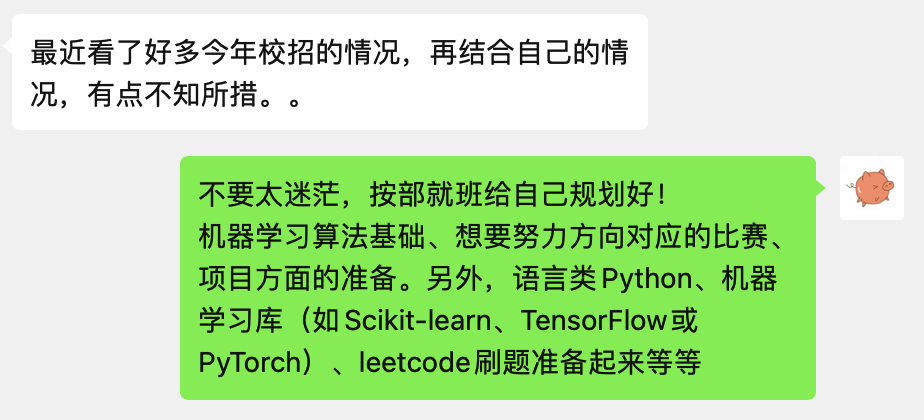
看了23届和24届在网上的言论,顿时感觉如果对待25届的校招,有点不知所措!
未曾经历,只能尽力!
在此期间的一切迷茫实属正常情况,但静下心来想想,过去我们已经经历了的很多困难的时刻,不也都近乎完美的过去了吗?
对于还未曾经历校招的同学,我这里给到大家的几点小建议。
以下建议针对算法和数据同学,其他方向的同学把专业知识换为服务端内容、前端内容即可!
大概包括了知识理论、项目经验、面试准备和个人能力展示等等。
1、知识理论:机器学习和相关领域的基本原理、算法和模型。统计学、线性代数、概率论等基础数学知识,常见的机器学习算法和深度学习框架要动手实现。
2、实践项目:通过完成实际项目来展示你的技能。实际项目可能来源于学校,也有可能来源于实习。将项目经验详细记录,可以在准备面试时介绍和讨论。
3、开源贡献:有时间有精力一定要积极参与开源社区,为开源项目提交代码或解决问题。提高编程能力+对于开源的态度。
4、算法和数据结构:算法和数据结构是编程思维训练必不可少的一环,这是大厂校招中常见的考点。复习排序、查找、图算法等常用算法,很清晰的可以判断其时间复杂度和空间复杂度。
5、代码实现:算法方向来说,前期Python必会,熟悉C++,相对熟练地实现机器学习算法和数据处理流程。动手利用常用的机器学习库(如Scikit-learn、TensorFlow或PyTorch)解决实际问题。
6、其他:关注上面的建议点、适当锻炼表达能力,有利于在面试中洒脱的交流。
总结一句话:多学习、多动手、有机会多实习!
另外,今天总结了必会的10大机器学习算法,包括可以直接运行的代码,帮助快速理解!
点赞收藏,转发给你旁边的那个同学!
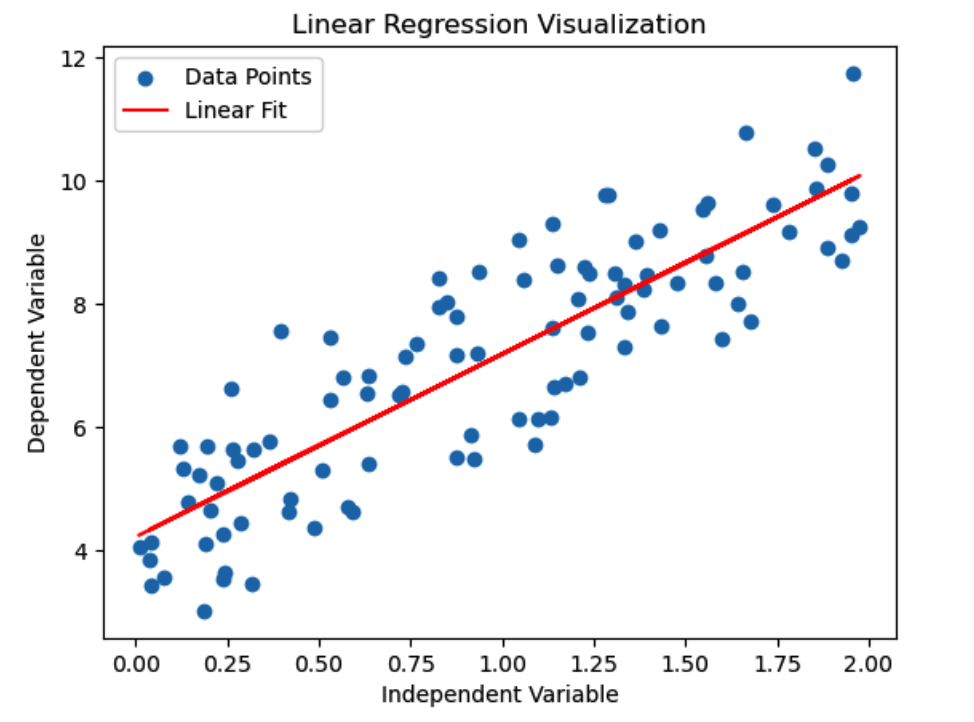
1、线性回归
线性回归是一种常见的统计分析方法,用于建立自变量(或特征)与因变量之间的线性关系模型。
它通常用于预测或解释两个或多个变量之间的关系。
公式表示:
其中:
是因变量(要预测的变量)。
是自变量(特征)。
是截距(模型在
都等于零时的预测值)。
是各个自变量的系数,表示它们对因变量的影响程度。
是误差项,表示模型无法完美地解释的部分。
线性回归的目标是通过拟合系数
来最小化误差项
,从而找到最佳拟合线性关系。
举个Python栗子:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression

# 创建一些示例数据
np.random.seed(0)
X = 2 * np.random.rand(100, 1)
y = 4 + 3 * X + np.random.randn(100, 1)

# 创建线性回归模型并拟合数据
model = LinearRegression()
model.fit(X, y)

# 获取拟合的系数
beta0 = model.intercept_
beta1 = model.coef_

# 绘制数据点和拟合直线
plt.scatter(X, y, label='Data Points')
plt.plot(X, beta0 + beta1 * X, color='red', label='Linear Fit')
plt.xlabel('Independent Variable')
plt.ylabel('Dependent Variable')
plt.legend()
plt.title('Linear Regression Visualization')
plt.show()
2、逻辑回归
逻辑回归是一种广泛用于分类问题的统计分析方法。
与线性回归不同,逻辑回归用于预测一个二元分类问题的概率。
它的输出是一个介于0和1之间的概率值,表示某个样本属于某一类别的概率。
逻辑回归使用的模型称为“逻辑函数”或“Sigmoid函数”,通常表示为:
其中:
是样本属于类别1的概率。
是特征或自变量。
是模型的系数,需要从训练数据中学习。
通过训练逻辑回归模型,我们可以找到最佳的系数来拟合训练数据,从而用于分类新的样本。
举个Python栗子:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression

# 生成示例数据
np.random.seed(0)
X = np.random.randn(100, 2)
y = (X[:, 0] + X[:, 1] > 0).astype(int)

# 创建逻辑回归模型并拟合数据
model = LogisticRegression()
model.fit(X, y)

# 生成一个复杂的图形以可视化决策边界
xx, yy = np.meshgrid(np.linspace(-3, 3, 500), np.linspace(-3, 3, 500))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

plt.contourf(xx, yy, Z, cmap=plt.cm.RdBu, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.RdBu, edgecolor='k')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.title('Logistic Regression Decision Boundary')
plt.show()
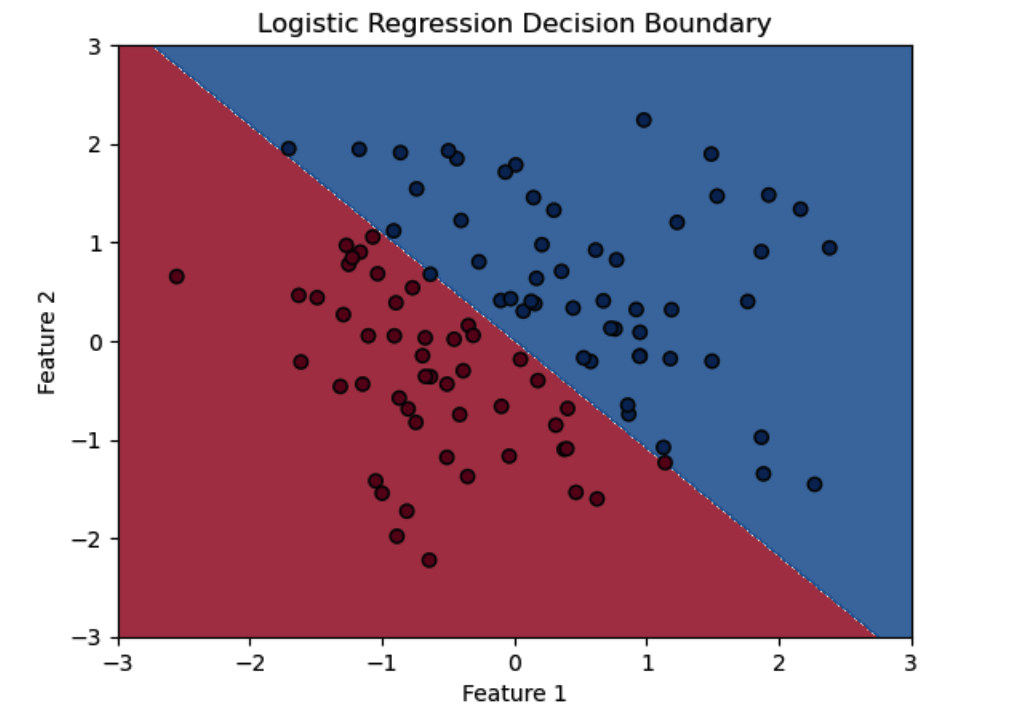
这段代码首先生成了一个示例数据集,然后使用LogisticRegression模型拟合数据。
接下来,它创建了一个复杂的图形,显示了决策边界,即模型预测样本属于两个类别的概率如何划分特征空间。
3、决策树
决策树是一种常用的机器学习算法,用于解决分类和回归问题。
它是一种基于树状结构的模型,通过一系列的决策规则来对数据进行分类或预测。
决策树的基本思想: 通过一系列问题或测试,将数据划分为不同的类别或值。每个决策节点代表一个问题或测试,每个分支代表一个可能的答案,而每个叶节点代表一个类别或值的预测。
决策树的建立过程通常包括以下步骤:
1、选择最佳的特征(问题或测试),以将数据划分为不同的子集。
2、递归地对每个子集应用步骤1,直到达到停止条件(例如,达到最大深度、子集中的样本数小于某个阈值等)。
3、在每个叶节点上分配一个类别标签(分类问题)或一个数值(回归问题),这是预测的结果。
决策树的模型可以用以下伪代码表示:
if 某个特征 <= 阈值:
    则进入左子树
else:
    则进入右子树
举个Python栗子,使用Scikit-Learn库的决策树分类器,并使用matplotlib进行可视化:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.tree import DecisionTreeClassifier, plot_tree

# 生成示例数据
X, y = make_classification(n_samples=100, n_features=2, n_informative=2, n_redundant=0, random_state=42)

# 创建决策树分类器
clf = DecisionTreeClassifier(max_depth=3, random_state=42)
clf.fit(X, y)

# 绘制决策树图形
plt.figure(figsize=(10, 6))
plot_tree(clf, filled=True, feature_names=['Feature 1', 'Feature 2'], class_names=['Class 0', 'Class 1'])
plt.title('Decision Tree Visualization')
plt.show()
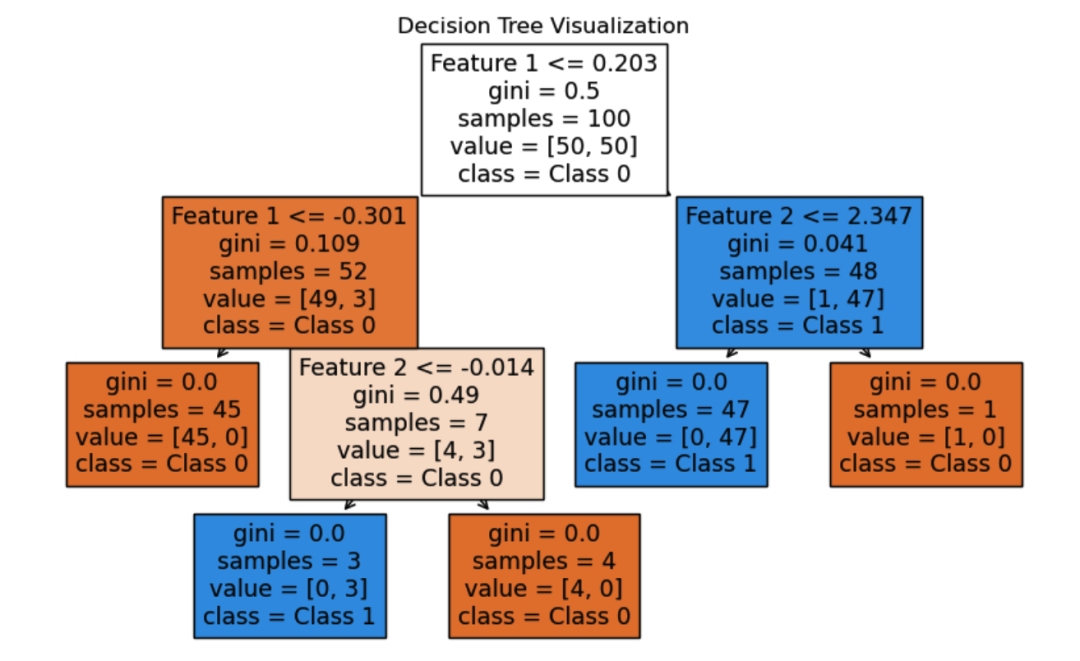
这段代码首先生成了一个示例的分类数据集,然后创建了一个深度限制为3的决策树分类器并拟合数据。
最后,使用plot_tree函数绘制决策树的图形表示,包括决策规则和叶节点的类别标签。
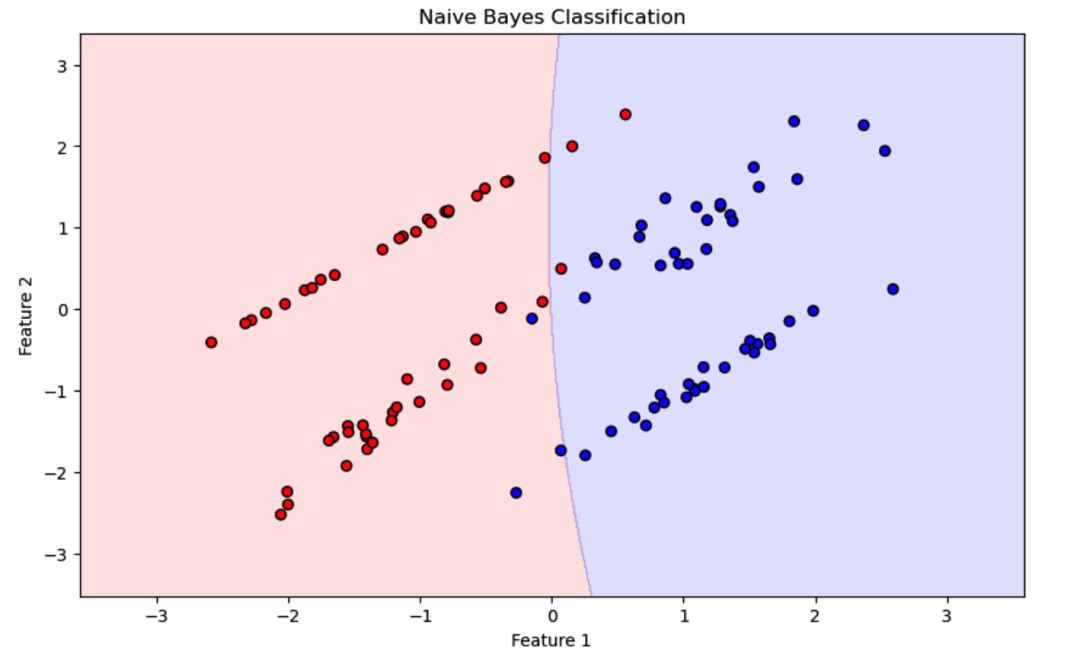
4、朴素贝叶斯
朴素贝叶斯(Naive Bayes)是一种基于贝叶斯定理的分类算法,它被广泛用于文本分类和垃圾邮件检测等应用中。
朴素贝叶斯的“朴素”之处在于它假设各个特征之间是条件独立的,这意味着每个特征对于分类的贡献是独立的,这是一个简化假设,因此称为“朴素”。
贝叶斯定理: 贝叶斯定理用于计算在给定某个特征(或条件)的情况下,发生某个事件的概率。
对于分类问题,我们可以使用贝叶斯定理来计算每个类别的后验概率,然后选择具有最高后验概率的类别作为预测结果。
朴素贝叶斯的分类模型可以表示为以下公式:
其中:
是在给定特征
的情况下,类别
的后验概率。
是在类别
的情况下,特征
的似然概率。
是类别
的先验概率。
是特征
的边缘概率。
朴素贝叶斯通过计算每个类别的后验概率,然后选择具有最高后验概率的类别作为预测结果。
举个Python栗子,使用Scikit-Learn库的朴素贝叶斯分类器,并使用matplotlib进行可视化:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.naive_bayes import GaussianNB
from matplotlib.colors import ListedColormap

# 生成示例数据
X, y = make_classification(n_samples=100, n_features=2, n_informative=2, n_redundant=0, random_state=42)

# 创建朴素贝叶斯分类器
clf = GaussianNB()
clf.fit(X, y)

# 绘制分类结果
cmap_background = ListedColormap(['#FFAAAA', '#AAAAFF'])
cmap_points = ListedColormap(['#FF0000', '#0000FF'])

x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.01), np.arange(y_min, y_max, 0.01))
Z = clf.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

plt.figure(figsize=(10, 6))
plt.contourf(xx, yy, Z, cmap=cmap_background, alpha=0.3)
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=cmap_points, edgecolor='k')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.title('Naive Bayes Classification')
plt.show()
这段代码首先生成了一个示例的分类数据集,然后创建了一个朴素贝叶斯分类器并拟合数据。
最后,使用contourf函数绘制了分类结果的可视化图形,其中不同的颜色表示不同的类别。
5、支持向量机(SVM)
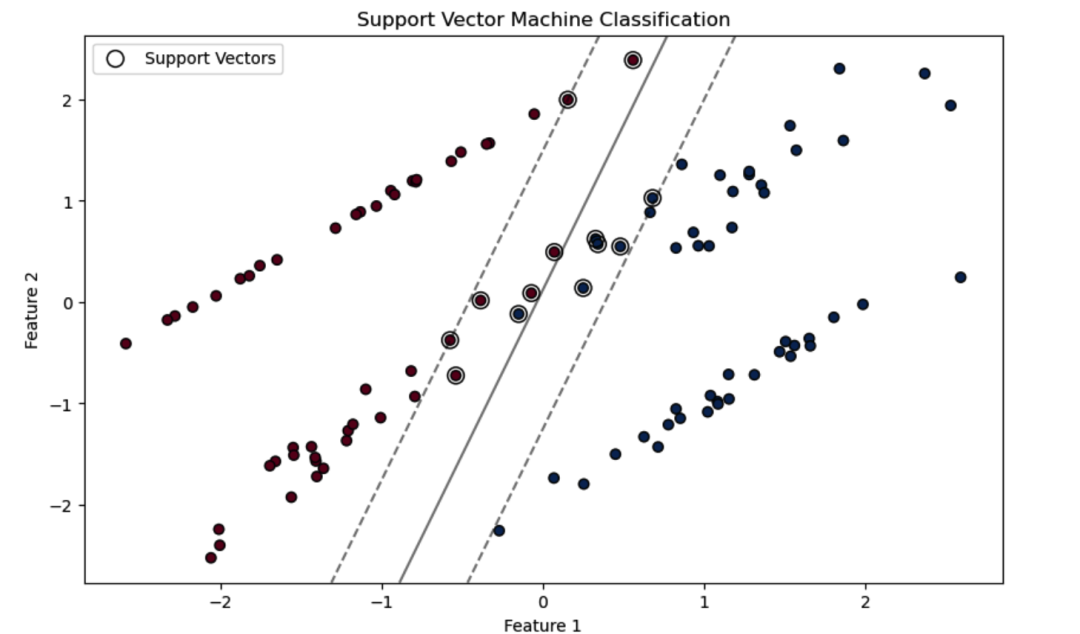
支持向量机(Support Vector Machine,SVM)是一种强大的监督学习算法,用于解决分类和回归问题。
它的主要思想是找到一个能够最大化两个不同类别之间的间隔(Margin)的超平面,从而使分类更加准确。SVM特别适用于高维空间中的数据分类和非线性问题。
SVM的基本思想: SVM试图找到一个超平面,它能够将不同类别的数据分隔开,并且离该超平面最近的数据点(支持向量)距离该超平面的间隔最大。这个间隔被称为"Margin"。
SVM的分类模型可以表示为以下公式:
其中:
是预测的类别。
是超平面的法向量。
是输入特征向量。
是偏置项。
SVM的目标是找到最佳的
和
,以最大化Margin,并满足以下条件:
这个不等式表示了支持向量的Margin必须大于等于1。
举个Python栗子:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.svm import SVC

# 生成示例数据
X, y = make_classification(n_samples=100, n_features=2, n_informative=2, n_redundant=0, random_state=42)

# 创建支持向量机分类器
clf = SVC(kernel='linear')
clf.fit(X, y)

# 绘制分类结果
plt.figure(figsize=(10, 6))

# 绘制数据点
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.RdBu, edgecolor='k')

# 绘制超平面和支持向量
ax = plt.gca()
xlim = ax.get_xlim()
ylim = ax.get_ylim()

xx, yy = np.meshgrid(np.linspace(xlim[0], xlim[1], 50), np.linspace(ylim[0], ylim[1], 50))
Z = clf.decision_function(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

plt.contour(xx, yy, Z, colors='k', levels=[-1, 0, 1], alpha=0.5, linestyles=['--', '-', '--'])

# 标记支持向量
plt.scatter(clf.support_vectors_[:, 0], clf.support_vectors_[:, 1], s=100, facecolors='none', edgecolors='k', marker='o', label='Support Vectors')

plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.title('Support Vector Machine Classification')
plt.legend()
plt.show()
这段代码首先生成了一个示例的分类数据集,然后创建了一个SVM分类器并拟合数据。
最后,使用contour函数绘制了超平面、支持向量和分类结果的可视化图形。
这个图形有助于理解SVM是如何找到最大Margin的超平面以进行分类的。
6、K-最近邻算法(KNN)
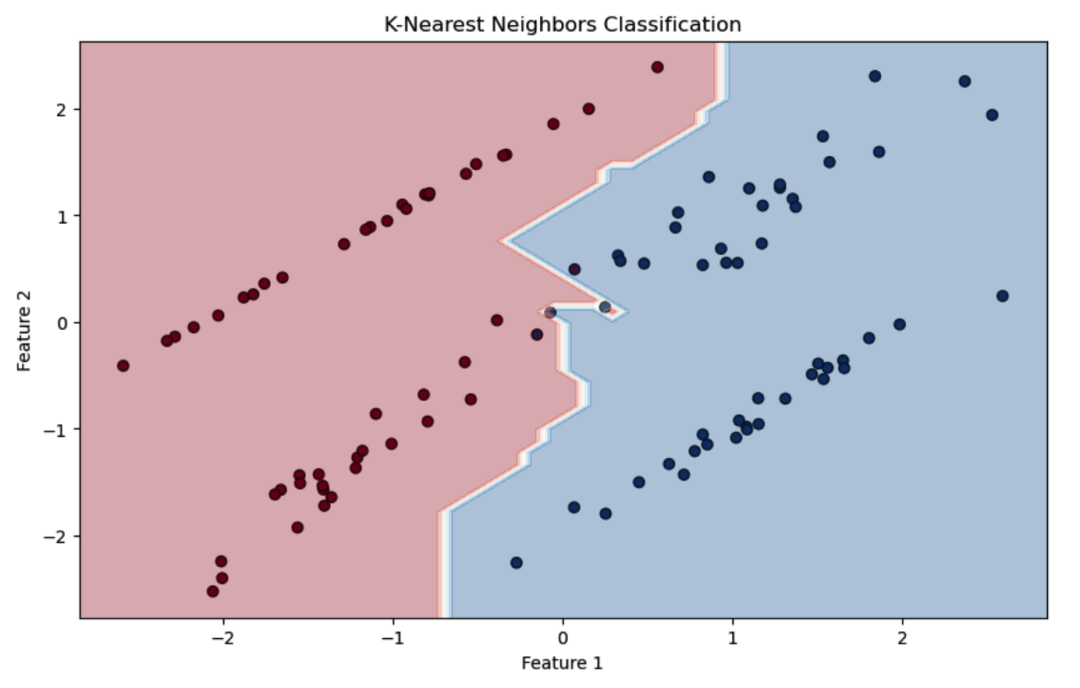
K-最近邻算法(K-Nearest Neighbors,K-NN)是一种简单而有效的监督学习算法,用于分类和回归问题。
它的核心思想是基于训练数据集中与新样本最接近的K个邻居的类别来对新样本进行分类或预测。
K-NN算法不需要训练模型,而是在预测时直接利用训练数据。
K-NN的基本思想: 对于分类问题,K-NN算法基于投票机制,将新样本的类别设为其K个最近邻居中最多的类别。对于回归问题,K-NN算法基于平均值或加权平均值来估计新样本的目标值。
K-NN的分类模型可以表示为以下公式:
对于分类问题,对于新样本
,其类别
为:
其中:
是新样本的类别。
是K个最近邻居的类别。
是指示函数,如果条件成立则为1,否则为0。
举个Python栗子,使用Scikit-Learn库的K-NN分类器,并使用matplotlib进行可视化:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.neighbors import KNeighborsClassifier

# 生成示例数据
X, y = make_classification(n_samples=100, n_features=2, n_informative=2, n_redundant=0, random_state=42)

# 创建K-NN分类器
clf = KNeighborsClassifier(n_neighbors=3)
clf.fit(X, y)

# 绘制分类结果
plt.figure(figsize=(10, 6))

# 绘制数据点
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.RdBu, edgecolor='k')

# 绘制决策边界
ax = plt.gca()
xlim = ax.get_xlim()
ylim = ax.get_ylim()

xx, yy = np.meshgrid(np.linspace(xlim[0], xlim[1], 50), np.linspace(ylim[0], ylim[1], 50))
Z = clf.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

plt.contourf(xx, yy, Z, cmap=plt.cm.RdBu, alpha=0.3)

plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.title('K-Nearest Neighbors Classification')
plt.show()
这段代码首先生成了一个示例的分类数据集,然后创建了一个K-NN分类器并拟合数据。
最后,使用contourf函数绘制了决策边界和分类结果的可视化图形。
7、K- 均值
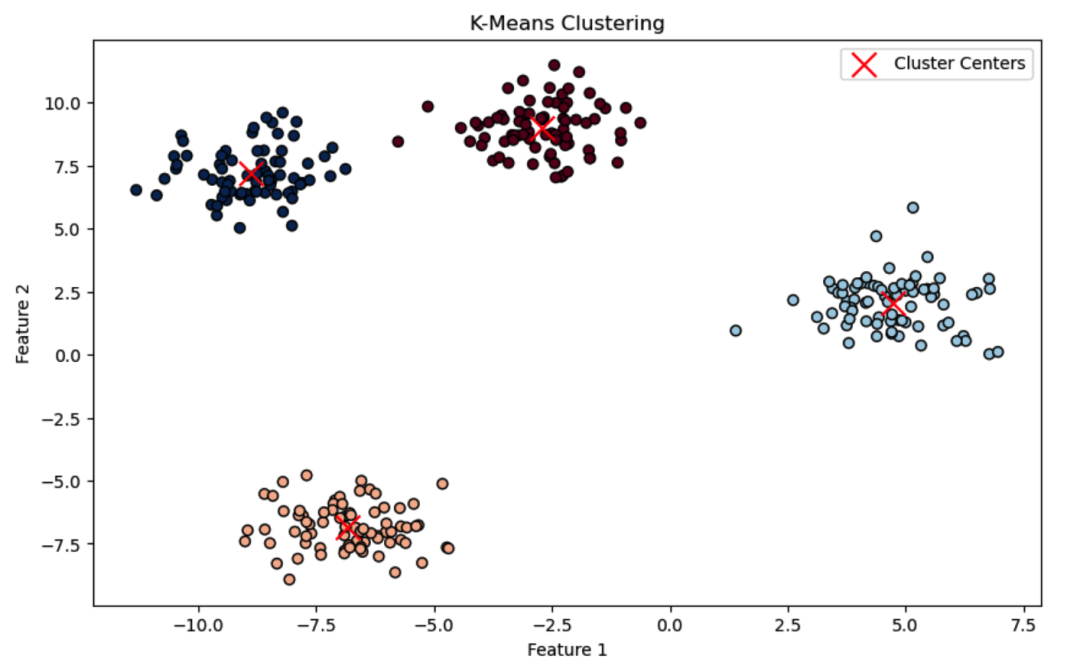
K-均值(K-Means)是一种聚类算法,用于将数据集中的样本划分为K个不同的簇,每个簇包含相似的数据点。
K-均值算法的目标是最小化每个簇内样本之间的平均距离,同时最大化不同簇之间的距离。
K-均值的基本思想: K-均值算法将数据点分配给离它们最近的簇中心,然后通过将每个簇的中心更新为其成员的平均值来迭代地优化簇的分配。这个过程不断迭代,直到簇分配和簇中心不再变化,或者达到预定的迭代次数。
K-均值的算法流程如下:
1、随机初始化K个簇中心。
2、将每个数据点分配给离它最近的簇中心。
3、更新每个簇的中心为其成员的平均值。
4、重复步骤2和3,直到簇分配不再变化或达到预定的迭代次数。
K-均值的目标函数可以表示为以下公式:
其中:
是目标函数,也称为簇内平方和(WCSS)。
是簇的数量。
是数据点的数量。
是数据点。
是第
个簇的中心。
举个Python栗子,以下是使用Python绘制K-均值聚类结果的示例代码,使用Scikit-Learn库的KMeans聚类器,并使用matplotlib进行可视化:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans

# 生成示例数据
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# 创建KMeans聚类器
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# 绘制聚类结果
plt.figure(figsize=(10, 6))

# 绘制数据点
plt.scatter(X[:, 0], X[:, 1], c=kmeans.labels_, cmap=plt.cm.RdBu, edgecolor='k')

# 绘制簇中心
plt.scatter(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:, 1], c='red', marker='x', s=200, label='Cluster Centers')

plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.title('K-Means Clustering')
plt.legend()
plt.show()
这段代码首先生成了一个示例的聚类数据集,然后创建了一个KMeans聚类器并拟合数据。
最后,使用scatter函数绘制了数据点和簇中心的可视化图形。这个图形有助于理解K-均值是如何将数据点分配到簇中的,并找到簇的中心。
8、随机森林
随机森林(Random Forest)是一种强大的集成学习算法,用于解决分类和回归问题。
它基于决策树构建,并通过组合多个决策树的预测结果来提高模型的准确性和稳定性。
随机森林的核心思想是通过随机抽取样本和特征来构建多个决策树,然后对这些树的结果进行投票或平均来进行预测。
随机森林的基本思想: 随机森林的主要特点包括随机抽取训练样本(自助采样)和随机选择特征。这两个随机性来源使得每个决策树都是略有不同的,从而减小了模型的过拟合风险。最后,随机森林综合了所有决策树的结果,以提高预测的准确性。
随机森林的分类模型通常采用投票法,对每个决策树的预测结果进行投票,选择得票最多的类别作为最终预测结果。对于回归问题,通常采用平均法,对每个决策树的预测结果进行平均得到最终预测值。
随机森林的基本思想可以表示为以下公式:
对于分类问题,最终预测结果
为:
其中:
是最终预测的类别。
是第
棵树的预测类别。
是决策树的数量。
是指示函数,如果条件成立则为1,否则为0。
举个Python栗子,使用Scikit-Learn库的随机森林分类器,并使用matplotlib进行可视化:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.ensemble import RandomForestClassifier
from matplotlib.colors import ListedColormap

# 生成示例数据
X, y = make_classification(n_samples=100, n_features=2, n_informative=2, n_redundant=0, random_state=42)

# 创建随机森林分类器
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X, y)

# 绘制分类结果
plt.figure(figsize=(10, 6))

# 绘制数据点
plt.scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.RdBu, edgecolor='k')

# 绘制决策边界
ax = plt.gca()
xlim = ax.get_xlim()
ylim = ax.get_ylim()

xx, yy = np.meshgrid(np.linspace(xlim[0], xlim[1], 500), np.linspace(ylim[0], ylim[1], 500))
Z = clf.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

plt.contourf(xx, yy, Z, cmap=plt.cm.RdBu, alpha=0.3)

plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.title('Random Forest Classification')
plt.show()
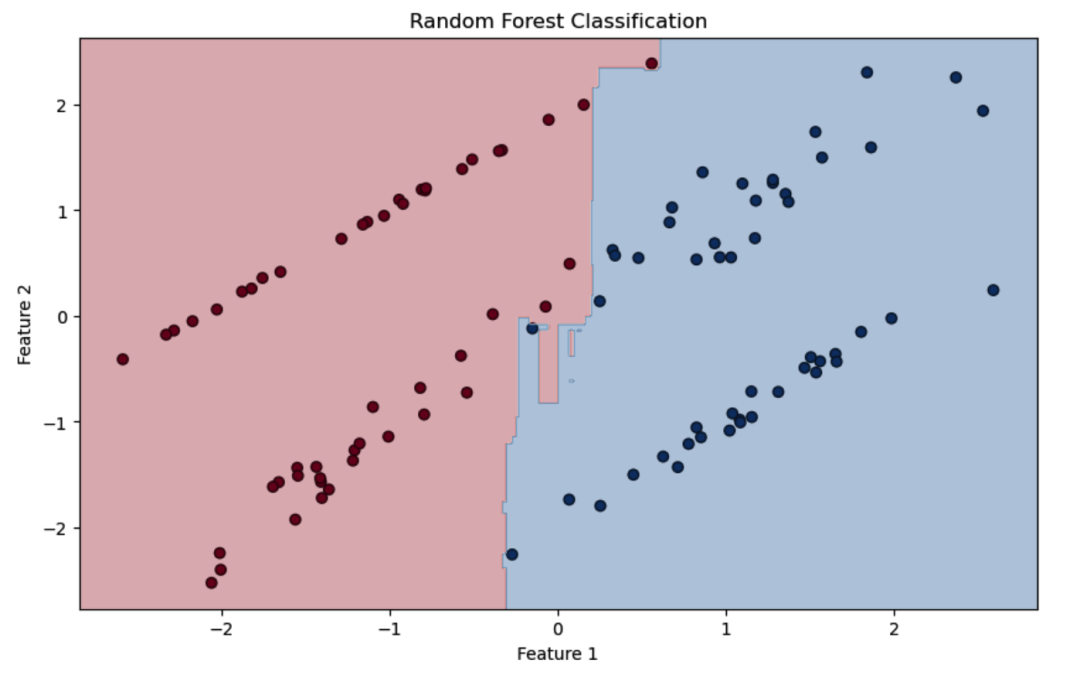
这段代码首先生成了一个示例的分类数据集,然后创建了一个随机森林分类器并拟合数据。
最后,使用contourf函数绘制了分类结果的可视化图形。
9、降维
降维是指减少数据的维度,即减少数据中特征的数量。在机器学习和数据分析中,降维通常用于以下几个目的:
- 数据可视化: 将高维数据映射到二维或三维空间,以便更容易理解和可视化数据。
- 特征选择: 从原始特征集中选择最相关或最有信息量的特征,以提高模型性能和减少过拟合。
- 降低计算复杂度: 减少特征数量可以大幅减少模型训练和预测的计算成本。
- 去除冗余: 去除高度相关的特征,减少数据中的冗余信息。
最常见的降维方法包括主成分分析(PCA)和线性判别分析(LDA)等。
主成分分析(PCA) 是一种常用的降维方法,它通过线性变换将原始数据投影到一个新的坐标系中,以最大化数据的方差。PCA的目标是找到一组新的特征(主成分),这些特征之间互不相关,并且能够捕捉数据中的最大方差。PCA的公式如下:
对于一个数据矩阵
,其均值为
,PCA的第一个主成分
可以通过以下公式计算:
其中
是一个单位向量,表示第一个主成分的方向。
举个Python栗子,以下是使用Python绘制PCA降维效果的示例代码,使用Scikit-Learn库的PCA。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.decomposition import PCA

# 生成示例数据
X, y = make_classification(n_samples=100, n_features=2, n_informative=2, n_redundant=0, random_state=42)

# 创建PCA模型
pca = PCA(n_components=1)
X_pca = pca.fit_transform(X)

# 绘制降维结果
plt.figure(figsize=(10, 6))
plt.scatter(X_pca, np.zeros_like(X_pca), c=y, cmap=plt.cm.RdBu, edgecolor='k')
plt.xlabel('Principal Component 1')
plt.title('PCA Dimensionality Reduction')
plt.show()
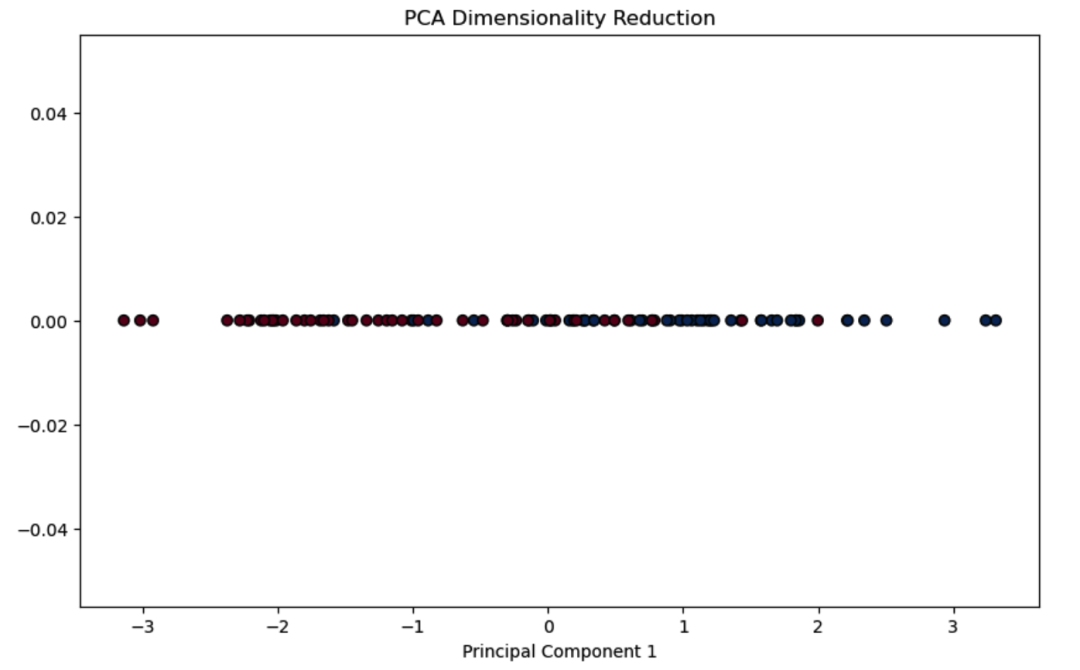
这段代码首先生成了一个示例的分类数据集,然后创建了一个PCA模型并拟合数据。
最后,使用scatter函数绘制了降维后的数据点。这个图形有助于理解PCA是如何将数据从二维降维到一维的。
10、人工神经网络(ANN)
人工神经网络(Artificial Neural Network,简称ANN)是一种受到生物神经系统启发而创建的机器学习模型。它由多个人工神经元(也称为节点或神经元)组成,这些神经元相互连接以形成一个网络。
ANN被广泛用于各种任务,包括图像识别、自然语言处理、模式识别、预测等。
下面是一个简单的ANN的结构示意图:
输入层 -> 隐藏层 -> 输出层
每个神经元都有一个权重(weight)和一个激活函数(activation function)。ANN的工作原理可以总结如下:
- 输入层:接受来自外部的输入数据,每个输入特征与一个输入层神经元相关联。
- 隐藏层:包含一个或多个层次的神经元,用于学习输入数据的复杂特征。每个隐藏层神经元都与上一层的所有神经元相连接,并且具有各自的权重和激活函数。
- 输出层:输出神经元产生模型的最终输出,通常用于执行分类或回归任务。
ANN的每个神经元的激活函数可以是不同的,但最常见的激活函数之一是sigmoid函数:
sigmoid(x) = 1 / (1 + e^(-x))
ANN通过训练来学习权重,以最小化预测输出与实际输出之间的差距。这通常涉及到反向传播算法(Backpropagation),其中模型的误差信号被反向传播到网络中,以更新权重。
举个Python栗子,以下使用Python和NumPy库创建简单的ANN示例代:
import numpy as np

# 定义sigmoid激活函数
def sigmoid(x):
    return 1 / (1 + np.exp(-x))

# 创建一个简单的ANN
class NeuralNetwork:
    def __init__(self, input_size, hidden_size, output_size):
        # 初始化权重和偏差
        self.weights_input_hidden = np.random.randn(input_size, hidden_size)
        self.bias_hidden = np.zeros((1, hidden_size))
        self.weights_hidden_output = np.random.randn(hidden_size, output_size)
        self.bias_output = np.zeros((1, output_size))

    def forward(self, X):
        # 前向传播
        self.hidden_input = np.dot(X, self.weights_input_hidden) + self.bias_hidden
        self.hidden_output = sigmoid(self.hidden_input)
        self.output = np.dot(self.hidden_output, self.weights_hidden_output) + self.bias_output
        return self.output

# 创建一个简单的ANN实例
input_size = 2
hidden_size = 3
output_size = 1
ann = NeuralNetwork(input_size, hidden_size, output_size)

# 进行前向传播
X = np.array([[0.5, 0.6]])
output = ann.forward(X)

print("模型的输出:", output)
这个示例演示了一个包含一个输入层、一个隐藏层和一个输出层的简单ANN的前向传播过程。
可以根据需要修改网络的结构和参数,以适应不同的问题。
通过调整权重和激活函数,ANN可以学习并适应各种复杂的数据模式。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2023-09-15 16:26,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号