
如何用包含特殊字符的名字重命名熊猫?
我正在阅读excel文件,并将内容转储到熊猫数据文件中。我正在使用sqlalchemy将整个数据上传到MySQL数据库中。
功能上一切正常,但是当我试图上传一个excel文档时遇到了一个问题,其中列中包含%符号。
我的一个函数用行重命名dataframe的标题,删除行,然后重新索引。
当我试图读取这个数据时,它会抛出一个错误,即存在一个非法的十六进制字符(%)- -这是正确的。
我不想修改这个列名,因为它是如何在我上传的excel文件中出现的,而且数据库希望它保持不变。
我怎样才能让熊猫数据文件接受列名中的特殊(%)字符?例如:“销售总额的百分比”
example data:
         [0]           [1]
    [0] Sales | Sales % of Total
    [1] $100  |        50%

dataframe.rename(columns=dataframe.iloc[0]).drop(dataframe.index[0]).reset_index(drop=True)

expected output:
       [Sales]  [Sales % of Total]
    [0] $100  |        50%
抛出错误:
URLDecover:转义(%)模式中的非法十六进制字符-索引0处的错误
回答 2
Stack Overflow用户
发布于 2019-07-19 00:44:37
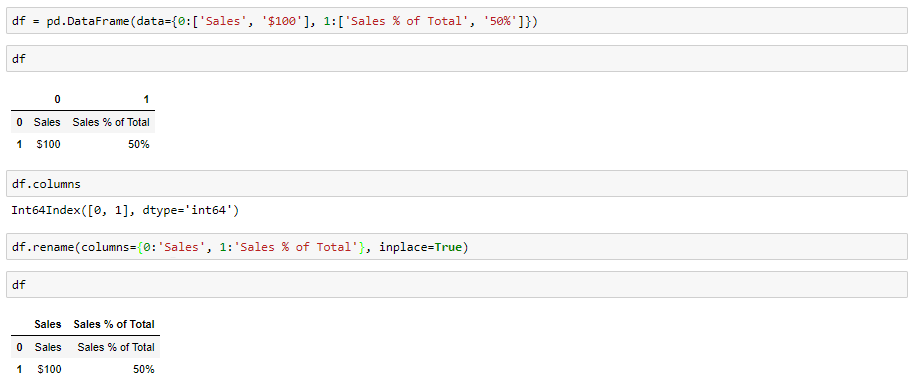
试试这个(用'df‘代替你的数据被称为“df”:
df.rename(columns={0:'Sales', 1:'Sales % of Total'}, inplace=True)详情见下面的图片。
Stack Overflow用户
发布于 2019-07-19 15:48:02
您也可以简单地使用
df.columns = ['Sales','Sales % of Total']若要根据需要定义列名,请执行以下操作。
您还可以考虑在读取excel文件时使用此技巧,以避免重命名标题、删除和重新编制索引的步骤。
Python pandas, How could I read excel file without column label and then insert column label?
https://stackoverflow.com/questions/57103260
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号