
选择重复项会使每个查询得到不同的结果计数。
目前,我正在尝试删除MySQL 5.7 (InnoDB)中的重复行,并通过运行SELECT COLUMN, COUNT(*) FROM TABLE GROUP BY COLUMN HAVING COUNT(*) > 1来检查是否有多少重复的mediumtext列。最近返回的查询:
[results]
31620 rows in set (17.98 sec)
如果稍后运行完全相同的查询,我会得到:
[results]
31594 rows in set (17.35 sec)诸若此类。我几乎每次都得到不同的结果。查询期间没有任何东西写入数据库。它只对此查询执行此操作;SELECT COUNT(*) FROM TABLE、SELECT COUNT(*) FROM TABLE WHERE COLUMN LIKE <VALUE>等都会产生一致的结果。在执行SELECT COLUMN, COUNT(*) FROM TABLE GROUP BY COLUMN HAVING COUNT(*) > 0.时也不会发生此错误。
我不知道还提供了哪些其他代码来帮助回答这个问题,因为这是我正在运行的唯一查询,而且我正在控制台中执行它。我在想什么能解释这件事。考虑到我对同一个数据库拥有的other problems,我想知道是否有什么东西被破坏了。
编辑:,我运行了1000个查询来对结果进行示例,结果如下所示:
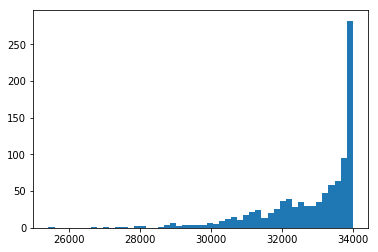
33991的上限是最常见的结果。
表的字符集是utf8mb4,正在聚合的列的排序规则是utf8mb4_general_ci。
EXPLAIN SELECT COLUMN, COUNT(*) FROM COLUMN GROUP BY COLUMN HAVING COUNT(*) > 1;在使用MyISAM时的输出:
+----+-------------+-------+------------+------+---------------+------+---------+------+--------+----------+---------------------------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows   | filtered | Extra                           |
+----+-------------+-------+------------+------+---------------+------+---------+------+--------+----------+---------------------------------+
|  1 | SIMPLE      | TABLE  | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 788685 |   100.00 | Using temporary; Using filesort |
+----+-------------+-------+------------+------+---------------+------+---------+------+--------+----------+---------------------------------+
InnoDB的结果:
+----+-------------+-------+------------+------+---------------+------+---------+------+--------+----------+---------------------------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows   | filtered | Extra                           |
+----+-------------+-------+------------+------+---------------+------+---------+------+--------+----------+---------------------------------+
|  1 | SIMPLE      | TABLE  | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 769501 |   100.00 | Using temporary; Using filesort |
+----+-------------+-------+------------+------+---------------+------+---------+------+--------+----------+---------------------------------+
到目前为止,我在评论中已经尝试过的东西
- Memtest,使用
memtestLinux包并运行memtest 15G 2(系统有16G内存,15.4可用,并使用.4。这是一台云机器,我无法用Memtest启动,尽管我已经向提供者提交了一个请求,以查看它们是否可以启动。 - 启用一般日志,它显示查询之间没有运行其他活动。
- 使用
OPTIMIZE TABLE。 - 下降并重新添加索引。
- 将表引擎从MyISAM更改为InnoDB,这似乎有点帮助,因为查询经过几次查询后达到了最大限制,但对于最初的几个查询,它仍然会弹来跳去。
回答 2
Stack Overflow用户
发布于 2019-07-15 08:05:13
我对mysql的有限知识触发了我对文本类型列的理解,我认为在文本类型列中,表中的默认存储大小是256,其余的文本大小存储在一些内部临时mysql表中。而且,由于mysql和mysql服务器的"max_allowed_packet“属性不同,所以我认为,每次mysql服务器向客户端发送不同的完整文本子集时,都有可能出现这种不明确的情况。
您应该能够为您的mysql客户端增加"max_allowed_packet“属性,并验证您是否确实获得了一致的结果。
Stack Overflow用户
发布于 2019-07-17 02:40:22
POSSIBLE KEYS  |   KEY
NULL          |  NULL
它显示,当您执行group时,您没有使用任何索引。在该列中添加特定索引。
https://stackoverflow.com/questions/56982039
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号