
在使用groupby并应用时,为多个索引中的一个索引创建一个新级别
我在Python3 / Pandas工作。我有一个多索引的DataFrame :数据源('src')、日期('dt')和状态('stat')。有一个名为“val”的任意测量列。目前,“状态”索引(['gain', 'loss', 'current'])有三个级别。我想要创建第四个级别'net',它将反映所有测量/列的‘增益’级别和‘损失’级别之间的差异(目前只有val,b/c,这是本例中唯一的列)。我会叫这个新的'stat‘级'net’。
--我可以想出扩大DataFrame的解决方案,但是当原始的DataFrame包含许多度量列时,这是不可取的。对于我的实际数据集,是这样的,尽管这个例子没有反映这一点。因此,答案应该推广到许多度量列,而不仅仅是示例'val' df**.**中的列。
以下是我目前的尝试:
from datetime import datetime
import random as rd
import pandas as pd

# create the levels for the multiindex
u_source = ['src1','src2']
u_date = pd.date_range(end=datetime.today(), freq='1D', periods=3).date
u_status = ['current','gain','loss']
idx = pd.MultiIndex.from_product(
    [u_source, u_date, u_status],
    names = ['src', 'dt', 'stat']
)

# create the measurement values
rd.seed(42)
vals = [rd.randint(0,9) for _ in range(len(idx))]
vals2 = [rd.randint(0,9) for _ in range(len(idx))]

# create the dataframe from the multiindex
# and measurement values
df = pd.DataFrame({'val':vals, 'val2':vals2}, index=idx)

# function to create measurement values that
# reflect differences in vals between
# two levels of a particular index in a multiindex
# Operates on a groupby object
def get_net(gb):
    new = gb.loc[(slice(None),slice(None),'gain'), :]
    new.rename(index={'gain':'net'}, inplace=True)
    lost = gb.loc[(slice(None),slice(None),'loss'), :]
    lost.rename(index={'loss':'net'}, inplace=True)

    nn = new - lost
    # pd.merge(gb, nn, how='outer') # doesn't work
    return nn # doesn't recombine with other levels, creates extra columns


# group by src and dt
# per each source and date,
# take the difference in val
# between stat=gain and stat=loss,
# label that difference as stat=net
df_gb = df.groupby(['src','dt']) # groupby
ans = df_gb.apply(get_net) # apply func to gb
ans
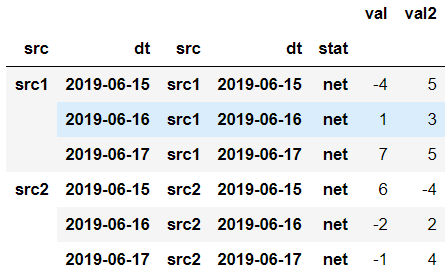
我可以做这个计算。但是,我当前的输出有两个不可取的方面。首先,群中使用的多指标'src‘和'dt’的两个指标在输出多指标中被重复。第二,我仍然想要原始索引的“val”列.但是“stat”(“增益”、“损失”、“当前”)的原始级别都在输出中下降。
如何防止多索引中的索引重复,并保留所有原始索引级别和相关值?
回答 1
Stack Overflow用户
发布于 2019-06-14 18:54:59
按以下评论。
您需要as_index = False作为groupby的参数
df_gb = df.groupby(['src','dt'], as_index=False)另一种方式。
更健壮和更通用的代码:
df.unstack().stack(0).eval('net = gain - loss').unstack().stack(0)你想要这样的东西吗?
df.unstack()['val'].eval('net = gain - loss').stack().to_frame(name='value')输出:
value
src dt stat
src1 2019-06-12 current 1
gain 0
loss 4
net -4
2019-06-13 current 3
gain 3
loss 2
net 1
2019-06-14 current 1
gain 8
loss 1
net 7
src2 2019-06-12 current 9
gain 6
loss 0
net 6
2019-06-13 current 0
gain 1
loss 3
net -2
2019-06-14 current 3
gain 8
loss 9
net -1
https://stackoverflow.com/questions/56603675
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号