
Kubernetes引擎: Node不断变得不健康,并且无缘无故地重新启动。
我的Kubernetes引擎集群一直在重新启动我的一个节点,尽管节点上的所有豆荚都是“行为良好”的。我试过查看集群的Stackdriver日志,但是找不到原因。过了一段时间,连续的重新启动通常会停止,几个小时或几天后才会再次发生。
通常只有一个节点会受到影响,而其他节点则会受到影响,但是删除该节点并在其位置创建一个新节点只是暂时的帮助。
我已经禁用了节点自动修复功能,以查看这是否会产生影响(它以前是打开的),并且我还记得在将集群升级到Kubernetes 1.13 (特别是版本1.13.5-gke)之后启动的。这个问题在升级到1.13.6-gke.0之后一直存在。甚至创建一个新的节点池并迁移到它也没有任何效果。
集群由四个节点组成,每个节点有1个CPU和3GB RAM。我知道这对于一个k8s集群来说是很小的,但是这在过去是很好的。
我正在使用新的Stackdriver监控以及在GKE上的Istio。
任何关于什么可能是原因或我在哪里寻找可能的原因的建议,我们将不胜感激。
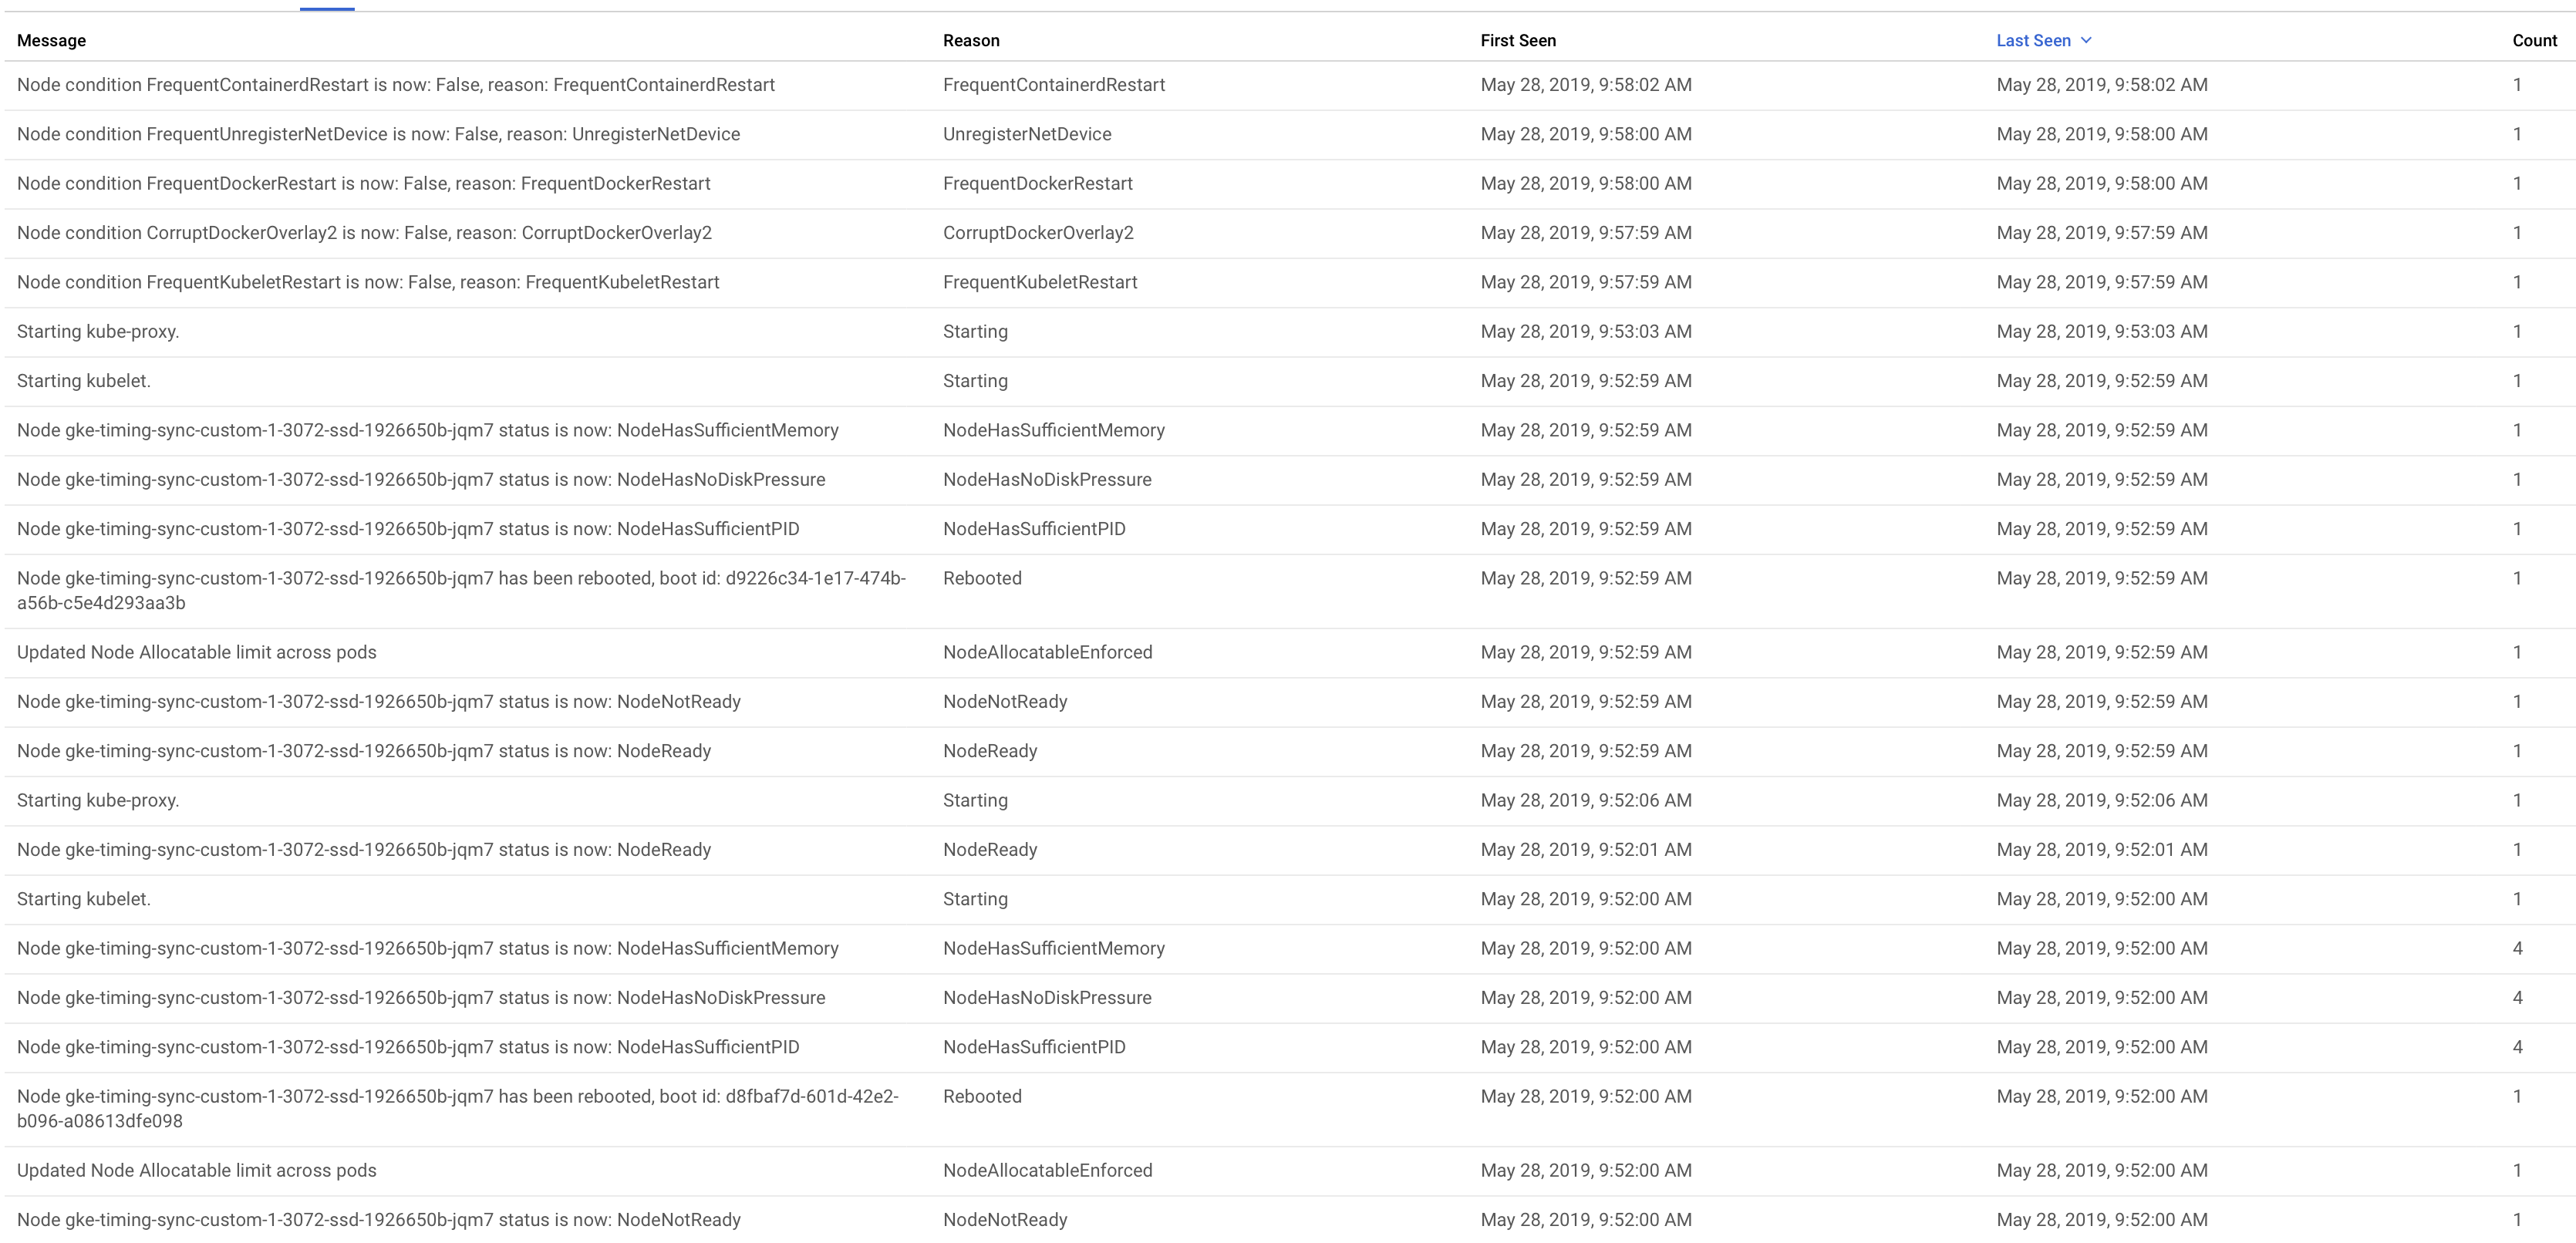
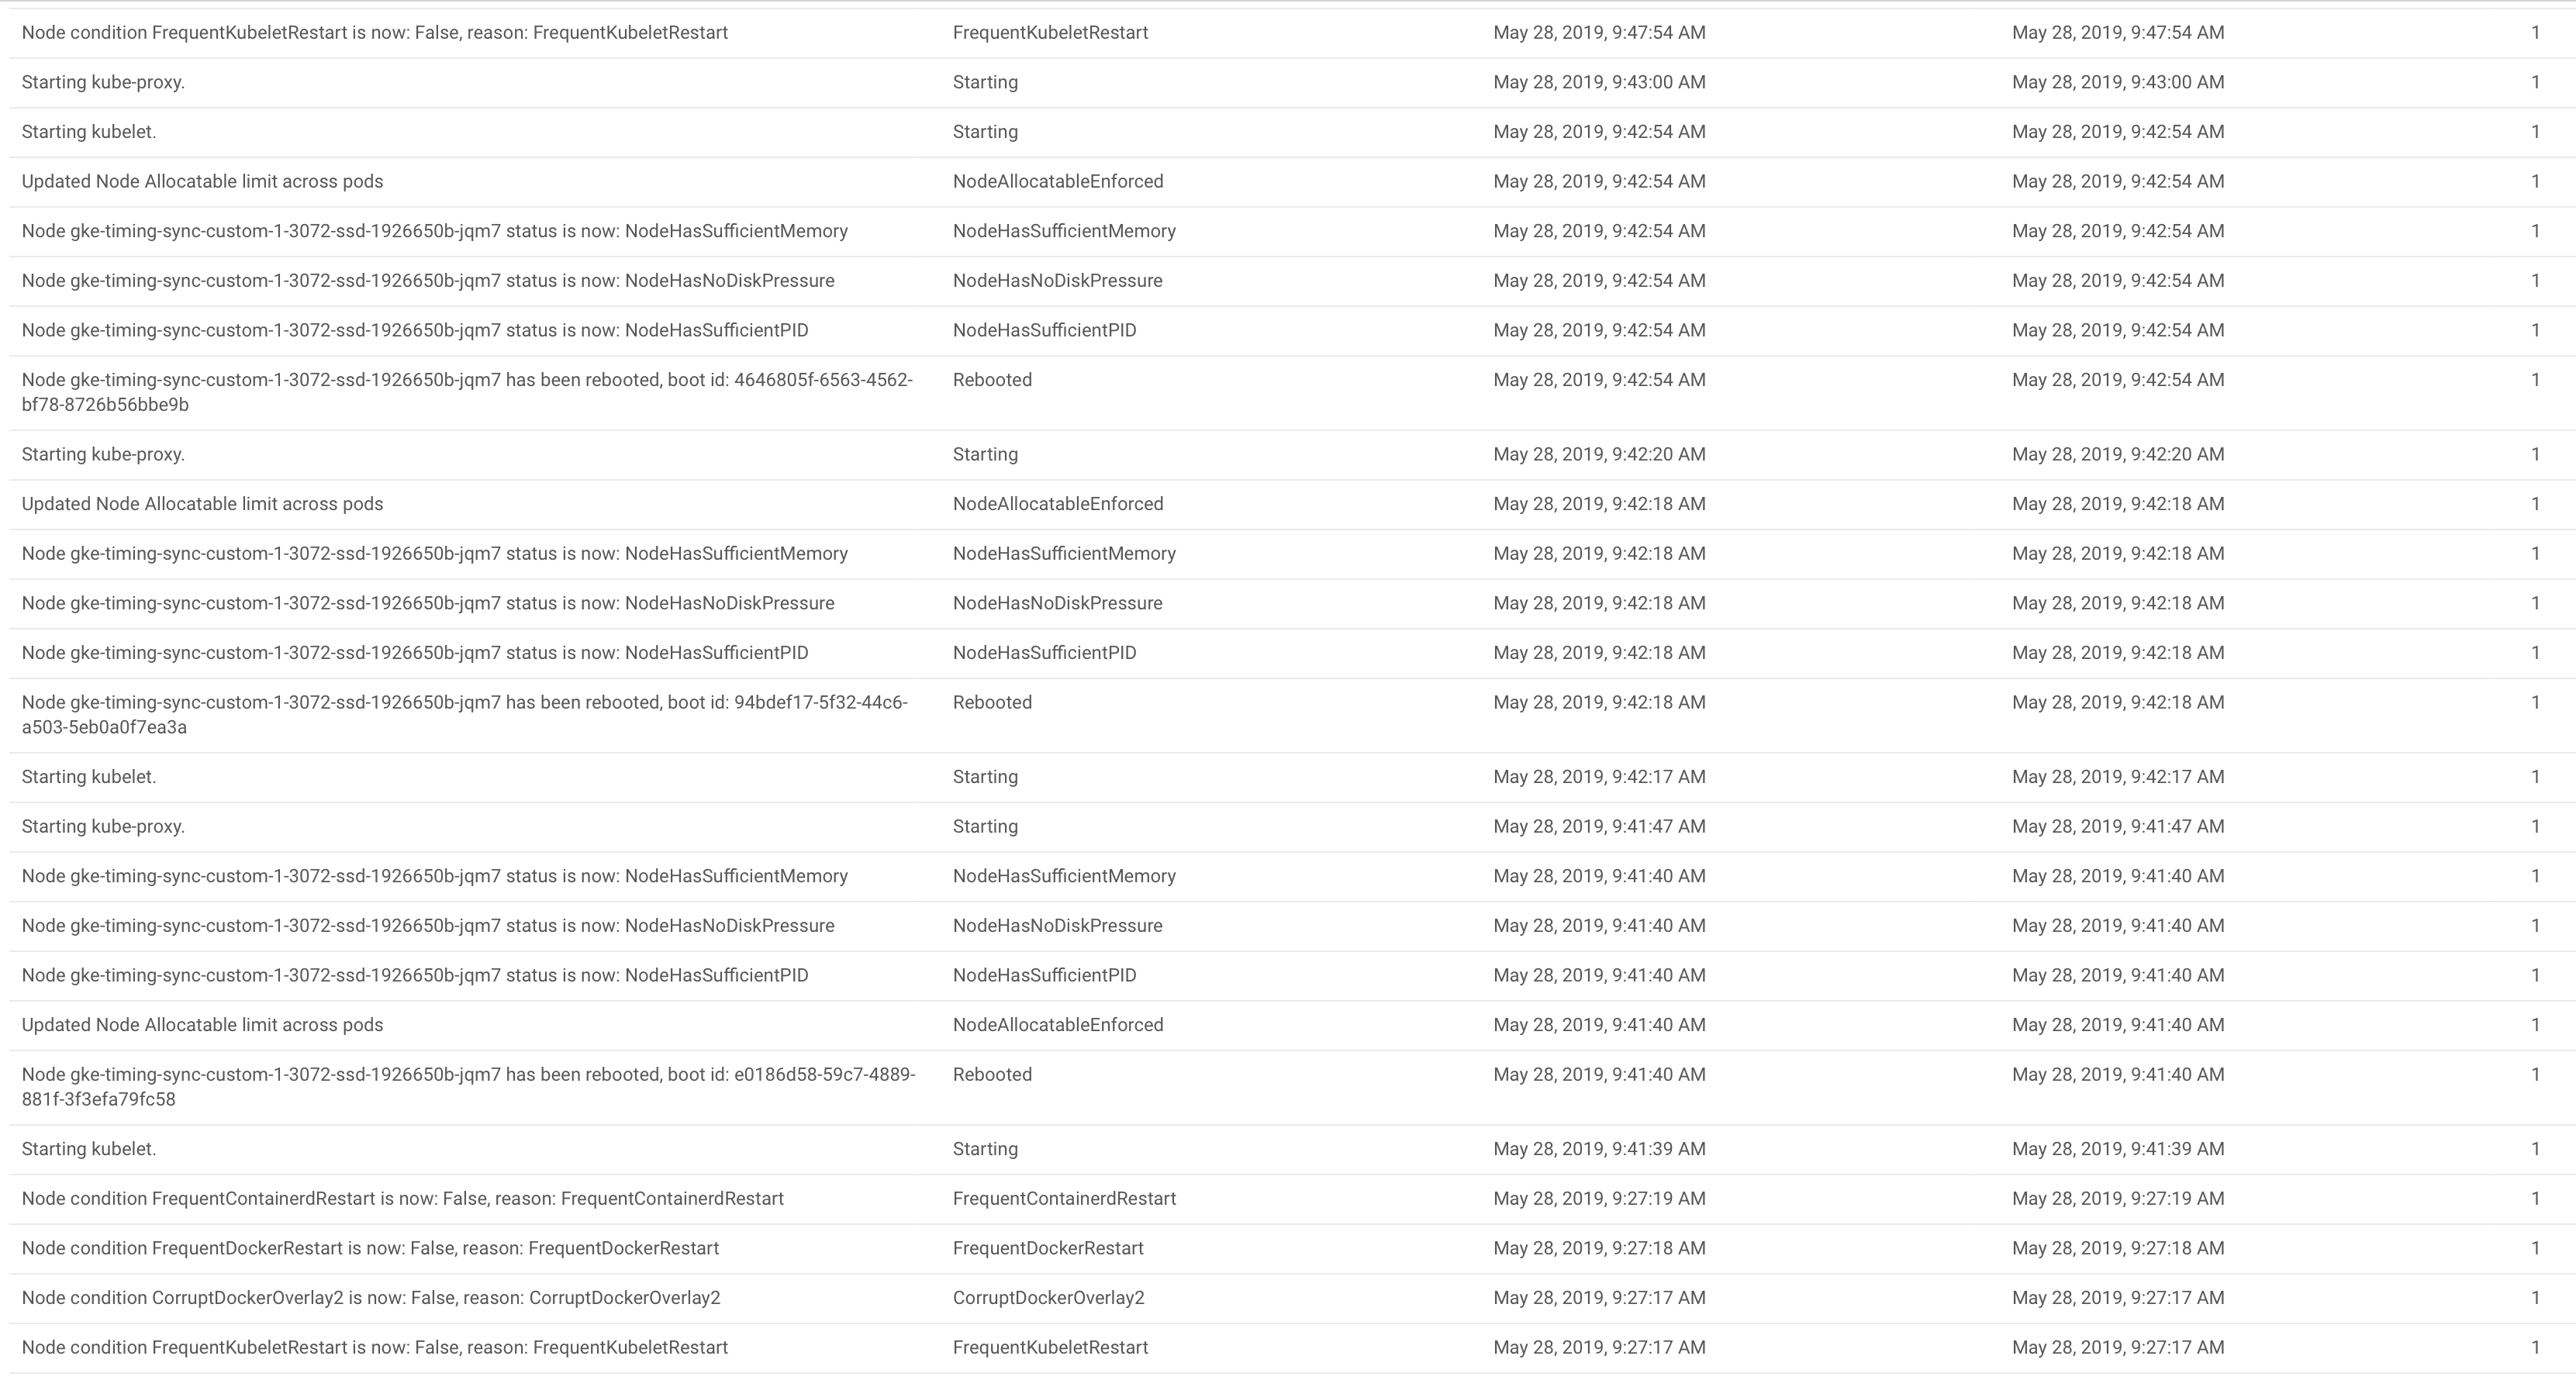
Node事件列表的屏幕截图(乐于提供其他日志;在Stackdriver中找不到任何有意义的内容):
回答 1
Stack Overflow用户
发布于 2020-11-23 09:08:03
将这个答案作为一个社区wiki发布,给出一些疑难解答技巧/步骤,因为根本的问题是找不到的。
可以自由地扩展它。
在以下步骤之后,节点重新启动的问题不再存在:
- 更新了Kubernetes版本(
GKE) - 卸载
Istio - 使用
e2-medium实例作为节点。
正如user @aurelius指出的那样:
我会从发布
kubectl describe node开始,也许在节点重新启动和不健康之前发生了一些事情。你也使用资源和限制吗?这种重新启动是否是一些可负担的工作负荷的结果?另外,在节点重新启动后,您是否尝试过检查系统日志?你能把结果贴出来吗?-奥雷利乌斯6月7日下午15:38
以上评论可能是解决集群问题的良好起点。
对注释中指出的群集进行故障排除的选项:
- 专注于输出的
$ kubectl describe node:Conditions-KubeletReady,KubeletHasSufficientMemory,KubeletHasNoDiskPressure等。- 调度工作负载的
Allocated resources-Requests和Limits
- 在节点重新启动后检查系统日志:
GCP Cloud Console(Web ) ->Logging->Legacy Logs Viewer/Logs Explorer->VM Instance/GCE Instance
检查CPU/RAM在下列文件中的使用情况也可能是受益方:
GCP Cloud Console(Web ) ->Monitoring->Metrics Explorer
您还可以检查集群上是否有任何操作:
gcloud container operations list
除上述各点外:
在GKE上使用Istio创建集群 我们建议在使用此加载项时至少创建一个具有2机器类型的4节点集群。您可以使用默认的GKE新集群设置来部署Istio本身,但这可能无法提供足够的资源来探索示例应用程序。 -- https://cloud.google.com/istio/docs/istio-on-gke/installing#creating_a_cluster_with_istio_on_gke
此外,Istio的官方文件指出:
CPU和内存 因为sidecar代理在数据路径上执行额外的工作,所以它消耗CPU和内存。从Istio1.7开始,代理每秒消耗0.5 vCPU / 1000次请求。 -- https://istio.io/latest/docs/ops/deployment/performance-and-scalability/#cpu-and-memory
追加资源:
https://stackoverflow.com/questions/56457129
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号