
这种分类有名字吗?
我写了/用了这种分类。我只是想知道它是否有任何名称,或者它是否类似于现有的任何排序算法。顺便问一下,它是否有效率/价值?
int s = 20;

int unsorted_array[s];

//(adding numbers to unsorted_array)
//We assume that every number is different to avoid any difficulties.

int i, i2, pos;
int sorted_array[s];

//!!! sorting algo starts here:

for(i=0; i<s; i++){
   pos = 0;
   for(i2=0; i2<s; i2++){

      if(unsorted_array[i] > unsorted_array[i2]){
         pos += 1;
      }
   }

   sorted_array[pos] = unsorted_array[i];

}
你怎么看?它是否比其他类型的排序方法慢/快?我还在学习。谢谢你的回复!
回答 3
Stack Overflow用户
发布于 2019-05-12 00:02:32
在我看来,这是一种逆向选择。选择排序会说:“哪个元素位于0位置?”然后找到那个元素。您的排序似乎是在说“当前处于0位置的元素在哪里?”,这也是一个同样有效的问题。
就复杂性而言,它肯定是O(n^2),它与其他“低效”方案(如插入、选择、气泡等)相提并论,并将其置于更复杂的“更好”方案(如合并或快速)之下。我最关心的问题是,您实际上是在迭代n^2时间,而插入或选择之类的算法可以避免使用n (n + 1) / 2 (三角形数,而不是正方形数),后者是相同的复杂性类,但总体上是较小的数目。另外,您的排序要求我们在内存中找到一个新的数组,而许多现有的数组(特别是插入和选择,因为它们与您的数组比较接近)可以在常量空间中完成,而无需再分配任何数组。
Stack Overflow用户
发布于 2019-05-12 00:00:35
它是否比其他类型的排序方法慢/快?
让我们分析一下该函数的时间复杂度。当未排序列表的大小增加时,它需要做多少工作?
重要的部分是循环。他们会告诉我们你需要做多少次,这才是最重要的。你的循环可以分解成这样:
for(1 to s){
   for(1 to s){
       do that thing
   }
}对于每个元素,它必须重新检查每个元素。如果有两个项目,这意味着你做了4次。3项,9次。4项,16次。我们说时间复杂度是n^2 (n是大小的惯例),因为随着大小的增加,步骤的数量被平方。这意味着,随着尺寸的增加,所需时间将呈指数级增长。在10个项目,它需要100次。100件就得花10,000件。1,000,000,000美元。如果可能的话,应该避免n^2。
大多数排序算法可以在n * log(n)或准线性时间内完成他们的工作。随着规模的增加,时间将由n * log(n)增长。这比线性快,但比指数慢。log(n)通常是自然对数或ln(n)。在10个项目,它将花费大约23次。100大约460。1000,大约6900。所以你的算法比较慢。
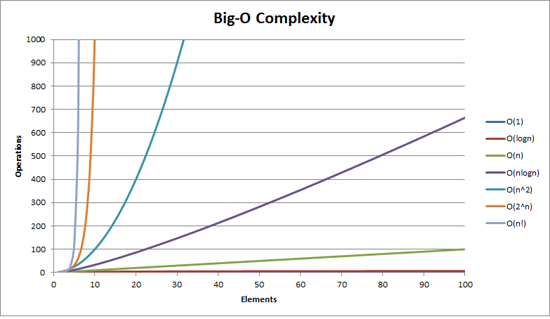
n * log(n)之上的算法增长得如此之快,因此有必要扭曲垂直时间尺度,以便用性能更好的算法对它们进行有意义的匹配。
您可以猜到,对于大量的项目来说,有一个更好的执行算法比更快地完成任务更重要。一个比n^2算法快100倍的n log n算法将在大约600个条目上丢失。
n^2 = 100 n * ln(n)
n = 100 ln(n)
n / ln(n) = 100Stack Overflow用户
发布于 2019-05-12 00:01:17
这是通过为数组中的每个元素查找小于它的元素数来实现的。这相当于找到它的最后位置。
慢的是O(n*n) (有很好的O(n*lg(n))算法)。但是有很多O(n*n)排序算法,所以你的公司很好。
它也只有独特的价值,这是一个相当严重的限制。
它还需要第二个数组来复制它,而大多数排序算法没有,因此这是另一个负点。
从好的方面看,它可以实现零交换,并且只有很少的实际拷贝(实际上就是n ),这在某些情况下可能是件好事,但这是一个非常小的加点。
https://stackoverflow.com/questions/56095119
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号