
如何在xmm寄存器中旋转填充四字?
给定一个包含两个四字(即两个64位整数)的128位xmm寄存器:
     ╭──────────────────┬──────────────────╮
xmm0 │ ffeeddccbbaa9988 │ 7766554433221100 │
     ╰──────────────────┴──────────────────╯
如何对单个四字进行旋转?例如:
prorqw xmm0, 32   // rotate right packed quadwords

     ╭──────────────────┬──────────────────╮
xmm0 │ bbaa9988ffeeddcc │ 3322110077665544 │
     ╰──────────────────┴──────────────────╯
我知道SSE2提供:
PSHUFW:洗牌包装的字(16位)PSHUFD:洗牌包装双字(32位)
虽然我不知道这些指令是做什么的,但也没有四字(64位)版本。
奖金问题
您将如何执行ROR的xmm寄存器-假设其他大小的打包数据?
- 将右填充双字旋转16位: xmm0│ffeeddcc││77665544│33221100│╰──────────┴──────────┴──────────┴──────────╯⇓xmm0╭──────────┬──────────┬──────────┬──────────╮│ddccffee│9988bbaa│55447766│11003322│╰──────────┴──────────┴──────────┴──────────╯
- 将右填充的Word旋转8位: ╭──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────╮xmm0│ffee│ddcc│bbaa│9988│7766│5544│3322│1100│╰──────┴──────┴──────┴──────┴──────┴──────╭──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────╮xmm0 eeff│ccdd│aabb│8899│6677│4455│2233│0011│╰──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────╯
额外奖金问题
如果是256位ymm寄存器,您将如何执行上面的操作?
     ╭──────────────────────────────────┬──────────────────────────────────╮
ymm0 │ 2f2e2d2c2b2a29282726252423222120 │ ffeeddccbbaa99887766554433221100 │ packed doublequadwords
     ╰──────────────────────────────────┴──────────────────────────────────╯
     ╭──────────────────┬──────────────────┬──────────────────┬──────────────────╮
ymm0 │ 2f2e2d2c2b2a2928 │ 2726252423222120 │ ffeeddccbbaa9988 │ 7766554433221100 │ packed quadwords
     ╰──────────────────┴──────────────────┴──────────────────┴──────────────────╯
     ╭──────────┬──────────┬──────────┬──────────┬──────────┬──────────┬──────────┬──────────╮
ymm0 │ 2f2e2d2c │ 2b2a2928 │ 27262524 │ 23222120 │ ffeeddcc │ bbaa9988 │ 77665544 │ 33221100 │ packed doublewords
     ╰──────────┴──────────┴──────────┴──────────┴──────────┴──────────┴──────────┴──────────╯
     ╭──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────┬──────╮
ymm0 │ 2f2e │ 2d2c │ 2b2a │ 2928 │ 2726 │ 2524 │ 2322 │ 2120 │ ffee │ ddcc │ bbaa │ 9988 │ 7766 │ 5544 │ 3322 │ 1100 │ packed words
     ╰──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────┴──────╯
奖金阅读
回答 2
Stack Overflow用户
发布于 2018-12-06 03:08:07
如果旋转计数为8的倍数,则可以使用字节洗牌。带有控制掩码的pshufb可以在一条指令中处理任何其他8的倍数。
pshufd可以处理count=32,交换每个qword的两个部分:_MM_SHUFFLE(2,3, 0,1),或者在asm pshufd xmm0, xmm0, 0b10_11_00_01中(NASM支持将_作为可选分隔符,就像C++11一样用于数字文本)。
对于一个没有pshufhw的功能版本来说,16次计数的SSSE3并不坏,但是对于低/高的qword,您需要单独的洗牌。( imm8控制字节只包含4个2位字段。)或使用AVX2,用于每条车道内的奇数/偶数qword。
,如果旋转计数是而不是( 8的倍数),则有AVX512F vprolq zmm0, zmm1, 13和vprorq。也可在变量计数版本中使用,每个元素计数来自另一个向量而不是直接。vprolvq / vprorvq.也可用dword粒度,但没有字或字节。
否则,如果只有(x << n) | (x >> (64-n)).,并且计数不是16的倍数,则需要left+right shift +或才能在asm中实现在asm中使用C表示旋转为SSE2的通用方法(C++中循环移位(旋转)操作的最佳实践指出了从超出范围的移位计数中绕过潜在的C的方法,这与本质或asm无关,因为asm和intrinsics的行为由英特尔很好地定义: SIMD移位使移位计数饱和,而不是像标量移位一样掩盖它。)
SSE2有粒度小到16位的移位,所以您可以直接这样做。
对于字节粒度,您需要额外的掩蔽以消除在一个字中的字节之间移动的位。AVX寄存器中字节旋转的有效方法。或者使用像pmullw这样的技巧,用一个2的元素的幂向量,允许每个元素的变量计数.(其中AVX2通常只有dword/qword的变量计数移位)。
Stack Overflow用户
发布于 2018-12-06 04:41:00
虽然我问过如何执行旋转右,但是当您执行两个64位值的ROR时,其中一个子集正好是32位。这使得任意的旋转变成了高和低32位的简单交换:
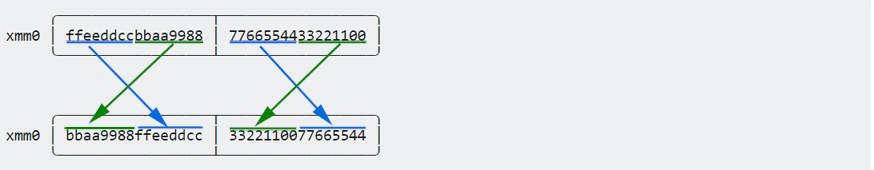
知道您只是在执行32位(即双字)交换,您可以使用另一条指令:
- pshufd:洗牌包装成双字
指令的编码很棘手,英特尔对混淆文档做了最大的努力。这样做的想法是,您可以将128位xmm视为32位doublewords,,并将它们推到任何您喜欢的地方:
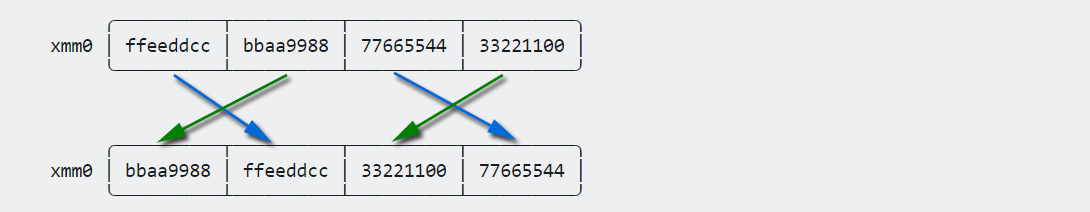
编码是很棘手的:
pshufd xmm0, xmm0, 0x02030001因为我正在推动四个双字,面具是由四个块组成的:
02030001
这些都是从左到右排列的,告诉你那个32位双字应该放在哪里的索引:
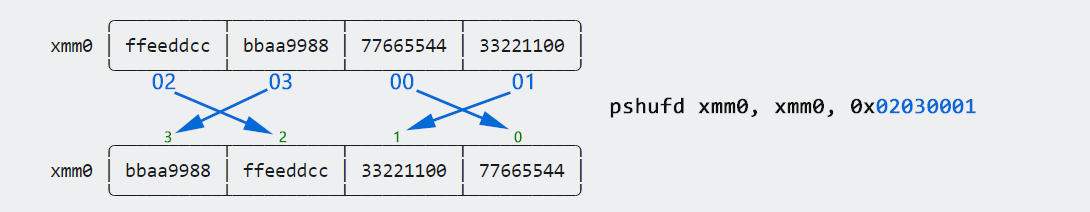
如果您正在旋转64位四字,并将其打包到xmm寄存器中,则可以使用以下命令:
pshufd xmm0, xmm0, 0x02030001 //rotate packed quadwords by 32-bits¹RotateRight(16)
现在如果:
- 而不是封装在xmm中的64位四字的
ROR(32)。 - 我想要
ROR(16)
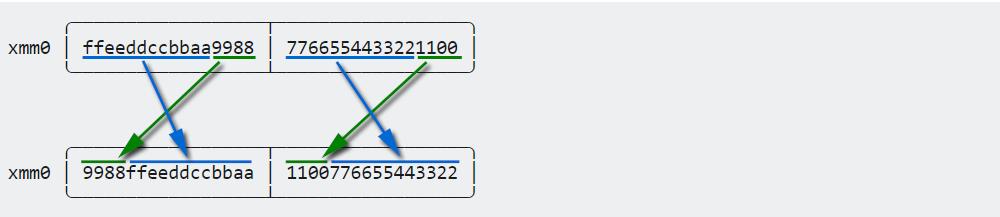
我们可以用同样的伎俩。假设64位四字被划分为16位字,并对它们进行洗牌:
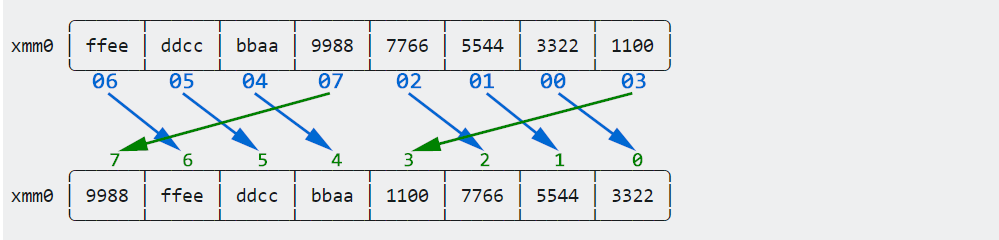
pshufw xmm0, xmm0, 0x0605040702010003 //shuffle packed words¹除了pshufw不能在xmm寄存器上操作。所以我说服自己停滞不前。
RotateRight(24)
现在如果:
- 而不是封装在xmm中的64位四字的
ROR(32)。 - 我想要
ROR(24)
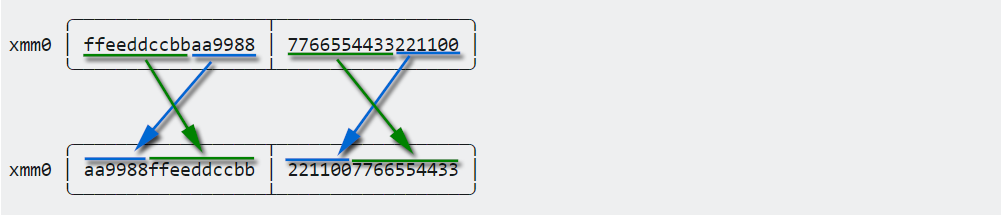
我们可以应用同样的东西。假设64位四字被分成8位字.
pshufb xmm0,xmm0,东西//洗牌打包字节
好吧,我明天再拿这个。现在我累了。我希望只输入一行代码;相反,这是一个长达四个小时的痛苦。我以为现在人们已经记录了所有这些基本操作;CPU已经存在至少3年了。
RotateRight(1)
好的,过会儿。
脚注
我认为。我不确定我的编码是否正确。
https://stackoverflow.com/questions/53643628
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号