
PySpark:如何从火花数据框架创建嵌套的JSON?
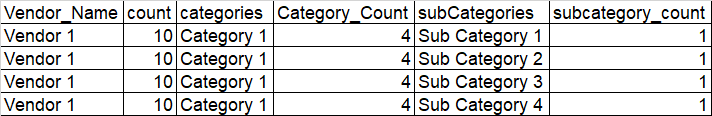
我正在尝试从我的创建一个嵌套的json,它具有以下结构中的数据。下面的代码是用键和值创建一个简单的json。你能帮帮忙吗
df.coalesce(1).write.format('json').save(data_output_file+"createjson.json", overwrite=True)Update1:根据@MaxU的回答,我将星火数据框架转换为熊猫,并使用了group。它将最后两个字段放在嵌套数组中。如何首先将类别和计数放在嵌套数组中,然后在该数组中放置子类别和计数。
样本文本数据:
Vendor_Name,count,Categories,Category_Count,Subcategory,Subcategory_Count
Vendor1,10,Category 1,4,Sub Category 1,1
Vendor1,10,Category 1,4,Sub Category 2,2
Vendor1,10,Category 1,4,Sub Category 3,3
Vendor1,10,Category 1,4,Sub Category 4,4

j = (data_pd.groupby(['vendor_name','vendor_Cnt','Category','Category_cnt'], as_index=False)
             .apply(lambda x: x[['Subcategory','subcategory_cnt']].to_dict('r'))
             .reset_index()
             .rename(columns={0:'subcategories'})
             .to_json(orient='records'))
[{
        "vendor_name": "Vendor 1",
        "count": 10,
        "categories": [{
            "name": "Category 1",
            "count": 4,
            "subCategories": [{
                    "name": "Sub Category 1",
                    "count": 1
                },
                {
                    "name": "Sub Category 2",
                    "count": 1
                },
                {
                    "name": "Sub Category 3",
                    "count": 1
                },
                {
                    "name": "Sub Category 4",
                    "count": 1
                }
            ]
}]回答 2
Stack Overflow用户
发布于 2018-11-28 09:48:56
在python/大熊猫中,最简单的方法是使用groupby使用一系列嵌套生成器,我认为:
def split_df(df):
    for (vendor, count), df_vendor in df.groupby(["Vendor_Name", "count"]):
        yield {
            "vendor_name": vendor,
            "count": count,
            "categories": list(split_category(df_vendor))
        }

def split_category(df_vendor):
    for (category, count), df_category in df_vendor.groupby(
        ["Categories", "Category_Count"]
    ):
        yield {
            "name": category,
            "count": count,
            "subCategories": list(split_subcategory(df_category)),
        }

def split_subcategory(df_category):
    for row in df.itertuples():
        yield {"name": row.Subcategory, "count": row.Subcategory_Count}

list(split_df(df))
[{ "vendor_name":"Vendor1“:”Vendor1“:10,”类别“:[{”名称“:”1",“计数”:4,"subCategories":{“名称”:“子类别1",”计数“:1},{“名称”:“次级类别2”、“计数”:2}、{“名称”:“子类别3”、“计数”:3}、{“名称”:“子类别4”、“计数”:4}、、}、} ]
要将其导出到json,需要一种导出np.int64的方法
Stack Overflow用户
发布于 2018-11-26 09:26:33
你需要重新构造整个数据框架。
"subCategories“是一个结构化的典型类型。
from pyspark.sql import functions as F
df.withColumn(
  "subCategories",
  F.struct(
    F.col("subCategories").alias("name"),
    F.col("subcategory_count").alias("count")
  )
)
然后,使用groupBy并使用F.collect_list创建数组。
最后,您需要在数据中只有1条记录才能得到预期的结果。
https://stackoverflow.com/questions/53477724
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号