
R-我的第一行在列名中有#字符?
我的测试文件格式非常简单。第一行以以下开头:
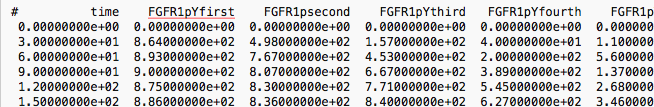
如果我忽略第一行并使用read.table导入数据,它可以正常工作,但是我没有列名。但是,如果我试图使用col.names=TRUE导入数据,它会说“列多于列名”。我想我可以分别导入第一行和其余的数据,并将第一行(即列名)添加到最终的输出文件中。但是当我导入第一行时:它完全忽略列名,跳到0 0 0.是因为第一行有一个#字符。另外,由于#字符,数据中还有一个额外的空列。
回答 2
Stack Overflow用户
发布于 2018-09-20 03:16:09
以下是一些可能性:
1) 两次将其读取为一行的字符向量( L,使用readLines )。然后删除#并使用L读取read.table
L <- sub("#", "", readLines("myfile.dat"))
read.table(text = L, header = TRUE)2)单独读取头部,对于较小的文件,前面的方法很短,应该很好,但是如果文件很大,您可能不想对其进行两次处理。在这种情况下,使用readLines只读取标题行,修复它,然后应用列名读取其馀部分。
File <- "myfile.dat"
col.names <- scan(text = readLines(File, 1), what = "", quiet = TRUE)[-1]
read.table(File, col.names = col.names)3)管道另一种方法是使用外部命令:
File <- "myfile.dat"
cmd <- paste("sed -e 1s/.//", File)
read.table(pipe(cmd), header = TRUE)在类似UNIX的系统上,sed应该是可用的。在Windows上,您需要安装Rtools,或者确保sed位于PATH上,或者使用文件的路径:
cmd <- paste("C:/Rtools/bin/sed -e 1s/.//", File)
read.table(pipe(cmd), header = TRUE)Stack Overflow用户
发布于 2018-09-20 03:09:49
一种方法是对第一行进行一次单独的读取,以嗅出列名。然后,像您已经做的那样做一个read.table,跳过第一行。
f <- "path/to/yourfile.csv"
con <- file(f, "r")
header <- readLines(con, n=1)
close(con)

df <- read.table(f, header=FALSE, sep = " ", skip=1)   # skip the first line
names(df) <- strsplit(header, "\\s+")[[1]][-1] # assign column names但是,我不喜欢这种方法,我更希望您修复平面文件的源代码,而不是包含那个麻烦的#符号。另外,如果您只需要将此要求作为一次使用,您也可以手动编辑平面文件以删除#符号。
https://stackoverflow.com/questions/52416906
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号