
Python Logistic回归产生错误的系数
我正在尝试使用LogisticRegression模型从科学工具包-学习解决摘录2从机器学习课程由吴国强对课程。但我得到的结果是错误的:
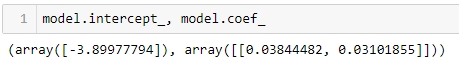
1)结果系数与答案不匹配:
我从模特那里得到了什么
根据答案我应该得到什么
-25.16,0.21,0.20
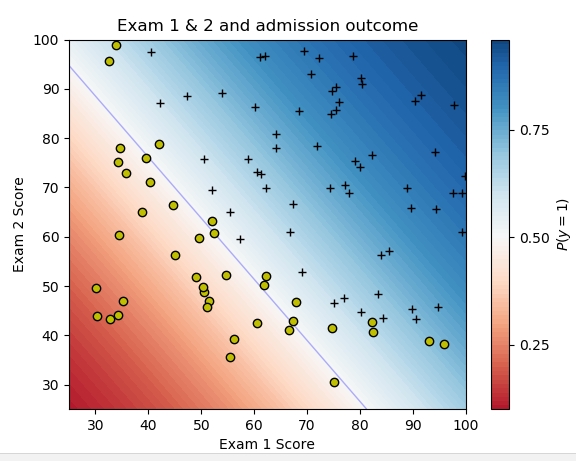
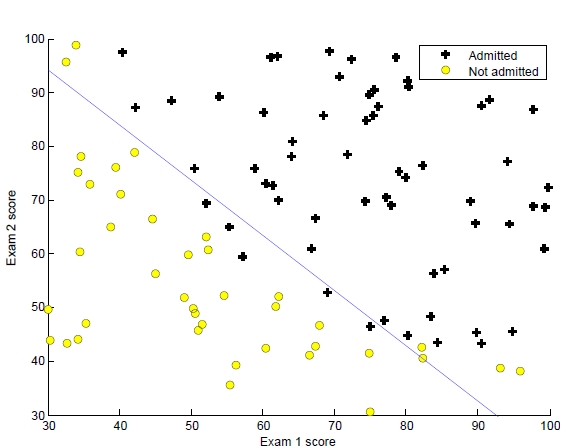
你可以在图上看到(错误的图),根据直觉,决策边界似乎比决策边界低一点点。
2)图形结果似乎是错误的,
如您所见,决策边界如下
LogisticRegression
回答
我的代码:
% matplotlib notebook


# IMPORT DATA

ex2_folder = 'machine-learning-ex2/ex2'
input_1 = pd.read_csv(folder + ex2_folder +'/ex2data1.txt', header = None)
X = input_1[[0,1]]
y = input_1[2]


# IMPORT AND FIT MODEL

from sklearn.linear_model  import LogisticRegression
model = LogisticRegression(fit_intercept = True)
model.fit(X,y)
print('Intercept (Theta 0: {}). Coefficients: {}'.format(model.intercept_, model.coef_))


# CALCULATE GRID
n = 5

xx1, xx2 = np.mgrid[25:101:n, 25:101:n]
grid = np.c_[xx1.ravel(), xx2.ravel()]
probs = model.predict_proba(grid)[:, 1]
probs = probs.reshape(xx1.shape)


# PLOTTING

f = plt.figure()
ax = plt.gca()


for outcome in [0,1]:
    xo = 'yo' if  outcome == 0 else 'k+'
    selection = y == outcome
    plt.plot(X.loc[selection, 0],X.loc[selection,1],xo, mec = 'k')
plt.xlim([25,100])
plt.ylim([25,100])

plt.xlabel('Exam 1 Score')
plt.ylabel('Exam 2 Score')
plt.title('Exam 1 & 2 and admission outcome')

contour = ax.contourf(xx1,xx2, probs, 100, cmap="RdBu",
                      vmin=0, vmax=1)
ax_c = f.colorbar(contour)
ax_c.set_label("$P(y = 1)$")
ax_c.set_ticks([0, .25, .5, .75, 1])

plt.contour(xx1, xx2, probs, [0.5], linewidths=1, colors='b', alpha = 0.3);

plt.plot(xx1[probs > 0.5], xx2[probs > 0.5],'.b', alpha = 0.3)
LINKS
回答 1
Stack Overflow用户
发布于 2018-09-18 05:26:34
要获得相同的结果,您需要创建相同的测试条件。
一目了然,一个明显的区别是迭代计数。Sklearn LogisticRegression分类器默认迭代计数为100,而Andrew的示例代码运行400次迭代。这肯定会给你一个与阮的课程不同的结果。
我不再确定Nguyen在练习中使用的代价函数是什么,但我很确定的是交叉熵,而不是L2是LogisticRecression分类器在scikit learn中的默认函数。
最后一个注意事项是,在实现更高级别的解决方案(scikitlearn/tensorflow/keras)之前,您应该首先尝试在纯python中实现它们,以了解它们是如何工作的。它将更容易(更有趣)尝试并使更高水平的软件包为您工作。
https://stackoverflow.com/questions/52379210
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号