
在C# .NET核心控制台应用程序中从浏览器页面检查器捕获数据
我的C# .NET核心控制台应用程序是一个简单的web爬虫。在源代码中包含所需数据的页面上,我能够访问所需的数据。在可以从窗口复制数据的页面中,可以在浏览器的页面检查器中查看,但不能在源代码中查看,我被卡住了。
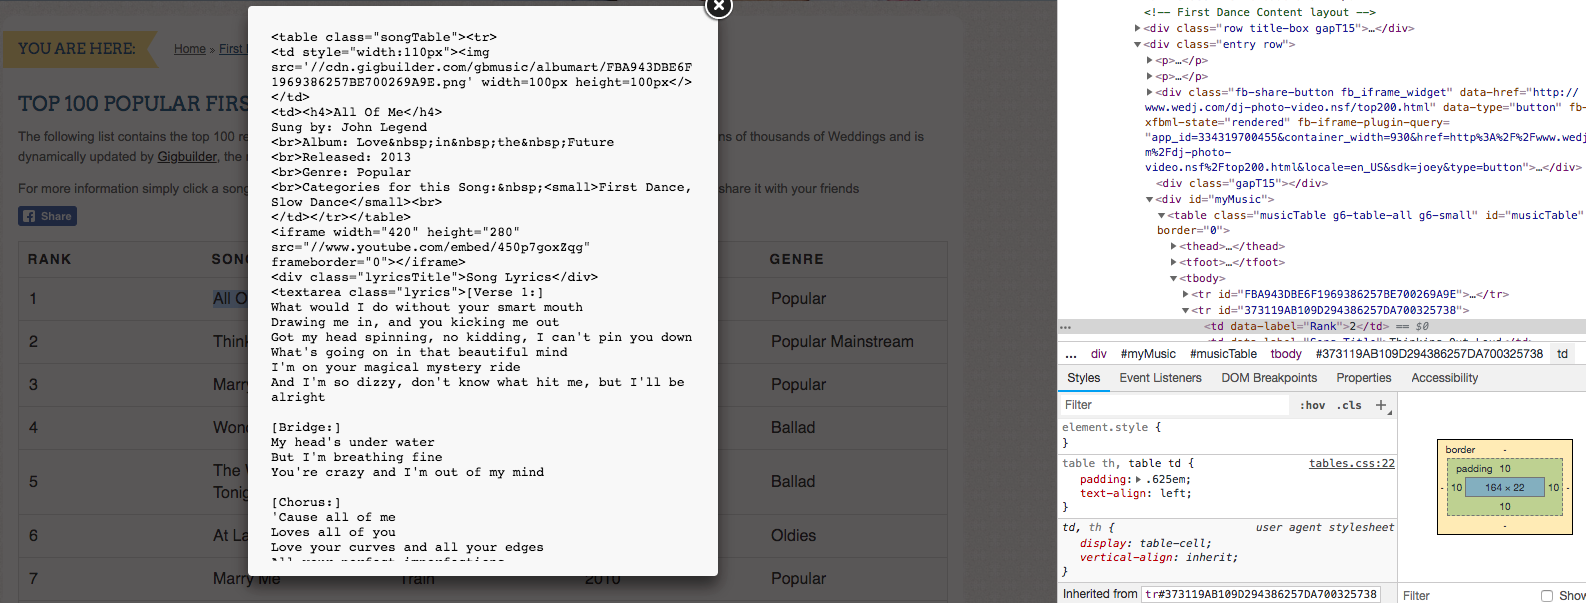
请提供代码示例,说明我如何获得这些数据。
我当前的捕获代码如下:
var htmlCode = string.empty;
using (WebClient client = new WebClient()) // WebClient class inherits IDisposable
{
     // Get the file content without saving it
     htmlCode = client.DownloadString("https://www.wedj.com/dj-photo-video.nsf/firstdance.html");
}
使用上面的代码,您将收到如下所示的源代码:
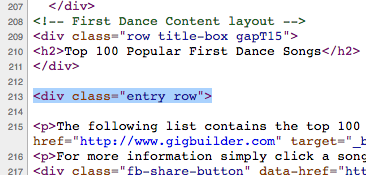
图1中显示的数据(从浏览器检查器中看到)隐藏在
<div class="entry row">回答 3
Stack Overflow用户
发布于 2018-08-17 08:40:30
有几种方法可以实现您需要的东西(考虑C#控制台应用程序)。
也许最简单的方法是使用与浏览器实例交互的工具,即Selenium (用于单元测试)。所以:
- 安装Selenium.WebDriver nuget软件包
- 安装应用程序运行的浏览器(让我们假设chrome)
- 下载浏览器驱动程序(显色剂)
- 写一些类似于: IWebDriver driver = null;尝试{ ChromeOptions options =新ChromeOptions();options.AddArguments(“-incognito”);options.AddArguments=新ChromeDriver(options);driver.Manage().Timeouts().ImplicitWait = TimeSpan.FromSeconds(5);driver.Url = "https://www.wedj.com/dj-photo-video.nsf/firstdance.html";var musicTable =driver.FindElement(By.Id(MusicTable));//与驱动程序交互以从页面获取数据。}最后{如果(驱动程序!= null) driver.Dispose();}
否则,您需要进一步研究网页是如何工作的。据我所见,该页面加载一个javascript,https://www.wedj.com/dj-photo-video.nsf/musiclist.js,它负责从服务器加载音乐列表。这个js脚本基本上从下面的url:firstdance&count=100加载数据(您也可以在浏览器中打开它)。不包括"(“和")",结果是您可以解析一个json (可能使用newtonsoft.json包):
{
  "more": "yes",
  "title": "<h1>Most Requested Wedding First Dance Songs<\/h...",
  "event": "<table class='musicTable g6-table-all g6-small' id='musicTable' borde..."
}
event属性包含您需要的数据(您可以使用HtmlAgilityPack nuget包来解析它)。
亲硒:
- 易于与之交互
- 此行为与浏览器所看到的行为相同。
缺点硒:
- 您需要安装chrome或其他浏览器。
- 当您与浏览器交互时,浏览器正在运行。
- 浏览器下载整个页面(图像、html、js、css.)
专业手册:
- 你只加载你需要的东西
- 不依赖于外部程序(即浏览器)
反对意见手册:
- 您需要了解html/js是如何工作的。
- 您需要手动解析json/html
在这种具体情况下,我更倾向于第二种选择。
Stack Overflow用户
发布于 2018-08-16 12:08:21
了解用于C#的,但是它会打开您想要删除的每个网页,然后返回源代码或在该网页上执行一些操作。
通常,这个工具不是(afaik)为网络爬虫,但可以是好的在一开始,特别是如果您的dotnet核心应用程序是坐在某个虚拟机/码头。
但是要小心,通过浏览器打开不安全的页面可能会有风险。
Stack Overflow用户
发布于 2018-08-16 14:28:44
你可能会尝试一下尖刺。它允许您获取当前的HTML状态。
using (var page = await browser.NewPageAsync())
{
    await page.GoToAsync("http://www.spapage.com");
    var result = await page.GetContentAsync();
}https://stackoverflow.com/questions/51752785
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号