
H12错误触发了Heroku上不断升级的记忆的向下螺旋
H12错误触发了Heroku上不断升级的记忆的向下螺旋
提问于 2018-07-24 12:41:14
我已经调试了几个星期,但没有什么成功,所以我想知道是否有更多的运气,这可能会帮助其他人在同样的问题在未来。
我们的设置:
- Ruby 2.3.7
- Rails 4.0.12
- 美洲狮3.11.4
- 暂停0.4.2
- Heroku 2X dynos
每隔一段时间,一个dynos就会被一波H12错误(吵闹的邻居?)击中。当这种情况发生时,内存逐渐升级,使dyno在重新启动之前无法使用。
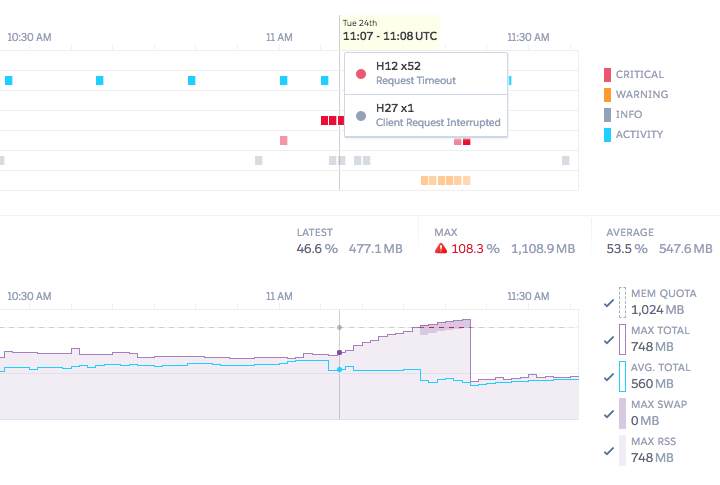
即使在H12错误消退之后,内存仍在不断升级:
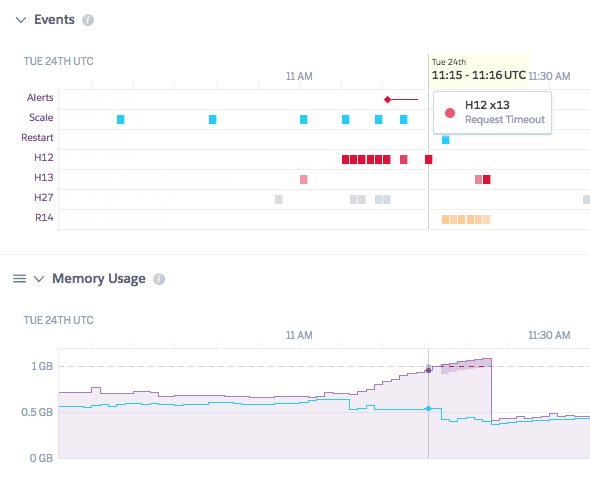
我们的rack-timeout设置为30秒后超时请求。这是可能是的原因/成因,虽然我无法果断地证明它。IO块期间的超时也是一个可能性。
我很高兴提供更多的信息,从NewRelic或书面线索,如果你们已经看过这一点,并知道要寻找什么。谢谢你的任何想法!
回答 1
Stack Overflow用户
发布于 2018-07-24 17:33:49
看到H12错误意味着Heroku在暂停请求之前对请求进行超时。您需要将机架超时设置减少到那是Heroku的超时时间后的30秒以下。我推荐25秒左右。
有了这些更改之后,您应该开始看到Rack::Timeout异常,而不是H12错误,您可以通过查看异常跟踪器中的堆栈跟踪来诊断超时的根本原因。
在您确定超时原因之前,我不会费心调查内存问题。我敢打赌,一旦你知道为什么你的请求超时,你解决了,你的内存问题也会得到解决。
页面原文内容由Stack Overflow提供。腾讯云小微IT领域专用引擎提供翻译支持
原文链接:
https://stackoverflow.com/questions/51498897
复制相关文章
相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号