
流动训练损失在不同跑步过程中有宏观相似之处
我有有线电视新闻网,我正在训练一个图像集,是存储在一个tfrecord。有关守则如下:
def parse_function(proto):
    ....

    train_path = "...."
    seed = random.randint(0, int(2**32 - 1))
    buffer_size = 300

    tf.set_random_seed(seed)
    train_set = tf.data.TFRecordDataset(train_path)
    train_set = train_set.map(parse_function)
    train_set = train_set.shuffle(buffer_size=buffer_size, seed=seed)
    train_set = train_set.batch(batch_size)
    train_set = train_set.repeat()

    iterator = train_set.make_one_shot_iterator()
    next_element = iterator.get_next()
    model = build_mode(next_element)
    with tf.Session() as sess:
        for i in range(iters):
            sess.run(model.train_op)
具有不同随机种子的多次运行的损失函数具有许多宏观相似性(如下图中的箭头所示)。
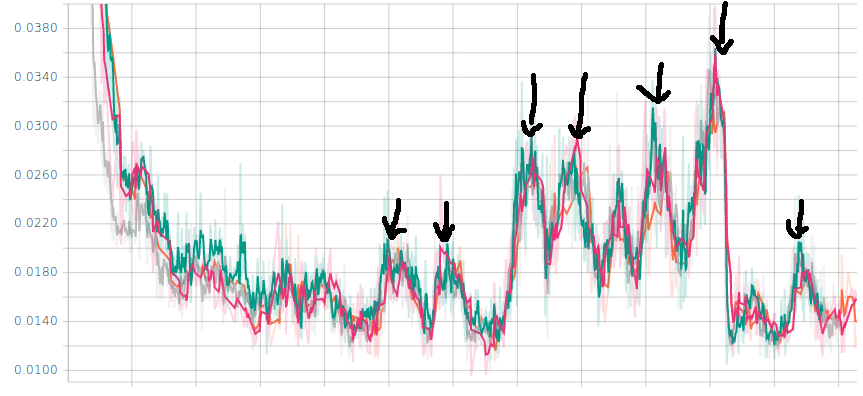
这里有4次单独的训练。注意,为了突出相似之处,这是放大一点,这只是头1000次迭代。这些相似之处大约每1000个迭代就会出现一次。如果我改变批次的大小,同样的事情似乎发生了变化。
对我来说,这指的是数据集根本没有被洗牌。知道为什么会这样吗?
回答 1
Stack Overflow用户
发布于 2018-06-26 16:01:42
我怀疑这个问题与所使用的批处理大小和缓冲区大小有关。buffer_size参数在shuffle中表示由后续的batch函数在任何给定时间从数据集中抽取的元素数。因此,如果buffer_size不够大(特别是与batch_size相比),则在采样数据集时可能没有足够的随机化。
我喜欢把buffer_size看作是在数据集上移动的窗口,其中随机化发生在窗口内(它比这更细微,但这是我喜欢可视化的图像)。因此,如果您的窗口大小与数据集的大小相比非常小,一般情况下,您不会在任何给定时间对大部分数据集进行随机化,从而导致跨迭代的批之间的周期性关联。
尝试将buffer_size从300增加到许多数据点,您可以轻松地将这些数据点放入内存。因此,例如,如果您正在处理n维浮点数据,并且您有500MB用于数据预处理,那么您可以在内存中为洗牌(近似为80000表示n=100)安装大约500MB/(n*64B)。在创建批处理时,这将增强随机化的程度。
https://stackoverflow.com/questions/51046450
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号